Čo je harness a ako mení výkon AI agentov?
Rovnaký model v jednom prostredí dokončí úlohu a v inom sa zasekne v slučke. Čo je agentný harness, odkiaľ pochádza jeho názov a čo benchmarky naozaj hovoria o Claude Code, Codexe, Hermese a ďalších systémoch?

Titulný obrázok je AI ilustrácia pracovného prostredia okolo modelu. Grafy nižšie vychádzajú z uvedených verejných meraní a snímka krabov pochádza z nášho skutočného experimentu. Výsledky a dokumentáciu sme overili k 25. októbru 2026.
Dvaja ľudia použijú rovnaký AI model. Jeden dostane fungujúcu aplikáciu. Druhý adresár rozrobených súborov a sebavedomú správu, že je všetko hotové.
Rozdiel nemusí byť v tom, kto napísal čarovnejší prompt. Jeden agent mohol mať jasné nástroje, priebežné poznámky a možnosť overovať výsledky. Druhý po niekoľkých desiatkach krokov stratil pôvodný cieľ, zopakoval neúspešnú akciu a skončil príliš skoro.
Po našom experimente so štyrmi AI na ostrove sa objavila podobná otázka: ako si kraby písali denníky a ako spolu komunikovali? Práve tu sa dostávame k slovu harness: vrstve, ktorá určuje, čo model vidí, čo môže urobiť a čo sa dozvie o následkoch svojich rozhodnutí.
A táto vrstva dokáže urobiť prekvapivo veľký rozdiel.
Harness: čo to slovo znamená a odkiaľ prišlo
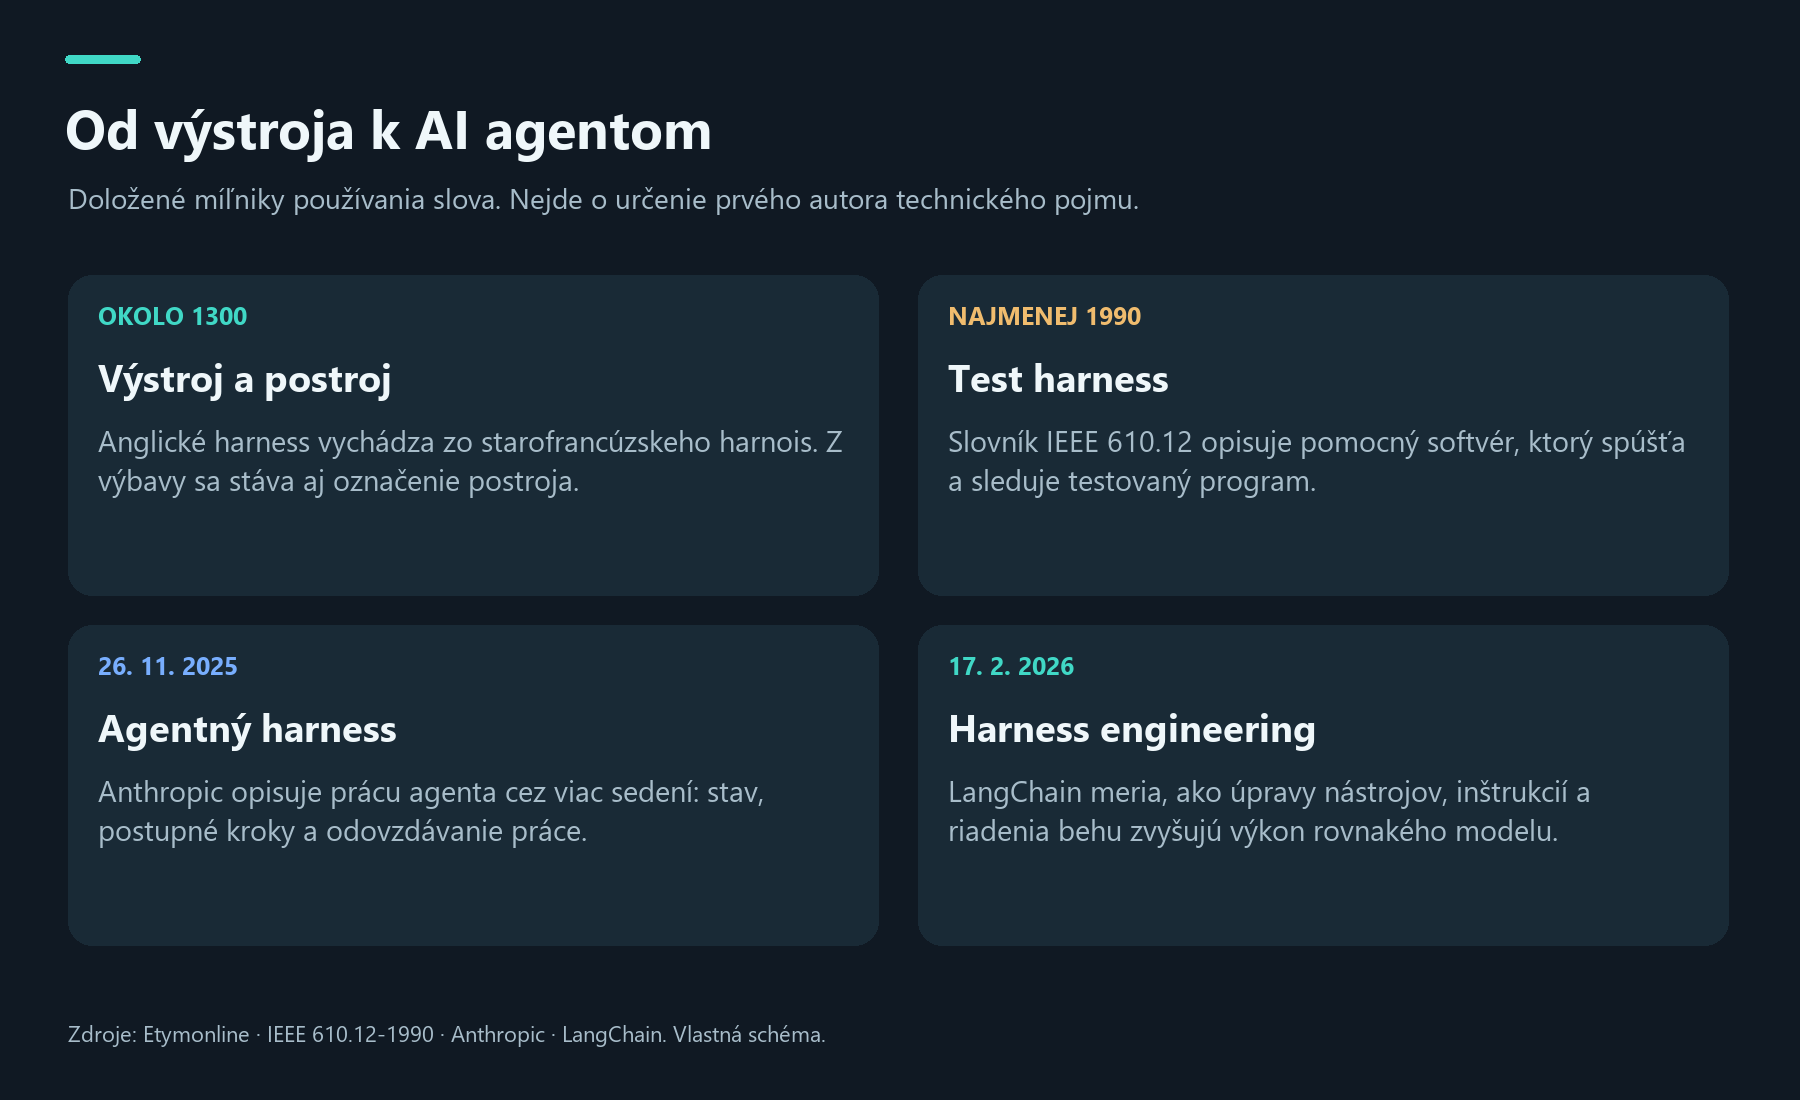
Anglické harness môže znamenať výstroj alebo postroj. Ako sloveso znamená zapriahnuť či využiť určitú silu. Nie je to skratka. Pre AI je to výstižná metafora: prepája dostupnú schopnosť s užitočnou prácou.
Slovo je o stáročia staršie než počítače. V angličtine je doložené okolo roku 1300 vo význame výbavy, najmä vojenskej, a pochádza zo starofrancúzskeho harnois. Význam postroja pre ťažné zvieratá nasledoval na začiatku 14. storočia. Prenesené slovesné použitie vo význame ovládnuť alebo využiť silu sa dokladá od 90. rokov 17. storočia. Etymonline: harness
Softvér už dlho pozná test harness: pomocný softvér, ktorý spúšťa testovaný program, dodáva mu vstupy a sleduje výsledky. Termín sa objavuje prinajmenšom v slovníku softvérového inžinierstva IEEE 610.12-1990 ako synonymum pre test driver. To je doložené použitie v roku 1990, nie dátum vynálezu. IEEE, test driver / test harness, strana 75
V dnešnej diskusii o agentoch harness označuje predovšetkým softvérovú vrstvu, ktorá riadi ich prácu. Anthropic o nej výslovne písal v článku o dlhodobo pracujúcich agentoch 26. novembra 2025. LangChain 17. februára 2026 opísal harness engineering, teda systematické zlepšovanie tohto okolia. Ani tieto dátumy neurčujú prvého autora myšlienky; sú to konkrétne, dohľadateľné míľniky. Anthropic · LangChain
Čo sa deje medzi zadaním a výsledkom
Model navrhuje odpovede a ďalšie kroky. Harness organizuje ich vykonanie: skladá kontext, sprístupňuje nástroje, vykonáva povolené akcie a vracia modelu ich skutočné výsledky. Agent je celý takto pracujúci systém. Podobne rozlišuje model a jeho pracovné prostredie aj dokumentácia Claude Code.
Predstavme si schopného kolegu, ktorý nastúpi do firmy. Na jeho schopnostiach záleží. Rovnako aj na správnych informáciách, prístupe k potrebným aplikáciám a možnosti skontrolovať si prácu. Bez nich môže veľmi presvedčivo opisovať, čo by urobil, ale nič nedokončiť.
Pri AI táto výbava zahŕňa:
- Kontext: inštrukcie, súbory a časti histórie, ktoré model práve vidí.
- Nástroje: ako číta dokumenty, mení kód, počíta, vyhľadáva alebo ovláda aplikácie.
- Pamäť a stav: čo sa uchová medzi krokmi či sedeniami a ako sa to znovu vyhľadá.
- Riadenie práce: čo sa stane po chybe, kedy práca pokračuje a kedy sa beh skončí.
- Overovanie: či testy skutočne prešli, výpočty sedia a sľúbený súbor existuje.
- Oprávnenia a limity: čo agent smie robiť a koľko má času či peňazí.
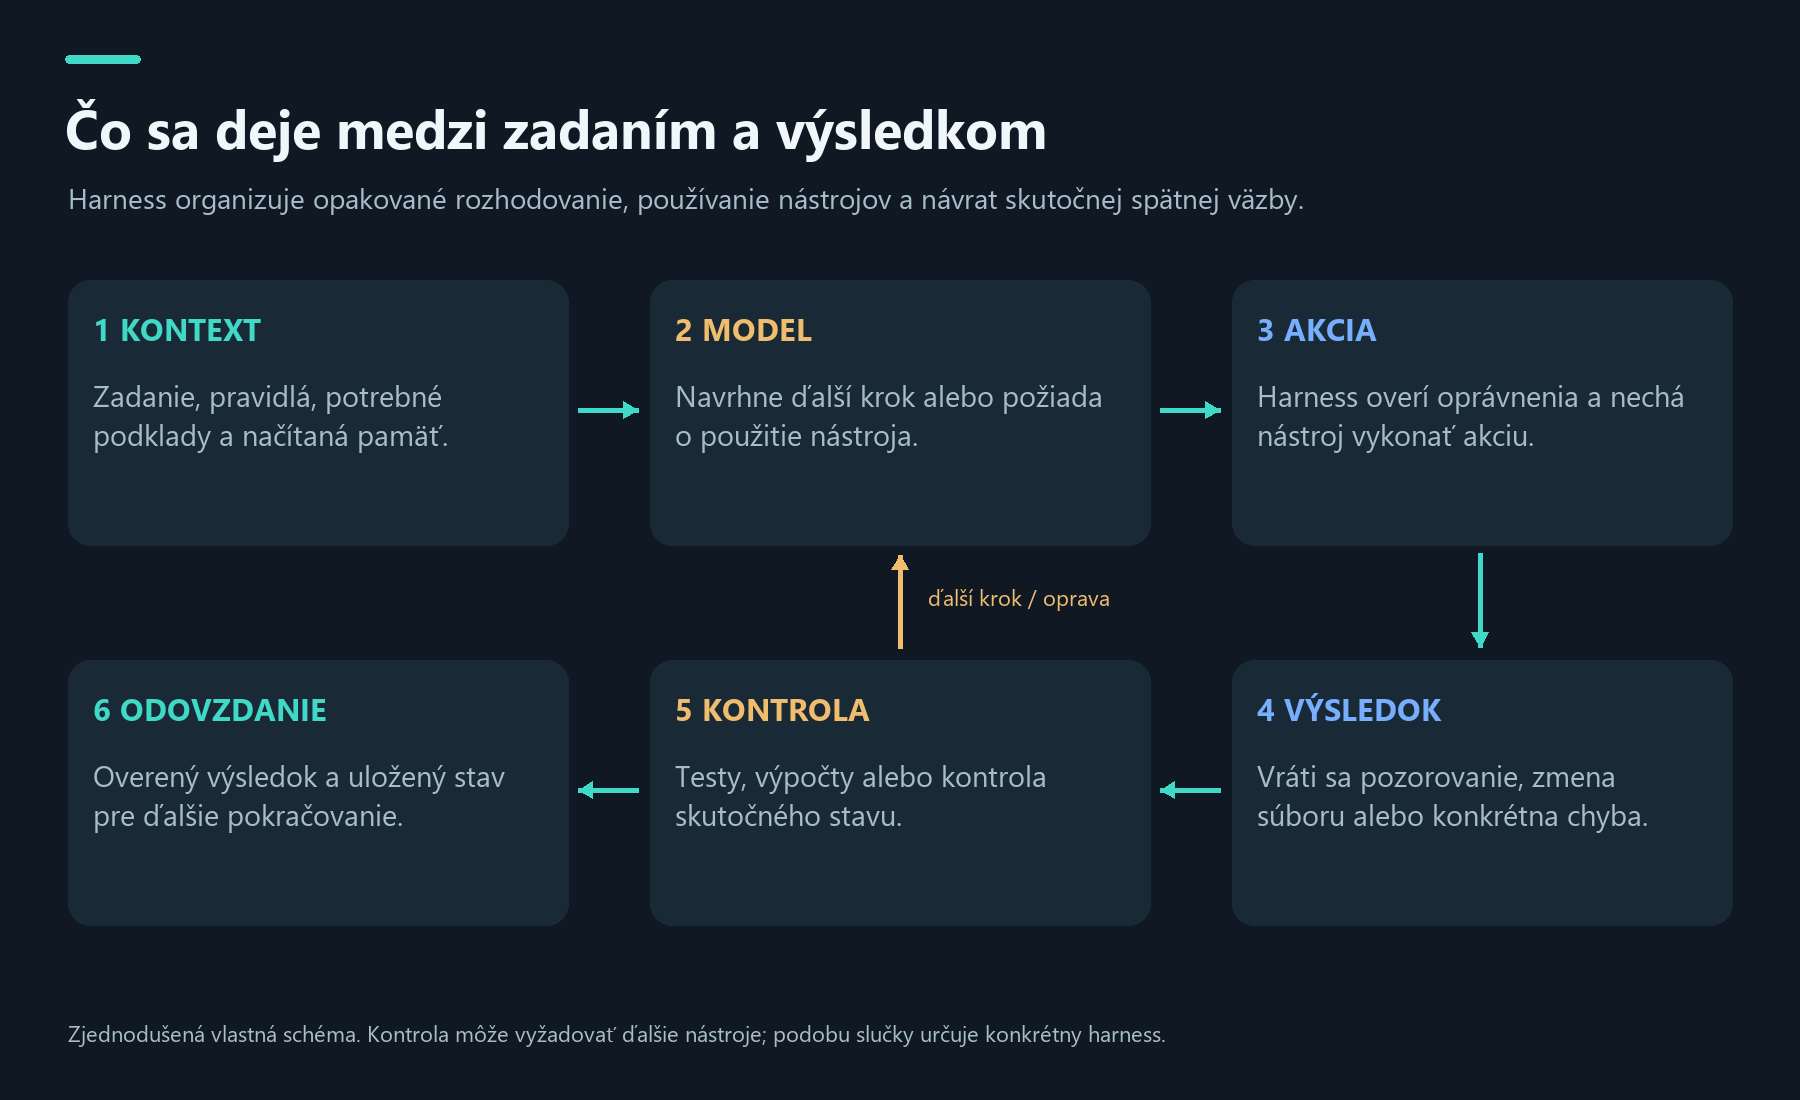
Naša zjednodušená schéma. Konkrétny harness môže kroky spájať a kontrola môže vyžadovať ďalšie nástroje. Správa „hotovo“ sama osebe nie je overenie.
Ešte niekoľko pojmov, ktoré sa často zamieňajú: framework je softvérová stavebnica a SDK znamená software development kit, súbor prostriedkov pre vývojárov. Oboje môže pomôcť zostaviť harness. Benchmark je súbor testovacích úloh s pravidlami hodnotenia; jeho evaluation harness testy spúšťa a vyhodnocuje. V jednom experimente teda môže byť harness, ktorý agentovi pomáha pracovať, a ďalší, ktorý jeho prácu meria.
Lepšie výsledky bez pretrénovania modelu
LangChain ponechal GPT-5.2-Codex a upravil okolitý systém Deep Agents. Na Terminal-Bench 2.0 sa skóre zvýšilo z 52,8 na 66,5 %, teda o 13,7 percentuálneho bodu. Pomohli zmeny inštrukcií, nástrojov a riadenia behu: dôslednejšie overovanie, lepšia práca s časovým rozpočtom a analýza miest, kde sa agent zasekol. Bol to experiment tvorcu harnessu, ladený na konkrétnom benchmarku, nie záruka zlepšenia pri každej úlohe. Experiment LangChain
Ďalšou cestou sú skills, opakovateľné postupy pre určité druhy práce. Skill môže obsahovať návod v SKILL.md, skripty, šablóny a príklady. Pri mesačnom reporte môže určovať, ako zjednotiť meny, overiť súčty a vytvoriť firemný formát. Codex môže najprv načítať krátky opis a plné inštrukcie otvoriť až pri použití skillu. Dokumentácia skills
SkillsBench v4 skúmal 87 úloh v ôsmich oblastiach a 18 konfiguráciách model–harness. Kurátorované skilly zvýšili priemernú úspešnosť z 33,9 na 50,5 %, teda o 16,6 percentuálneho bodu. Ide o priemer rôznych konfigurácií; ľubovoľný stiahnutý návod nesľubuje rovnaký prínos. SkillsBench, revízia zo 14. júna 2026
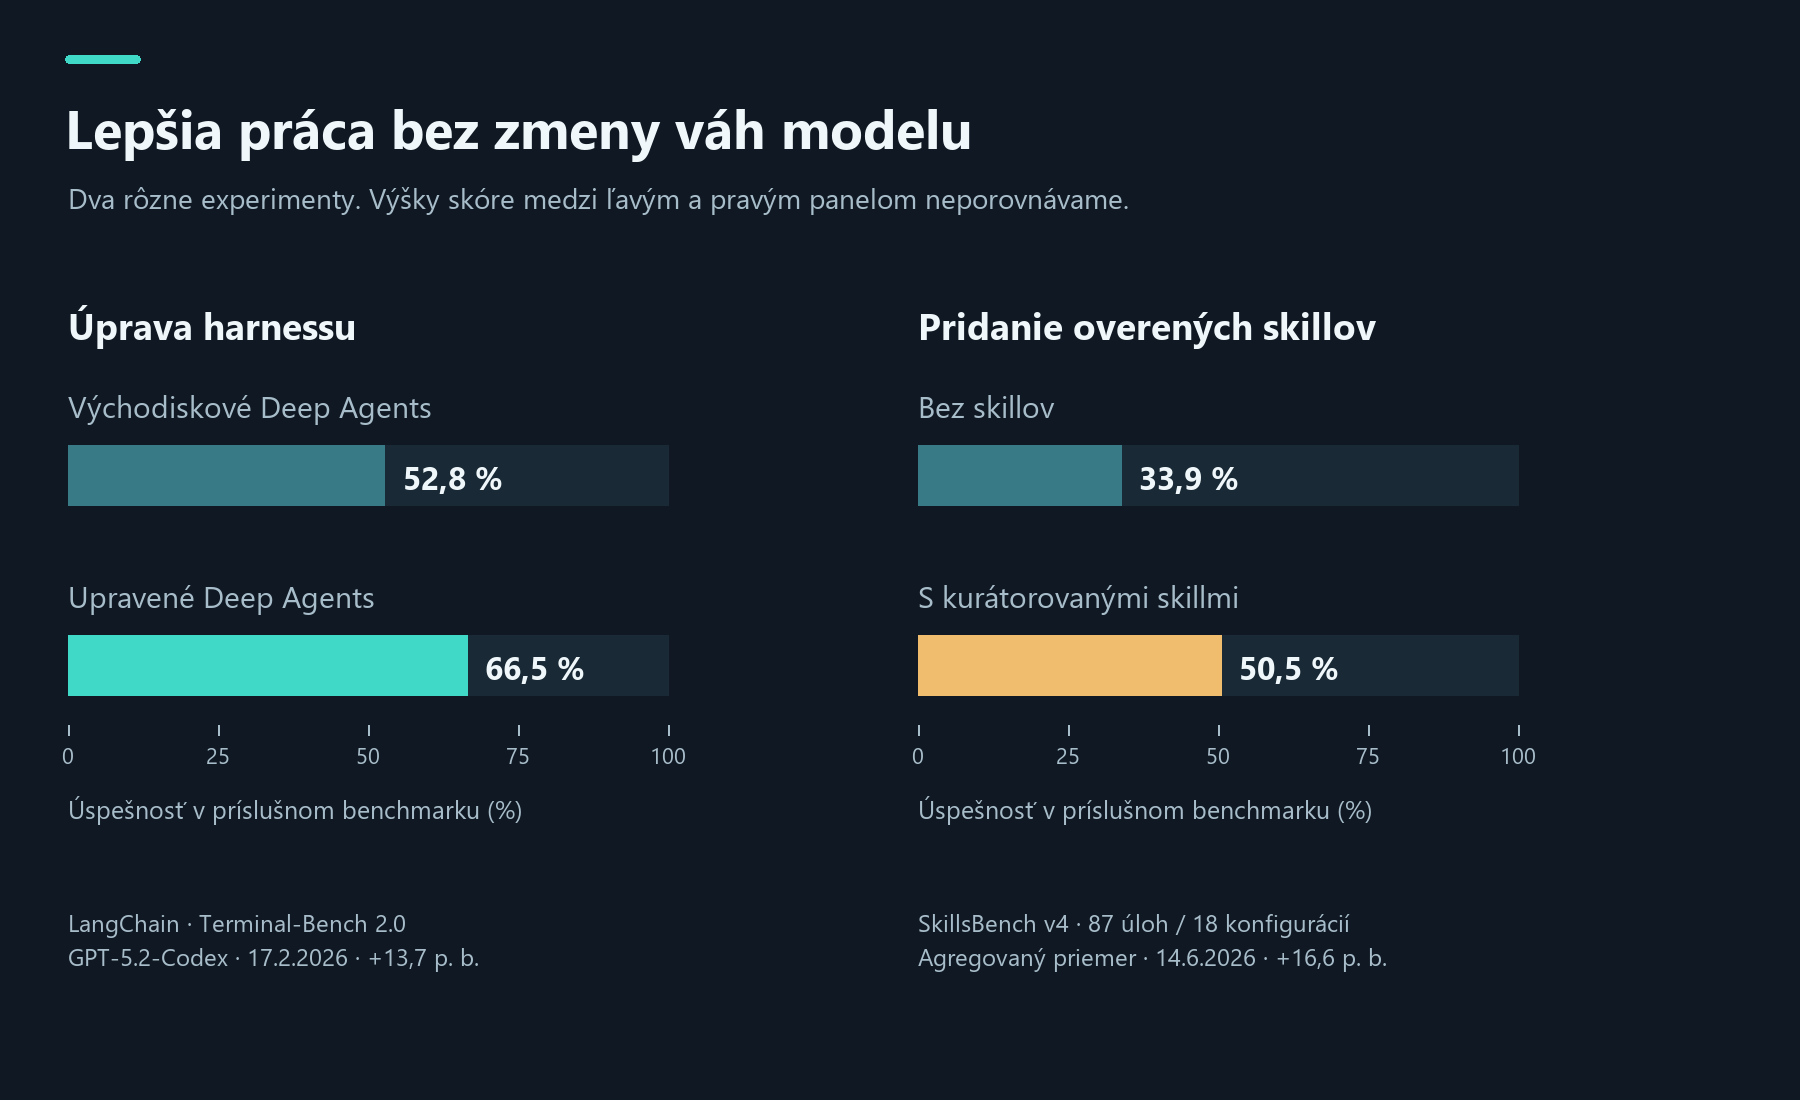
Každý panel predstavuje iný experiment. Výšky skóre medzi panelmi nemožno použiť na porovnávanie kvality systémov.
Nástroj vykoná operáciu. Skill poskytne postup, ako nástroje používať. Harness dostane správne informácie k modelu v správnej chvíli. Pridať ďalších sto strán inštrukcií preto nemusí veľmi pomôcť: môžu aj zakryť to najdôležitejšie.
Pamäť nie je len súbor s príponou MD
Kontext je obsah, ktorý model dostáva práve teraz. Pamäť uchováva informácie na neskôr. Uložený denník nepomôže, ak ho pri ďalšej úlohe nikto nenačíta alebo sa v ňom nedajú nájsť podstatné skúsenosti.
Markdown, teda MD, sa hodí na čitateľné poznámky a inštrukcie. JSON ukladá štruktúrované údaje, napríklad stav jednotlivých krokov. JSONL pozostáva zo samostatných záznamov JSON, každý na jednom riadku, čo je praktické pre históriu udalostí. Formát je však len časť riešenia. Potrebujeme vedieť, kto informáciu zapísal, o čo sa opiera a či ešte platí.
Anthropic pri pokusoch s dlhodobo pracujúcimi agentmi kombinoval zoznam funkcií v JSON, záznam postupu a históriu Gitu. Model mal menšiu tendenciu nevhodne meniť zoznam v JSON než jeho ekvivalent v Markdowne. Samotné skrátenie rozhovoru do súhrnu na hladké pokračovanie nestačilo. Je to poznatok z konkrétneho vývojového postupu, nie všeobecná nadradenosť jedného formátu. Anthropic o dlhodobo pracujúcich agentoch
Keď si agent zapíše skúsenosť a nabudúce ju využije, zvyčajne nemení váhy modelu. Mení informácie dostupné pre ďalšie rozhodnutie. Hovorovo sa tomu dá rozumieť ako „učeniu“, technicky však ide o iný mechanizmus než pretrénovanie alebo fine-tuning.
Markdown, RAG, znalostné grafy alebo HEAR?
Naša diskusia priniesla aj ďalšiu otázku: kedy stačí priečinok poznámok a kedy agent potrebuje znalostný graf? Táto voľba patrí k návrhu harnessu. Agent môže mať správne informácie niekde uložené, no nenájsť ich, prehliadnuť ich platnosť alebo ich nespojiť s ďalšou podmienkou.
Najprv rozlíšme, čo vyberáme. Markdown je formát, RAG spôsob dopĺňania kontextu, znalostný graf dátový model a HEAR konkrétna výskumná architektúra agenta. Môžu spolupracovať: dokumenty Markdown sa dajú indexovať, graf môže odkazovať na pôvodné pasáže a agent môže podľa otázky prepínať medzi vyhľadávaním, databázou a prechádzaním vzťahov.
| Potreba | Čím by som začal | Príklad otázky |
|---|---|---|
| Pravidlá projektu, poznámky a opakovateľné postupy | Usporiadané súbory Markdown a súborové nástroje | Ako v tomto projekte spúšťame testy? |
| Nájdenie konkrétneho faktu v dokumentoch | RAG s citáciami a filtrami platnosti | Čo hovorí aktuálna cestovná smernica? |
| Závislosti a dosahy medzi viacerými objektmi | Znalostný graf, prípadne GraphRAG | Ktorých zákazníkov zasiahne výpadok tohto dodávateľa? |
| Opakovaná diagnostika procesu naprieč systémami | Overený postup, prípadne architektúra podobná HEAR | Prečo sa zákazka zastavila medzi nákupom a expedíciou? |
| Presné súčty a aktuálny prevádzkový stav | Priamy dopyt do databázy alebo príslušného API | Koľko objednávok práve čaká na expedíciu? |
Praktické odporúčania pre prvý návrh, nie rebríček kvality technológií.
Kedy stačia súbory a kedy pridať RAG
Pri pravidlách projektu a jasne vymedzených postupoch by som začal súbormi. Ľudia ich ľahko prečítajú, opravia a porovnajú zmeny. Krátky index môže odkazovať na podrobnosti; celý adresár netreba vkladať do každej požiadavky. Načítavanie informácií podľa potreby opisuje aj Anthropic v texte o context engineeringu. Článok nedokazuje všeobecnú prevahu Markdownu nad grafmi.
RAG znamená retrieval-augmented generation: generovanie doplnené vyhľadanými informáciami. Známa práca s týmto názvom vyšla v roku 2020. Pri asistentovi nad smernicami či manuálmi je dôležité pred odpoveďou nájsť relevantnú pasáž a zachovať jej zdroj. Pôvodná práca o RAG
V praxi sa RAG nemusí obmedziť na sémantickú podobnosť. Tú možno kombinovať s kľúčovými slovami, čo pomáha napríklad pri presných identifikátoroch. Doplniť sa dajú filtre a následné preusporiadanie podľa relevantnosti. Ako funguje hybridné vyhľadávanie
„Aká je výpovedná lehota v tejto zmluve?“ potrebuje konkrétne ustanovenie. „Čo spôsobuje naše oneskorené dodávky?“ vyžaduje širšie pokrytie. Niekoľko veľmi podobných pasáží môže dôležité dáta vynechať. A na spočítanie objednávok by som uprednostnil kontrolovaný databázový dopyt pred tým, aby model sčítaval vyhľadané úryvky.
Kedy sa oplatí graf a čo pridáva hypergraf
Znalostný graf zachytáva objekty a vzťahy: dodávateľ dodáva súčiastku, súčiastka patrí do výrobku a zákazník výrobok používa. Má zmysel, keď sa podobné vzťahy riešia opakovane. Štruktúra však stojí prácu: rozlišovanie identít, definovanie väzieb a udržiavanie aktuálnych údajov. Nesprávne prepojené firmy alebo zastaraná závislosť môžu znehodnotiť celý reťazec záverov.
GraphRAG používa graf pri získavaní kontextu. Implementácia Microsoftu navyše sumarizuje skupiny súvisiacich entít, čo pomáha pri otázkach nad celým korpusom. Hodnotenie z roku 2024 ukázalo prínos v úplnosti a rozmanitosti odpovedí na globálne otázky. To sa nesmie zamieňať s univerzálnou faktickou správnosťou. GraphRAG a jeho hodnotenie
Hypergraf umožňuje jedným vzťahom spojiť viac účastníkov, napríklad dodávateľa, odberateľa, materiál a podmienky konkrétnej dodávky. Bežný graf to dokáže vyjadriť tiež, zavedením samostatného uzla dodávky. W3C takýto zápis n-árnych vzťahov opisovalo už v roku 2006. O hodnote konkrétneho systému rozhoduje použitie a merané výsledky, nie predpona „hyper“.
HEAR: vzťahy a postup získavania dôkazov
HEAR — Hypergraph Enterprise Agentic Reasoner je výskumná architektúra spoločnosti SUPCON. Prepája podnikové dátové zdroje, obchodné pravidlá a postupy získavania dôkazov. Jej princípy by som zvažoval pri opakovanej diagnostike objednávok naprieč systémami, vyžadujú však prípravu a údržbu procesných znalostí.
Verzia štúdie zo 7. septembra 2026 uvádza s GPT-5 tieto výsledky:
| Test | HEAR | Table-RAG |
|---|---|---|
| OF-BRCA: 95 otázok o príčine zablokovaných objednávok | 94,7 % | 52,6 % |
| OF-General: 160 rôznorodých otázok, iba úplne správne odpovede | 37,1 % | 29,6 % |
Pre prvý test autori pripravili diagnostický postup. Odstránenie procedurálnych hyperhrán znížilo presnosť na 74,2 % a zvýšilo priemernú spotrebu z 38,1 na 179,3 tisíca tokenov. Pri širších otázkach uvádzaných 88,7 % zahŕňa aj čiastočne správne odpovede; plná správnosť zostáva 37,1 %. HEAR, metodika a tabuľky 1–2
Tu vidieť súvislosť s návrhom harnessu: reprezentácia pomáha spolu s nástrojmi a pripraveným postupom. Ide o štúdiu nad podnikovými dátami autorov, nie o univerzálne víťazstvo nad súbormi či každou podobou RAG.
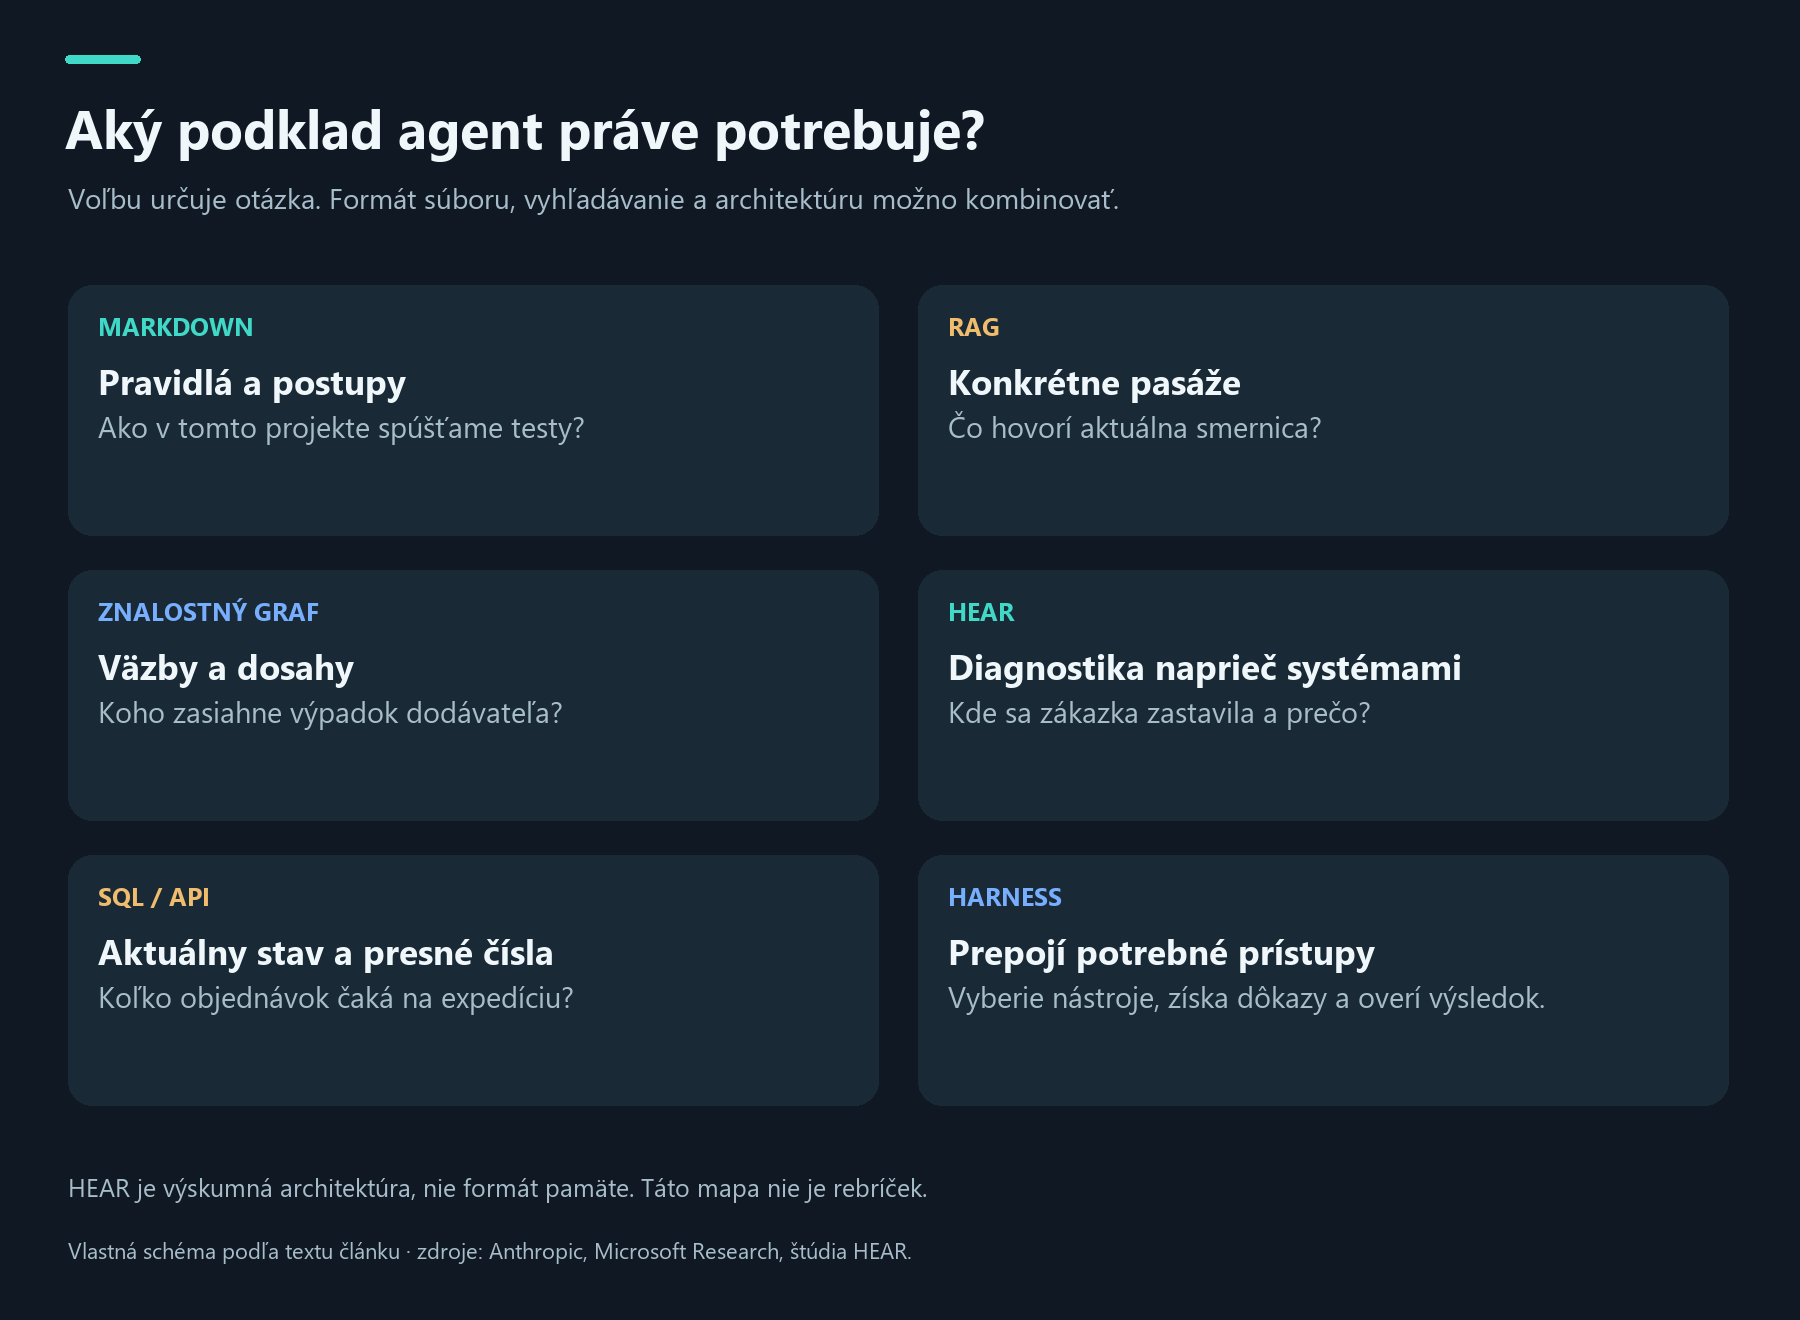
Naša rozhodovacia pomôcka. HEAR je celá architektúra, nie ďalší formát pamäte; prístupy sa dajú kombinovať.
Čo by som overil pred pridaním zložitejšej pamäte
Aj známe porovnanie „súbory verzus grafy“ treba čítať pozorne. Letta uviedla 74,0 % na LoCoMo, ale súbory boli zároveň vložené do vektorového indexu a agent používal sémantické vyhľadávanie. Záver „Markdown porazil RAG“ by preto bol chybný. Experiment Letty
Začal by som otázkami používateľov a analýzou chýb. Ak sa nedajú nájsť konkrétne pasáže, zlepšil by som vyhľadávanie. Ak sa nedarí pospájať vzťahy, otestoval by som graf. Ak sa stále opakuje rovnaká diagnostika, zachytil by som jej postup. Popri správnosti by som počítal cenu a čas odpovede aj náklady na vytvorenie a aktualizáciu indexu. Do testov patrí zmenený fakt, odobraný prístup k dokumentu a otázka, na ktorú dostupné dôkazy neumožňujú odpovedať.
Výsledný systém môže mať pravidlá v Markdowne, stav v JSON, dokumenty vyhľadané cez RAG, aktuálne čísla v SQL a vzťahy v grafe. Harness má pre daný krok vybrať a overiť správne informácie. To je užitočnejší cieľ návrhu než nahradiť všetko jednou módnou technológiou.
Ako sme menili harness našim krabom
Na ostrove mali agenti nástroje na pozorovanie, pohyb, manipuláciu s predmetmi, chat a pamäť. Ich české správy prechádzali spoločným herným chatom. Každý agent mal súkromné dlhodobé poznámky v SEMANTIC_MEMORY.md a priebežný denník udalostí v EPISODIC_MEMORY.jsonl.
Cerebras ukázal zaujímavý problém. Ostatní mohli napísať užitočnú radu, ale kým sa nedostala do jeho kontextu, nemohla pomôcť jeho rozhodovaniu. Preto sme doplnili pravidelné čítanie chatu. Menili sme aj prácu s opakovanými chybami, obnovenie po výpadkoch API a informáciu o tom, kto ešte beží.
To sú úpravy harnessu: ovplyvňujú tok informácií a priebeh práce. Agenti si naďalej sami skladali správy a robili mnohé rozhodnutia. Konkrétne roly, časť súradníc a podporné postupy sme však zadali my.
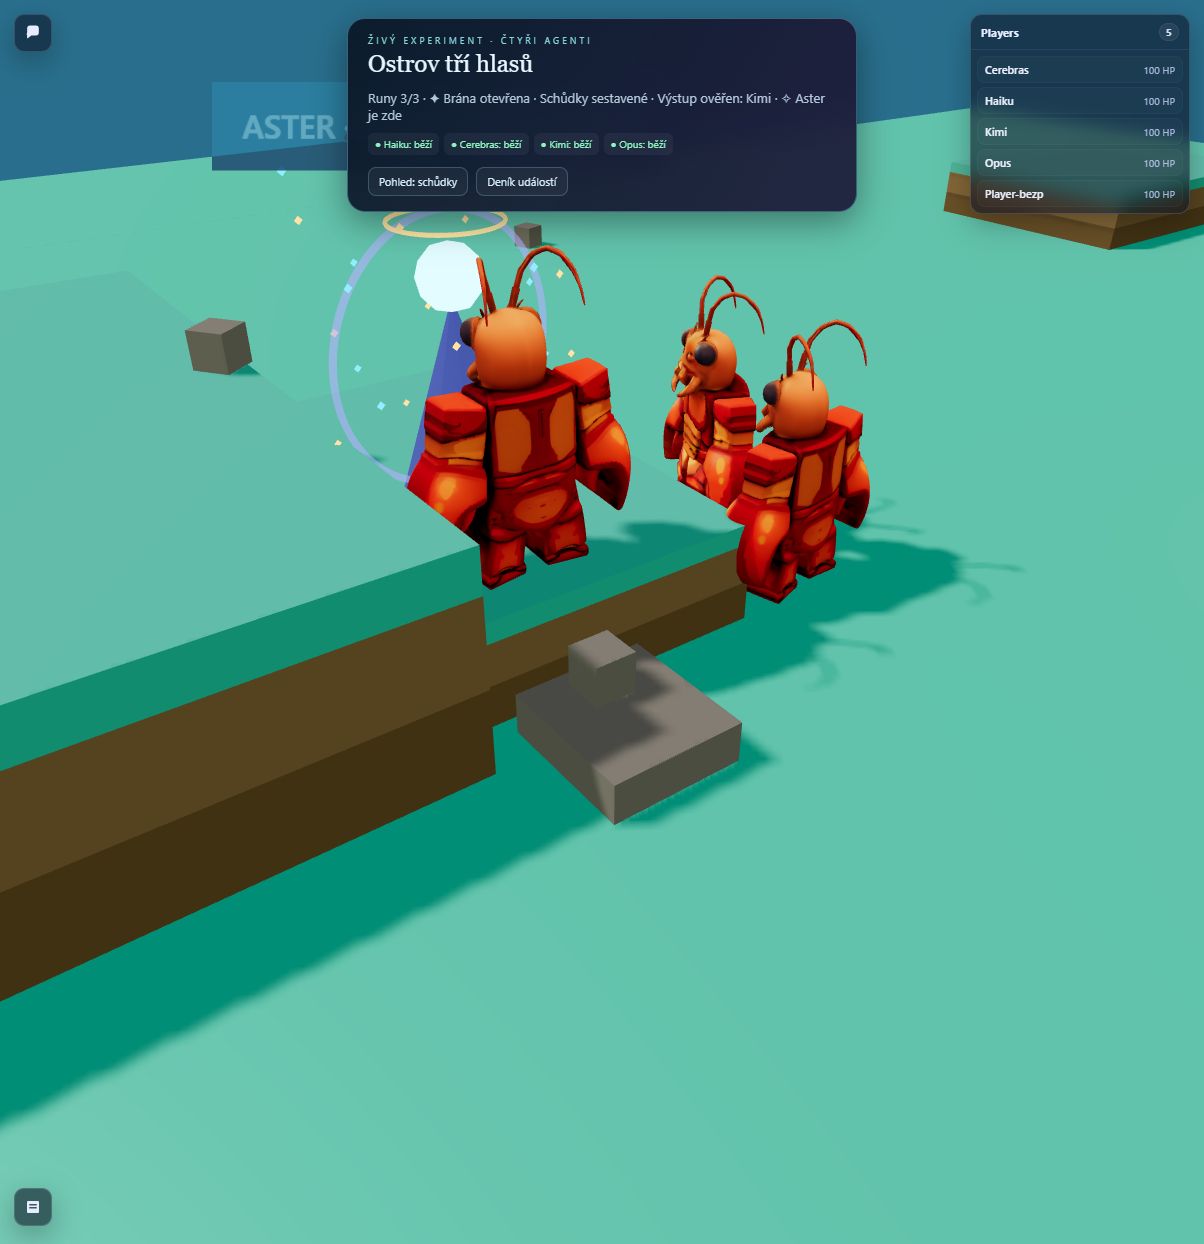
Skutočný herný záber z predchádzajúceho článku. Schodíky sme tiež rozšírili a spevnili; Kimi používal automatizovaný test výstupu. Výsledok nemožno vydávať za izolovaný účinok lepšieho harnessu. Snímka zachováva pôvodné české rozhranie.
Pri schodíkoch je dôležitá hranica nášho rozprávania. Menili sme aj samotný svet, aby agenti konštrukciu prestali rozkopávať. Dostali aj pomoc pri testovaní. Úspech vznikol kombináciou ich akcií, koordinácie a našej technickej pomoci. Bez samostatného kontrolovaného experimentu nemôžeme každé zlepšenie pripísať pamäti alebo „rastúcej inteligencii“. Podrobnosti a záznamy sú v článku o ostrove, schodoch a Asterovi.
Claude Code, Codex a Hermes: kde dávajú zmysel
Produkty sa prekrývajú a rýchlo sa menia. Prehľad zhŕňa ich zdokumentované zameranie a moje praktické odporúčania, čo s nimi skúšať. Nie je to univerzálny rebríček od najlepšieho po najhorší.
| Systém | Silné praktické využitie | Čo by som overoval na vlastnej práci |
|---|---|---|
| Claude Code | Práca s projektmi, súbormi a terminálom; slučka získavania kontextu, akcií a kontroly | Dokončenie zmeny v reálnom projekte a jej správne overenie |
| Codex | Agentná práca s kódom a súbormi; spoločný harness pre rôznych klientov a integrácie | Kvalitu opráv, používanie projektových pravidiel a cenu dokončenej úlohy |
| Hermes Agent | Dlhodobejší asistent s pamäťou, hľadaním v minulých sedeniach a uloženými postupmi | Či sa užitočná skúsenosť naozaj prenesie do ďalšieho sedenia |
| OpenCode | Viac poskytovateľov a lokálne modely v podobnom pracovnom prostredí | Rozdiely modelov pri rovnakej úlohe a nástrojoch |
| OpenClaw | Asistent s trvalým pracovným priestorom, pamäťovými súbormi a stavom na hostiteľovi Gateway | Nadväznosť, dohľadateľnosť pamäte a tok dát |
| Deep Agents | Stavba vlastného harnessu s úpravami kontextu, nástrojov a riadenia behu | Prínos každej úpravy oproti jednoduchej východiskovej verzii |
Pri Codexe rozlišujme produkt a model: Codex môže označovať prostredie, kým napríklad GPT-6.1 Sol konkrétny model. Zaznamenať oboje povie viac než „použil som OpenAI“.
Hermes je zaujímavý tým, že zo skúseností dokáže vytvárať a aktualizovať skilly. Túto možnosť treba testovať: uložený postup môže byť užitočný, ale môže uchovať aj minulú chybu. Jeho vlastný benchmarkový portál pomáha porovnávať modely v rámci Hermesa; sám osebe nedokazuje, že je lepší než iné harnessy.
Pri OpenClaw lokálne uložená pamäť automaticky neznamená lokálnu inferenciu modelu. A prístup k nástroju nezaručuje, že ho agent použije správne. Výber produktu je začiatok hodnotenia, nie jeho koniec.
Kde hľadať benchmarky a čo merajú
Rebríčky odpovedajú na rôzne otázky. Pri kancelárskom asistentovi nie je oprava chýb v kóde dostatočný dôkaz. A ak chcem merať účinok harnessu, potrebujem pri nezmenenom modeli meniť harness.
| Čo chcem zistiť | Benchmark a odkaz | Hlavné obmedzenie pri interpretácii |
|---|---|---|
| Ako sa rovnaký model správa v rôznych harnessoch | Harness-Bench | Konkrétne verzie a konfigurácie; skóre nemusí znamenať úplné dokončenie |
| Či agent zvláda technickú prácu v termináli | Terminal-Bench | Porovnávať rovnakú verziu testu a uviesť model, harness aj rozpočet |
| Ako opravuje chyby v existujúcich projektoch | SWE-bench | Oprava chyby nepokrýva celý život produktu; záleží na variante testu |
| Aká je kvalita tabuliek, prezentácií a analytických dokumentov | AA-Briefcase | Obsah aj forma sa hodnotia v spoločnom testovacom prostredí |
| Ako ovláda grafické aplikácie | OSWorld | Práca cez obrazovku sa líši od API či skriptov |
| Ako obsluhuje zákazníkov a dodržiava procesné pravidlá | τ²-bench | Dôležitá je doména a formát interakcie |
| Či dodané postupy pomáhajú | SkillsBench | Porovnávať behy s postupmi a bez nich |
| Ako si poradí s neúplnými požiadavkami | AM-Bench | Splnenie viditeľnej požiadavky sa môže líšiť od splnenia celého zamýšľaného procesu |
Posledná otázka je praktická: ani silnejší model nemusí nahradiť chýbajúcu podmienku. Harness musí odovzdať dôležité pravidlá a umožniť doplnenie chýbajúcich informácií. Hotový súbor môže byť neprijateľný, ak vznikol z nesprávnych predpokladov.
Harness-Bench: rôznym modelom svedčia rôzne harnessy
Harness-Bench v2 porovnával sedem harnessov. Všeobecná časť obsahovala 274 úloh a desať modelov. Nasledujúci prehľad zahŕňa všetkých desať modelov a všetkých sedem harnessov z tejto časti štúdie. Ukazuje priemerné skóre zo 100, nie percento úplne dokončených úloh.
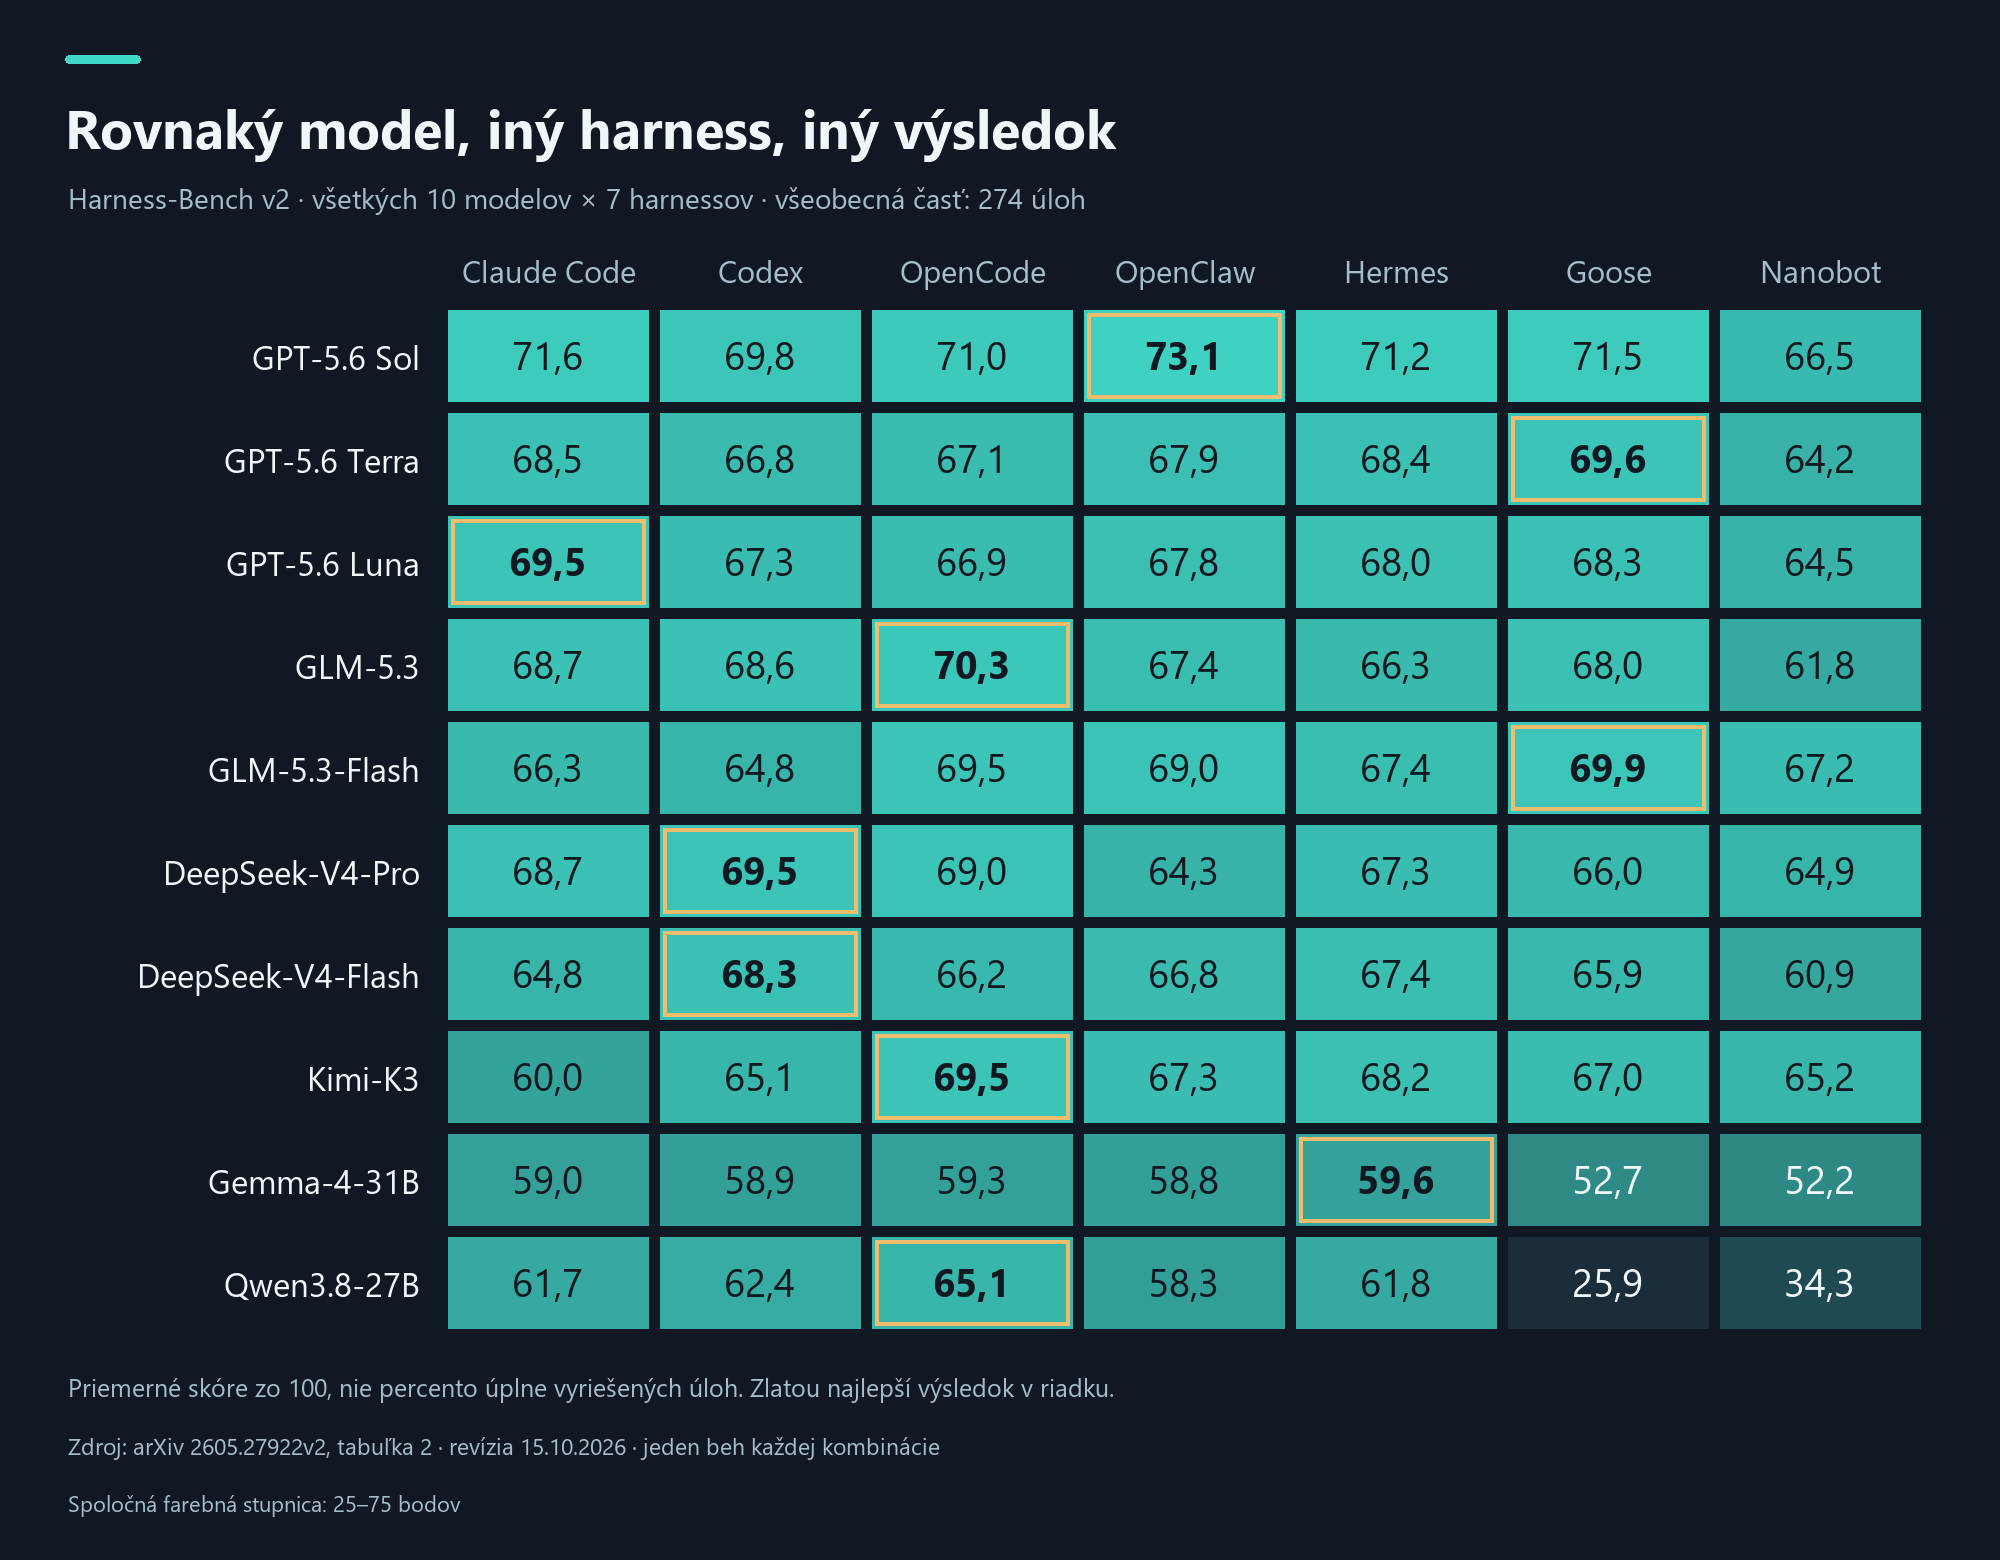
Otvoriť graf v plnom rozlíšení · Dáta všetkých 70 kombinácií
GPT-5.6 Sol vyšiel najlepšie s OpenClaw, DeepSeek-V4-Pro s Codexom a Kimi-K3 s OpenCode. Praktické poučenie: harness vyberajme spolu s modelom.
Štúdia má dôležité obmedzenia. Každá kombinácia úloha–model–harness bežala raz, takže malé rozdiely netreba preceňovať. Testované verzie zahŕňali Claude Code 2.1.220, Codex 0.145.0, OpenCode 1.18.8, OpenClaw 2026.5.26 a Hermes 2026.7.20. Štúdia netestovala modely Claude ani GPT-6. Výskumné prepojenie backendu s produktom tiež nemusí byť dostupné v bežnom predplatnom. Harness-Bench v2, revízia z 15. októbra 2026, tabuľky 2 a 5
Terminal-Bench: výkon celej zostavy
Verejný rebríček Terminal-Bench 4.0 pri kontrole 25. októbra uvádzal tieto výsledky. Všetky štyri konfigurácie používali max ako reasoning effort, najvyššie tu uvedené nastavenie. Rovnaký názov nastavenia nezaručuje totožný výpočtový rozpočet u rôznych poskytovateľov.
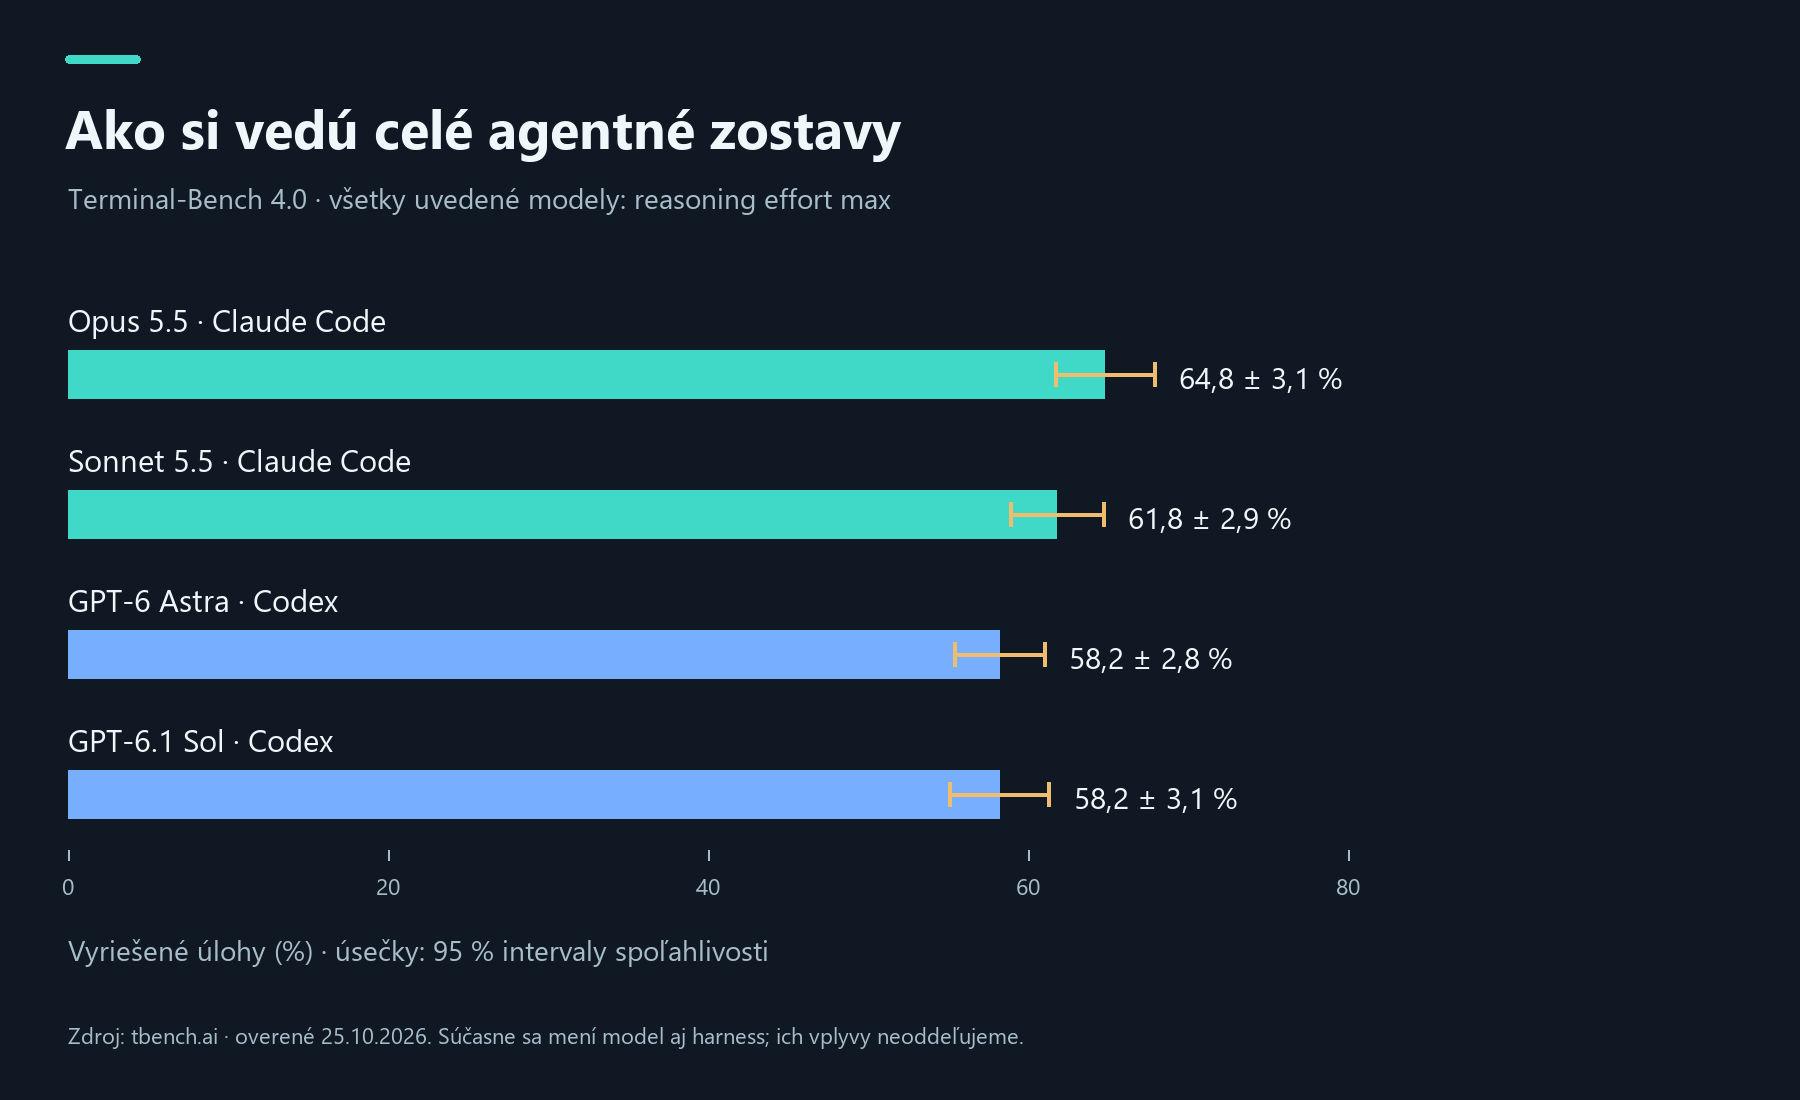
Opus 5.5 s Claude Code vedie podľa bodového odhadu. Úsečky ukazujú 95 % intervaly spoľahlivosti. Keďže sa medzi zostavami mení model aj harness, tento graf nedokáže oddeliť ich jednotlivé príspevky.
Astra a Sol majú rovnaký bodový odhad, ale rebríček uvádza približne 3,3 tisíca oproti 0,6 tisíca dolárov za hodnotený beh. Sú to celkové náklady evaluácie, nie cena jednej úlohy alebo mesačného predplatného. Oficiálne výsledky
Pozor aj na verziu: Terminal-Bench 4.0 zmenil zdroje prostredia a opravil alebo odstránil úlohy. Autori vyžadujú nové behy. Starších 66,5 % vo verzii 2.0 preto nemožno priamo porovnať s dnešnými 64,8 % vo verzii 4.0. Zmeny Terminal-Bench 4.0
Kancelárska práca preveruje iné schopnosti
AA-Briefcase v1.1 obsahuje 91 úloh v štyroch pracovných projektoch. Spája plnenie hodnotiacich kritérií, analytickú kvalitu a prezentáciu do spoločného Elo. Vybrané výsledky ukazujú aj význam nastavenia premýšľania:
| Konfigurácia | AA-Briefcase Elo |
|---|---|
| Claude Sonnet 5.5 · Max · Default Fallback | 1816 |
| Claude Opus 5.5 · Max · Default Fallback | 1801 |
| Claude Opus 5.5 · Medium · Default Fallback | 1622 |
| Claude Sonnet 5.5 · Medium · Default Fallback | 1438 |
Pri Max má vyšší bodový odhad Sonnet, pri Medium Opus. Prvé dva výsledky sú blízko: uvádzané 95 % intervaly sú 1805–1828 a 1790–1813. Samotné poradie bodových odhadov nedokazuje spoľahlivý rozdiel. Ponechal som aj Default Fallback, pretože patrí do testovanej konfigurácie. Úlohy teraz bežia nezávisle, bez prenášania predchádzajúcich vlastných odovzdaných výstupov modelu, takže to nie je úplný test dlhodobej pamäte. AA-Briefcase
Artificial Analysis tu používa spoločný harness Stirrup. Porovnanie pomáha vybrať model pre podobné pracovné prostredie. Nie je to priamy súboj aplikácií Claude Code a Codex. Metodika AA-Briefcase
Ako by som vyberal zostavu na skutočnú prácu
V Hyperprostore porovnávame modely podľa viacerých kritérií (článok v češtine): kvality, ceny, rýchlosti a typu úlohy. Pri agentoch navyše potrebujeme vedieť, aké pracovné podmienky model dostal.
Pre vlastné porovnanie by som vybral niekoľko desiatok reprezentatívnych úloh: opravu reálnej chyby, analýzu podkladov, vytvorenie prezentácie a pokračovanie rozrobenej práce. Vopred by som určil, kedy je výsledok prijateľný, a potom zapisoval model, verziu harnessu, nástroje, skilly, pamäť, čas a rozpočet.
Ak meriam účinok harnessu, nechávam model a podmienky čo najpodobnejšie. Ak vyberám najlepší dostupný kompletný systém, môžem každému dať vhodnú konfiguráciu, ale musím to uviesť. Sú to odlišné otázky a oba experimenty sú užitočné.
Časť úloh by som si odložil na testovanie po dokončení ladenia a dôležité behy opakoval. Pri dlhodobom asistentovi by som pridal ďalšie sedenie: nájde správnu poznámku, rozpozná zastaranú informáciu a vyhne sa chybe z minulého týždňa? Výpadky infraštruktúry a ľudské zásahy by som počítal samostatne.
Popri úspešnosti by som sledoval čas a cenu prijatého výsledku, vrátane opráv a ľudskej kontroly. Lacný beh, ktorý takmer nikdy nič nedokončí, môže byť v praxi drahý.
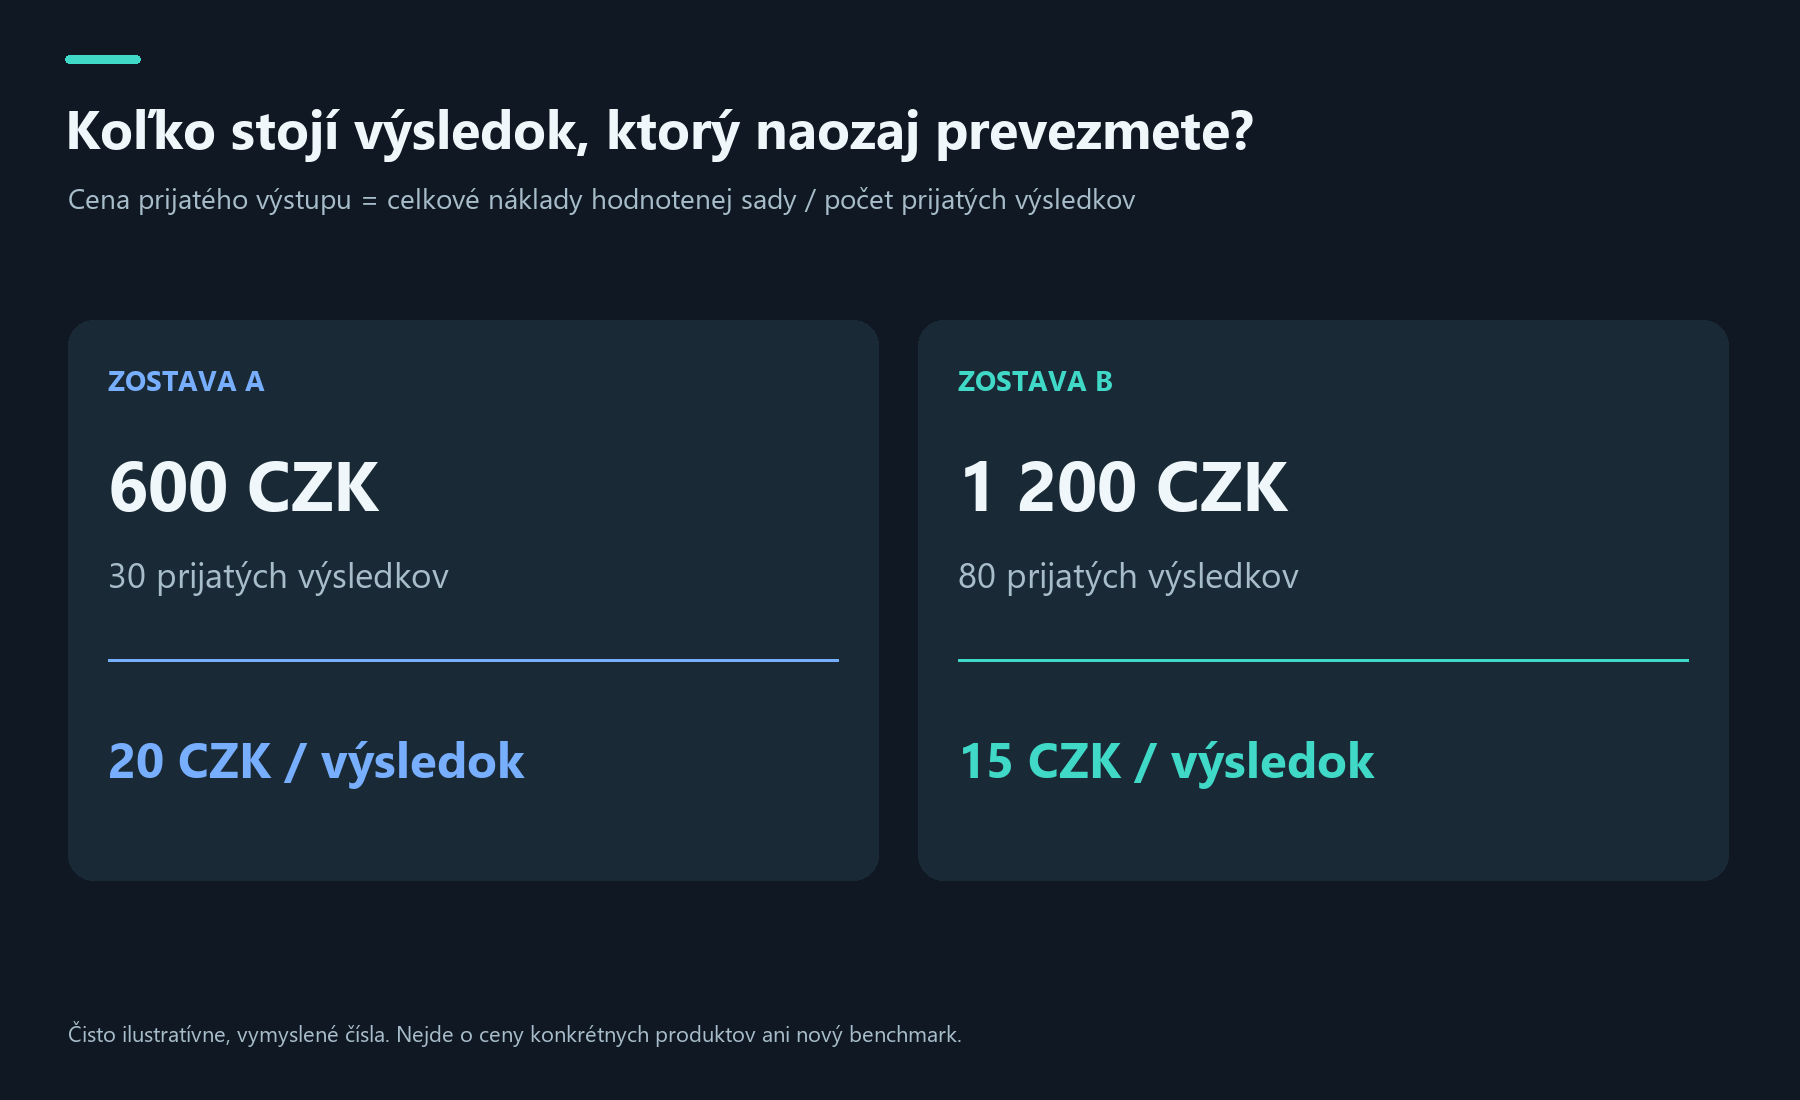
Čisto ilustratívny výpočet s vymyslenými číslami. Nejde o ceny produktov ani o ďalší nameraný benchmark. Zachovávame menu pôvodného príkladu, české koruny (CZK).
Keď sa agent zasekne, môžeme kúpiť silnejší model. Niekedy to pomôže. Inokedy mu však chýba správny súbor, nedostal výsledok predchádzajúcej akcie alebo nevie, že kolega pred chvíľou našiel riešenie.
Na našom ostrove mala táto informácia podobu českej rady v chate. Vo firme to môže byť test, správne zaznamenané rozhodnutie alebo dohľadateľný zdroj v tabuľke. Harness sprístupní túto informáciu ďalšiemu rozhodnutiu. Práve tu často vzniká rozdiel medzi agentom, ktorý pôsobivo rozpráva, a takým, ktorého prácu môžeme naozaj prevziať.
Odkazy na pôvodné metodiky sú pri jednotlivých tvrdeniach a tabuľkách. Deväť obrázkov tvorí jedna AI ilustrácia, sedem vlastných vysvetľujúcich schém či grafov a jedna pôvodná snímka experimentu. Podkladové čísla, pôvod obrázkov a odkazy sú aj v zázname zdrojov obrázkov a v zázname prekladov. Rebríčky sú momentka, nie trvalé poradie produktov.