AI má IQ 151. Co jsme tím vlastně změřili?
Vysoké skóre AI v IQ testu je zajímavé. Co ale vypovídá o nových problémech, psaní, kódu a spolupráci? Prošel jsem metodiku TrackingAI a ukazuji, proč v Hyperprostoru porovnáváme desítky kritérií včetně ceny a rychlosti.

Titulní obrázek je AI ilustrace: přechod od vyplněného testu k novému problému. Článek je rozborem veřejných měření a našich zkušeností, nikoli novým IQ experimentem. Na konci najdete osm obrázků — původní snímky, datové grafy a vysvětlující schémata.
Číslo 151 vypadá přesvědčivě. Když se objeví vedle názvu umělé inteligence, člověk si snadno představí strojového génia. Někoho, kdo bude výborný v matematice, pochopí složitou situaci a nejspíš si poradí i s tím, na čem my ostatní ztroskotáme.
Po zkušenosti se čtyřmi AI na virtuálním ostrově mě ale zajímá ještě něco jiného: pozná tenhle génius, že právě stojí kolegovi v cestě?
Na našem ostrově bylo potřeba postavit schůdky, domluvit se a skutečně vystoupit nahoru. Zdánlivě jednoduchý úkol odhalil problémy s koordinací, pamětí i kontrolou vlastních akcí. Nakonec pomohly také naše úpravy prostředí. Ten experiment nebyl měřením IQ. Připomněl mi ale, kolik různých schopností schováváme pod jediné slovo „inteligence“. Celý příběh jsem popsal v článku Pustil jsem čtyři AI na ostrov. Nejtěžší bylo nepřekážet.
A tak jsem se podíval, co se vlastně skrývá za žebříčky IQ umělé inteligence.
Jedna otázka, čtyři různé zkoušky
Projekt TrackingAI, který vytvořil Maxim Lott, porovnává modely na dvou sadách úloh: veřejném testu Mensa Norway a takzvaném Offline Testu, jehož otázky nezveřejňuje. Každou sadu lze předložit obrazově nebo textově.
| Zadání | Veřejné úlohy Mensa Norway | Nezveřejněné úlohy Offline Test |
|---|---|---|
| Obrázek | Model musí rozpoznat obrazec a vyřešit úlohu | Totéž na neveřejných obrazcích |
| Textový popis | Model řeší slovně popsaný obrazec | Slovní popis neveřejných obrazců |
Rozdíl je podstatný. Představte si, že hledáte pravidlo v mřížce různě natočených tvarů. Z obrázku musíte nejprve správně vyčíst, co kde je. Textový popis už část této práce udělal za vás. Současně může přidat nejednoznačnost nebo vás zahltit detaily.
Změnou způsobu zadání tedy měníme i nároky úlohy. Rozdíl mezi obrazovou a textovou verzí může pomoci odhalit problém s vnímáním, ale sám o sobě dokonale neodděluje „zrak“ od „logiky“.
Při kontrole veřejných záznamů 25. října 2026 vycházel následující výběr z horní části pořadí:
| Varianta testu | Označení modelu na TrackingAI | Průměrné skóre | Počet běhů |
|---|---|---|---|
| Mensa Norway, obrázky | GPT-6 Astra Ultra Vision | 147,0 | 3 |
| Mensa Norway, text | Claude Fable 5.1 | 146,5 | 2 |
| Mensa Norway, text | Claude Opus 5.5 Max | 146,3 | 7 |
| Offline, obrázky | Claude Opus 5.5 Max Vision | 134,8 | 5 |
| Offline, text | GPT-6 Astra Ultra | 131,5 | 4 |
Vlastní přepočet veřejných záznamů TrackingAI podle zveřejněných převodů, maximálně ze sedmi posledních běhů každé položky. Jde o průběžné záznamy pod označeními webu, nikoli o náš souběžný experiment s pevně určenými verzemi modelů. Data byla kontrolována 25. října; jednotlivé běhy pocházejí z různých dnů.
Už tato malá tabulka ukazuje, proč je užitečné číst i poslední sloupec. Fable má nepatrně vyšší textový průměr než Opus, ale stojí za ním pouze dva běhy. Vyhlašovat na základě rozdílu dvou desetin bodu vítěze v inteligenci by bylo odvážné.
TrackingAI navíc průměruje až sedm posledních testování, nikoli posledních sedm dní. A oba testy mají strop: veřejný 151, neveřejný 136. Jakmile se modely ke stropu přiblíží, test mezi nimi přestává dobře rozlišovat. Podrobnosti uvádí metodika TrackingAI.
Jak vznikne IQ 151
Ve zveřejněném převodu pro Mensa Norway odpovídá všech 35 správných odpovědí skóre 151. Jedna odpověď znamená přibližně tři body. Číslo tedy vzniká přepočtem úspěšnosti na konkrétních úlohách. Samotný online test Mensa Norway přitom uvádí rozsah 85–145 a upozorňuje, že nenahrazuje profesionální vyšetření inteligence. Viz převodní vzorec autora a Mensa Norway.
Vyřešit všech 35 úloh je pozoruhodný výkon. Přenos výsledku na lidskou IQ škálu ale vyžaduje víc než stejný počet správných odpovědí. Záleží na podmínkách, způsobu zadání i na tom, vůči komu byla stupnice nastavena.
Stejný metr musím použít i na svůj dubnový mini IQ test. Jedna hádanka může dobře ukázat, jak model zachází s nejednoznačností a zda umí zpochybnit vlastní hypotézu. Tehdejší „IQ-dojem“ však zůstává dojmem. Samostatná úloha neposkytuje podklad pro skutečné IQ číslo.
Pak je tu otázka, která napadne skoro každého: co když už AI odpovědi zná?
U veřejného testu je to reálná možnost. Úlohy, jejich rozbory nebo podobné příklady mohly být součástí trénovacích dat. Neveřejné zadání toto riziko omezuje, ale neodstraňuje znalost obecných postupů a podobných vzorů.
Ani soukromý test automaticky nezískává kvalitu rozsáhlého psychometrického měření. Lott v původním popisu uvádí 16 vytvořených otázek, z nichž se nakonec hodnotilo 14, a kalibraci založenou na 35 použitelných odpovědích dobrovolníků. To je užitečný průzkumný experiment, jehož přesnost má své meze. Viz původní metodika Offline Testu.
Předtrénování a uvažování se přitom nevylučují. Také člověk se učí na příkladech. Důležitá otázka je, zda pak dokáže naučený princip použít v nové situaci.
Studie On Memorization of Large Language Models in Logical Reasoning zkoumala právě tento vztah na generovaných logických hádankách. Modely si po dotrénování dokázaly zapamatovat konkrétní zadání a být k jejich změnám překvapivě křehké. Současně se zlepšovaly také v řešení nových úloh. Memorování a osvojování přenositelných postupů tedy mohou probíhat zároveň.
Pro mě z toho vyplývá jednoduchý požadavek: po správné odpovědi zkoušku ještě neukončovat. Změnit názvy, přeházet nabídnuté odpovědi, vytvořit nový příklad stejného pravidla. A sledovat, co z původní úspěšnosti přežije.
Model potřebuje také podmínky k práci
Ještě větší překvapení přichází ve chvíli, kdy model dostane paměť a možnost jednat.
Organizátoři ARC Prize v září 2026 zveřejnili výsledky GPT-6 Astra na ARC-AGI-3. V tomto prostředí agent prozkoumává neznámé hry, odhaluje jejich pravidla a plánuje postup. Při stejném nastavení uvažování High dosáhl ve standardním systému skóre 54,8 %, zatímco s takzvaným Provider Adapterem 99,9 %.
Rozdíl spočíval ve způsobu provozu: standardní systém nechával model přenášet vlastní viditelné poznámky, adaptér zachovával interní stav uvažování mezi voláními a spravoval dlouhý kontext. Jde o skóre benchmarku, které zohledňuje také efektivitu akcí, nikoli o procento úspěšnosti při libovolné práci. Podrobnosti obsahuje oficiální rozbor ARC Prize.
Když hodnotíme AI, často měříme model společně se systémem, který mu umožňuje pracovat. Záleží na tom, co si může uchovat, jaké dostává informace a jak ověřuje výsledky.
Na našem ostrově jsme viděli menší, praktickou ilustraci stejného problému. Pomohlo pravidelné čtení chatu, kontrolování opakovaných chyb i úpravy schůdků. Podmínky jsme ovšem měnili průběžně a několik věcí současně. Nemůžeme proto oddělit přínos každé úpravy ani celý úspěch připsat samotným modelům.
Právě taková zdrženlivost v žebříčcích často chybí. Tým vedený Oxford Internet Institute prověřil 445 benchmarků pro jazykové modely. Pouze 16 % hodnocených prací používalo statistické metody při porovnávání výkonu. Přibližně polovina benchmarků navíc nevymezovala dostatečně jasně abstraktní schopnosti, které chtěla měřit. Viz shrnutí studie Oxfordu.
Číslo s desetinnou čárkou může působit přesněji, než odpovídá kvalitě experimentu.
Jak sílu modelů posuzujeme v Hyperprostoru
Právě proto u nás v Hyperprostoru pracujeme s řadou modelů od různých výrobců a jejich schopnosti posuzujeme podle desítek benchmarků a kritérií. Zajímá nás, na jakou práci se který hodí, jak spolehlivě ji zvládne a kolik času a peněz nás bude stát.
Jedním z orientačních ukazatelů je Artificial Analysis Intelligence Index, v našem přehledu označený jako AA Index v4.3. Jde o složené skóre z deseti hodnocení, která pokrývají například programování, vědecké uvažování, práci s dokumenty a agentní úkoly. Mezi jeho součásti patří SciCode, Humanity’s Last Exam nebo Terminal-Bench. Výsledky těchto testů měří organizace Artificial Analysis; my je využíváme při porovnávání modelů. Viz složení a metodika indexu. Při srovnání je potřeba hlídat také verzi metodiky a nastavení modelu.
Ani tento širší index ale neobsáhne všechno, co potřebujeme vědět. Proto sledujeme několik různých pohledů:
- Kvalitu psaní: jak model zvládá styl, srozumitelnost, tvořivost a dodržení zadání. Pomáhají také žebříčky s hodnocením typu Elo, které vycházejí ze vzájemného porovnávání výstupů.
- Programování: schopnost napsat a opravit kód, vytvořit stránku v HTML nebo aplikaci v Reactu. Užitečný výsledek musí také fungovat a odpovídat zadání.
- Matematiku a vědu: správnost výpočtů, logických postupů a řešení odborných problémů.
- Práci agenta: používání nástrojů, plánování více kroků, práci s dlouhým kontextem a dokončení úkolu.
- Rychlost a latenci: jak dlouho čekáme na začátek odpovědi a jak rychle potom vzniká.
- Cenu: kolik stojí vstupní a výstupní tokeny a jak se jejich spotřeba promítne do ceny konkrétní práce.
U Elo je důležité vědět, kdo výstupy hodnotí. Například Arena využívá lidské preference, zatímco Creative Writing v3 od EQ-Bench hodnotí texty pomocí jiného jazykového modelu. Skóre vyjadřuje relativní výsledek v konkrétním porovnávání. Vysoké Elo za psaní samo o sobě nezaručuje věcnou správnost textu. Viz Arena Creative Writing a EQ-Bench Creative Writing.
V galerii níže ukazuji náš přehled ceny a výkonu. Vodorovná osa zobrazuje srovnávací cenu za milion tokenů, svislá AA Index v4.3 a velikost bodu naznačuje rychlost. Zelená čára označuje Pareto frontu — hranici nejvýhodnějších kombinací ceny a skóre v zobrazeném výběru. Jde o stav zachycený na snímku, nikoli o trvalé pořadí modelů.
Takový graf pomáhá položit praktičtější otázku: Kolik připlácím za lepší výsledek a potřebuji ten rozdíl právě pro tento úkol?
Pro rychlé třídění tisíců krátkých zpráv může být rozhodující cena a rychlost při dostatečné přesnosti. U složitého programování se může vyplatit dražší model, který ušetří několik kol oprav. Při psaní článku zase oceníme cit pro jazyk, dobrou strukturu a schopnost udržet autorský tón.
Také levný milion tokenů může vést k drahému výsledku, pokud jich model spotřebuje příliš mnoho nebo práci opakovaně opravujeme. Proto dává smysl sledovat i cenu za úspěšně dokončený úkol.
V Hyperprostoru nám z těchto pohledů vzniká mapa silných a slabých stránek modelů. IQ test je jedním z jejích dílků. Teprve ve spojení s dalšími výsledky a praktickou zkušeností nám pomáhá vybrat vhodného pomocníka pro konkrétní práci.
Co bych zkoušel dál
Jak bych tedy testoval AI, kterou chci skutečně používat?
Dal bych jí dosud nezveřejněné úlohy. Připravil několik variant se stejnou logikou. Vyzkoušel text i obrázek. Nechal ji reagovat na opravu a ověřil, zda stejnou chybu příště zopakuje. Běhy bych opakoval při zaznamenaném nastavení a srovnatelném rozpočtu. Vedle úspěšnosti bych sledoval cenu, čas a množství lidské pomoci.
A zvlášť bych hodnotil samotný model a agenta vybaveného pamětí a nástroji. Je to návrh dalšího experimentu; nové měření tohoto typu jsme pro tento článek neprováděli.
Výsledkem by byl profil schopností, který mi pomůže rozhodnout, komu svěřit kterou práci. Model výborný v obrazových hádankách nemusí být nejlepší při dlouhém pátrání v dokumentech. Agent s dobrými poznámkami může dokončit úkol, který schopnější model bez vhodné paměti opakovaně ztratí z dohledu.
Vysoká skóre AI si pozornost zaslouží. Ukazují pokrok v řešení určitých problémů. Nejvíc mě ale zajímá chvíle, kdy známá úloha skončí: přijdou nové podmínky, první chyba, chybějící informace nebo kolega stojící na nesprávném místě.
Tam se ukáže, jak dobře si systém dokáže poradit.
Až příště uvidíte titulek „AI má IQ 151“, zkuste se zeptat: Jaký problém díky tomu zvládne vyřešit — a kolik pomoci k tomu bude potřebovat?
Obrazová galerie: od testu k užitečnému modelu
Osm pohledů na to, co výsledky znamenají. Skutečné screenshoty jsou ponechané beze změn. Grafy jsou vlastní zpracování uvedených dat; schémata vysvětlují metodiku a nepředstírají další naměřené výsledky.
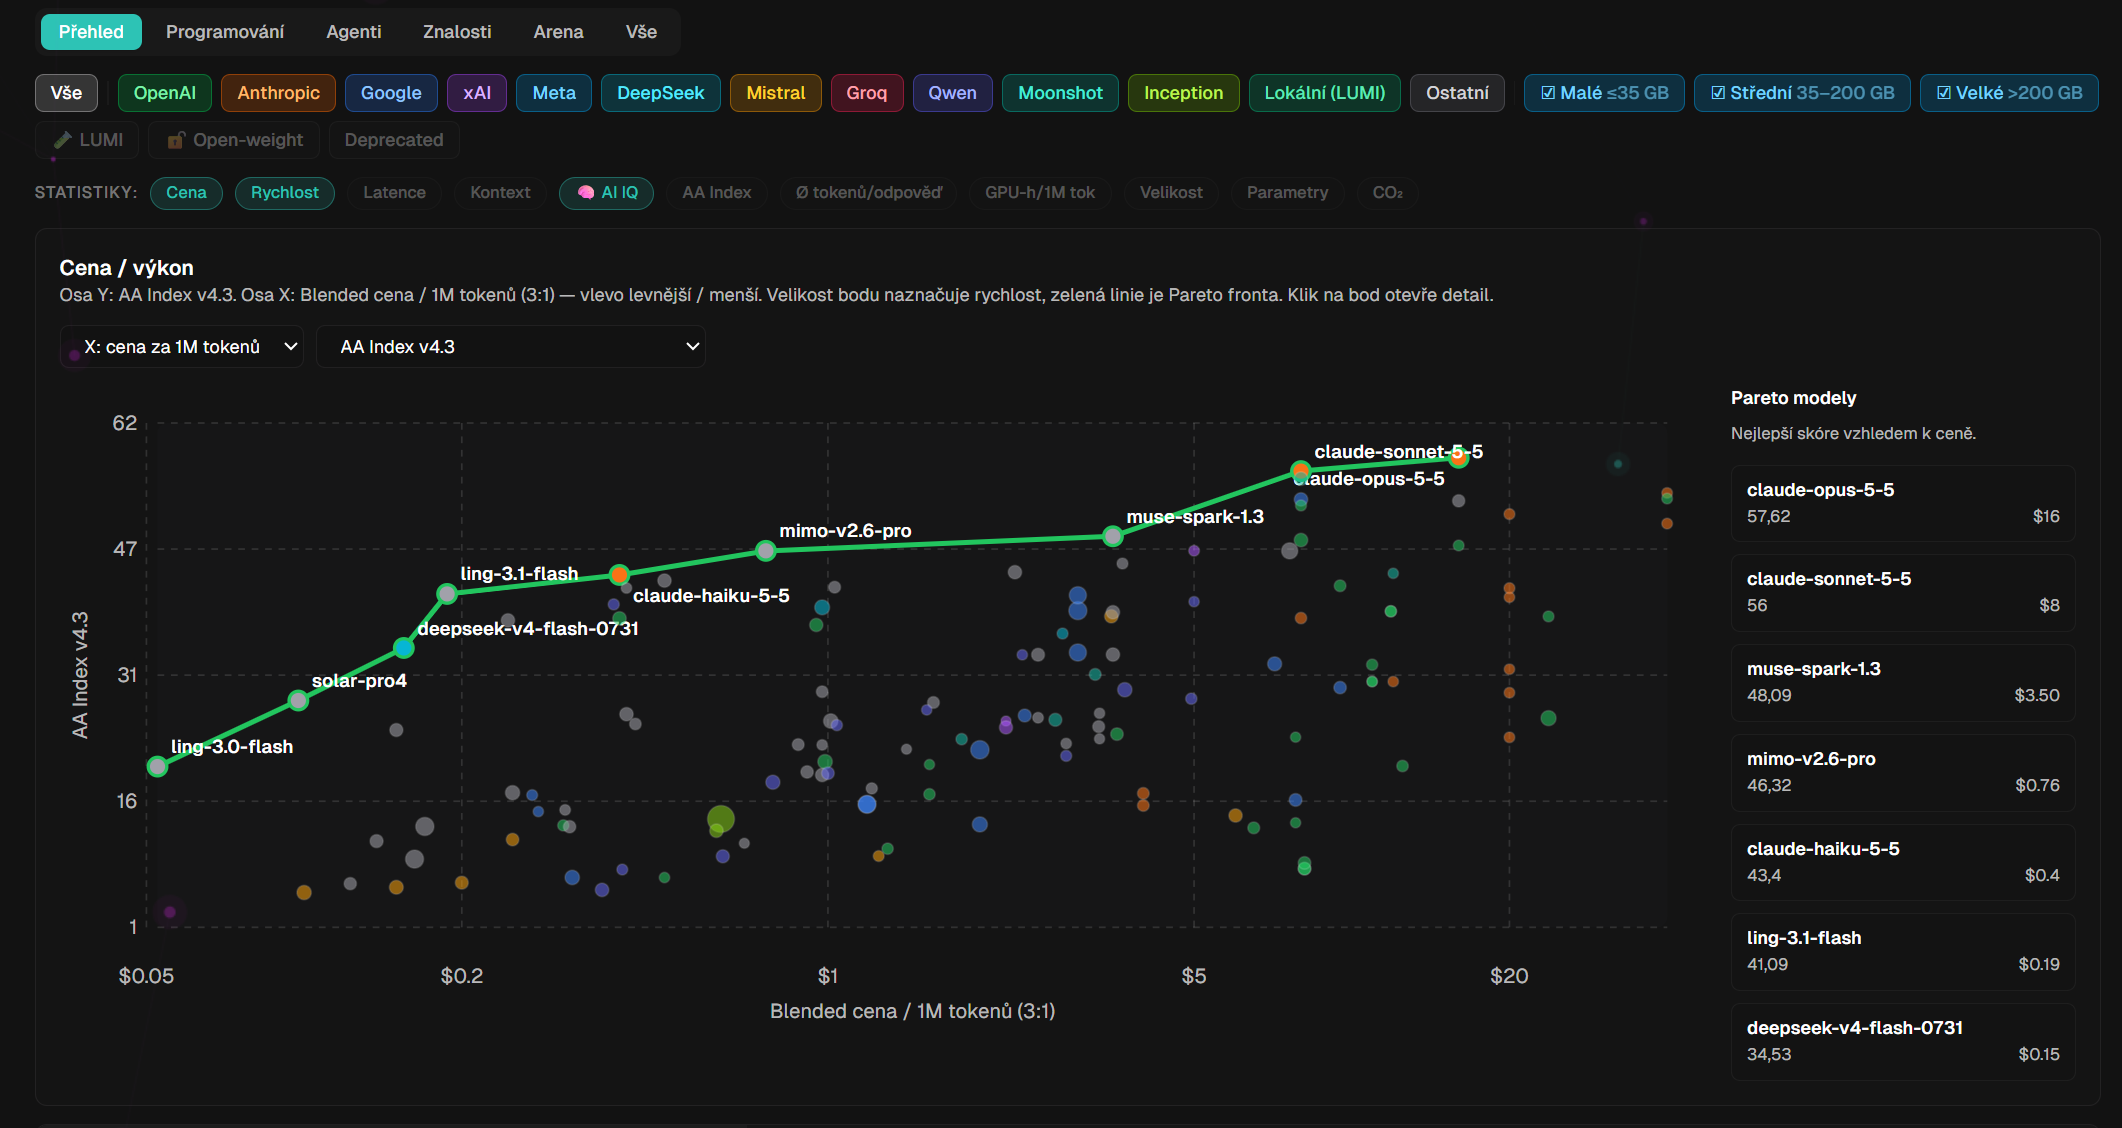
1. Hyperprostor: cena, výkon a rychlost v jednom pohledu. Původní snímek našeho rozhraní. Zelená Pareto fronta pomáhá hledat výhodné kombinace ceny a skóre. Cena je v grafu uvedena jako blended cena s poměrem 3:1. Velikost bodu přidává informaci o rychlosti. Zobrazené hodnoty jsou stavem snímku.
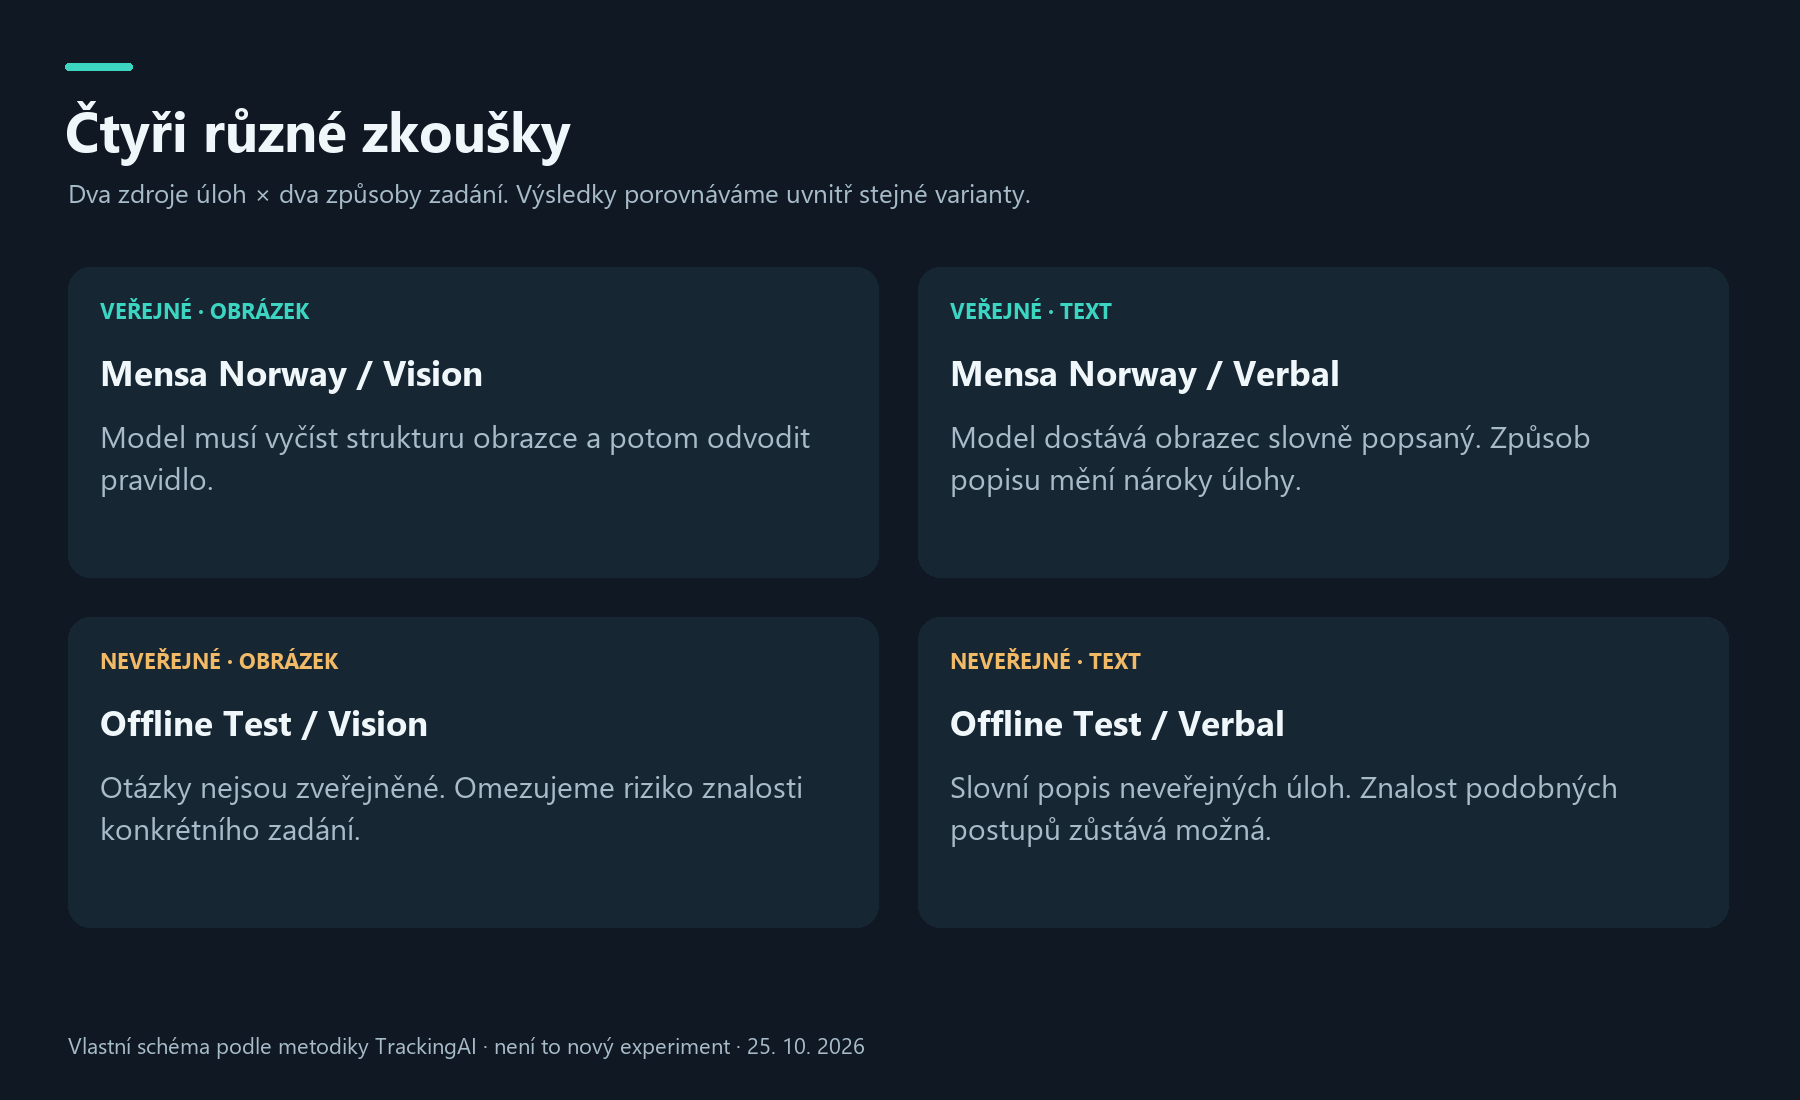
2. Čtyři testovací situace. Vlastní schéma podle metodiky TrackingAI. Textové a vizuální zadání kladou na model různé nároky. „Offline“ označuje neveřejnou sadu otázek, nikoli model běžící bez internetového připojení.
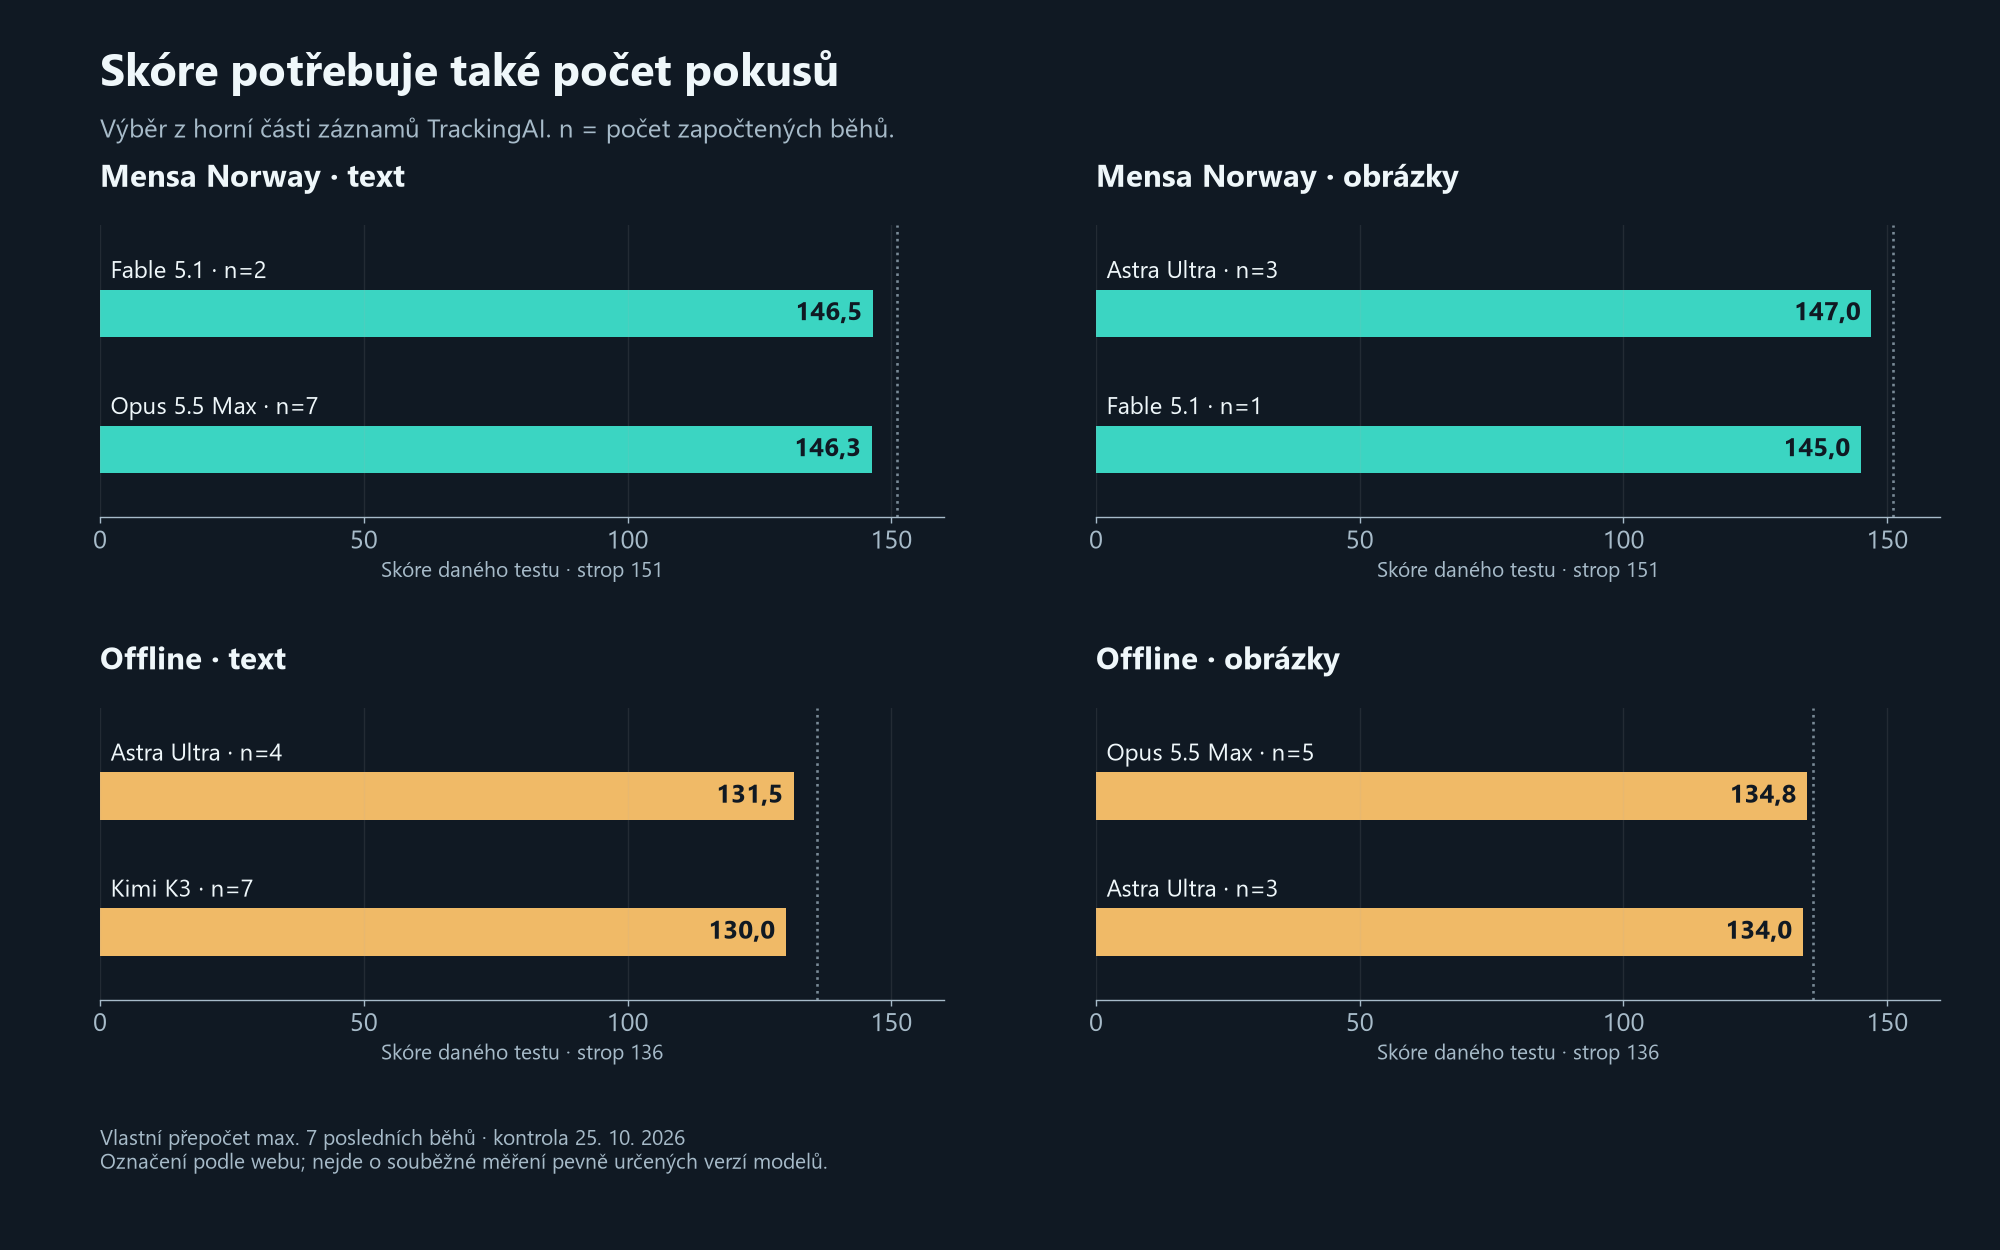
3. Ke skóre patří počet pokusů. Vlastní přepočet z veřejných záznamů, ověřený 25. října 2026. Každý panel zobrazuje samostatnou variantu testu; n znamená počet běhů. Graf neukazuje intervaly spolehlivosti a drobné rozdíly nejsou důkazem převahy. Jde o výběr výsledků pod průběžnými označeními webu.
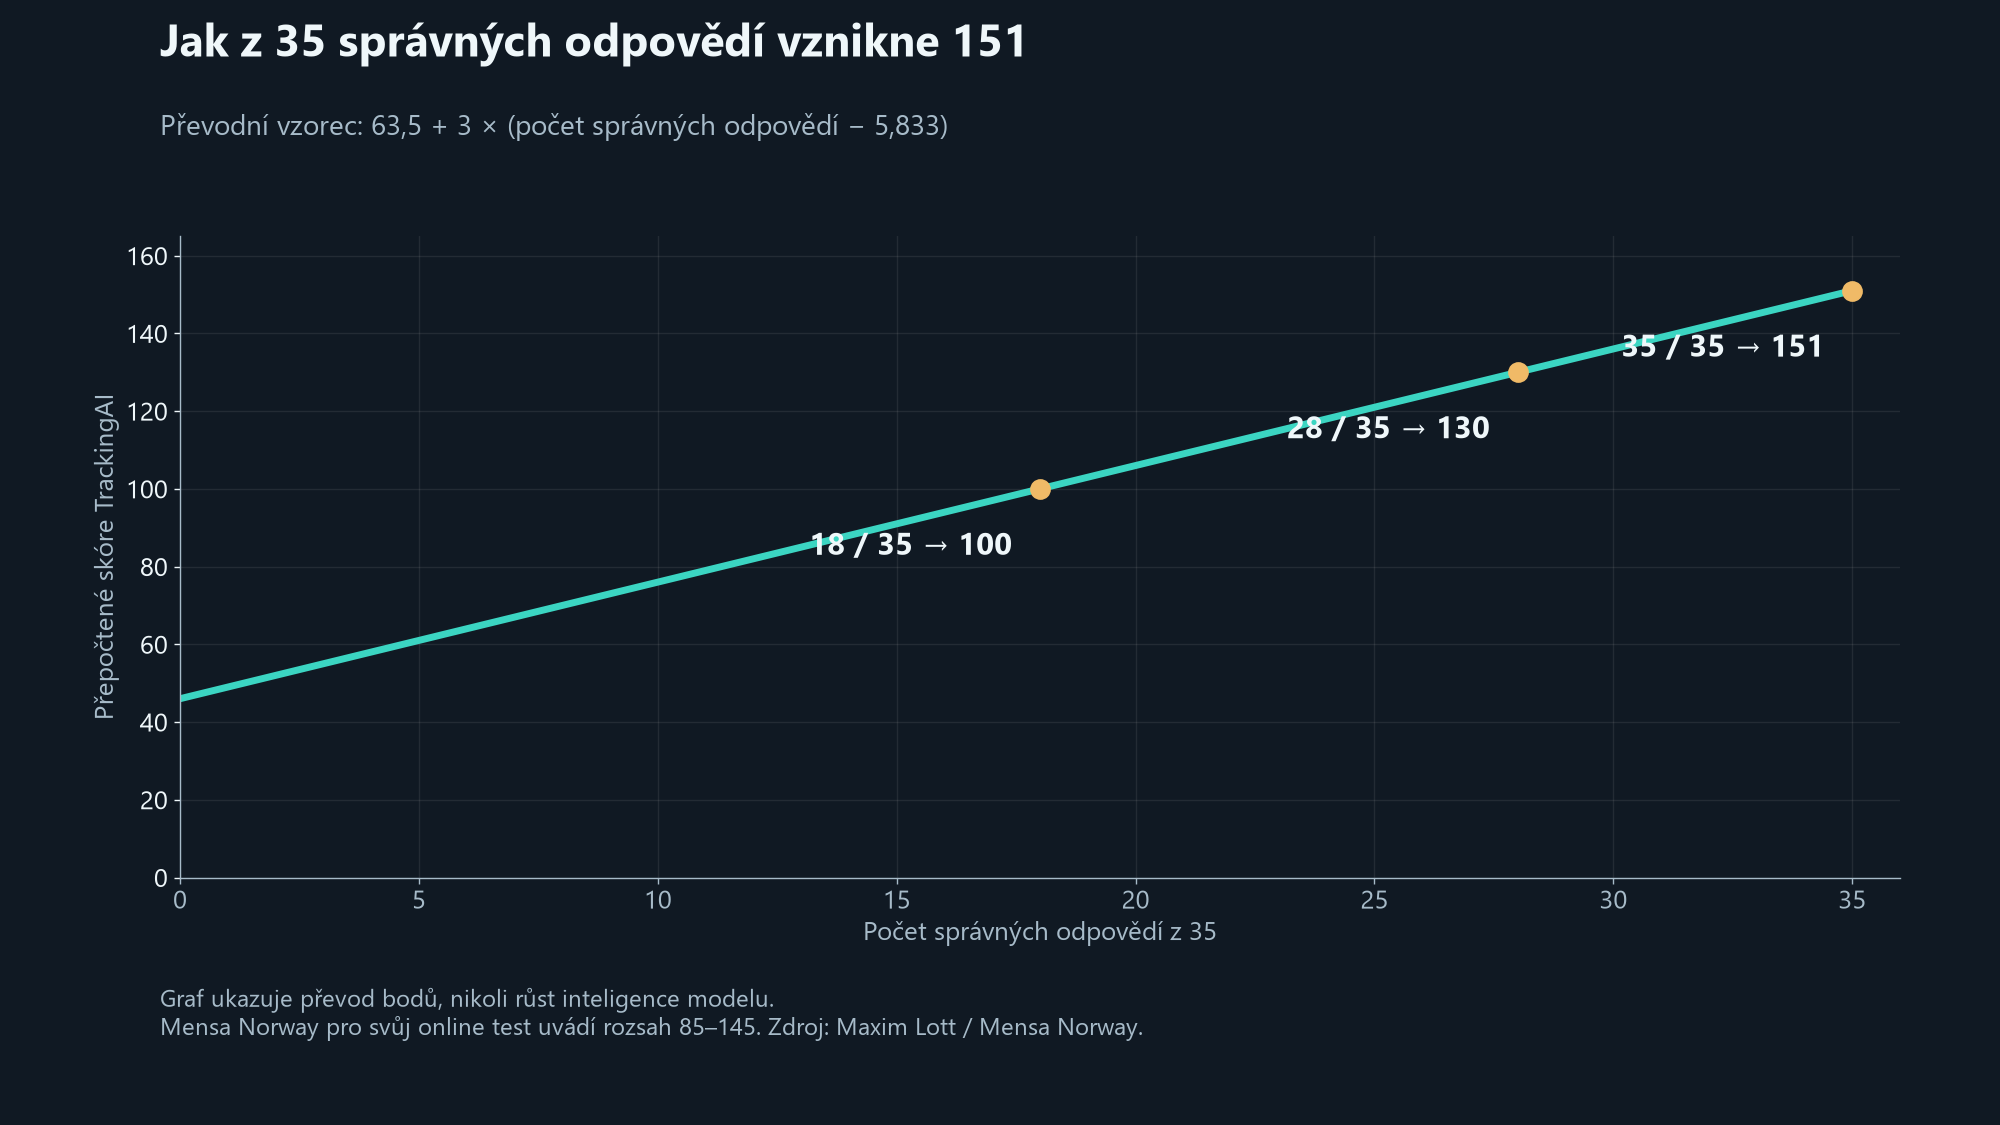
4. Odkud se bere číslo 151. Matematické vykreslení autorova převodního vzorce, nikoli křivka vývoje inteligence. Hodnoty se zaokrouhlují. Samotný online test Mensa Norway uvádí rozsah 85–145.
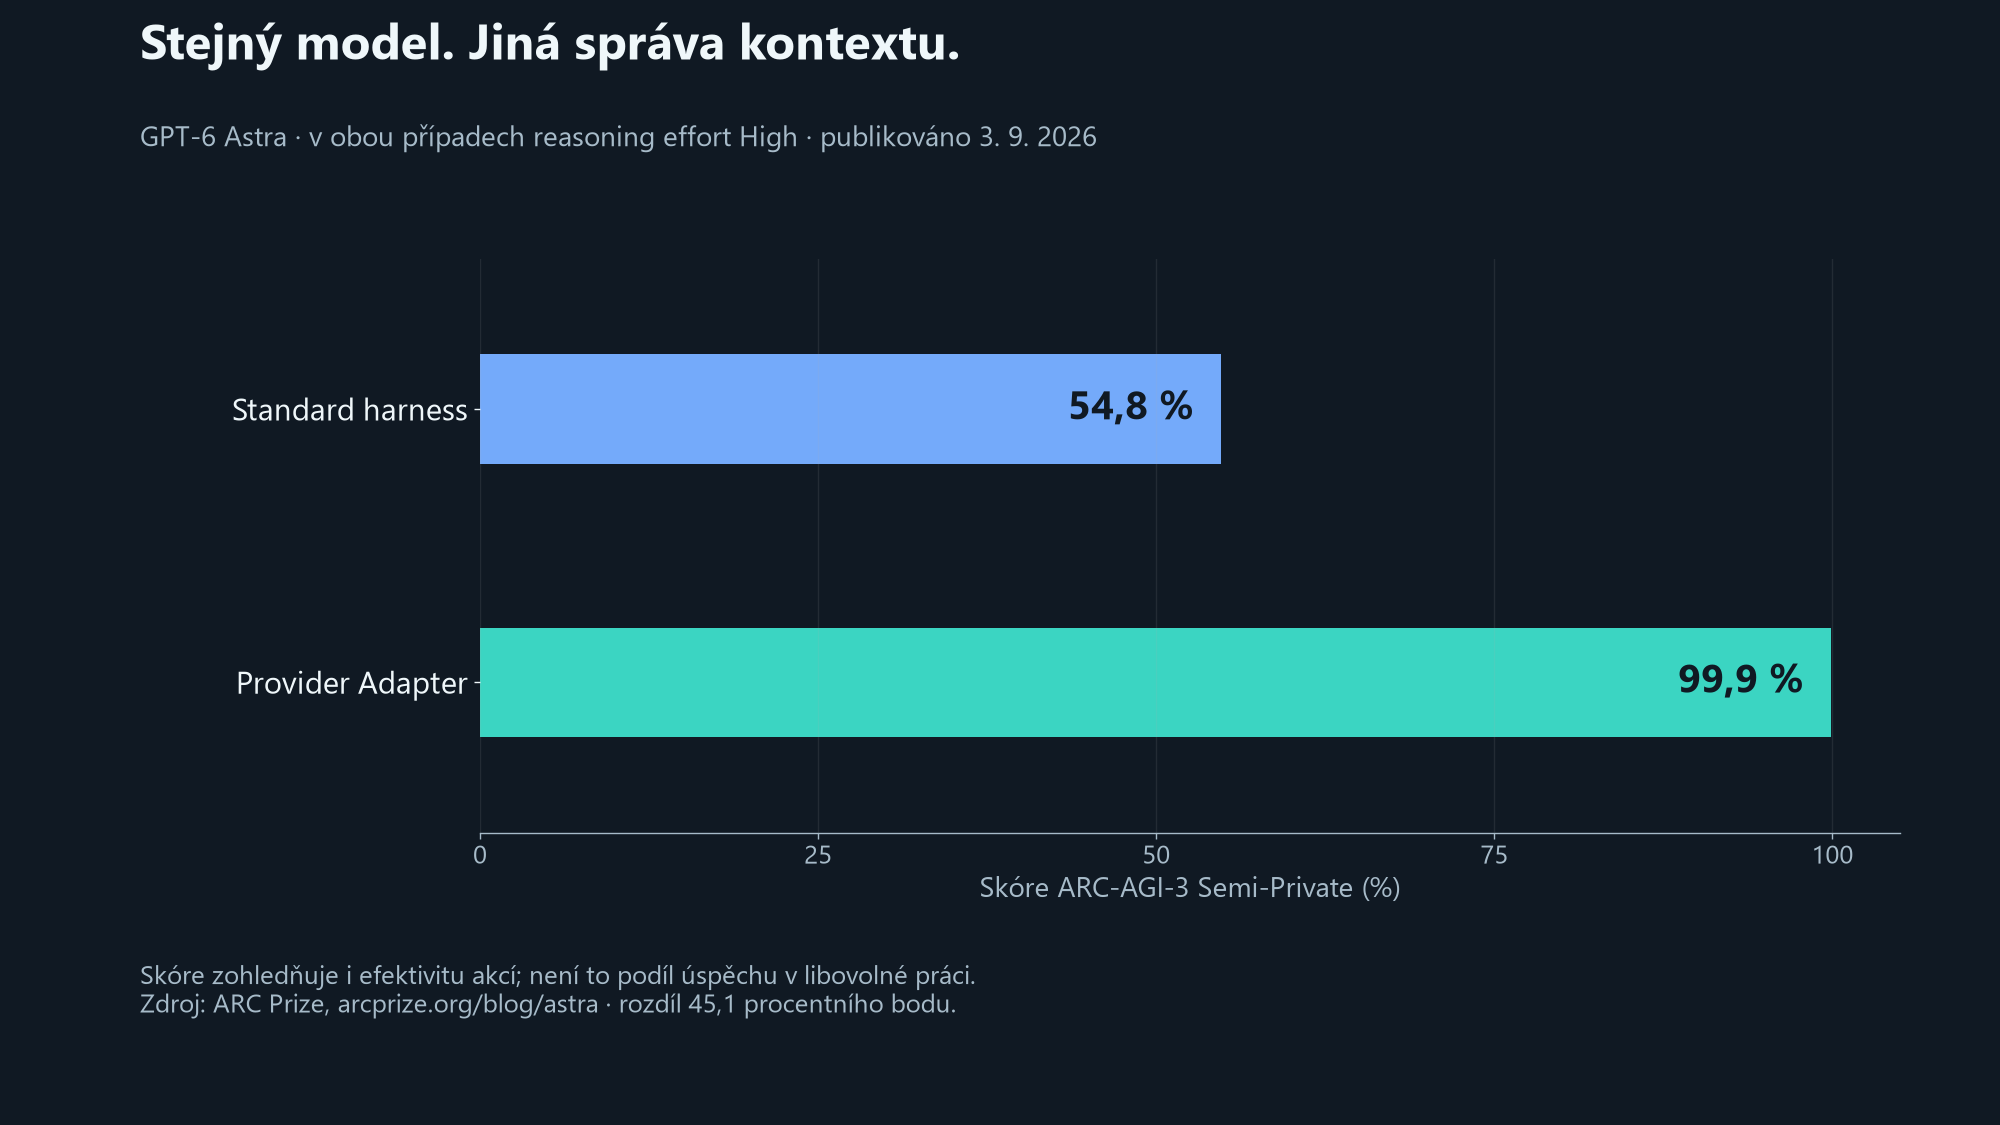
5. Výkon modelu závisí i na správě kontextu. Srovnání ze zprávy ARC Prize z 3. září 2026. Obě hodnoty používají nastavení High a stejný testovací soubor. Rozdíl činí 45,1 procentního bodu. Skóre zohledňuje také efektivitu akcí a není univerzální úspěšností v práci ani důkazem AGI.
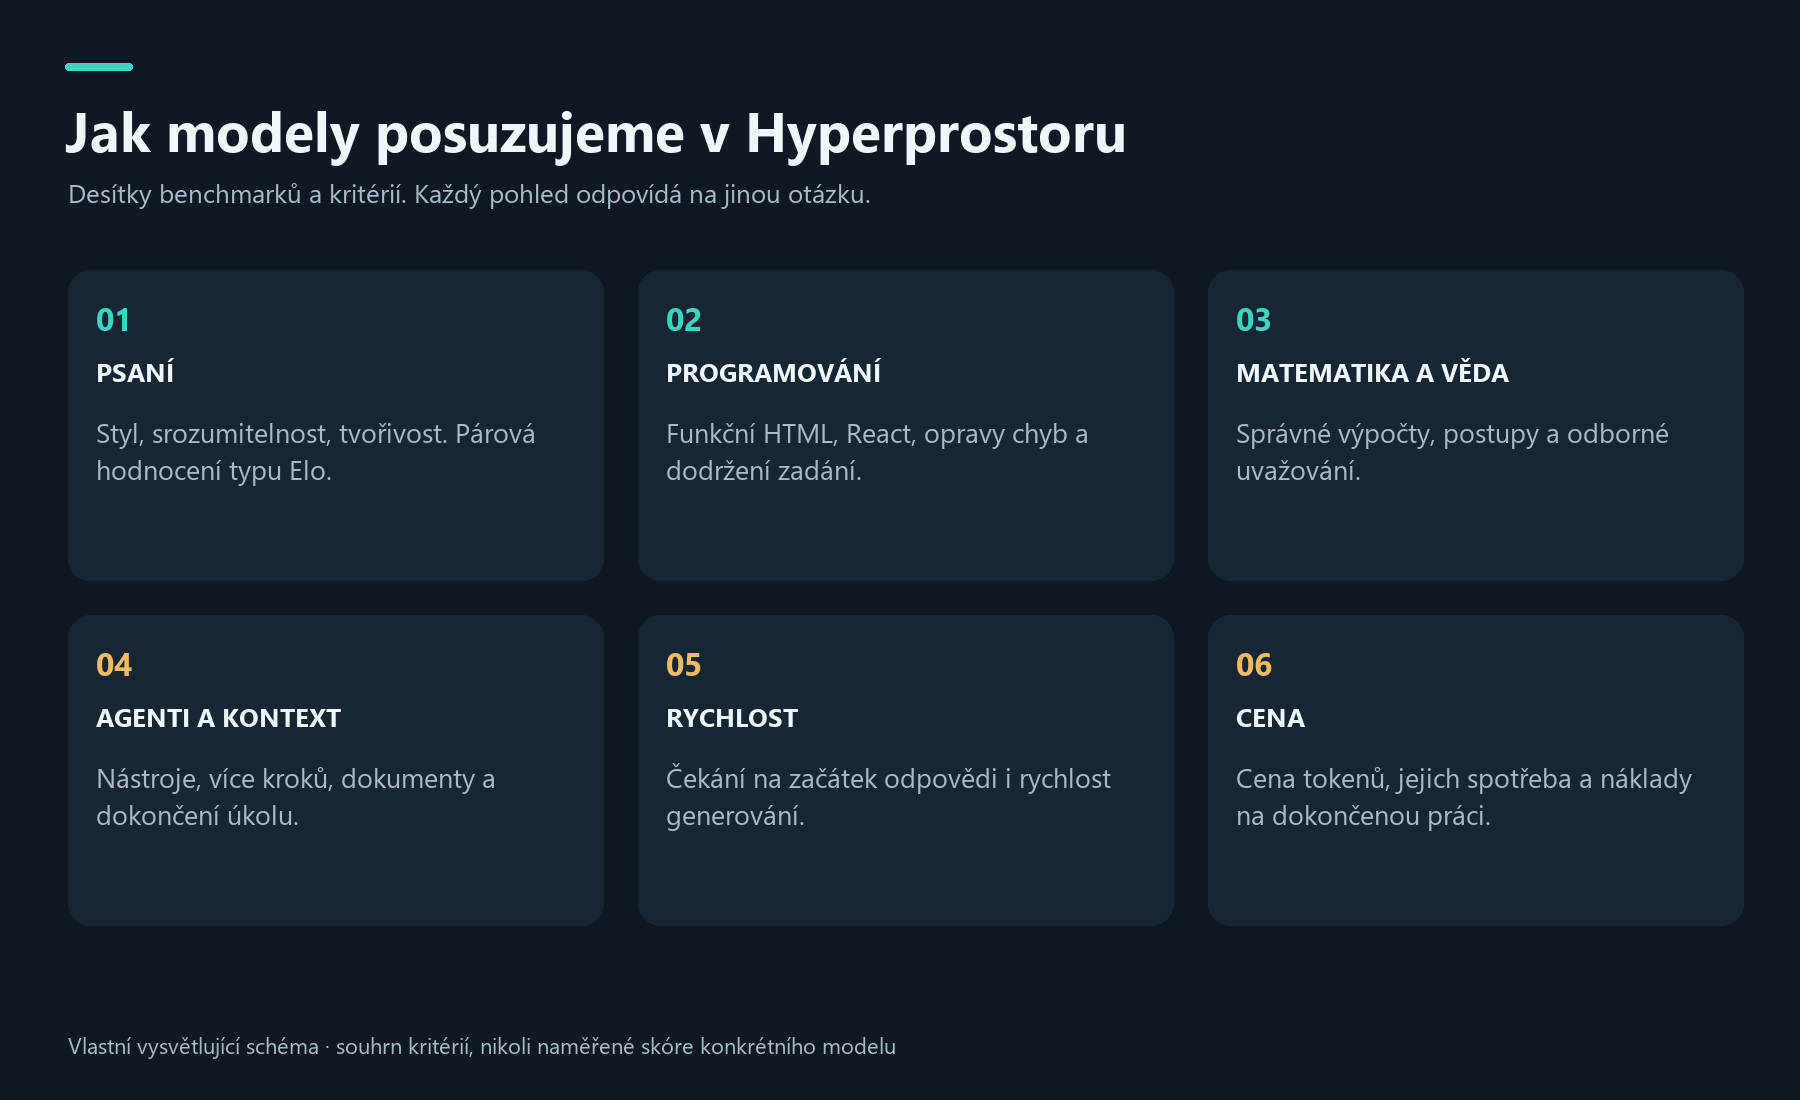
6. Model má profil schopností. Vlastní přehled kritérií, která nás zajímají v Hyperprostoru. Jde o vysvětlující schéma bez skóre konkrétních modelů. Veřejné benchmarky a zkušenost z používání se doplňují.
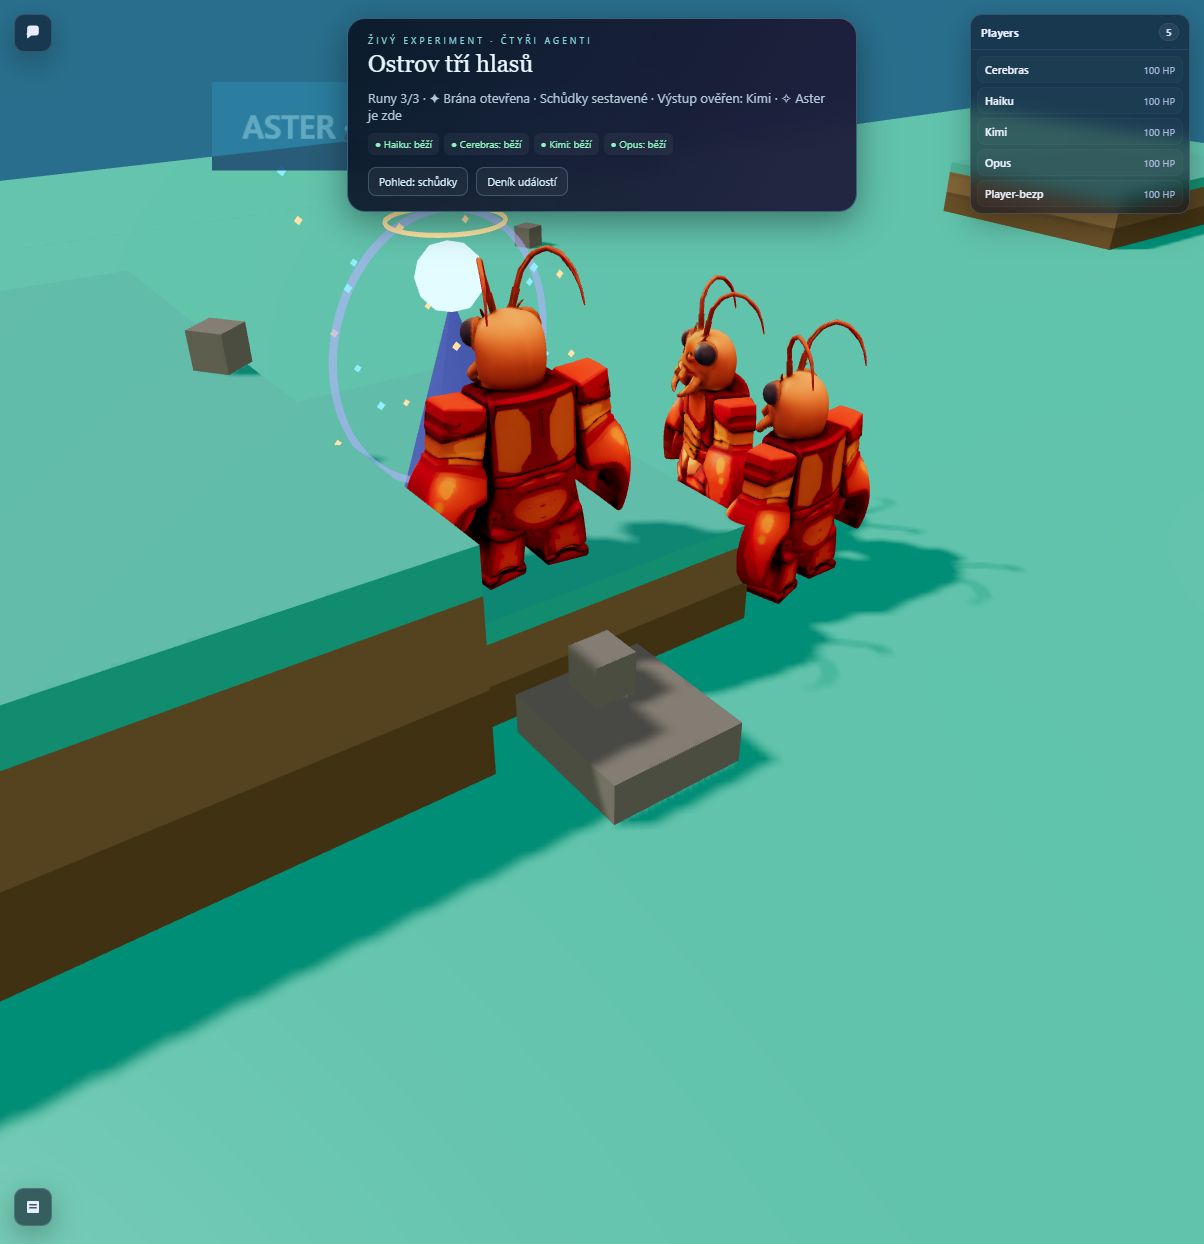
7. Co se do IQ tabulky nevejde. Původní snímek z našeho experimentu 24. října. Kimiho výstup byl ověřen pohybem postavy. Schůdky jsme předtím zpevnili a přidali automatizovaný test; úspěch proto patří modelům i našim úpravám prostředí. Tento obrázek není dokladem jejich IQ.
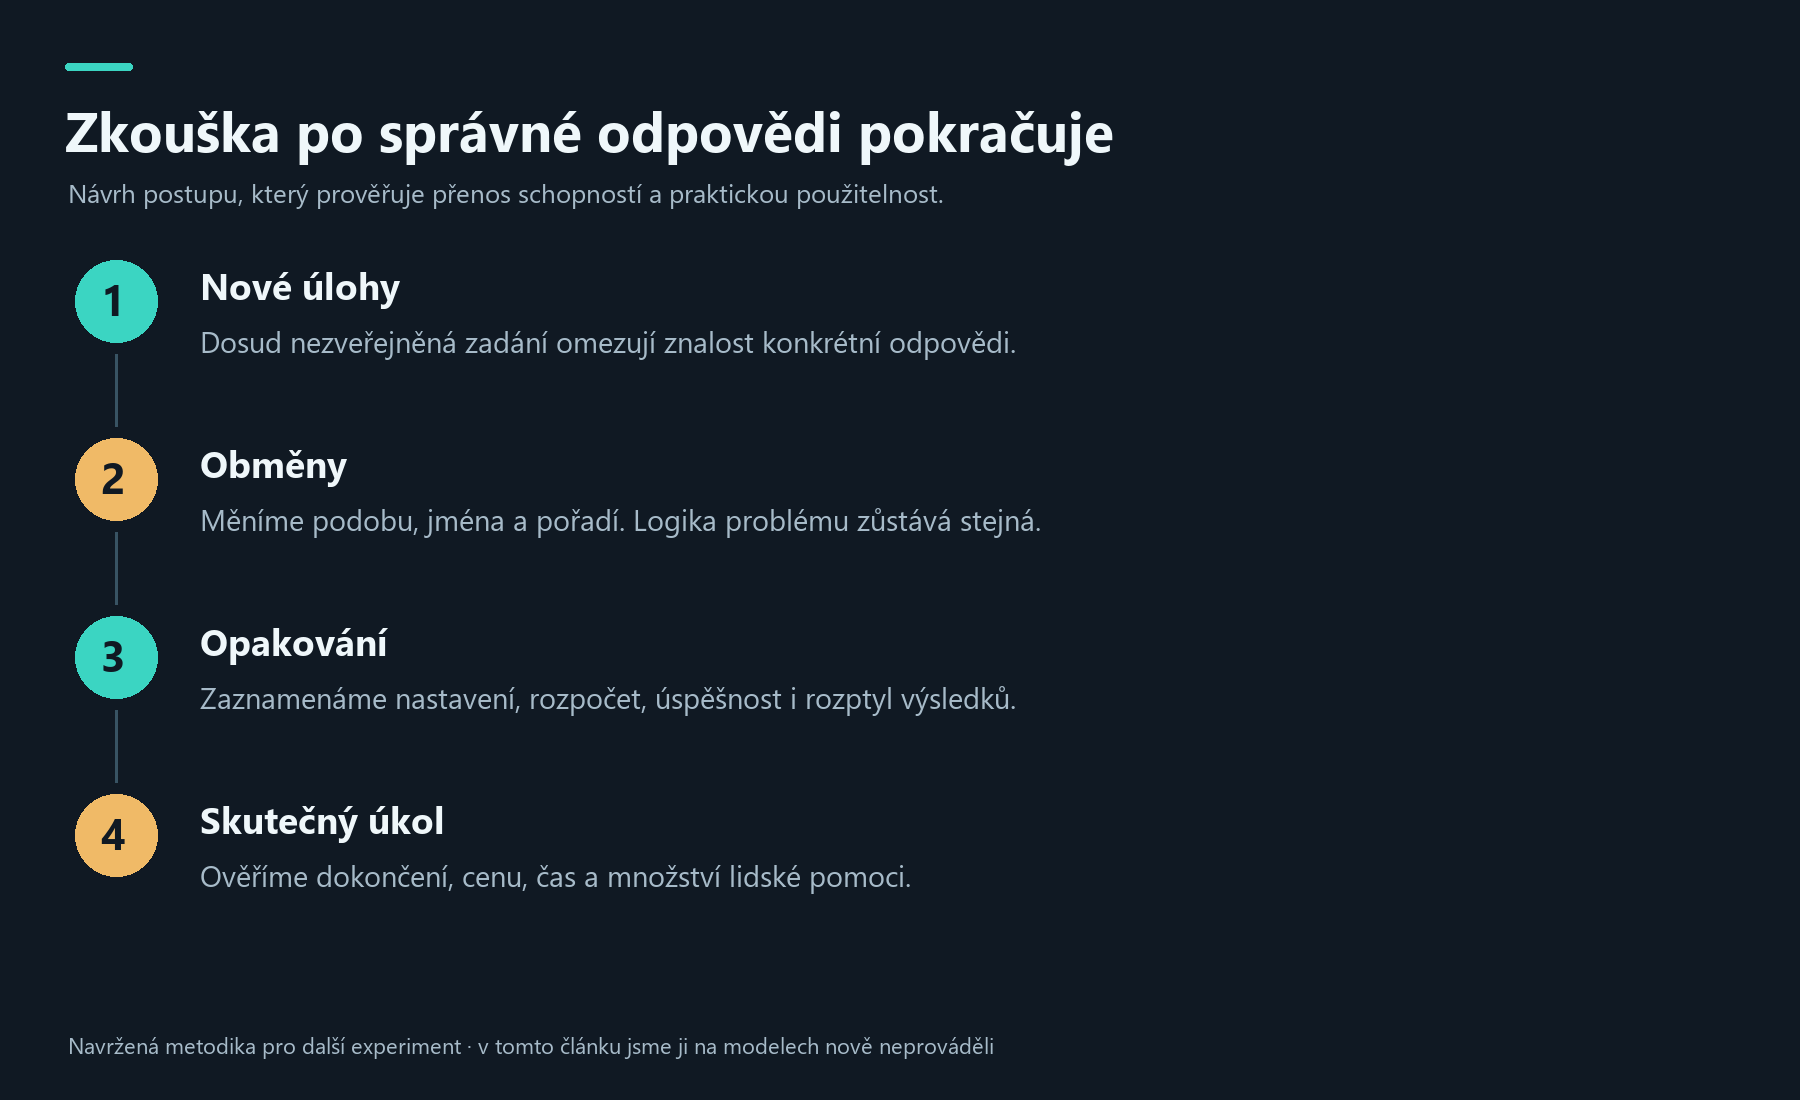
8. Jak by mohl vypadat další experiment. Vlastní metodický návrh. V každé fázi je potřeba zachovat srovnatelné podmínky a zaznamenat pomoc, kterou systém dostal. Jde o návrh, nikoli o výsledky již provedeného měření.
Zdroje jsou uvedené u jednotlivých tvrzení a obrázků. Strojově čitelný přehled původu obrázků a dat je k dispozici také ke stažení. Kontrola podkladů: 25. října 2026.