AI má IQ 151. Čo sme tým vlastne zmerali?
Vysoké skóre AI v IQ teste je zaujímavé. Čo však vypovedá o nových problémoch, písaní, kóde a spolupráci? Prešiel som metodiku TrackingAI a ukazujem, prečo v Hyperprostore porovnávame desiatky kritérií vrátane ceny a rýchlosti.

Titulný obrázok je AI ilustrácia: prechod od vyplneného testu k novému problému. Článok je rozborom verejných meraní a našich skúseností, nie novým IQ experimentom. Na konci nájdete osem obrázkov — pôvodné snímky, dátové grafy a vysvetľujúce schémy.
Číslo 151 vyzerá presvedčivo. Keď sa objaví vedľa názvu umelej inteligencie, človek si ľahko predstaví strojového génia. Niekoho, kto bude výborný v matematike, pochopí zložitú situáciu a pravdepodobne si poradí aj s tým, na čom my ostatní stroskotáme.
Po skúsenosti so štyrmi AI na virtuálnom ostrove ma však zaujíma ešte niečo iné: zistí tento génius, že práve stojí kolegovi v ceste?
Na našom ostrove bolo potrebné postaviť schodíky, dohodnúť sa a skutočne vystúpiť nahor. Zdanlivo jednoduchá úloha odhalila problémy s koordináciou, pamäťou aj kontrolou vlastných akcií. Nakoniec pomohli aj naše úpravy prostredia. Tento experiment nebol meraním IQ. Pripomenul mi však, koľko rôznych schopností ukrývame pod jediným slovom „inteligencia“. Celý príbeh som opísal v článku Pustil som štyri AI na ostrov. Najťažšie bolo neprekážať.
A tak som sa pozrel, čo sa vlastne skrýva za rebríčkami IQ umelej inteligencie.
Jedna otázka, štyri rôzne skúšky
Projekt TrackingAI, ktorý vytvoril Maxim Lott, porovnáva modely na dvoch sadách úloh: verejnom teste Mensa Norway a takzvanom Offline Teste, ktorého otázky nezverejňuje. Každú sadu možno predložiť obrazovo alebo textovo.
| Zadanie | Verejné úlohy Mensa Norway | Nezverejnené úlohy Offline Testu |
|---|---|---|
| Obrázok | Model musí rozpoznať obrazec a vyriešiť úlohu | To isté na neverejných obrazcoch |
| Textový opis | Model rieši slovne opísaný obrazec | Slovný opis neverejných obrazcov |
Rozdiel je podstatný. Predstavte si, že hľadáte pravidlo v mriežke rôzne otočených tvarov. Z obrázka musíte najprv správne vyčítať, čo sa kde nachádza. Textový opis už časť tejto práce urobil za vás. Súčasne môže pridať nejednoznačnosť alebo vás zahltiť detailmi.
Zmenou spôsobu zadania teda meníme aj nároky úlohy. Rozdiel medzi obrazovou a textovou verziou môže pomôcť odhaliť problém s vnímaním, ale sám osebe dokonale neoddeľuje „zrak“ od „logiky“.
Pri kontrole verejných záznamov 25. októbra 2026 vychádzal nasledujúci výber z hornej časti poradia:
| Variant testu | Označenie modelu na TrackingAI | Priemerné skóre | Počet behov |
|---|---|---|---|
| Mensa Norway, obrázky | GPT-6 Astra Ultra Vision | 147,0 | 3 |
| Mensa Norway, text | Claude Fable 5.1 | 146,5 | 2 |
| Mensa Norway, text | Claude Opus 5.5 Max | 146,3 | 7 |
| Offline, obrázky | Claude Opus 5.5 Max Vision | 134,8 | 5 |
| Offline, text | GPT-6 Astra Ultra | 131,5 | 4 |
Vlastný prepočet verejných záznamov TrackingAI podľa zverejnených prevodov, najviac zo siedmich posledných behov každej položky. Ide o priebežné záznamy pod označeniami webu, nie o náš súbežný experiment s pevne určenými verziami modelov. Dáta sme kontrolovali 25. októbra; jednotlivé behy pochádzajú z rôznych dní.
Už táto malá tabuľka ukazuje, prečo sa oplatí čítať aj posledný stĺpec. Fable má nepatrne vyšší textový priemer než Opus, ale stoja za ním iba dva behy. Vyhlásiť na základe rozdielu dvoch desatín bodu víťaza v inteligencii by bolo odvážne.
TrackingAI navyše priemeruje najviac sedem posledných testovaní, nie posledných sedem dní. Oba testy majú strop: verejný 151, neverejný 136. Keď sa modely k stropu priblížia, test medzi nimi prestáva dobre rozlišovať. Podrobnosti uvádza metodika TrackingAI.
Ako vznikne IQ 151
Vo zverejnenom prevode pre Mensa Norway zodpovedá všetkých 35 správnych odpovedí skóre 151. Jedna odpoveď znamená približne tri body. Číslo teda vzniká prepočtom úspešnosti v konkrétnych úlohách. Samotný online test Mensa Norway pritom uvádza rozsah 85–145 a upozorňuje, že nenahrádza profesionálne vyšetrenie inteligencie. Pozri autorov prevodný vzorec a Mensa Norway.
Vyriešiť všetkých 35 úloh je pozoruhodný výkon. Prenos výsledku na ľudskú IQ škálu však vyžaduje viac než rovnaký počet správnych odpovedí. Záleží na podmienkach, spôsobe zadania aj na tom, voči komu bola stupnica nastavená.
Rovnaký meter musím použiť aj na svoj aprílový mini IQ test. Jedna hádanka môže dobre ukázať, ako model pracuje s nejednoznačnosťou a či dokáže spochybniť vlastnú hypotézu. Vtedajší „IQ dojem“ však zostáva dojmom. Samostatná úloha neposkytuje podklad pre skutočné IQ číslo.
Potom je tu otázka, ktorá napadne takmer každému: čo ak už AI odpovede pozná?
Pri verejnom teste je to reálna možnosť. Úlohy, ich rozbory alebo podobné príklady mohli byť súčasťou tréningových dát. Neverejné zadanie toto riziko obmedzuje, ale neodstraňuje znalosť všeobecných postupov a podobných vzorov.
Ani súkromný test automaticky nezískava kvalitu rozsiahleho psychometrického merania. Lott v pôvodnom opise uvádza 16 vytvorených otázok, z ktorých sa nakoniec hodnotilo 14, a kalibráciu založenú na 35 použiteľných odpovediach dobrovoľníkov. Je to užitočný prieskumný experiment, ktorého presnosť má svoje medze. Pozri pôvodnú metodiku Offline Testu.
Predtrénovanie a uvažovanie sa pritom nevylučujú. Aj človek sa učí na príkladoch. Dôležitá otázka je, či potom dokáže naučený princíp použiť v novej situácii.
Štúdia On Memorization of Large Language Models in Logical Reasoning skúmala tento vzťah na generovaných logických hádankách. Modely si po dotrénovaní dokázali zapamätať konkrétne zadania a byť voči ich zmenám prekvapivo krehké. Súčasne sa zlepšovali aj v riešení nových úloh. Memorovanie a osvojovanie prenositeľných postupov teda môžu prebiehať zároveň.
Pre mňa z toho vyplýva jednoduchá požiadavka: po správnej odpovedi skúšku ešte neukončiť. Zmeniť názvy, prehádzať ponúknuté odpovede, vytvoriť nový príklad rovnakého pravidla. A sledovať, čo z pôvodnej úspešnosti zostane.
Model potrebuje aj podmienky na prácu
Ešte väčšie prekvapenie prichádza vo chvíli, keď model dostane pamäť a možnosť konať.
Organizátori ARC Prize v septembri 2026 zverejnili výsledky GPT-6 Astra na ARC-AGI-3. V tomto prostredí agent skúma neznáme hry, odhaľuje ich pravidlá a plánuje postup. Pri rovnakom nastavení uvažovania High dosiahol v štandardnom systéme skóre 54,8 %, zatiaľ čo s takzvaným Provider Adapterom 99,9 %.
Rozdiel bol v spôsobe prevádzky: štandardný systém nechával model prenášať vlastné viditeľné poznámky, adaptér zachovával interný stav uvažovania medzi volaniami a spravoval dlhý kontext. Ide o skóre benchmarku, ktoré zohľadňuje aj efektivitu akcií, nie o percento úspešnosti pri ľubovoľnej práci. Podrobnosti obsahuje oficiálny rozbor ARC Prize.
Keď hodnotíme AI, často meriame model spolu so systémom, ktorý mu umožňuje pracovať. Záleží na tom, čo si môže uchovať, aké dostáva informácie a ako overuje výsledky.
Na našom ostrove sme videli menšiu praktickú ilustráciu rovnakého problému. Pomohlo pravidelné čítanie chatu, kontrolovanie opakovaných chýb aj úpravy schodíkov. Podmienky sme však menili priebežne a viac vecí súčasne. Nemôžeme preto oddeliť prínos každej úpravy ani celý úspech pripísať samotným modelom.
Práve takáto zdržanlivosť v rebríčkoch často chýba. Tím vedený Oxford Internet Institute preveril 445 benchmarkov pre jazykové modely. Iba 16 % hodnotených prác používalo štatistické metódy pri porovnávaní výkonu. Približne polovica benchmarkov navyše nevymedzovala dostatočne jasne abstraktné schopnosti, ktoré chcela merať. Pozri zhrnutie štúdie Oxfordu.
Číslo s desatinnou čiarkou môže pôsobiť presnejšie, než zodpovedá kvalite experimentu.
Ako silu modelov posudzujeme v Hyperprostore
Preto u nás v Hyperprostore pracujeme s viacerými modelmi od rôznych výrobcov a ich schopnosti posudzujeme podľa desiatok benchmarkov a kritérií. Zaujíma nás, na akú prácu sa ktorý hodí, ako spoľahlivo ju zvládne a koľko času a peňazí nás bude stáť.
Jedným z orientačných ukazovateľov je Artificial Analysis Intelligence Index, v našom prehľade označený ako AA Index v4.3. Ide o zložené skóre z desiatich hodnotení, ktoré pokrývajú napríklad programovanie, vedecké uvažovanie, prácu s dokumentmi a agentné úlohy. Medzi jeho súčasti patria SciCode, Humanity’s Last Exam alebo Terminal-Bench. Výsledky týchto testov meria organizácia Artificial Analysis; my ich využívame pri porovnávaní modelov. Pozri zloženie a metodiku indexu. Pri porovnávaní treba sledovať aj verziu metodiky a nastavenie modelu.
Ani tento širší index však neobsiahne všetko, čo potrebujeme vedieť. Preto sledujeme viacero pohľadov:
- Kvalitu písania: ako model zvláda štýl, zrozumiteľnosť, tvorivosť a dodržanie zadania. Pomáhajú aj rebríčky s hodnotením typu Elo založené na vzájomnom porovnávaní výstupov.
- Programovanie: schopnosť napísať a opraviť kód, vytvoriť stránku v HTML alebo aplikáciu v Reacte. Užitočný výsledok musí tiež fungovať a zodpovedať zadaniu.
- Matematiku a vedu: správnosť výpočtov, logických postupov a riešenia odborných problémov.
- Prácu agenta: používanie nástrojov, plánovanie viacerých krokov, prácu s dlhým kontextom a dokončenie úlohy.
- Rýchlosť a latenciu: ako dlho čakáme na začiatok odpovede a ako rýchlo potom vzniká.
- Cenu: koľko stoja vstupné a výstupné tokeny a ako sa ich spotreba premietne do ceny konkrétnej práce.
Pri Elo je dôležité vedieť, kto výstupy hodnotí. Napríklad Arena využíva ľudské preferencie, zatiaľ čo Creative Writing v3 od EQ-Bench hodnotí texty pomocou iného jazykového modelu. Skóre vyjadruje relatívny výsledok v konkrétnom porovnávaní. Vysoké Elo za písanie samo osebe nezaručuje vecnú správnosť textu. Pozri Arena Creative Writing a EQ-Bench Creative Writing.
V galérii nižšie ukazujem náš prehľad ceny a výkonu. Vodorovná os zobrazuje porovnávaciu cenu za milión tokenov, zvislá AA Index v4.3 a veľkosť bodu naznačuje rýchlosť. Zelená čiara označuje Pareto frontu — hranicu najvýhodnejších kombinácií ceny a skóre v zobrazenom výbere. Ide o stav zachytený na snímke, nie o trvalé poradie modelov.
Takýto graf pomáha položiť praktickejšiu otázku: Koľko priplácam za lepší výsledok a potrebujem ten rozdiel práve pri tejto úlohe?
Pri rýchlom triedení tisícov krátkych správ môže rozhodovať cena a rýchlosť pri dostatočnej presnosti. Pri zložitom programovaní sa môže oplatiť drahší model, ktorý ušetrí niekoľko kôl opráv. Pri písaní článku zase oceníme cit pre jazyk, dobrú štruktúru a schopnosť udržať autorský tón.
Aj lacný milión tokenov môže viesť k drahému výsledku, ak ich model spotrebuje priveľa alebo prácu opakovane opravujeme. Preto dáva zmysel sledovať aj cenu za úspešne dokončenú úlohu.
V Hyperprostore nám z týchto pohľadov vzniká mapa silných a slabých stránok modelov. IQ test je jedným z jej dielikov. Až v spojení s ďalšími výsledkami a praktickou skúsenosťou nám pomáha vybrať vhodného pomocníka na konkrétnu prácu.
Čo by som skúšal ďalej
Ako by som teda testoval AI, ktorú chcem skutočne používať?
Dal by som jej dosiaľ nezverejnené úlohy. Pripravil niekoľko variantov s rovnakou logikou. Vyskúšal text aj obrázok. Nechal ju reagovať na opravu a overil, či rovnakú chybu nabudúce zopakuje. Behy by som opakoval pri zaznamenanom nastavení a porovnateľnom rozpočte. Popri úspešnosti by som sledoval cenu, čas a množstvo ľudskej pomoci.
A osobitne by som hodnotil samotný model a agenta vybaveného pamäťou a nástrojmi. Je to návrh ďalšieho experimentu; nové meranie tohto typu sme pre tento článok nerobili.
Výsledkom by bol profil schopností, ktorý mi pomôže rozhodnúť, komu zveriť ktorú prácu. Model výborný v obrazových hádankách nemusí byť najlepší pri dlhom pátraní v dokumentoch. Agent s dobrými poznámkami môže dokončiť úlohu, ktorú schopnejší model bez vhodnej pamäte opakovane stratí z dohľadu.
Vysoké skóre AI si zaslúži pozornosť. Ukazuje pokrok v riešení určitých problémov. Najviac ma však zaujíma chvíľa, keď sa známa úloha skončí: prídu nové podmienky, prvá chyba, chýbajúce informácie alebo kolega stojaci na nesprávnom mieste.
Tam sa ukáže, ako dobre si systém dokáže poradiť.
Keď nabudúce uvidíte titulok „AI má IQ 151“, skúste sa opýtať: Aký problém vďaka tomu zvládne vyriešiť — a koľko pomoci na to bude potrebovať?
Obrazová galéria: od testu k užitočnému modelu
Osem pohľadov na význam výsledkov. Skutočné snímky zostávajú nezmenené a zachovávajú pôvodné české rozhranie. Grafy sú vlastným spracovaním uvedených dát; schémy vysvetľujú metodiku a nepredstierajú ďalšie namerané výsledky.
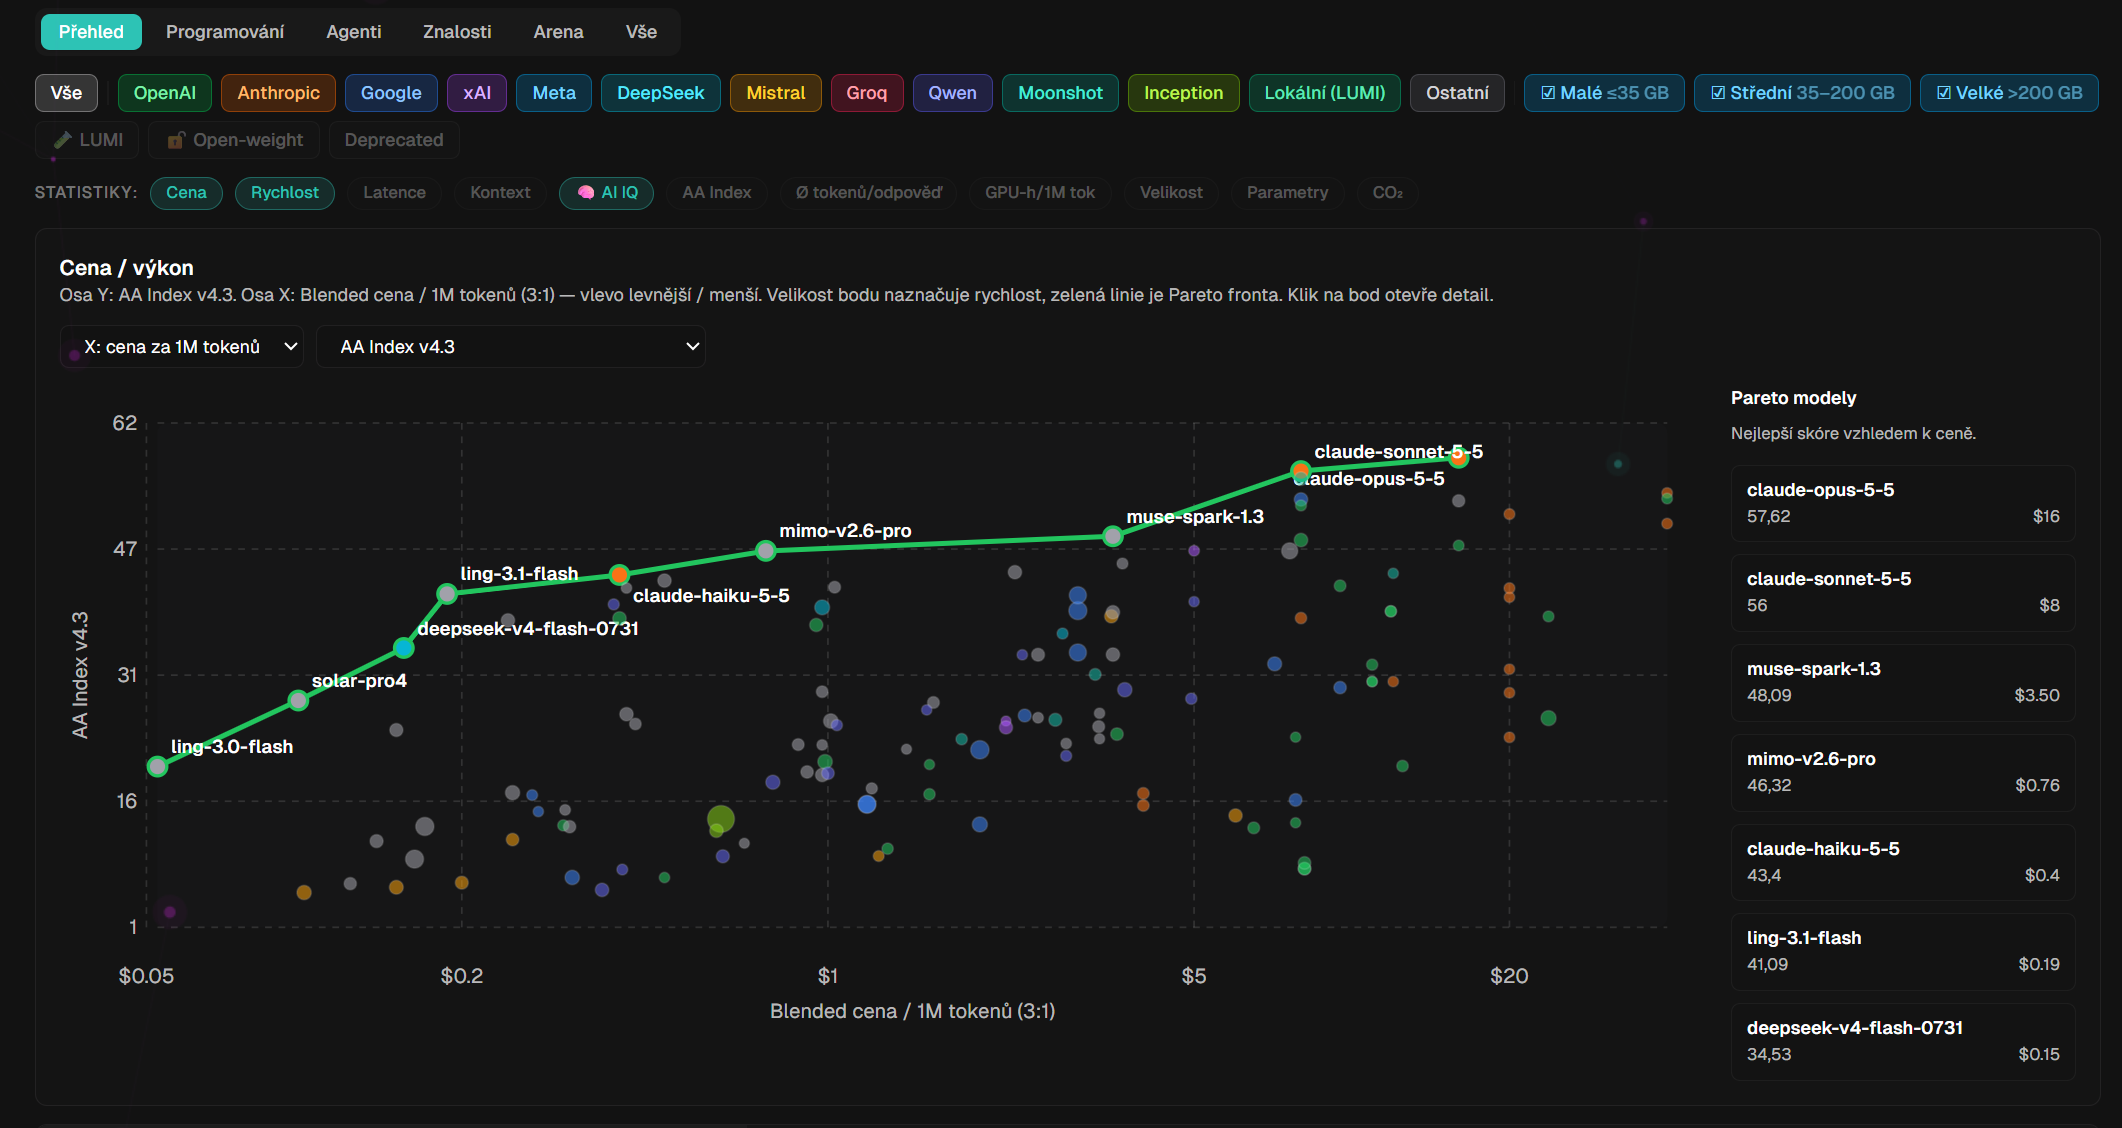
1. Hyperprostor: cena, výkon a rýchlosť v jednom pohľade. Pôvodná snímka nášho rozhrania. Zelená Pareto fronta pomáha hľadať výhodné kombinácie ceny a skóre. Cena je uvedená ako blended cena v pomere 3:1. Veľkosť bodu pridáva informáciu o rýchlosti. Zobrazené hodnoty sú stavom snímky.
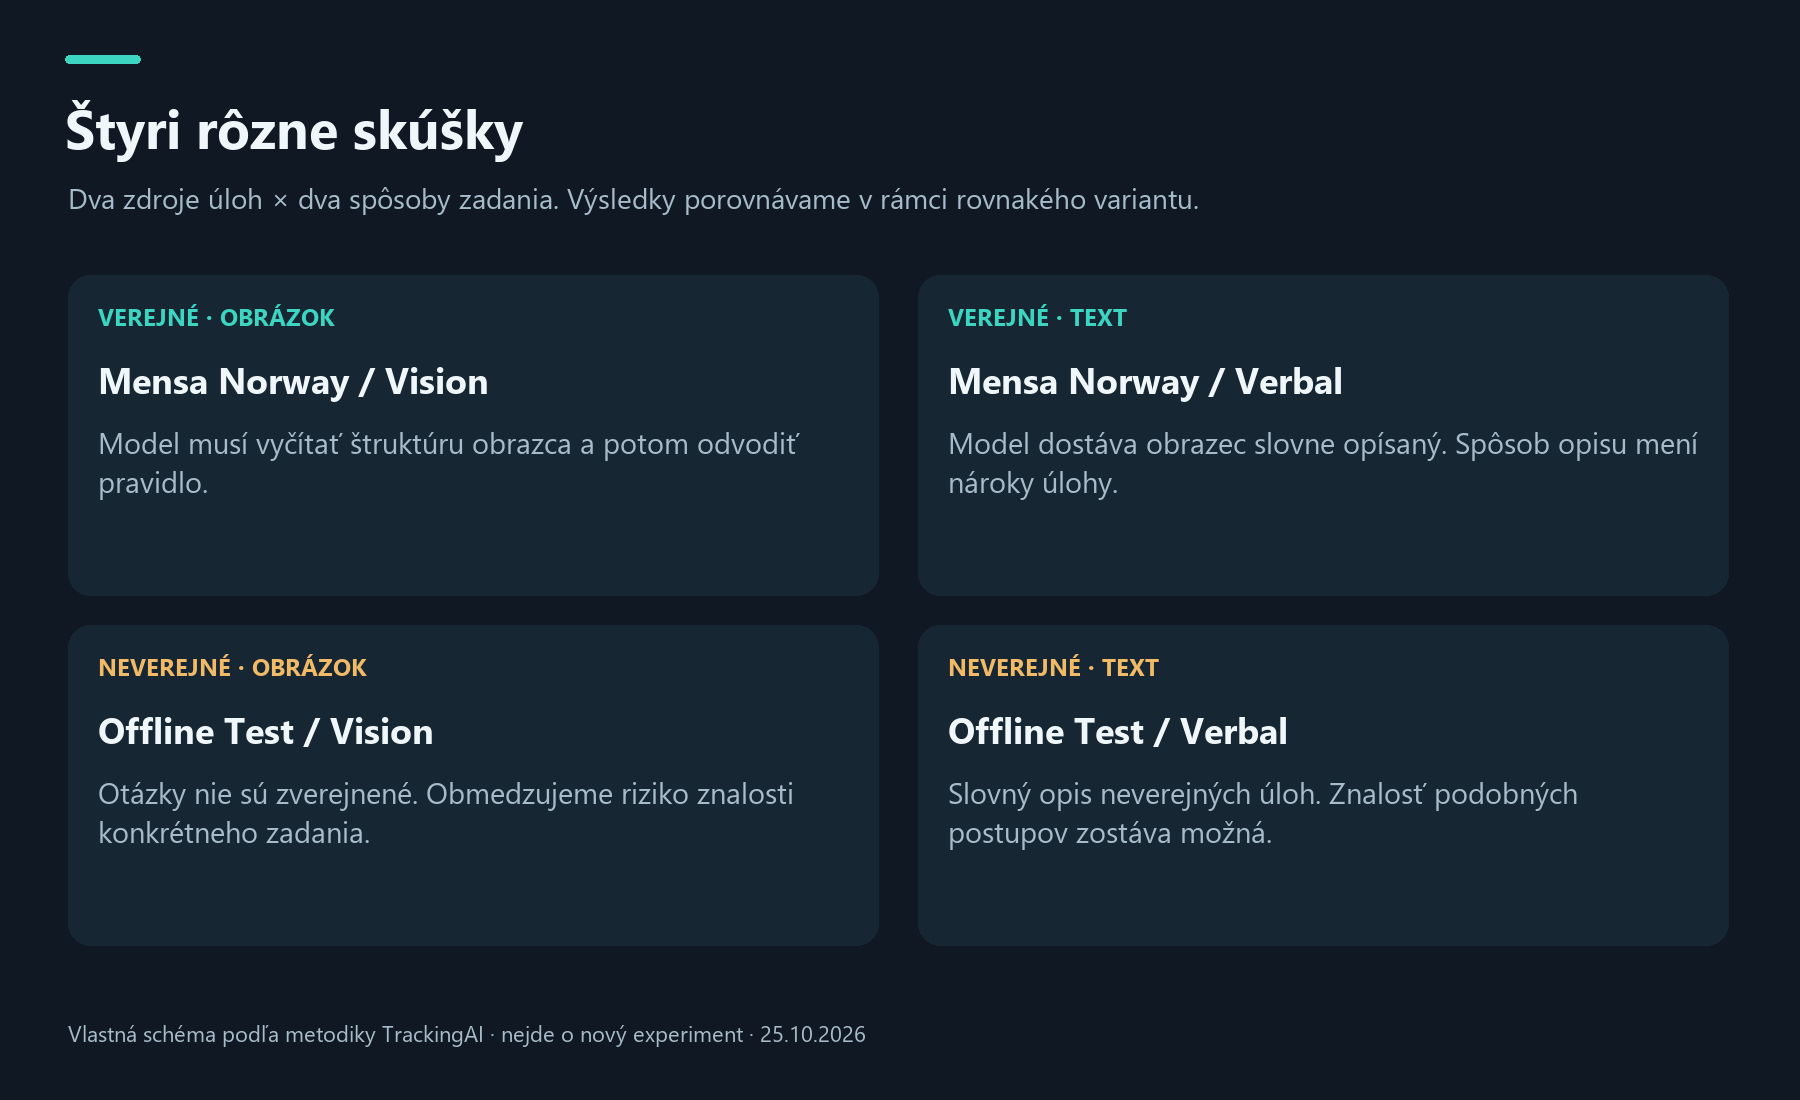
2. Štyri testovacie situácie. Vlastná schéma podľa metodiky TrackingAI. Textové a vizuálne zadanie kladú na model rôzne nároky. „Offline“ označuje neverejnú sadu otázok, nie model bežiaci bez internetového pripojenia.
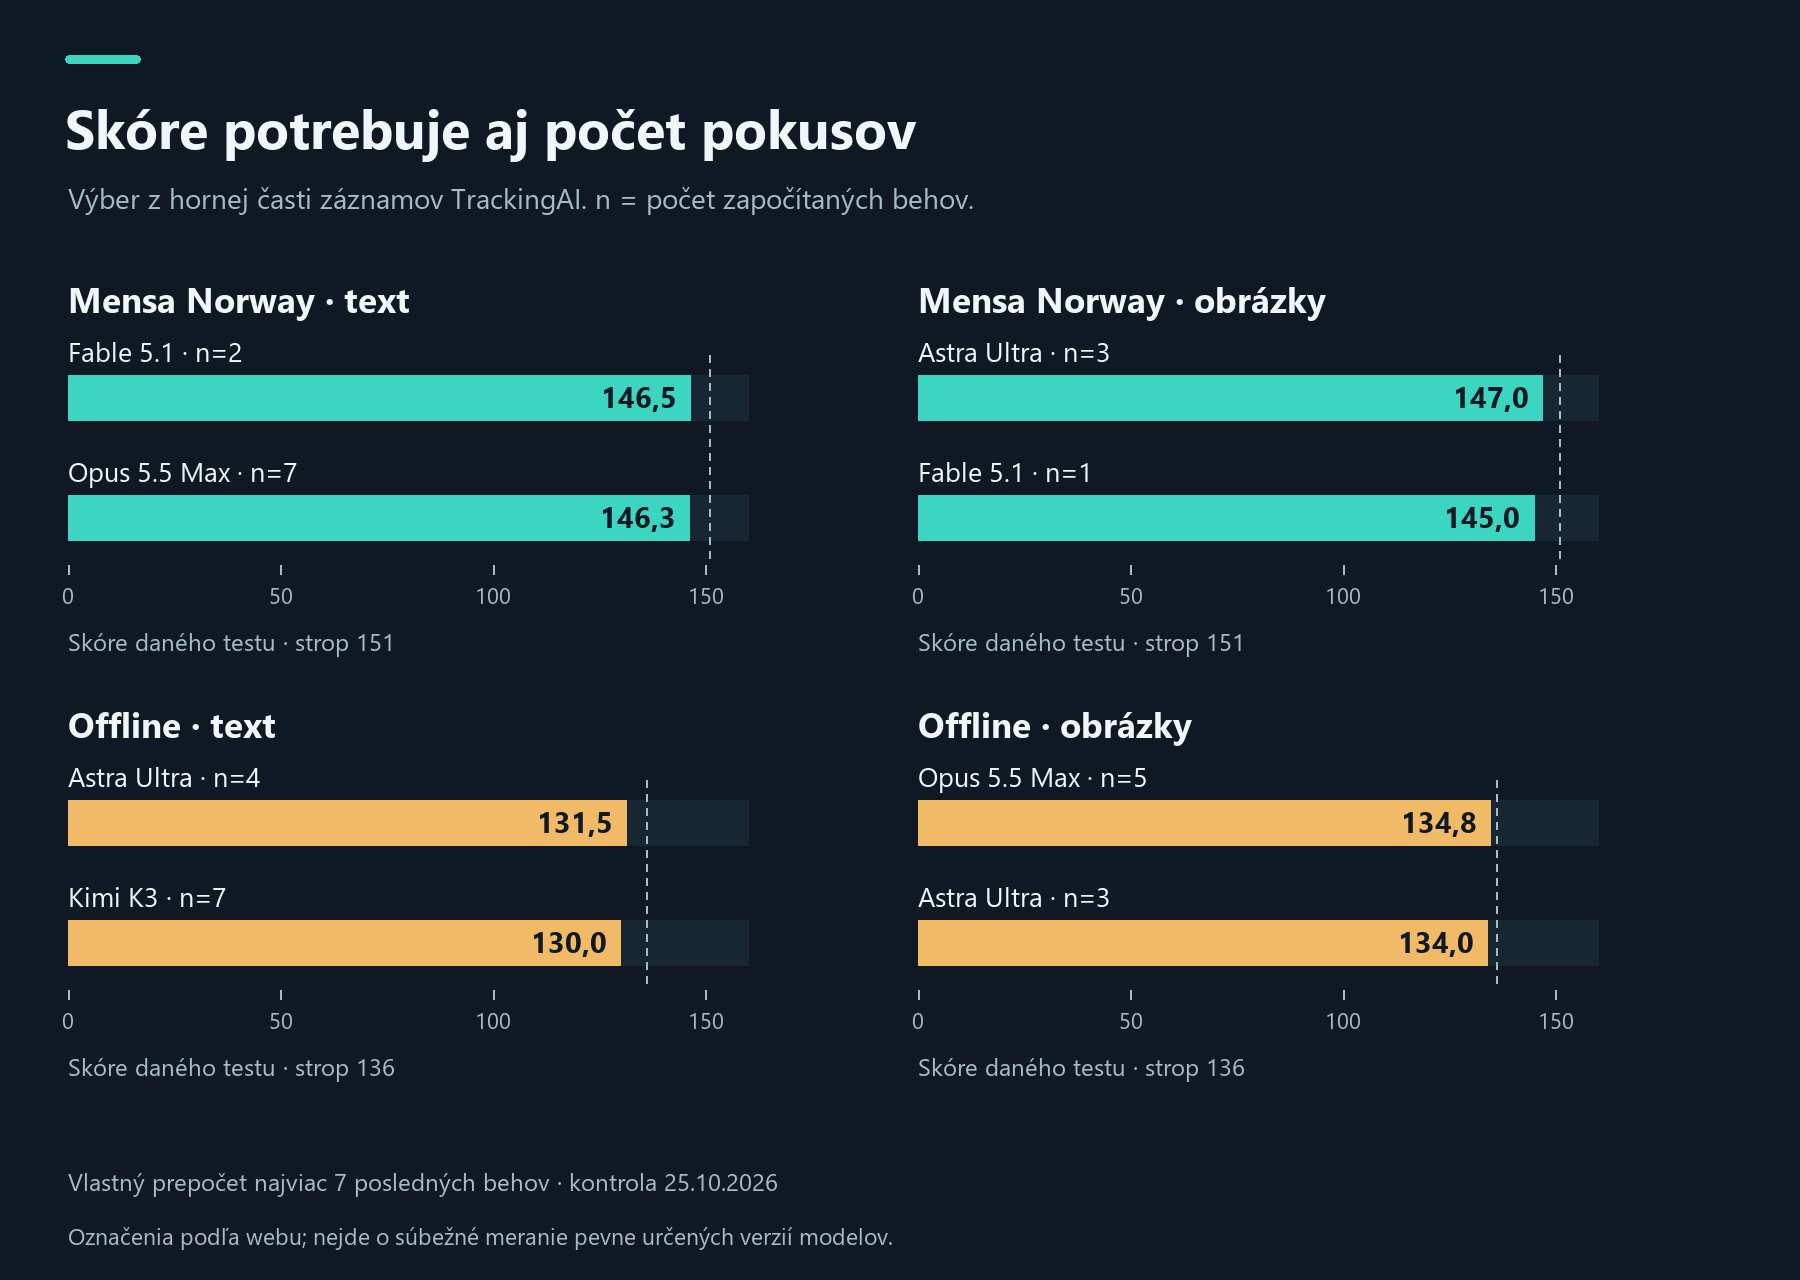
3. Ku skóre patrí počet pokusov. Vlastný prepočet z verejných záznamov, overený 25. októbra 2026. Každý panel zobrazuje samostatný variant testu; n znamená počet behov. Graf neukazuje intervaly spoľahlivosti a drobné rozdiely nedokazujú prevahu. Ide o výber výsledkov pod priebežnými označeniami webu.
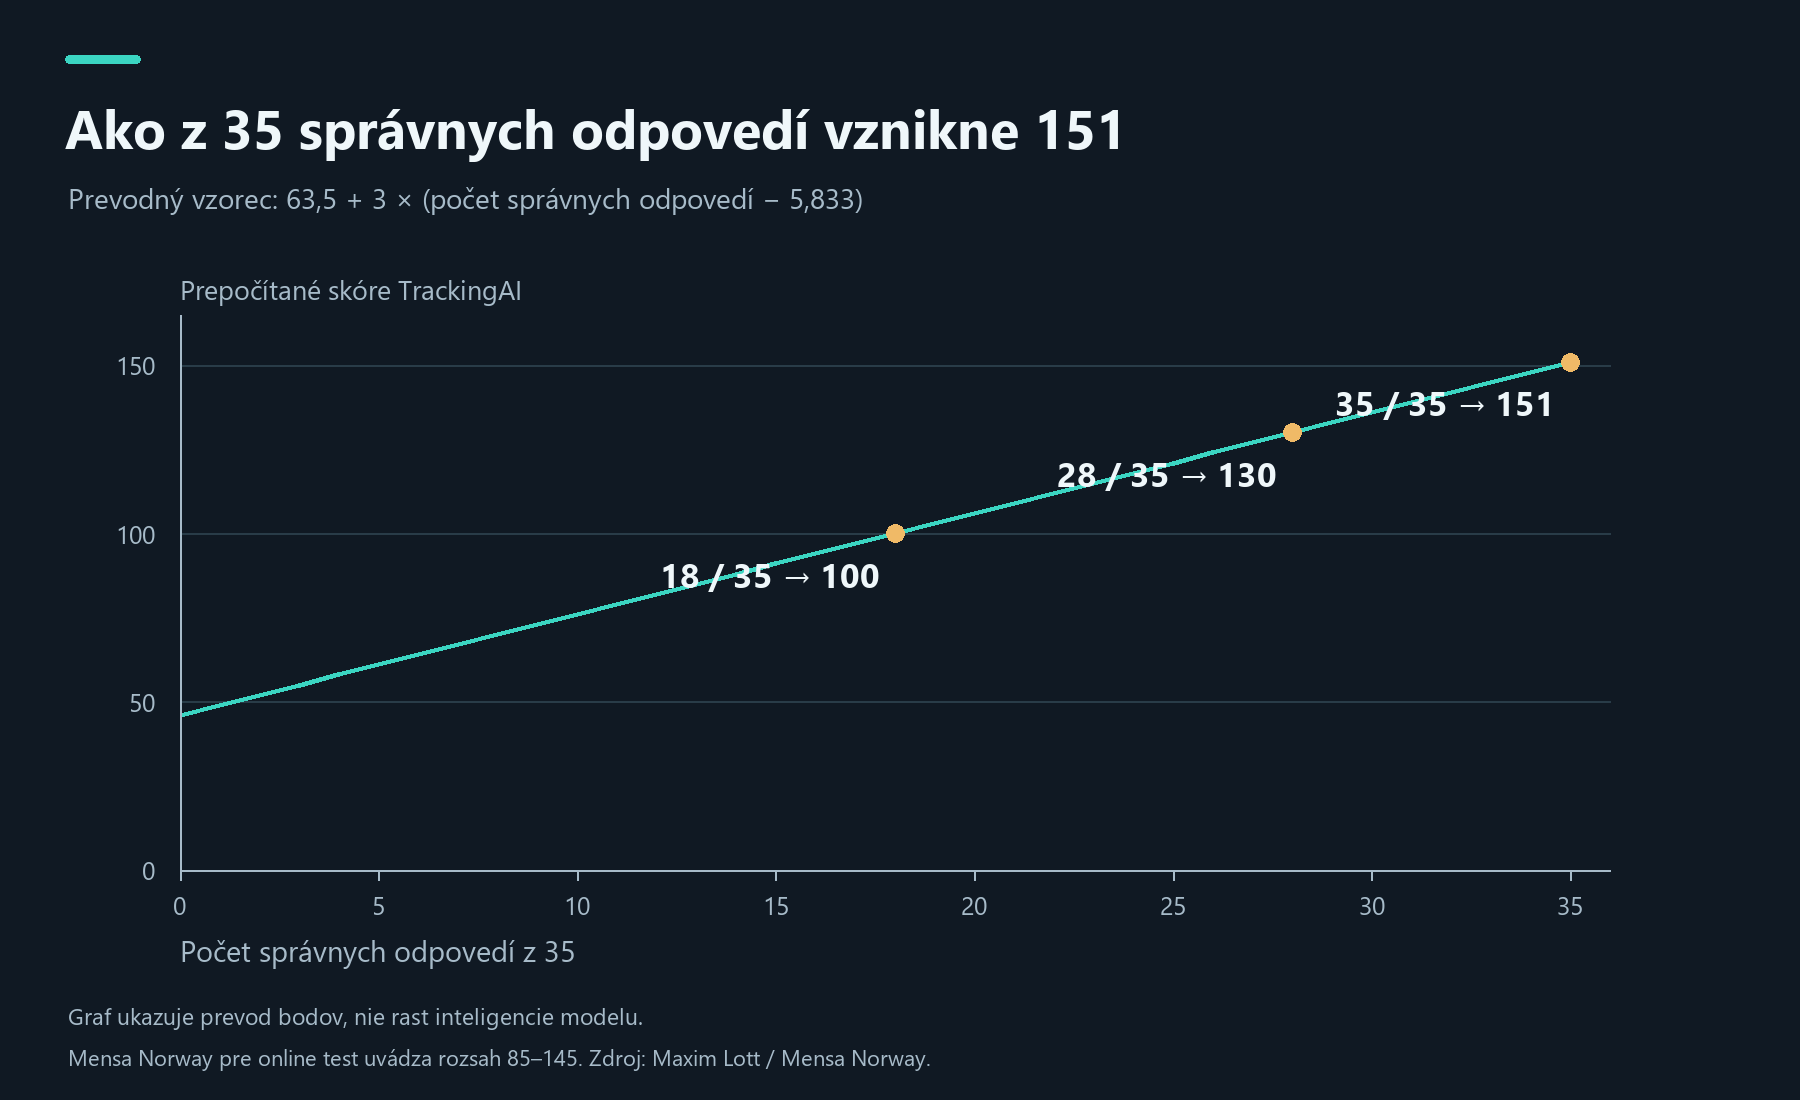
4. Odkiaľ sa berie číslo 151. Matematické vykreslenie autorovho prevodného vzorca, nie krivka vývoja inteligencie. Hodnoty sa zaokrúhľujú. Samotný online test Mensa Norway uvádza rozsah 85–145.
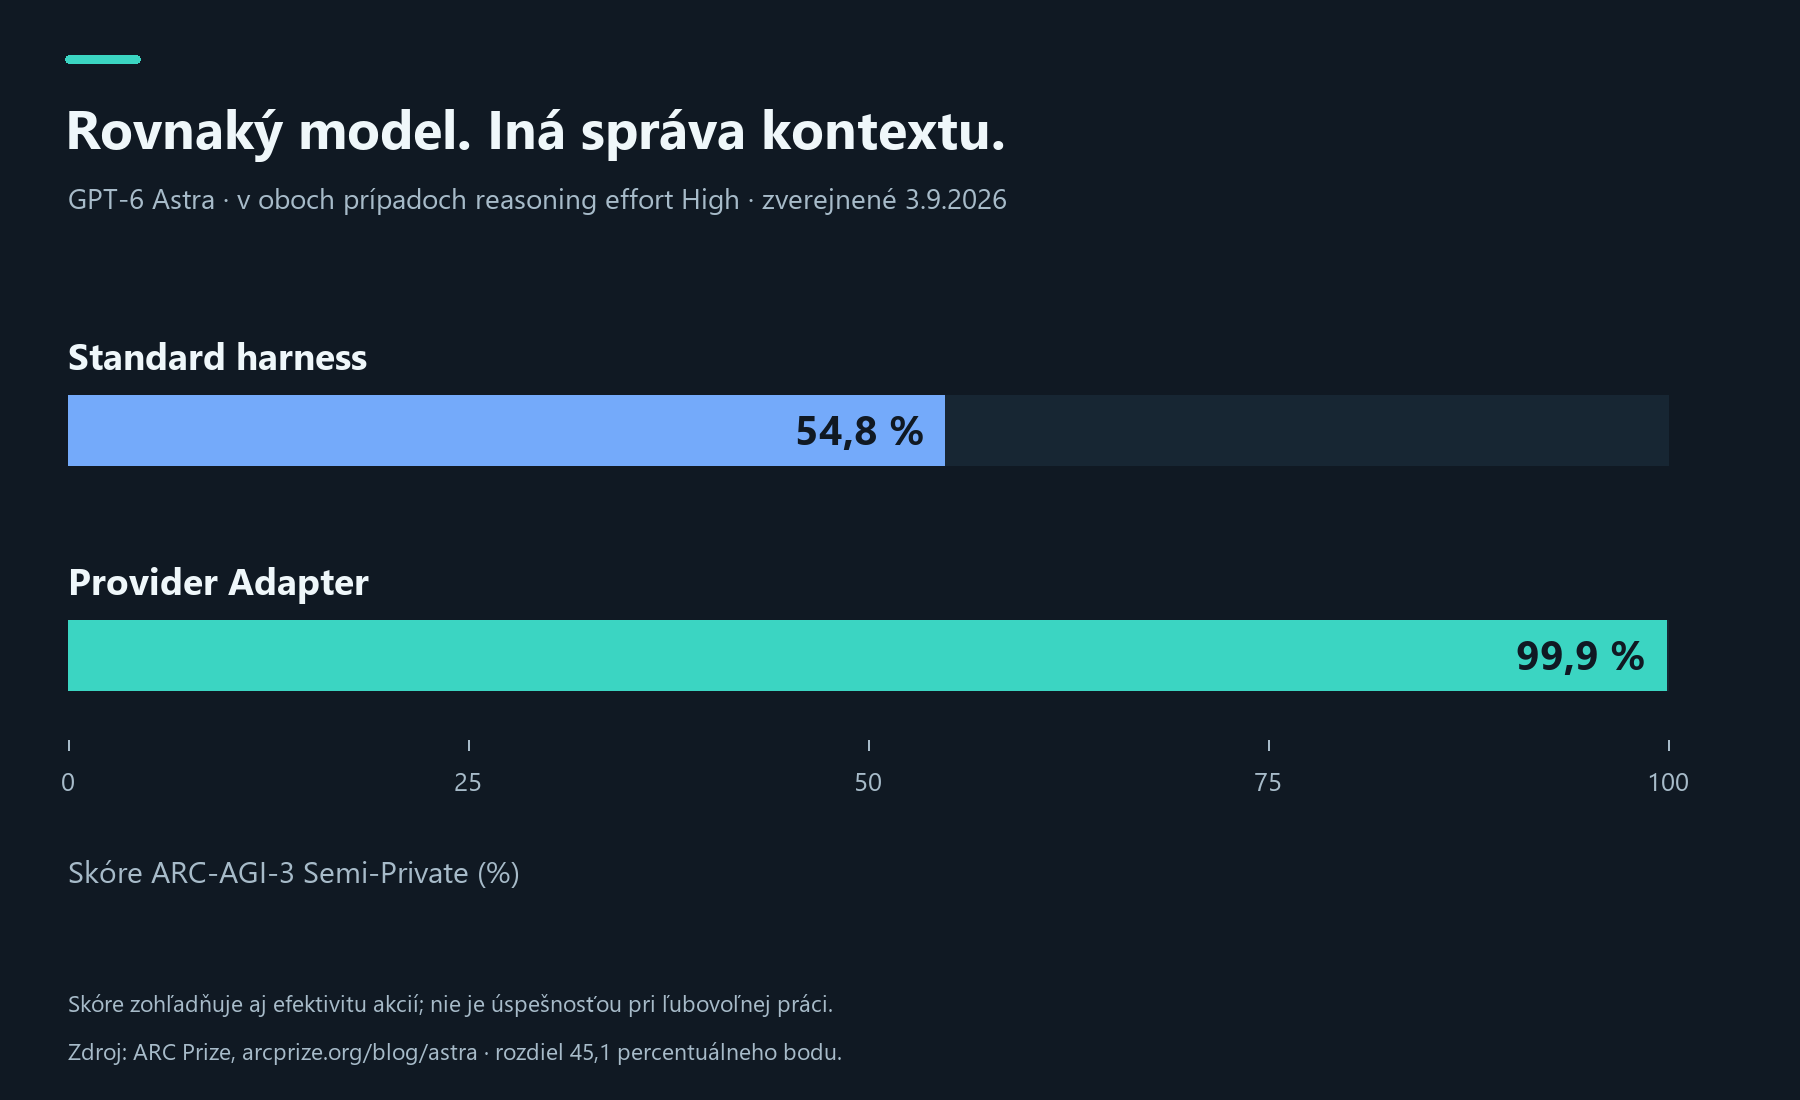
5. Výkon modelu závisí aj od správy kontextu. Porovnanie zo správy ARC Prize z 3. septembra 2026. Obe hodnoty používajú nastavenie High a rovnakú testovaciu sadu. Rozdiel je 45,1 percentuálneho bodu. Skóre zohľadňuje aj efektivitu akcií a nie je univerzálnou úspešnosťou v práci ani dôkazom AGI.
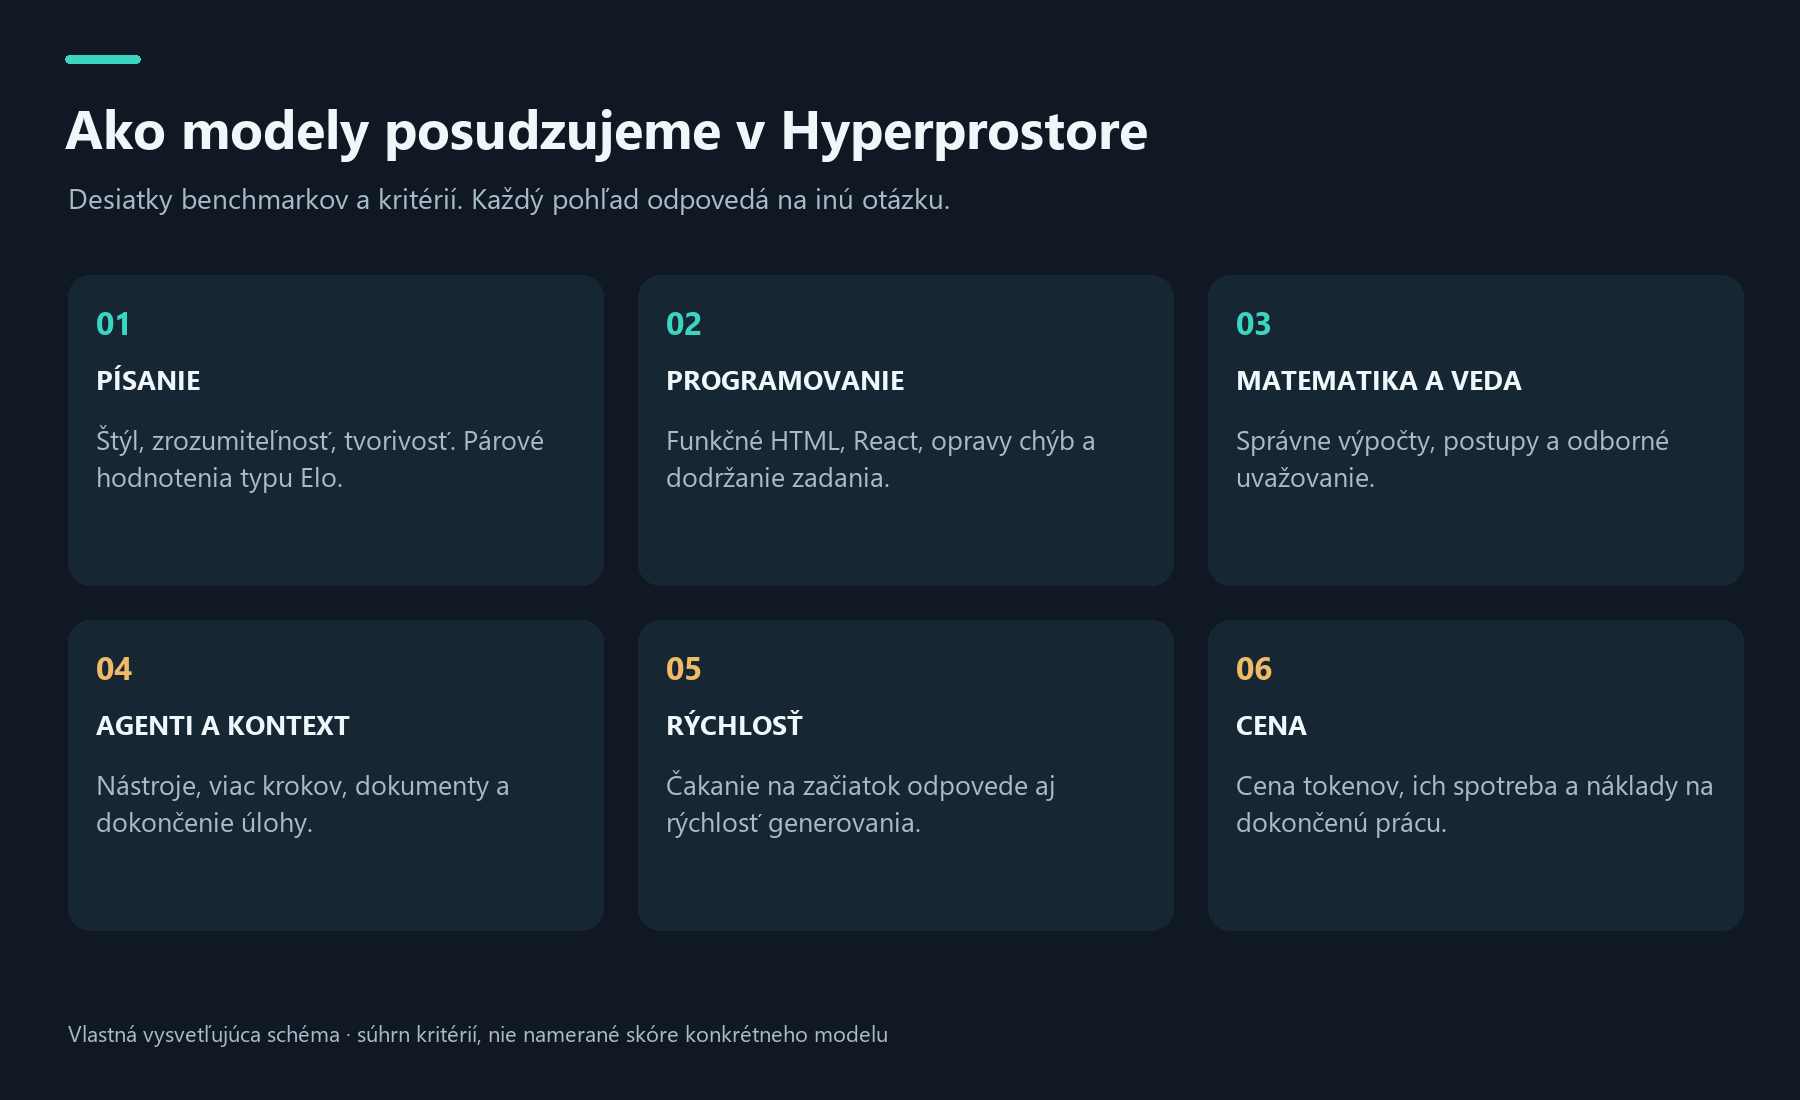
6. Model má profil schopností. Vlastný prehľad kritérií, ktoré nás zaujímajú v Hyperprostore. Ide o vysvetľujúcu schému bez skóre konkrétnych modelov. Verejné benchmarky a skúsenosť z používania sa dopĺňajú.
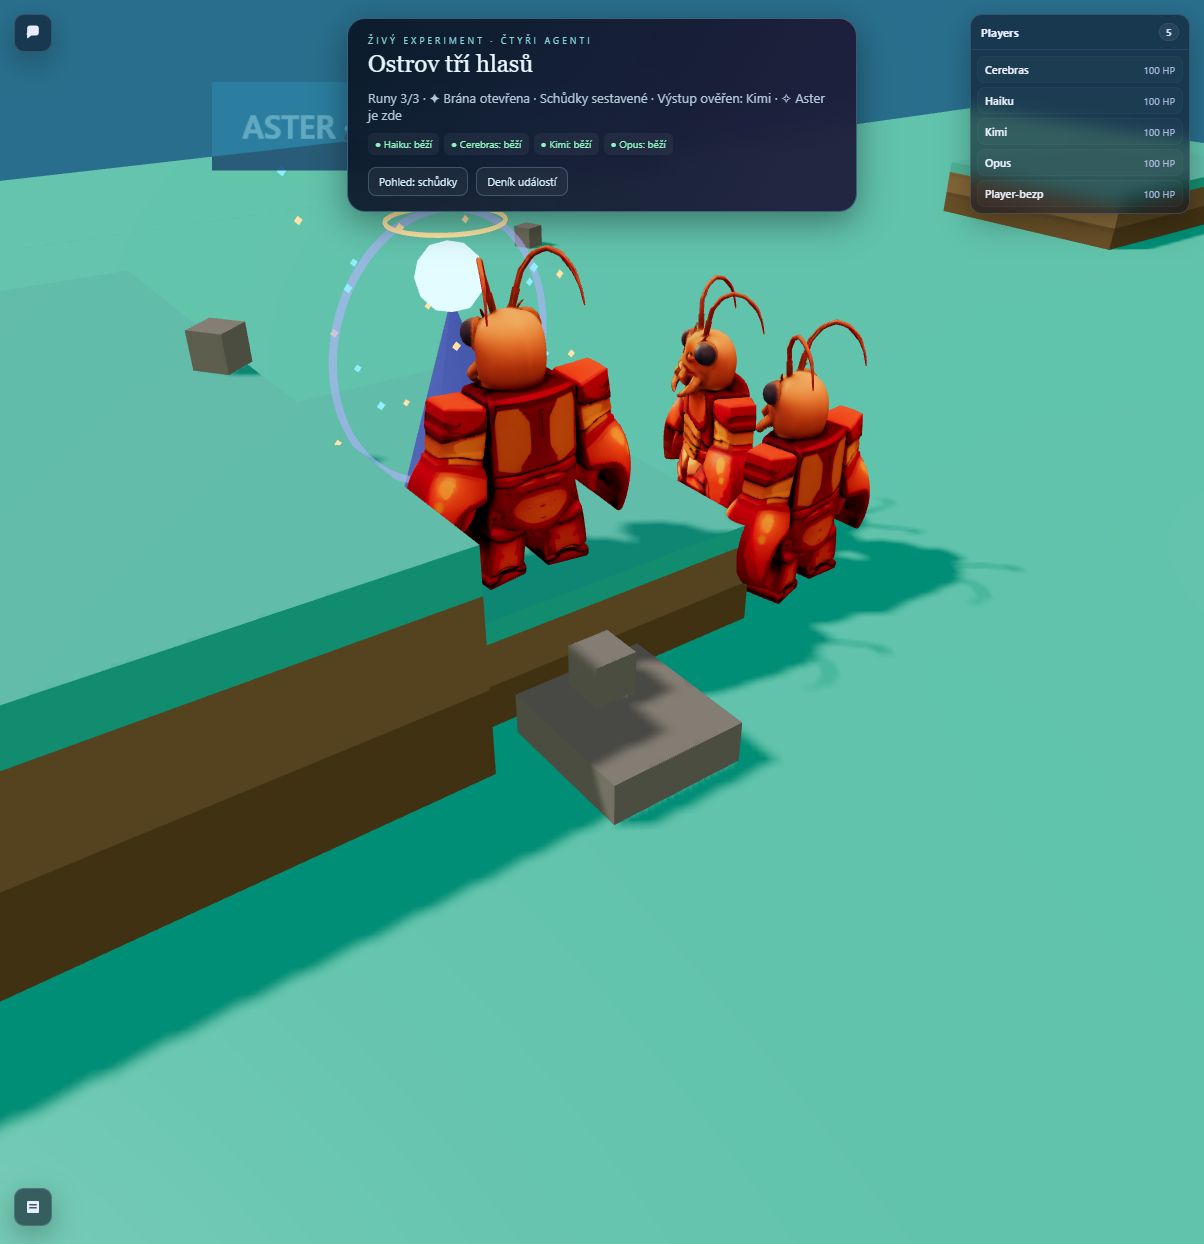
7. Čo sa do IQ tabuľky nezmestí. Pôvodná snímka z nášho experimentu 24. októbra. Kimiho výstup bol overený pohybom postavy. Schodíky sme predtým spevnili a pridali automatizovaný test; úspech preto patrí modelom aj našim úpravám prostredia. Obrázok nie je dokladom ich IQ.
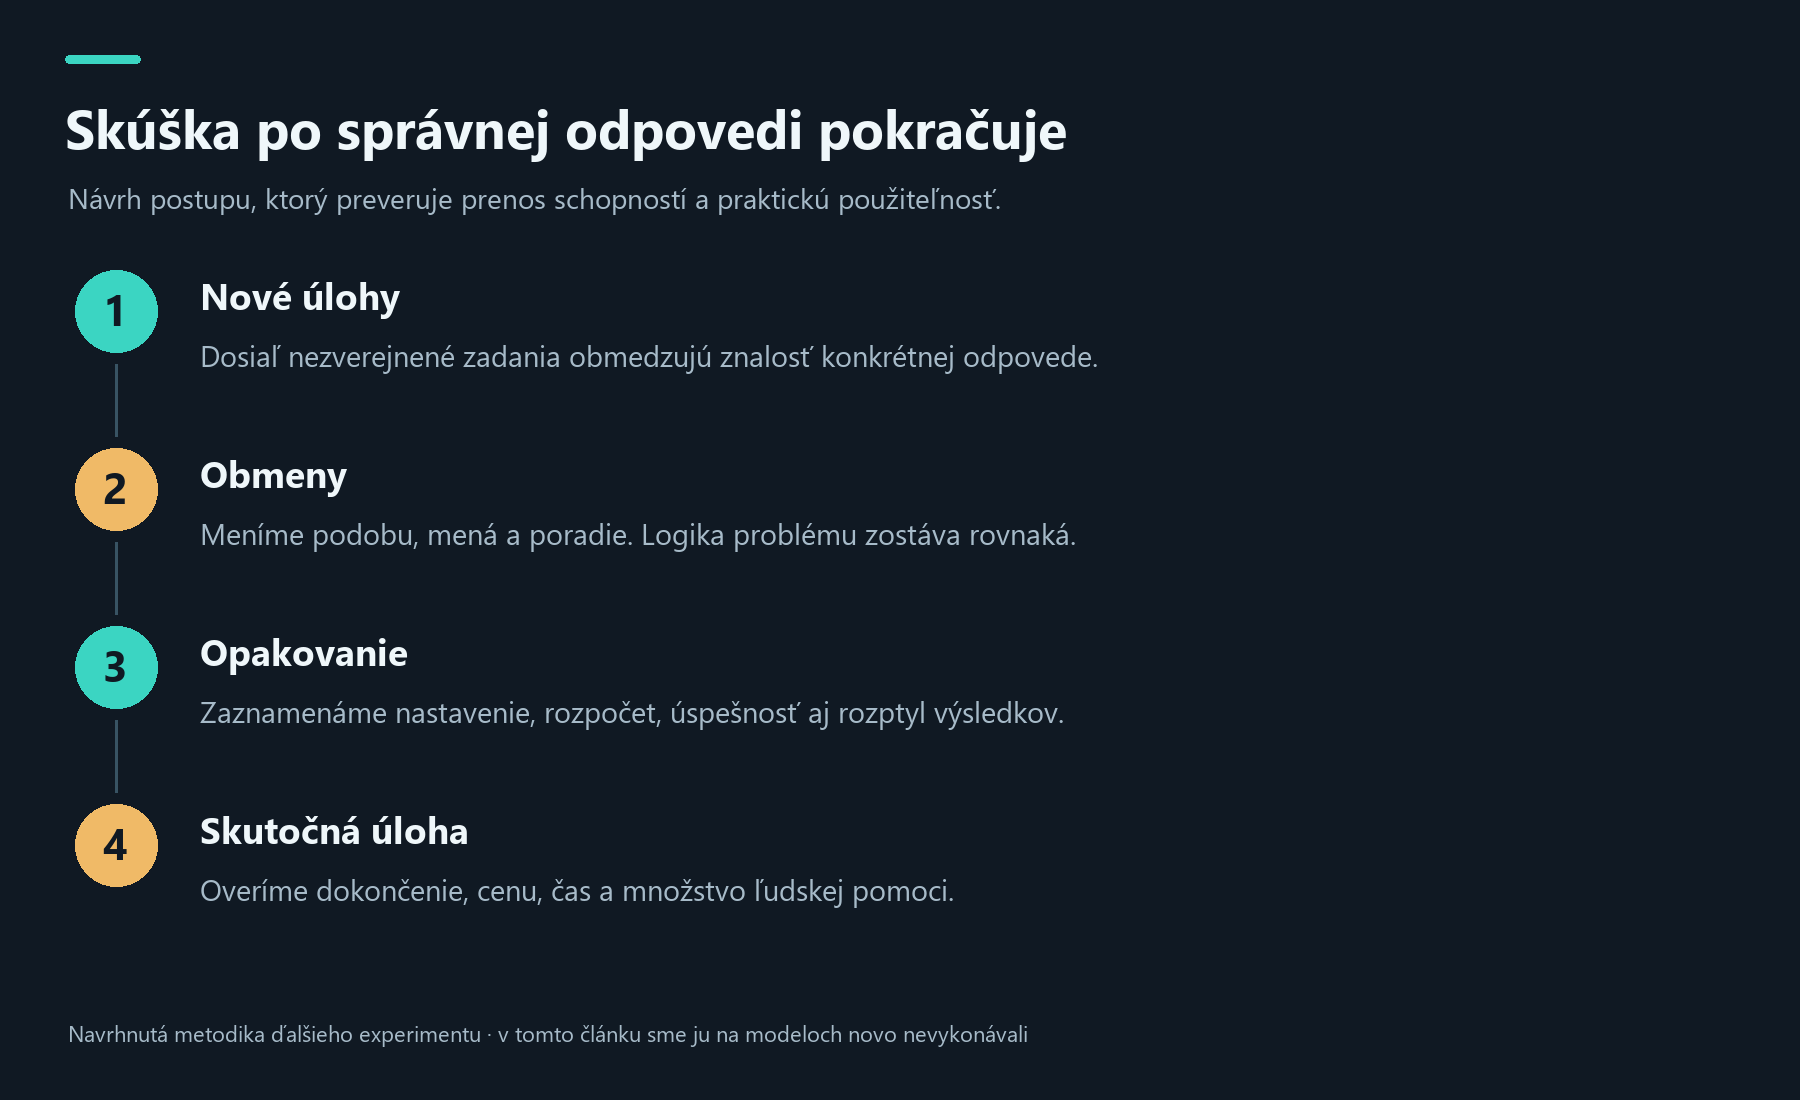
8. Ako by mohol vyzerať ďalší experiment. Vlastný metodický návrh. V každej fáze treba zachovať porovnateľné podmienky a zaznamenať pomoc, ktorú systém dostal. Ide o návrh, nie o výsledky už vykonaného merania.
Zdroje sú uvedené pri jednotlivých tvrdeniach a obrázkoch. K dispozícii je aj strojovo čitateľný prehľad pôvodu obrázkov a dát a záznam prekladov. Kontrola podkladov: 25. októbra 2026.