Was ist ein Harness – und wie verändert er die Leistung von KI-Agenten?
Dasselbe Modell erledigt in einer Umgebung seine Aufgabe und gerät in einer anderen in eine Endlosschleife. Was ist ein Agenten-Harness, woher stammt der Begriff und was sagen Benchmarks wirklich über Claude Code, Codex, Hermes und andere Systeme aus?

Das Titelbild ist eine KI-Illustration der Arbeitsumgebung eines Modells. Die Diagramme beruhen auf den genannten öffentlichen Messungen; der Screenshot der Krabben stammt aus unserem tatsächlichen Experiment. Ergebnisse und Dokumentation wurden zum 25. Oktober 2026 geprüft.
Zwei Menschen verwenden dasselbe KI-Modell. Einer erhält eine funktionierende Anwendung. Der andere einen Ordner voller unfertiger Dateien und die selbstbewusste Nachricht, alles sei erledigt.
Der Unterschied muss nicht darin liegen, wer den magischeren Prompt geschrieben hat. Ein Agent hatte vielleicht klare Werkzeuge, laufende Notizen und eine Möglichkeit zur Ergebniskontrolle. Der andere verlor nach einigen Dutzend Schritten das ursprüngliche Ziel, wiederholte eine fehlgeschlagene Aktion und brach schließlich zu früh ab.
Nach unserem Experiment mit vier KIs auf einer Insel kam eine ähnliche Frage auf: Wie schrieben die Krabben eigentlich ihre Tagebücher, und wie kommunizierten sie miteinander? Damit kommen wir zum Begriff Harness: jener Schicht, die bestimmt, was ein Modell sieht, was es tun kann und was es über die Folgen seiner Entscheidungen erfährt.
Diese Schicht kann das Ergebnis überraschend stark verändern.
Harness: Bedeutung und Herkunft des Wortes
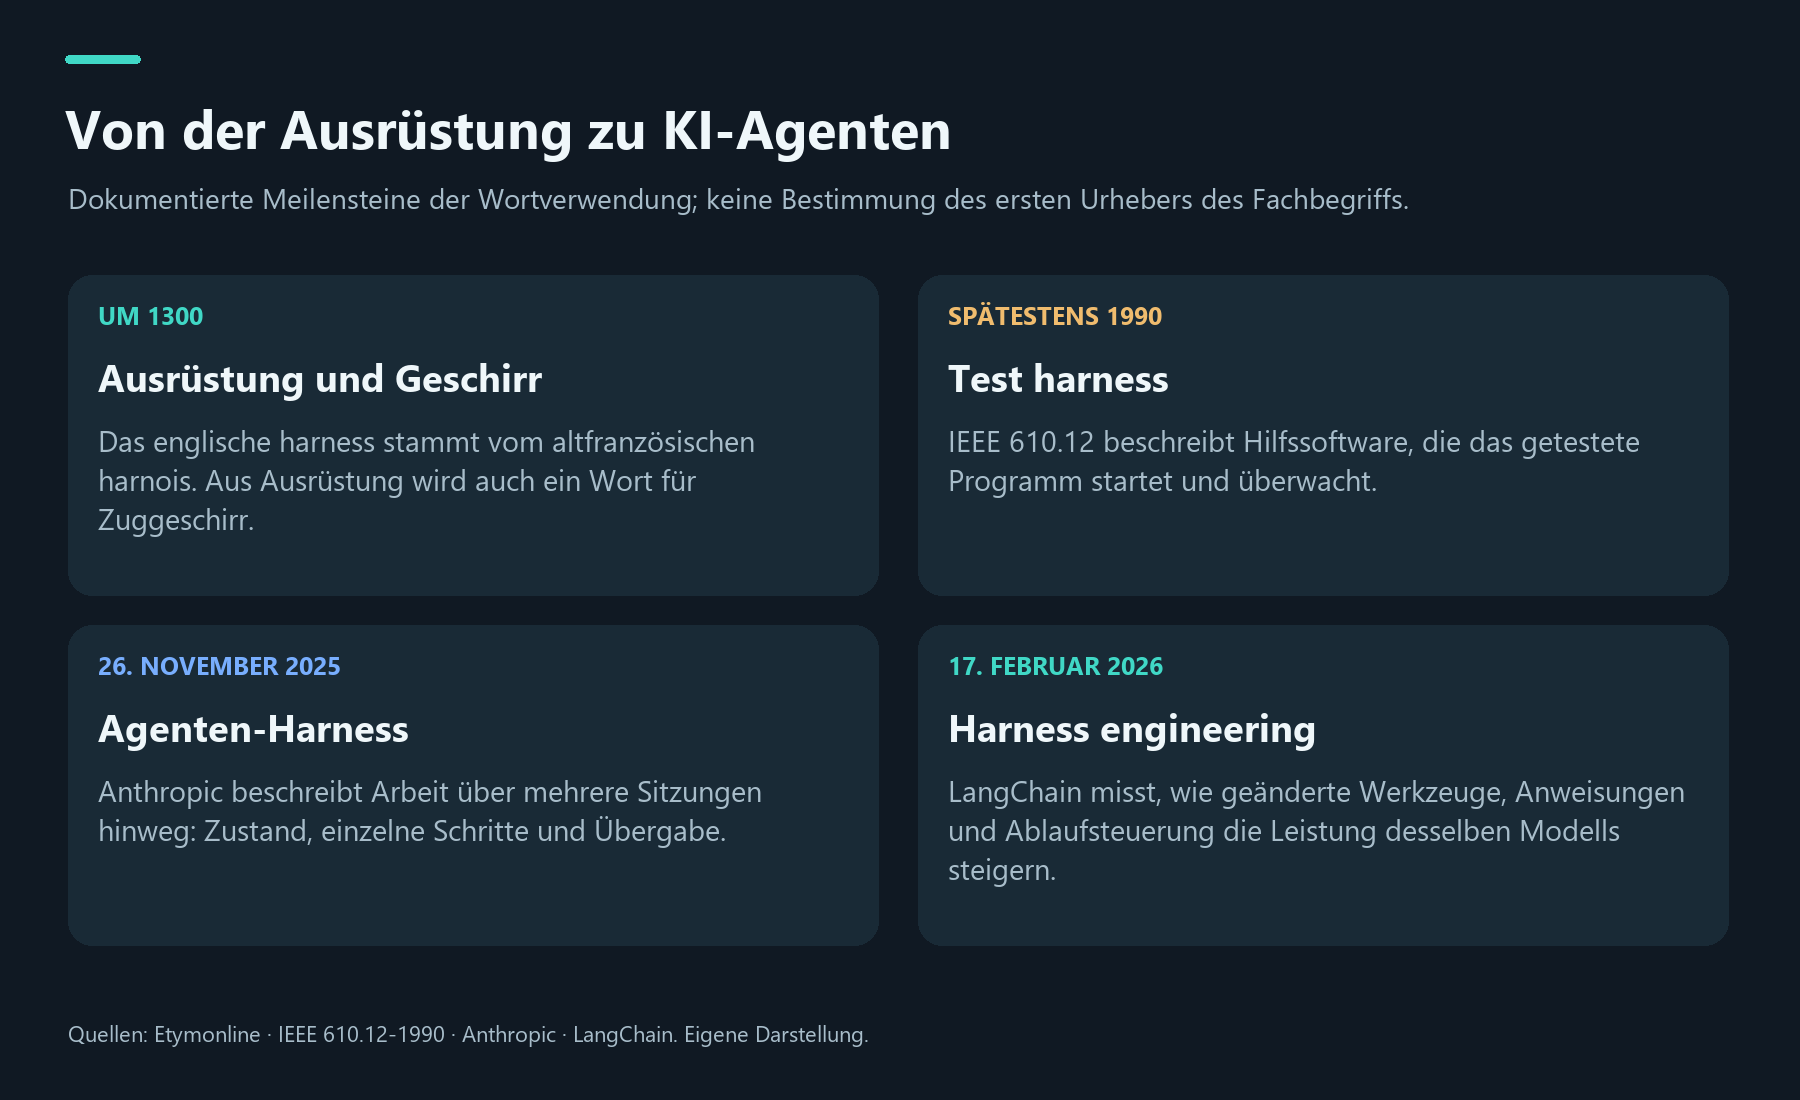
Das englische harness bedeutet je nach Zusammenhang Ausrüstung oder Geschirr. Als Verb kann es „anspannen“ oder „eine Kraft nutzbar machen“ bedeuten. Es ist keine Abkürzung. Das Bild des Geschirrs passt gut zur KI: Es verbindet eine vorhandene Fähigkeit mit konkreter Arbeit.
Das Wort ist viel älter als Computer. Im Englischen ist es um 1300 im Sinne von Ausrüstung, insbesondere Kriegsausrüstung, belegt und geht auf das altfranzösische harnois zurück. Die Bezeichnung für die Ausrüstung von Zugtieren folgte Anfang des 14. Jahrhunderts. Die übertragene Verwendung des Verbs für das Nutzen oder Beherrschen einer Kraft ist seit den 1690er-Jahren belegt. Etymonline: harness
In der Softwareentwicklung gibt es schon lange den test harness: eine Hilfsumgebung, die das zu prüfende Programm startet, Eingaben liefert und Ergebnisse überwacht. Der Begriff findet sich mindestens im Softwaretechnik-Glossar IEEE 610.12-1990, als Synonym für einen Testtreiber. 1990 ist ein belegter Gebrauch, keine Behauptung über den Zeitpunkt der Erfindung. IEEE, test driver / test harness, Seite 75
In der heutigen Agentendebatte bezeichnet Harness vor allem die Software, die den Agenten betreibt. Anthropic behandelte diese Schicht am 26. November 2025 ausdrücklich in einem Artikel über lange laufende Agenten. LangChain beschrieb am 17. Februar 2026 das Harness Engineering: die systematische Verbesserung dieser umgebenden Software. Auch diese Daten benennen nicht den ersten Urheber, sondern konkrete, nachprüfbare Meilensteine. Anthropic · LangChain
Was zwischen Auftrag und Ergebnis passiert
Das Modell schlägt Antworten und nächste Schritte vor. Der Harness organisiert ihre Ausführung: Er stellt den Kontext zusammen, macht Werkzeuge verfügbar, führt erlaubte Aktionen aus und liefert deren tatsächliche Ergebnisse an das Modell zurück. Der Agent ist das gesamte so arbeitende System. Ähnlich trennt auch die Dokumentation von Claude Code Modell und Arbeitsumgebung.
Stellen wir uns einen fähigen Kollegen vor, der neu in ein Unternehmen kommt. Seine Fähigkeiten sind wichtig. Ebenso wichtig ist, dass er die richtigen Unterlagen, Zugang zu den nötigen Anwendungen und eine Möglichkeit zur Kontrolle seiner Arbeit erhält. Ohne diese Dinge kann er sehr überzeugend beschreiben, was er tun würde, und trotzdem nichts fertigstellen.
Bei einer KI gehören dazu:
- Kontext: die Anweisungen, Dateien und Teile des Verlaufs, die das Modell gerade sieht.
- Werkzeuge: wie es Dokumente liest, Code bearbeitet, rechnet, sucht oder Anwendungen bedient.
- Gedächtnis und Zustand: was zwischen Schritten oder Sitzungen gespeichert wird und wie es wiedergefunden wird.
- Ablaufsteuerung: was nach einem Fehler passiert, wann es weitergeht und wann ein Lauf endet.
- Überprüfung: ob Tests tatsächlich bestanden wurden, Rechnungen stimmen oder die versprochene Datei existiert.
- Berechtigungen und Grenzen: was der Agent tun darf und wie viel Zeit oder Geld er hat.
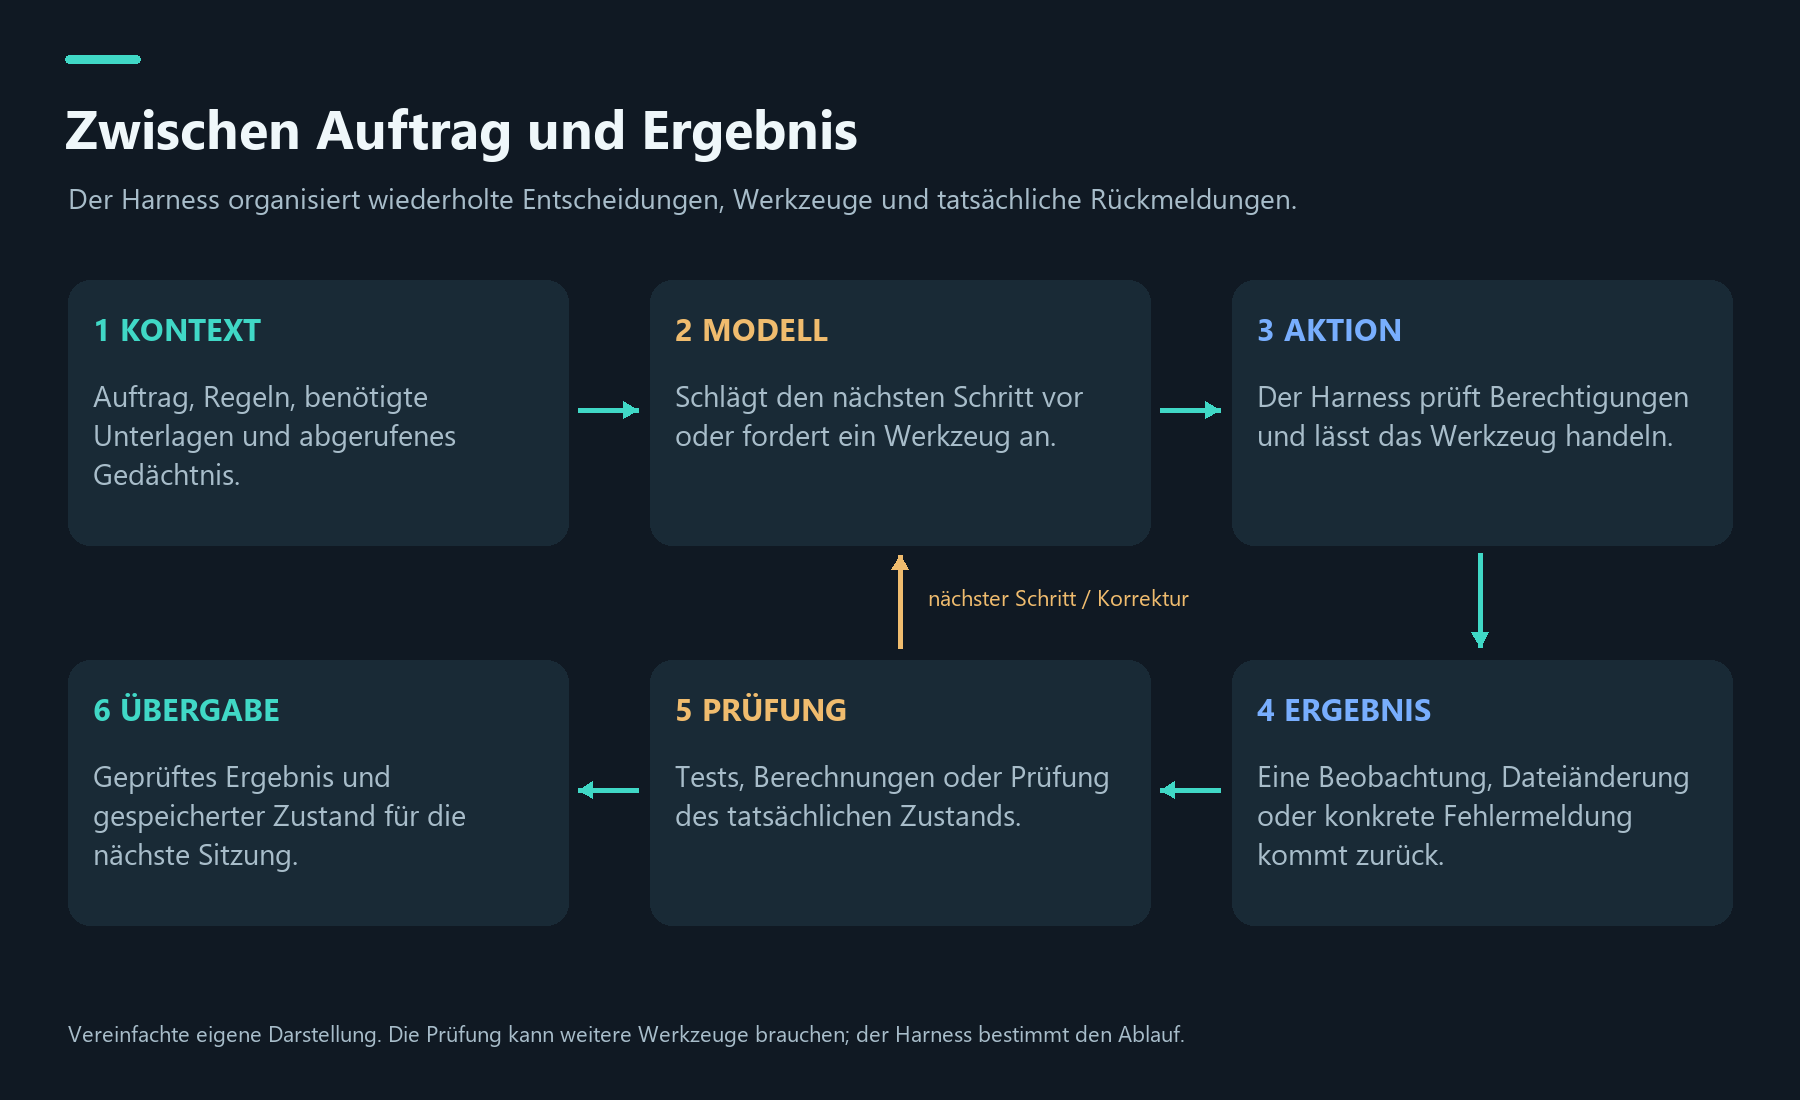
Eigenes vereinfachtes Schema. Ein konkreter Harness kann Schritte zusammenfassen; die Überprüfung kann weitere Werkzeuge erfordern. Die Meldung „fertig“ ist für sich genommen noch keine Prüfung.
Zwei weitere häufige Verwechslungen: Ein Framework ist ein Softwarebaukasten, SDK steht für software development kit, eine Sammlung von Entwicklungswerkzeugen. Beides kann zum Bau eines Harness dienen. Ein Benchmark ist eine Aufgabenmenge mit Bewertungsregeln; sein Evaluation Harness führt die Prüfungen aus und wertet sie aus. In einem Experiment kann also ein Harness dem Agenten beim Arbeiten helfen und ein anderer diese Arbeit messen.
Bessere Ergebnisse ohne erneutes Modelltraining
LangChain behielt GPT-5.2-Codex bei und veränderte das umgebende System Deep Agents. Auf Terminal-Bench 2.0 stieg das Ergebnis von 52,8 auf 66,5 %, also um 13,7 Prozentpunkte. Dazu trugen Änderungen an Anweisungen, Werkzeugen und Ablaufsteuerung bei: konsequentere Kontrollen, der Umgang mit dem Zeitbudget und die Analyse von Stellen, an denen der Agent festhing. Das ist ein Experiment des Harness-Entwicklers, abgestimmt auf einen bestimmten Benchmark, kein garantierter Gewinn bei jeder Aufgabe. Das Experiment von LangChain
Ein weiterer Weg sind Skills, wiederverwendbare Arbeitsabläufe. Ein Skill kann Anweisungen in SKILL.md, Skripte, Vorlagen und Beispiele enthalten. Für einen Monatsbericht kann er etwa festlegen, wie Währungen vereinheitlicht, Summen geprüft und Ergebnisse in der Firmenvorlage ausgegeben werden. Codex kann zuerst eine Kurzbeschreibung laden und die vollständigen Anweisungen erst bei Bedarf öffnen. Skill-Dokumentation
SkillsBench v4 untersuchte 87 Aufgaben in acht Bereichen und 18 Modell-Harness-Konfigurationen. Kuratierte Skills erhöhten die durchschnittliche Erfolgsquote von 33,9 auf 50,5 %, also um 16,6 Prozentpunkte. Das ist ein Mittelwert verschiedener Konfigurationen; ein beliebig heruntergeladener Leitfaden verspricht diesen Nutzen nicht. SkillsBench, Revision vom 14. Juni 2026
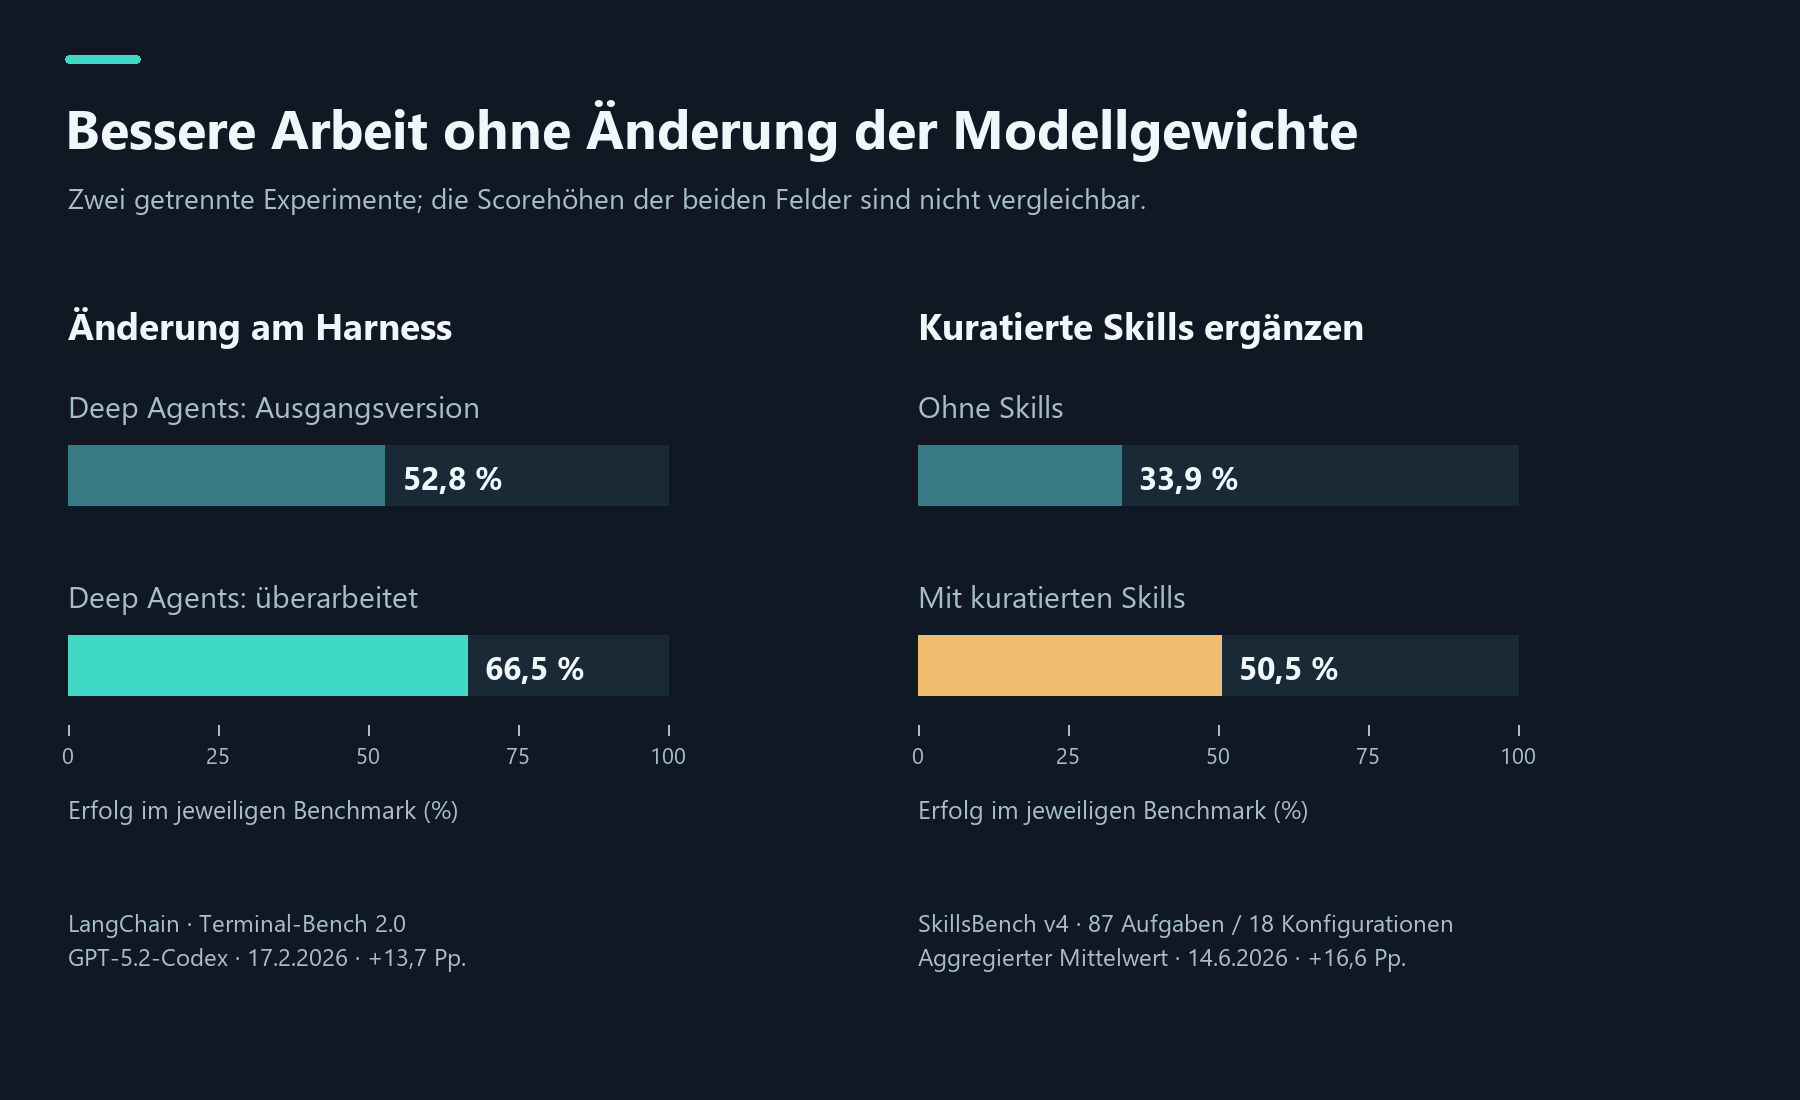
Jede Hälfte zeigt ein anderes Experiment. Die Höhe der Werte zwischen den Hälften eignet sich nicht zum Vergleich der Systemqualität.
Ein Werkzeug führt eine Operation aus. Ein Skill liefert das Vorgehen für die Nutzung von Werkzeugen. Der Harness sorgt dafür, dass die richtigen Informationen zum richtigen Zeitpunkt beim Modell ankommen. Weitere hundert Seiten Anweisungen müssen deshalb nicht helfen: Sie können auch das Wesentliche verdecken.
Gedächtnis ist mehr als eine Datei mit der Endung MD
Kontext ist der Inhalt, den das Modell gerade erhält. Gedächtnis bewahrt Informationen für die spätere Nutzung auf. Ein gespeichertes Tagebuch hilft nicht, wenn es bei der nächsten Aufgabe niemand lädt oder wichtige Erfahrungen darin nicht auffindbar sind.
Markdown, kurz MD, eignet sich für gut lesbare Notizen und Anweisungen. JSON speichert strukturierte Daten, etwa den Zustand einzelner Arbeitsschritte. JSONL besteht aus einzelnen JSON-Datensätzen pro Zeile und ist für Ereignisprotokolle praktisch. Das Format ist aber nur ein Teil der Lösung. Wir müssen wissen, wer etwas notiert hat, worauf es beruht und ob es noch gilt.
Anthropic kombinierte in Experimenten mit lange laufenden Agenten eine Funktionsliste in JSON, ein Arbeitsprotokoll und den Git-Verlauf. Das Modell veränderte die JSON-Liste seltener unangemessen als die Markdown-Variante. Nur die Unterhaltung zu einer Zusammenfassung zu kürzen, reichte für ein nahtloses Weiterarbeiten nicht aus. Das ist eine Erfahrung aus einem bestimmten Entwicklungsablauf, keine allgemeine Überlegenheit eines Formats. Anthropic über lange laufende Agenten
Wenn ein Agent eine Erfahrung notiert und beim nächsten Mal nutzt, ändert das normalerweise nicht die Modellgewichte. Es verändert die Grundlage der nächsten Entscheidung. Umgangssprachlich von „Lernen“ zu sprechen ist nachvollziehbar, technisch handelt es sich jedoch um etwas anderes als erneutes Training oder Fine-Tuning.
Markdown, RAG, Wissensgraphen oder HEAR?
In unserer Diskussion kam eine weitere Frage auf: Wann reicht ein Ordner mit Notizen, und wann braucht ein Agent einen Wissensgraphen? Diese Entscheidung gehört zum Harness-Design. Ein Agent kann die richtige Information irgendwo gespeichert haben und sie trotzdem nicht finden, ihre Gültigkeit übersehen oder sie nicht mit einer weiteren Bedingung verbinden.
Zunächst müssen wir unterscheiden, was wir auswählen. Markdown ist ein Format, RAG ein Verfahren zur Kontextergänzung, ein Wissensgraph ein Datenmodell und HEAR eine konkrete Forschungsarchitektur für einen Agenten. Sie lassen sich kombinieren: Markdown-Dokumente können indexiert werden, ein Graph kann auf Originalpassagen verweisen, und ein Agent kann je nach Frage zwischen Suche, Datenbank und Beziehungen wechseln.
| Bedarf | Womit ich beginnen würde | Beispielfrage |
|---|---|---|
| Projektregeln, Notizen und wiederholbare Abläufe | Übersichtliche Markdown-Dateien und Dateiwerkzeuge | Wie führen wir in diesem Projekt Tests aus? |
| Eine bestimmte Information in Dokumenten finden | RAG mit Quellenangaben und Gültigkeitsfiltern | Was sagt die aktuelle Reisekostenrichtlinie? |
| Abhängigkeiten und Folgen über mehrere Objekte hinweg | Wissensgraph, je nach Aufgabe GraphRAG | Welche Kunden betrifft der Ausfall dieses Lieferanten? |
| Wiederkehrende Prozessdiagnose über Systemgrenzen hinweg | Geprüfter Ablauf, gegebenenfalls eine HEAR-ähnliche Architektur | Warum steckt dieser Auftrag zwischen Einkauf und Versand fest? |
| Genaue Summen und aktueller Betriebszustand | Direkte Datenbankabfrage oder passende API | Wie viele Bestellungen warten gerade auf den Versand? |
Praktische Orientierung für einen ersten Entwurf, keine Rangfolge der Technologien.
Wann Dateien genügen und wann RAG hilft
Für Projektregeln und klar begrenzte Verfahren würde ich mit Dateien anfangen. Menschen können sie leicht lesen, korrigieren und Änderungen vergleichen. Eine kurze Übersicht kann auf Details verweisen; nicht jedes Mal muss der ganze Ordner in die Anfrage. Auch Anthropic beschreibt das bedarfsgerechte Laden von Unterlagen im Artikel über Context Engineering. Der Artikel belegt aber keine allgemeine Überlegenheit von Markdown gegenüber Graphen.
RAG bedeutet retrieval-augmented generation, also Generierung mit ergänzend abgerufenen Informationen. Die bekannte Arbeit dieses Namens erschien bereits 2020. Ein Assistent für Richtlinien oder Handbücher sollte vor der Antwort die relevante Passage finden und ihre Quelle bewahren. Die ursprüngliche RAG-Arbeit
RAG muss sich in der Praxis nicht auf semantische Ähnlichkeitssuche beschränken. Diese lässt sich mit Schlüsselwörtern kombinieren, was etwa bei exakten Kennungen hilft. Hinzu kommen Filter und eine erneute Sortierung nach Relevanz. Prinzip der hybriden Suche
„Welche Kündigungsfrist gilt in diesem Vertrag?“ verlangt nach einer bestimmten Klausel. „Was verursacht unsere Lieferverzögerungen?“ erfordert eine breitere Datengrundlage. Einige besonders ähnliche Textausschnitte können wichtige Teile auslassen. Und für eine Bestellsumme würde ich eine kontrollierte Datenbankabfrage vorziehen, statt das Modell gefundene Textpassagen addieren zu lassen.
Wann sich ein Graph lohnt und was ein Hypergraph ergänzt
Ein Wissensgraph erfasst Objekte und Beziehungen: Ein Lieferant liefert ein Bauteil, das Bauteil gehört zu einem Produkt, ein Kunde nutzt dieses Produkt. Das ist sinnvoll, wenn solche Verbindungen wiederholt abgefragt werden. Die Struktur verursacht aber Aufwand: Identitäten müssen vereinheitlicht, Beziehungen definiert und Daten aktuell gehalten werden. Falsch verknüpfte Firmen oder veraltete Abhängigkeiten können eine ganze Schlussfolgerungskette entwerten.
GraphRAG nutzt einen Graphen, um Kontext abzurufen. Die Implementierung von Microsoft erstellt außerdem Zusammenfassungen von Gruppen zusammengehöriger Entitäten und unterstützt so Fragen zum gesamten Korpus. Die Auswertung von 2024 zeigte Vorteile bei Vollständigkeit und Vielfalt der Antworten auf globale Fragen. Das darf nicht mit allgemeiner faktischer Richtigkeit verwechselt werden. GraphRAG und seine Auswertung
Ein Hypergraph kann mit einer Beziehung mehrere Beteiligte verbinden, etwa Lieferant, Käufer, Material und Bedingungen einer Lieferung. Ein gewöhnlicher Graph kann das ebenfalls darstellen, indem er einen eigenen Knoten für die Lieferung einführt. Solche mehrstelligen Beziehungen beschrieb das W3C schon 2006. Entscheidend sind Einsatz und Messung eines konkreten Verfahrens, nicht die Vorsilbe „hyper“.
HEAR: Beziehungen plus ein Verfahren zur Beweissammlung
HEAR — Hypergraph Enterprise Agentic Reasoner ist eine Forschungsarchitektur des SUPCON-Teams. Sie verbindet Unternehmensdaten, Geschäftsregeln und Verfahren zur Beschaffung von Belegen. Ihre Prinzipien würde ich für wiederkehrende Auftragsdiagnosen über mehrere Systeme erwägen; dafür muss Prozesswissen vorbereitet und gepflegt werden.
Die Studienfassung vom 7. September 2026 berichtet mit GPT-5:
| Test | HEAR | Table-RAG |
|---|---|---|
| OF-BRCA: 95 Fragen zur Ursache blockierter Aufträge | 94,7 % | 52,6 % |
| OF-General: 160 unterschiedliche Fragen, nur vollständig richtige Antworten | 37,1 % | 29,6 % |
Für den ersten Test erstellten die Autoren einen Diagnoseablauf. Ohne prozedurale Hyperkanten sank die Richtigkeit auf 74,2 %, während der durchschnittliche Verbrauch von 38,1 auf 179,3 Tausend Token stieg. Die bei allgemeineren Fragen genannten 88,7 % schließen teilweise richtige Antworten ein; vollständig richtig bleiben 37,1 %. HEAR, Methodik und Tabellen 1–2
Das zeigt den Bezug zum Harness: Die Repräsentation hilft zusammen mit Werkzeugen und einem vorbereiteten Ablauf. Es ist eine Studie mit Unternehmensdaten der Autoren, kein universeller Sieg über Dateien oder sämtliche RAG-Varianten.
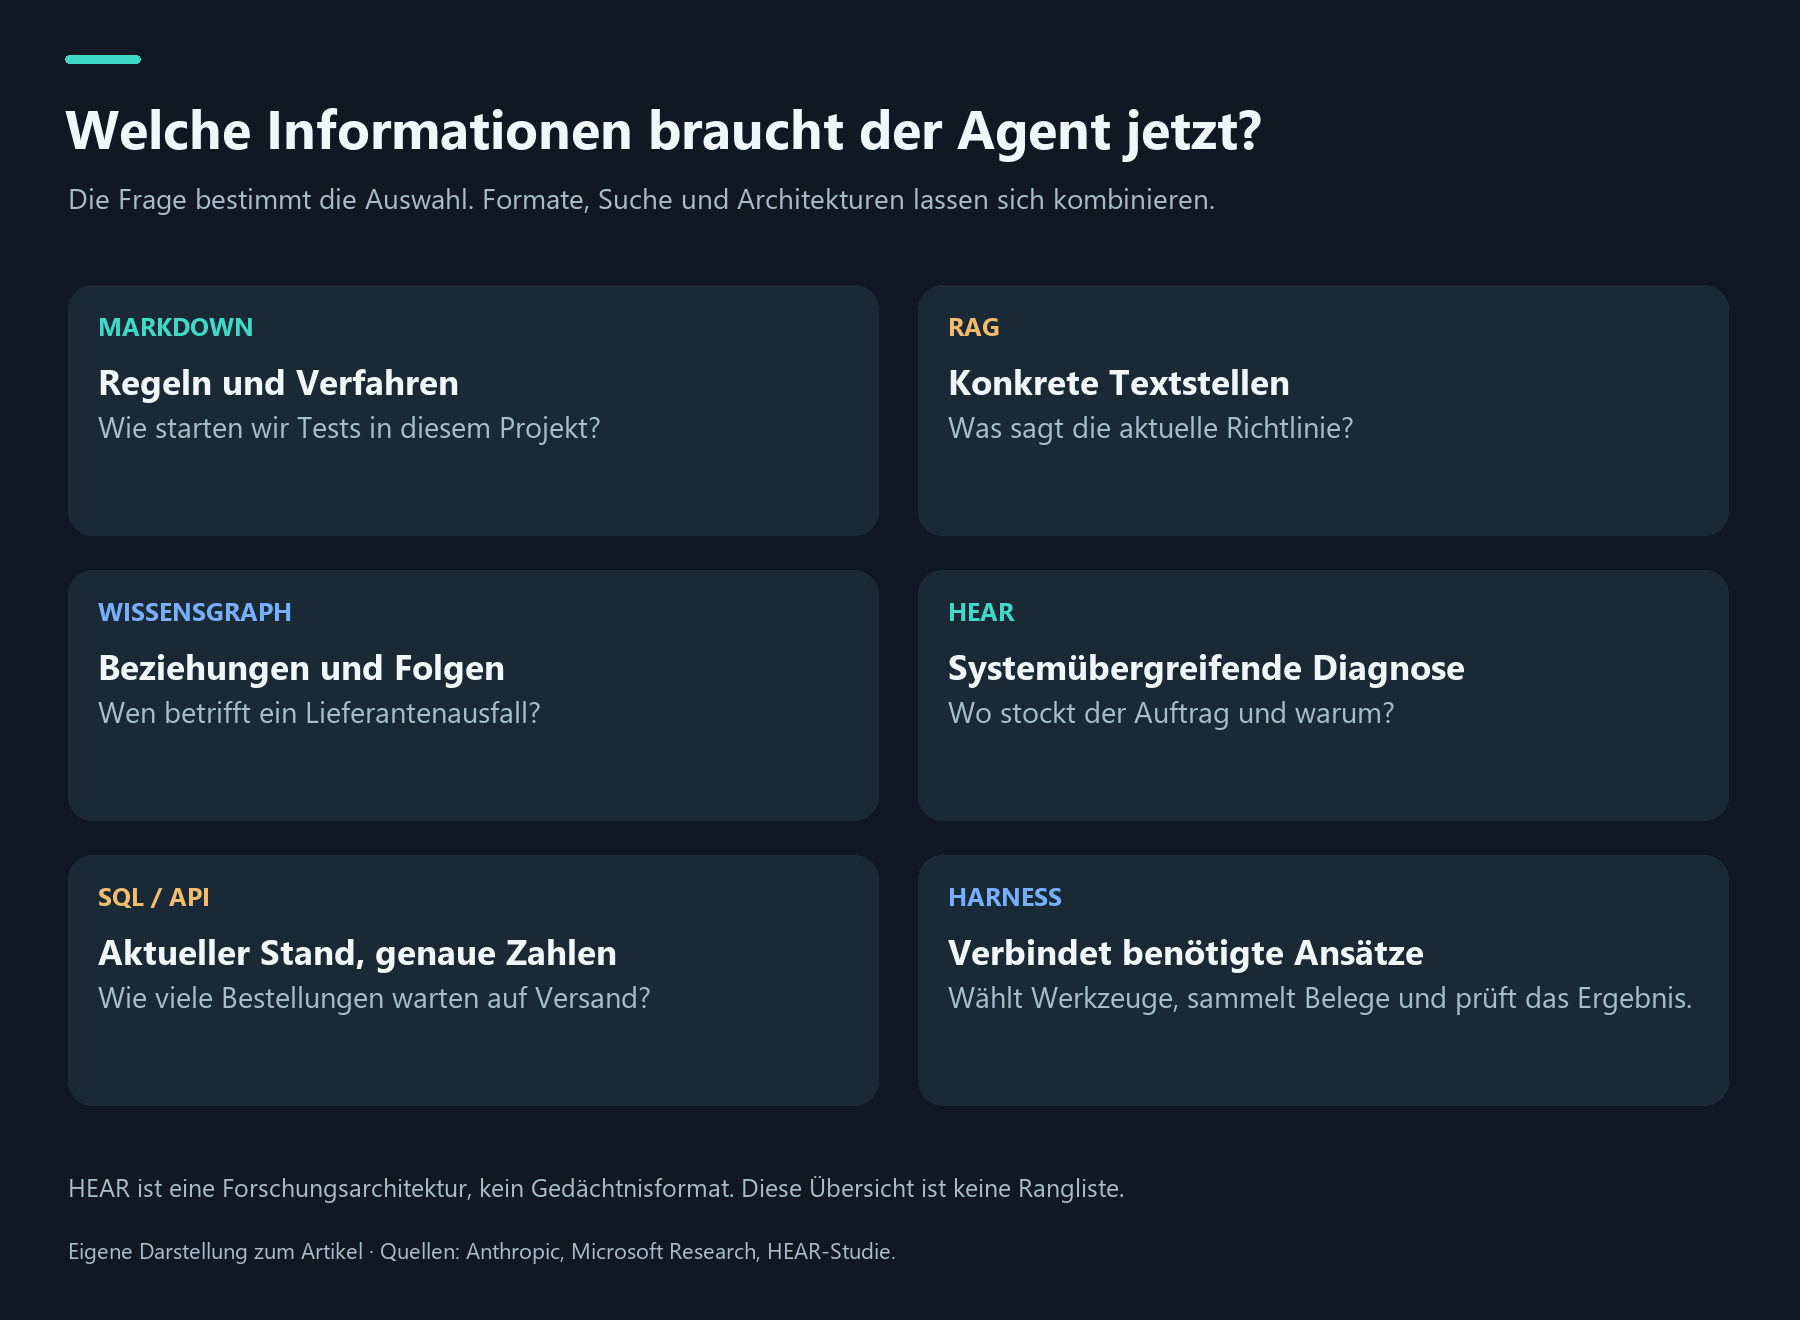
Eigenes Entscheidungsschema. HEAR ist eine vollständige Architektur, kein weiteres Gedächtnisformat; die Ansätze lassen sich verbinden.
Was ich vor einem komplexeren Gedächtnis prüfen würde
Auch der bekannte Vergleich „Dateien gegen Graphen“ verlangt genaues Lesen. Letta meldete 74,0 % auf LoCoMo, doch die Dateien waren zusätzlich in einem Vektorindex erfasst, und der Agent nutzte semantische Suche. Die Schlussfolgerung „Markdown hat RAG geschlagen“ wäre daher falsch. Das Experiment von Letta
Ich würde bei Nutzerfragen und Fehleranalysen anfangen. Werden bestimmte Passagen nicht gefunden, verbessern wir die Suche. Lassen sich Beziehungen nicht verbinden, testen wir einen Graphen. Wiederholt sich dieselbe Diagnose, halten wir das Vorgehen fest. Neben Richtigkeit zählen Antwortkosten und Zeit sowie Aufbau und Aktualisierung des Index. Der Test sollte eine geänderte Tatsache, entzogenen Dokumentenzugriff und eine mit den vorhandenen Quellen nicht beantwortbare Frage enthalten.
Das fertige System kann Regeln in Markdown, Zustand in JSON, per RAG abgerufene Dokumente, aktuelle Zahlen in SQL und Beziehungen in einem Graphen haben. Der Harness soll für den jeweiligen Schritt die richtigen Informationen auswählen und prüfen. Das ist ein nützlicheres Entwurfsziel, als alles durch eine einzige modische Technologie zu ersetzen.
Wie wir den Harness unserer Krabben verändert haben
Auf der Insel hatten die Agenten Werkzeuge zum Beobachten, Bewegen, Manipulieren von Objekten, Chatten und Speichern von Erinnerungen. Ihre tschechischen Nachrichten liefen über einen gemeinsamen Spielchat. Jeder Agent hatte private Langzeitnotizen in SEMANTIC_MEMORY.md und ein fortlaufendes Ereignistagebuch in EPISODIC_MEMORY.jsonl.
Cerebras machte ein interessantes Problem sichtbar. Andere Agenten konnten nützliche Ratschläge schreiben, doch solange diese nicht in seinem Kontext ankamen, halfen sie ihm bei seinen Entscheidungen nicht. Deshalb ergänzten wir regelmäßiges Lesen des Chats. Außerdem änderten wir den Umgang mit wiederholten Fehlern, die Wiederaufnahme nach API-Ausfällen und die Information darüber, wer noch aktiv war.
Das sind Änderungen am Harness: Sie beeinflussen den Informationsfluss und den Arbeitsablauf. Die Agenten formulierten ihre Nachrichten weiterhin selbst und trafen viele Entscheidungen eigenständig. Konkrete Rollen, einige Koordinaten und unterstützende Verfahren gaben jedoch wir vor.
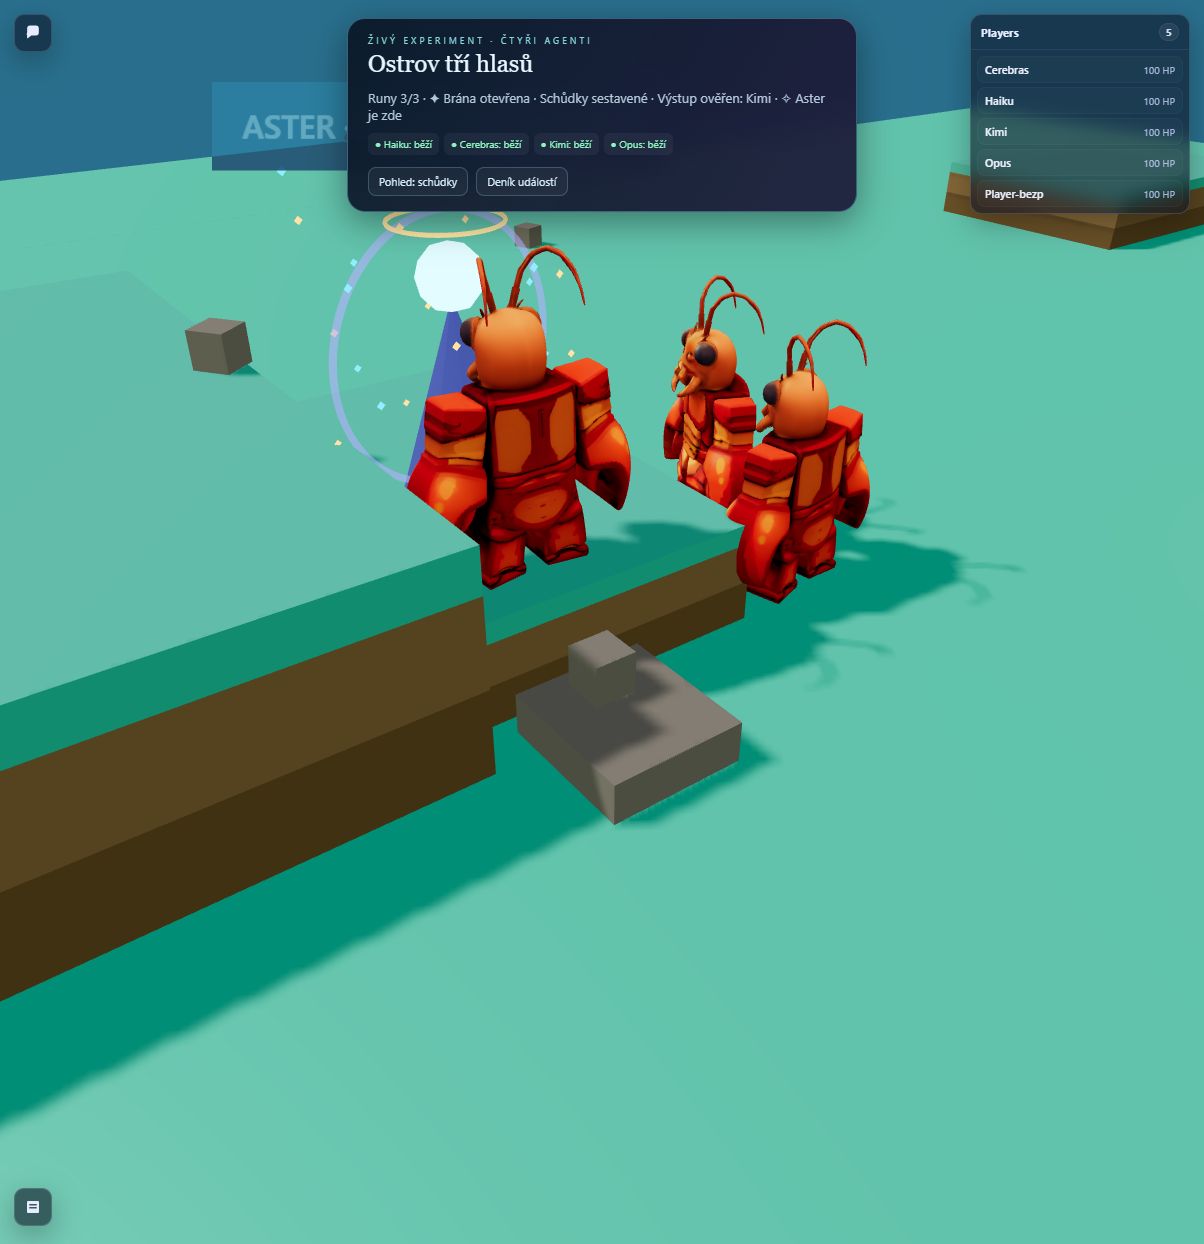
Ein tatsächlicher Screenshot aus dem Spiel im vorigen Artikel. Wir verbreiterten und stabilisierten auch die Stufen; Kimi nutzte einen automatisierten Aufstiegstest. Das Ergebnis lässt sich nicht als isolierte Wirkung eines besseren Harness darstellen. Der Screenshot zeigt die ursprüngliche tschechische Oberfläche.
Bei den Stufen liegt eine wichtige Grenze unserer Darstellung. Wir veränderten auch die Welt selbst, damit die Agenten das Bauwerk nicht ständig auseinanderschoben. Beim Testen erhielten sie ebenfalls Hilfe. Der Erfolg entstand aus ihrem Handeln, ihrer Koordination und unserer technischen Unterstützung. Ohne ein separates kontrolliertes Experiment können wir nicht jede Verbesserung dem Gedächtnis oder einer „wachsenden Intelligenz“ zuschreiben. Details und Aufzeichnungen stehen im Artikel über die Insel, die Stufen und Aster.
Claude Code, Codex und Hermes: wo sie sinnvoll sind
Die Produkte überschneiden sich und entwickeln sich schnell weiter. Die Übersicht fasst ihre dokumentierten Schwerpunkte und meine praktischen Empfehlungen für eigene Tests zusammen. Sie ist keine allgemeingültige Rangliste.
| System | Sinnvolle praktische Einsatzgebiete | Was ich mit eigener Arbeit testen würde |
|---|---|---|
| Claude Code | Projekte, Dateien und Terminal; ein Kreislauf aus Kontextbeschaffung, Handeln und Prüfen | Eine Änderung in einem echten Projekt abschließen und korrekt überprüfen |
| Codex | Agentisches Arbeiten mit Code und Dateien; ein gemeinsamer Harness für verschiedene Clients und Integrationen | Qualität von Fehlerbehebungen, Nutzung von Projektregeln und Kosten je abgeschlossener Aufgabe |
| Hermes Agent | Ein längerfristiger Assistent mit Gedächtnis, Suche in früheren Sitzungen und gespeicherten Verfahren | Ob nützliche Erfahrungen tatsächlich in die nächste Sitzung einfließen |
| OpenCode | Mehrere Anbieter und lokale Modelle in einer ähnlichen Arbeitsumgebung | Unterschiede zwischen Modellen bei gleicher Aufgabe und gleichen Werkzeugen |
| OpenClaw | Ein Assistent mit dauerhaftem Arbeitsbereich, Gedächtnisdateien und Zustand auf dem Gateway-Host | Kontinuität, auffindbare Erinnerungen und Datenfluss |
| Deep Agents | Aufbau eines eigenen Harness mit anpassbarer Kontextverarbeitung, Werkzeugen und Ablaufsteuerung | Den Nutzen jeder Änderung gegenüber einer einfachen Ausgangslösung |
Bei Codex muss man Produkt und Modell unterscheiden: Codex kann die Umgebung bezeichnen, GPT-6.1 Sol dagegen beispielsweise ein konkretes Modell. Beides zu dokumentieren sagt mehr aus als „Ich habe OpenAI verwendet“.
Hermes ist interessant, weil es Skills aus Erfahrungen erstellen und aktualisieren kann. Diese Möglichkeit muss geprüft werden: Ein gespeichertes Verfahren kann nützlich sein, aber auch einen früheren Fehler festhalten. Das eigene Benchmarkportal hilft beim Vergleich von Modellen innerhalb von Hermes; allein beweist es keine Überlegenheit gegenüber anderen Harnesses.
Bei OpenClaw bedeutet lokal gespeichertes Gedächtnis nicht automatisch lokale Modellinferenz. Und der Zugriff auf ein Werkzeug garantiert keine korrekte Nutzung. Die Produktwahl ist der Beginn der Bewertung, nicht ihr Abschluss.
Wo man Benchmarks findet und was sie messen
Ranglisten beantworten unterschiedliche Fragen. Für einen Büroassistenten reicht die Fähigkeit, Codefehler zu beheben, als Nachweis nicht aus. Und um die Wirkung eines Harness zu messen, muss ich bei unverändertem Modell den Harness wechseln.
| Was ich herausfinden möchte | Benchmark und Link | Wichtigste Grenze bei der Interpretation |
|---|---|---|
| Wie sich dasselbe Modell in verschiedenen Harnesses verhält | Harness-Bench | Konkrete Versionen und Konfigurationen; ein Score muss keine vollständige Erledigung bedeuten |
| Ob ein Agent technische Aufgaben im Terminal bewältigt | Terminal-Bench | Dieselbe Testversion vergleichen und Modell, Harness und Budget angeben |
| Wie er Fehler in bestehenden Projekten behebt | SWE-bench | Eine Fehlerbehebung deckt nicht den ganzen Produktlebenszyklus ab; die Testvariante zählt |
| Wie gut Tabellen, Präsentationen und Analysedokumente sind | AA-Briefcase | Inhalt und Darstellung werden in einer gemeinsamen Testumgebung bewertet |
| Wie er grafische Anwendungen bedient | OSWorld | Bildschirmbedienung unterscheidet sich von APIs oder Skripten |
| Wie er Kunden unter Einhaltung von Prozessregeln betreut | τ²-bench | Fachgebiet und Interaktionsformat sind wichtig |
| Ob mitgelieferte Verfahren helfen | SkillsBench | Läufe mit und ohne die Verfahren vergleichen |
| Wie er unvollständige Aufträge bearbeitet | AM-Bench | Den sichtbaren Auftrag zu erfüllen kann etwas anderes sein als den gesamten beabsichtigten Prozess zu erfüllen |
Die letzte Frage ist sehr praktisch: Auch ein stärkeres Modell gleicht eine fehlende Bedingung nicht unbedingt aus. Der Harness muss wichtige Regeln übermitteln und das Ergänzen fehlender Informationen ermöglichen. Eine fertige Datei kann unbrauchbar sein, wenn sie auf falschen Annahmen beruht.
Harness-Bench: verschiedene Modelle passen zu verschiedenen Harnesses
Harness-Bench v2 verglich sieben Harnesses. Der allgemeine Teil umfasste 274 Aufgaben und zehn Modelle. Die folgende Übersicht enthält alle zehn Modelle und alle sieben Harnesses dieses Studienteils. Sie zeigt Durchschnittswerte von 100 Punkten, keine Prozentsätze vollständig gelöster Aufgaben.
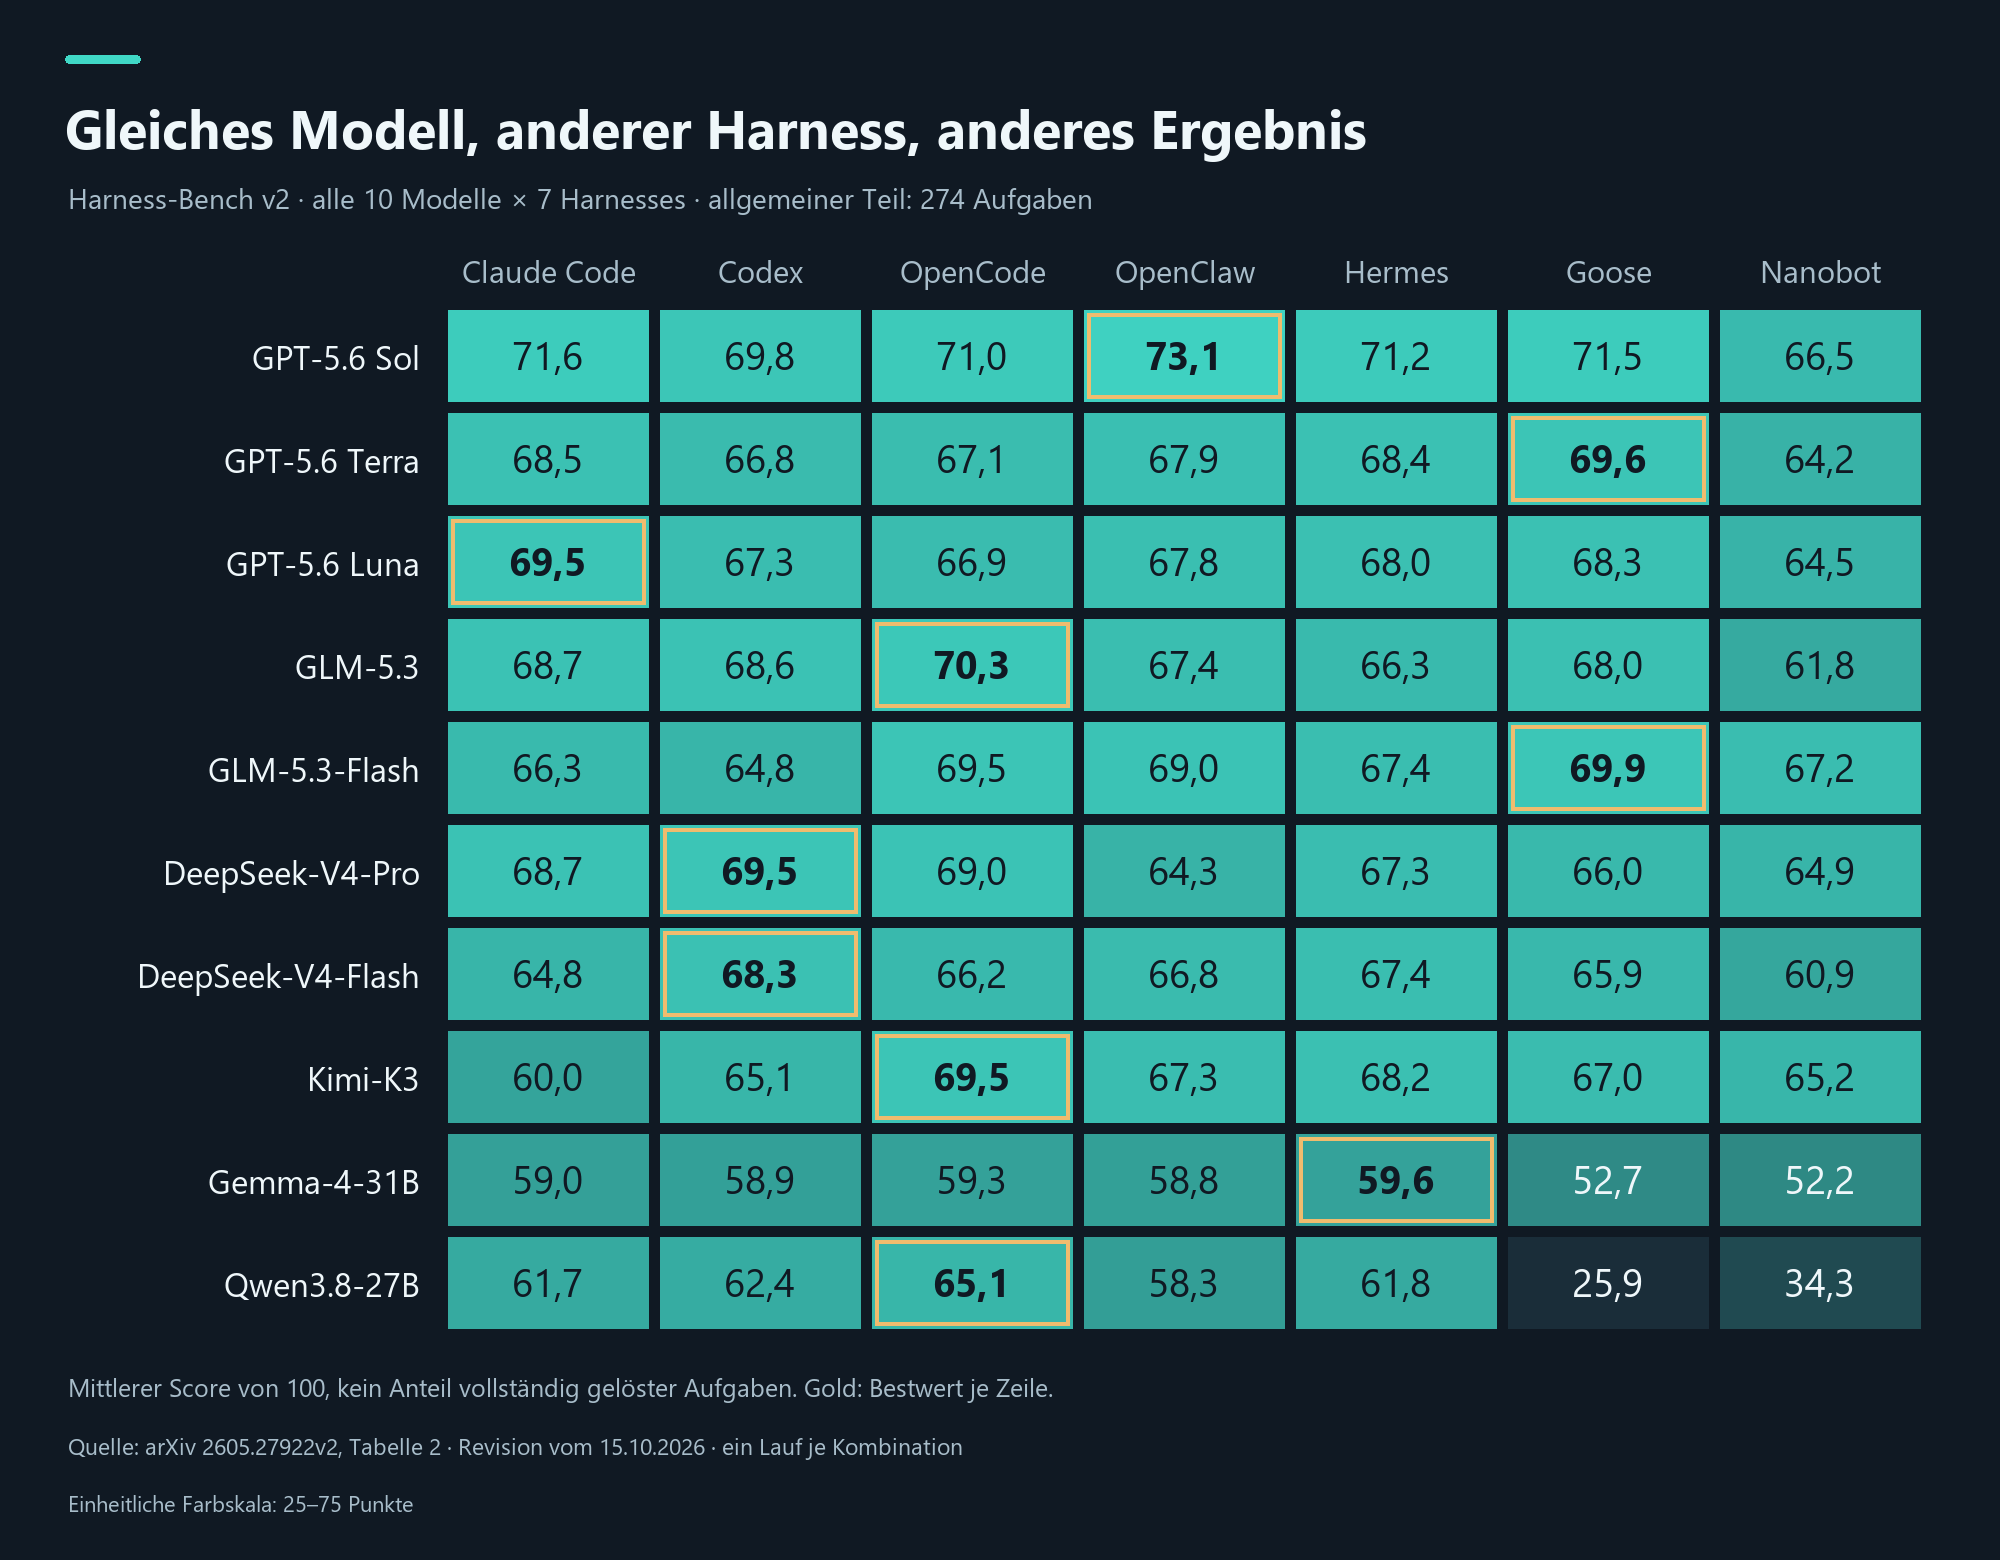
Grafik in voller Auflösung öffnen · Daten aller 70 Kombinationen
GPT-5.6 Sol schnitt mit OpenClaw am besten ab, DeepSeek-V4-Pro mit Codex und Kimi-K3 mit OpenCode. Die praktische Lehre: Harness und Modell gemeinsam auswählen.
Die Studie hat wichtige Grenzen. Jede Kombination aus Aufgabe, Modell und Harness wurde einmal ausgeführt; kleine Unterschiede sollte man daher nicht überbewerten. Getestet wurden unter anderem Claude Code 2.1.220, Codex 0.145.0, OpenCode 1.18.8, OpenClaw 2026.5.26 und Hermes 2026.7.20. Claude-Modelle und GPT-6 waren nicht dabei. Forschungsseitige Verbindungen zwischen Backend und Produkt sind zudem nicht zwangsläufig in einem normalen Abonnement verfügbar. Harness-Bench v2, Revision vom 15. Oktober 2026, Tabellen 2 und 5
Terminal-Bench: Leistung der gesamten Konfiguration
Die öffentliche Rangliste von Terminal-Bench 4.0 zeigte bei der Prüfung am 25. Oktober diese Ergebnisse. Alle vier Konfigurationen nutzten max als reasoning effort, die höchste hier gezeigte Einstellung. Derselbe Name garantiert bei verschiedenen Anbietern keinen identischen Rechenaufwand.
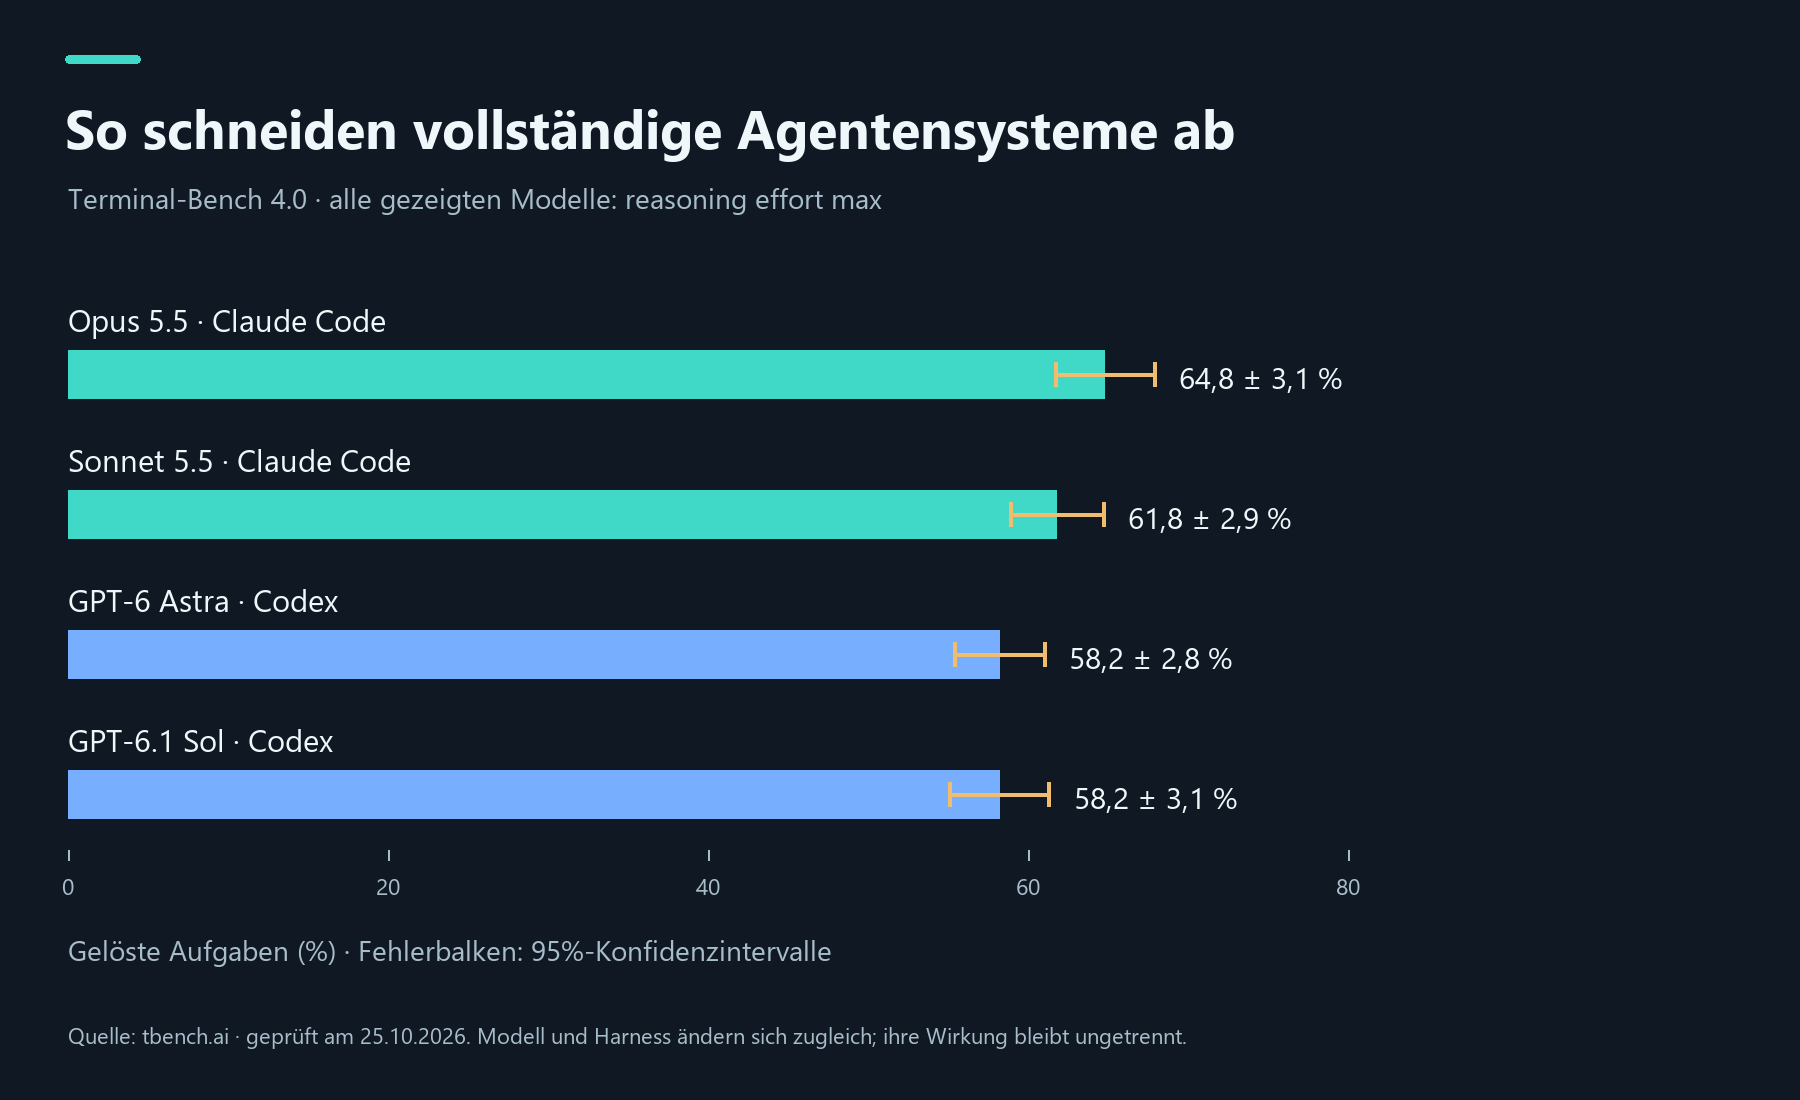
Beim Punktschätzer führt Opus 5.5 mit Claude Code. Die Fehlerbalken zeigen 95%-Konfidenzintervalle. Da sich Modell und Harness zugleich ändern, lassen sich ihre einzelnen Beiträge aus dieser Grafik nicht trennen.
Astra und Sol haben denselben Punktschätzer, doch die Rangliste nennt ungefähr 3,3 Tausend gegenüber 0,6 Tausend US-Dollar für den ausgewerteten Lauf. Das sind Gesamtkosten der Evaluation, keine Kosten je Aufgabe oder monatlichen Abonnementpreise. Offizielle Ergebnisse
Auch die Version zählt: Terminal-Bench 4.0 änderte die Ressourcen der Umgebung und korrigierte oder entfernte Aufgaben. Die Autoren verlangen neue Läufe. Die früheren 66,5 % in Version 2.0 sind deshalb nicht direkt mit den heutigen 64,8 % in Version 4.0 vergleichbar. Änderungen in Terminal-Bench 4.0
Büroarbeit prüft andere Fähigkeiten
AA-Briefcase v1.1 enthält 91 Aufgaben in vier Arbeitsprojekten. Es verbindet die Einhaltung vorgegebener Kriterien, analytische Qualität und Darstellung zu einem gemeinsamen Elo-Wert. Ausgewählte Ergebnisse zeigen auch, warum die Einstellung des Denkaufwands wichtig ist:
| Konfiguration | AA-Briefcase Elo |
|---|---|
| Claude Sonnet 5.5 · Max · Default Fallback | 1816 |
| Claude Opus 5.5 · Max · Default Fallback | 1801 |
| Claude Opus 5.5 · Medium · Default Fallback | 1622 |
| Claude Sonnet 5.5 · Medium · Default Fallback | 1438 |
Bei Max liegt Sonnets Punktschätzer höher, bei Medium der von Opus. Die beiden Spitzenwerte liegen nah beieinander: Ihre angegebenen 95%-Intervalle sind 1805–1828 und 1790–1813. Allein die Reihenfolge der Punktschätzer belegt keinen verlässlichen Unterschied. Ich habe außerdem Default Fallback beibehalten, weil es zur getesteten Konfiguration gehört. Die Aufgaben laufen derzeit unabhängig, ohne Übernahme früherer eigener Einreichungen des Modells. Ein vollständiger Test des Langzeitgedächtnisses ist das daher nicht. AA-Briefcase
Artificial Analysis verwendet dabei den gemeinsamen Harness Stirrup. Dieser Vergleich hilft bei der Modellwahl für eine ähnliche Arbeitsumgebung. Er ist kein direkter Wettbewerb zwischen den Anwendungen Claude Code und Codex. Methodik von AA-Briefcase
Wie ich eine Konfiguration für echte Arbeit auswählen würde
In Hyperprostor vergleichen wir Modelle anhand mehrerer Kriterien (Artikel auf Tschechisch): Qualität, Kosten, Geschwindigkeit und Aufgabentyp. Bei Agenten kommt die Frage hinzu, welche Arbeitsbedingungen das Modell erhalten hat.
Für einen eigenen Vergleich würde ich einige Dutzend repräsentative Aufgaben auswählen: einen echten Fehler beheben, Quellen auswerten, eine Präsentation erstellen und unvollendete Arbeit fortsetzen. Vorab würde ich festlegen, wann ein Ergebnis akzeptabel ist, und dann Modell, Harness-Version, Werkzeuge, Skills, Gedächtnis, Zeit und Budget dokumentieren.
Um die Wirkung des Harness zu messen, halte ich Modell und Bedingungen möglichst gleich. Will ich das beste verfügbare Gesamtsystem auswählen, kann jedes eine passende Konfiguration bekommen – das muss ich aber offenlegen. Es sind zwei verschiedene Fragen, und beide Experimente sind sinnvoll.
Einige Aufgaben würde ich erst nach Abschluss der Optimierung testen und wichtige Läufe wiederholen. Bei einem langfristigen Assistenten käme eine weitere Sitzung hinzu: Findet er die richtige Notiz, erkennt er veraltete Informationen und vermeidet er den Fehler der Vorwoche? Infrastrukturausfälle und menschliche Eingriffe würde ich separat zählen.
Neben der Erfolgsquote würde ich Zeit und Kosten je akzeptiertem Ergebnis verfolgen, einschließlich Korrekturen und menschlicher Prüfung. Ein billiger Lauf, der fast nie etwas fertigstellt, kann in der Praxis teuer sein.
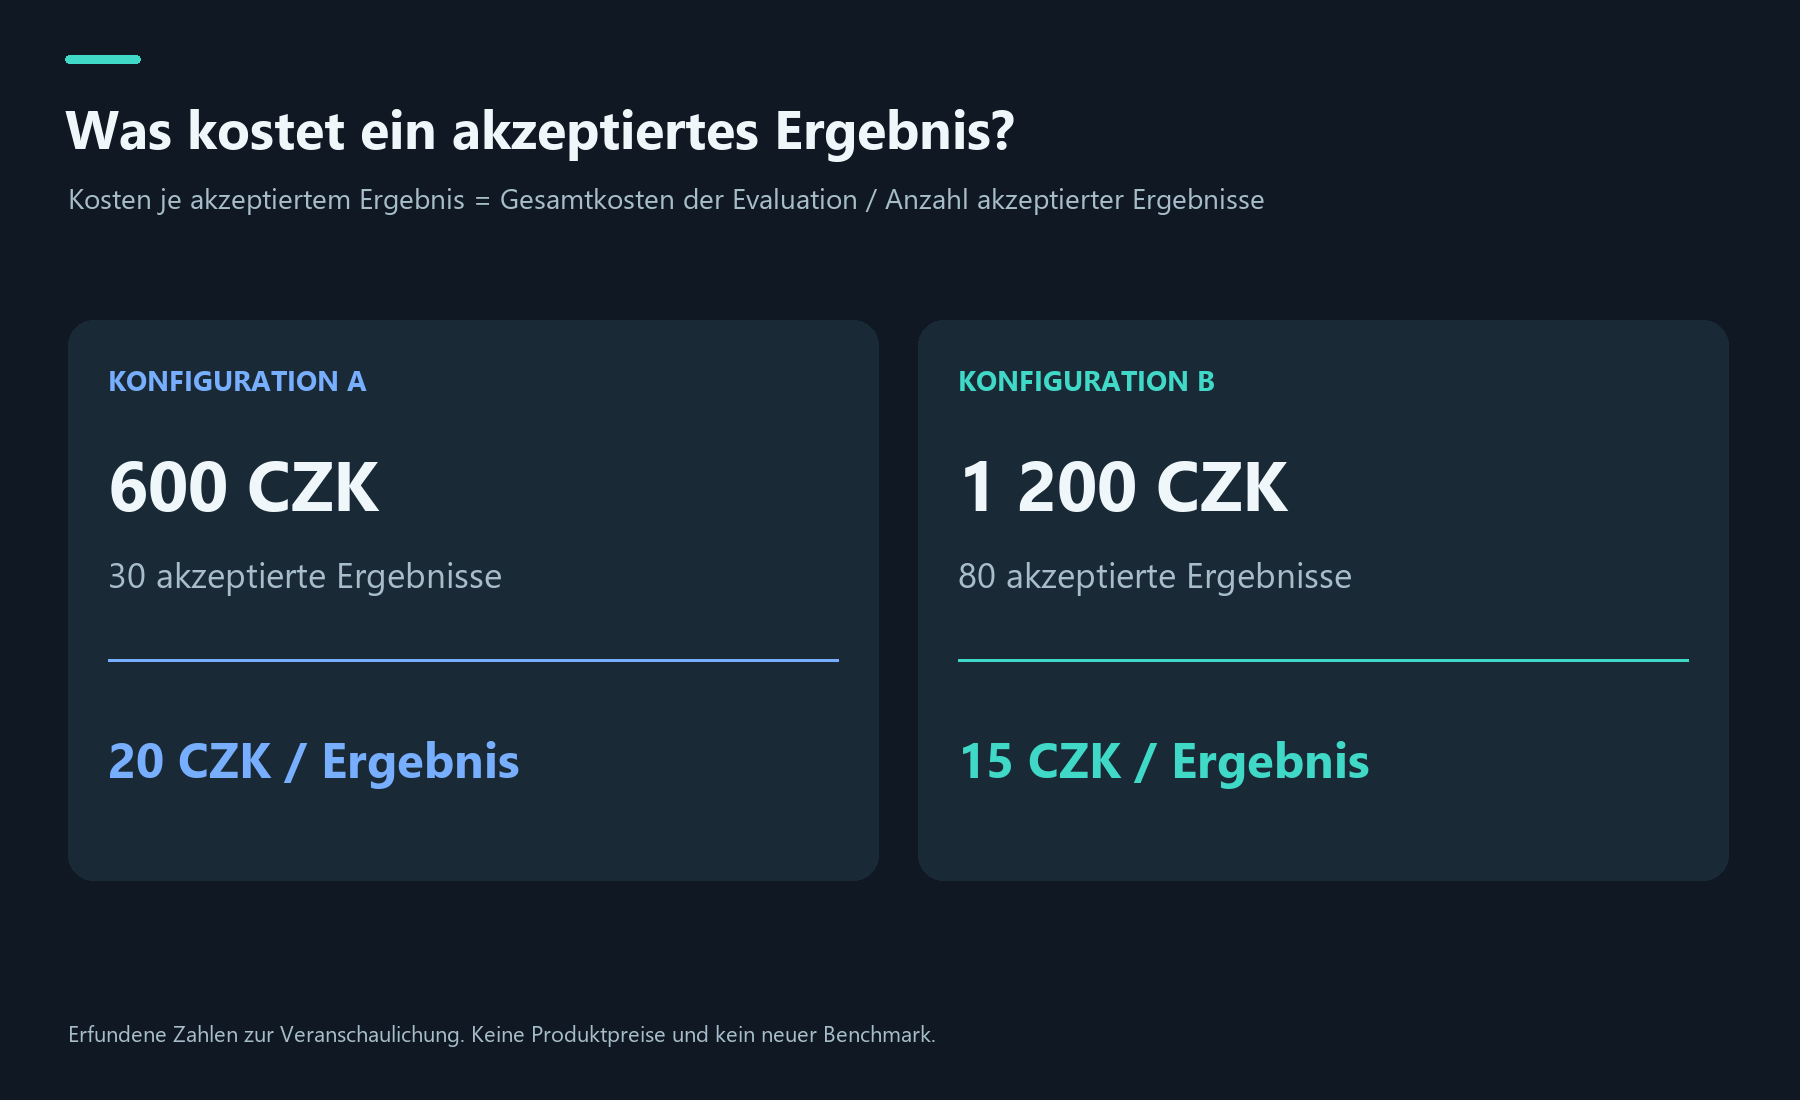
Eine rein illustrative Rechnung mit erfundenen Zahlen. Keine Produktpreise und kein weiterer gemessener Benchmark. Die Währung des ursprünglichen Beispiels, tschechische Kronen (CZK), bleibt erhalten.
Wenn ein Agent feststeckt, können wir ein stärkeres Modell kaufen. Manchmal hilft das. Manchmal fehlt jedoch die richtige Datei, das Ergebnis der letzten Aktion ist nicht angekommen, oder er weiß nicht, dass ein Kollege gerade die Lösung gefunden hat.
Auf unserer Insel war diese Information ein tschechischer Ratschlag im Chat. In einem Unternehmen kann es ein Test sein, eine sauber dokumentierte Entscheidung oder eine nachvollziehbare Quelle in einer Tabelle. Der Harness macht diese Information für die nächste Entscheidung verfügbar. Hier entsteht oft der Unterschied zwischen einem Agenten, der beeindruckend spricht, und einem, dessen Arbeit wir tatsächlich abnehmen können.
Links zu den Originalmethoden stehen bei den jeweiligen Aussagen und Tabellen. Die neun Bilder umfassen eine KI-Illustration, sieben eigene erklärende Diagramme oder Grafiken und einen Original-Screenshot des Experiments. Zahlen, Bildherkunft und Links finden sich auch im Bildquellenverzeichnis und im Übersetzungsnachweis. Ranglisten sind Momentaufnahmen, keine dauerhafte Reihenfolge der Produkte.