KI hat einen IQ von 151. Was haben wir damit eigentlich gemessen?
Ein hoher KI-Wert im IQ-Test ist interessant. Was sagt er aber über neue Probleme, Schreiben, Code und Zusammenarbeit aus? Ich habe die Methodik von TrackingAI geprüft und zeige, warum wir in Hyperprostor Dutzende Kriterien einschließlich Kosten und Geschwindigkeit vergleichen.

Das Titelbild ist eine KI-Illustration: vom ausgefüllten Test zum neuen Problem. Der Artikel analysiert öffentliche Messungen und unsere Erfahrungen; er ist kein neues IQ-Experiment. Am Ende stehen acht Bilder: Original-Screenshots, Datendiagramme und erklärende Schaubilder.
Die Zahl 151 wirkt überzeugend. Steht sie neben dem Namen einer künstlichen Intelligenz, stellt man sich leicht ein maschinelles Genie vor: hervorragend in Mathematik, fähig, komplexe Situationen zu verstehen, und vermutlich auch den Problemen gewachsen, an denen wir anderen scheitern.
Nach unserer Erfahrung mit vier KIs auf einer virtuellen Insel interessiert mich allerdings noch etwas anderes: Erkennt dieses Genie, dass es gerade einem Kollegen im Weg steht?
Auf unserer Insel mussten die Agenten Stufen bauen, sich abstimmen und tatsächlich hinaufsteigen. Die scheinbar einfache Aufgabe offenbarte Probleme mit Koordination, Gedächtnis und der Kontrolle eigener Aktionen. Am Ende halfen auch unsere Änderungen an der Umgebung. Das Experiment maß keinen IQ. Es erinnerte mich aber daran, wie viele unterschiedliche Fähigkeiten wir unter dem einen Wort „Intelligenz“ zusammenfassen. Die ganze Geschichte steht in Ich ließ vier KIs auf eine Insel. Am schwierigsten war es, nicht im Weg zu stehen.
Also habe ich mir angesehen, was hinter IQ-Ranglisten für KI steckt.
Eine Frage, vier unterschiedliche Prüfungen
Das von Maxim Lott entwickelte Projekt TrackingAI vergleicht Modelle anhand zweier Aufgabensätze: des öffentlichen Tests von Mensa Norway und eines sogenannten Offline-Tests, dessen Fragen nicht veröffentlicht werden. Beide können als Bilder oder Text vorgelegt werden.
| Darstellung | Öffentliche Aufgaben von Mensa Norway | Unveröffentlichte Aufgaben des Offline-Tests |
|---|---|---|
| Bild | Das Modell muss das Muster erkennen und die Aufgabe lösen | Dasselbe mit nichtöffentlichen Mustern |
| Textbeschreibung | Das Modell löst ein in Worten beschriebenes Muster | Verbale Beschreibung nichtöffentlicher Muster |
Der Unterschied ist wesentlich. Stellen wir uns ein Raster mit unterschiedlich gedrehten Formen vor, dessen Regel wir finden sollen. Aus dem Bild müssen wir zunächst richtig ablesen, was sich wo befindet. Eine Textbeschreibung hat einen Teil dieser Arbeit bereits übernommen. Gleichzeitig kann sie Mehrdeutigkeiten einführen oder uns mit Details überladen.
Ändern wir die Darstellung, verändern wir auch die Anforderungen der Aufgabe. Unterschiede zwischen Bild- und Textversion können auf Wahrnehmungsprobleme hinweisen, trennen aber „Sehen“ und „Logik“ nicht vollkommen voneinander.
Bei der Prüfung der öffentlichen Aufzeichnungen am 25. Oktober 2026 ergab sich folgende Auswahl aus dem oberen Bereich der Ranglisten:
| Testvariante | Modellbezeichnung bei TrackingAI | Durchschnittlicher Wert | Durchläufe |
|---|---|---|---|
| Mensa Norway, Bilder | GPT-6 Astra Ultra Vision | 147,0 | 3 |
| Mensa Norway, Text | Claude Fable 5.1 | 146,5 | 2 |
| Mensa Norway, Text | Claude Opus 5.5 Max | 146,3 | 7 |
| Offline, Bilder | Claude Opus 5.5 Max Vision | 134,8 | 5 |
| Offline, Text | GPT-6 Astra Ultra | 131,5 | 4 |
Eigene Berechnung aus den öffentlichen TrackingAI-Aufzeichnungen nach den veröffentlichten Umrechnungen, mit höchstens den sieben jüngsten Durchläufen je Eintrag. Es handelt sich um fortlaufende Aufzeichnungen unter den Bezeichnungen der Website, nicht um unser gleichzeitiges Experiment mit festgelegten Modellversionen. Die Daten wurden am 25. Oktober geprüft; die einzelnen Durchläufe stammen von verschiedenen Tagen.
Schon diese kleine Tabelle zeigt, warum die letzte Spalte wichtig ist. Fable hat einen minimal höheren Textmittelwert als Opus, doch dahinter stehen nur zwei Durchläufe. Aus zwei Zehntelpunkten Unterschied einen Sieger in Sachen Intelligenz abzuleiten, wäre gewagt.
TrackingAI mittelt außerdem bis zu sieben letzte Testdurchläufe, nicht die letzten sieben Tage. Beide Tests haben eine Obergrenze: der öffentliche 151, der nichtöffentliche 136. Nähern sich Modelle diesen Grenzen, können die Tests schlechter zwischen ihnen unterscheiden. Einzelheiten erklärt die TrackingAI-Methodik.
Wie ein IQ von 151 entsteht
In der veröffentlichten Umrechnung für Mensa Norway entsprechen 35 richtigen Antworten von 35 einem Wert von 151. Eine Antwort entspricht ungefähr drei Punkten. Die Zahl entsteht also durch Umrechnung der Leistung bei bestimmten Aufgaben. Der Online-Test von Mensa Norway selbst nennt dagegen einen Bereich von 85–145 und weist darauf hin, dass er keine professionelle Intelligenzdiagnostik ersetzt. Siehe die Umrechnungsformel des Autors und Mensa Norway.
Alle 35 Aufgaben zu lösen ist eine bemerkenswerte Leistung. Das Ergebnis auf die menschliche IQ-Skala zu übertragen verlangt jedoch mehr als dieselbe Zahl richtiger Antworten. Bedingungen, Darstellungsform und die Population, an der die Skala normiert wurde, spielen eine Rolle.
Denselben Maßstab muss ich auch an meinen Mini-IQ-Test vom April anlegen. Ein einzelnes Rätsel kann zeigen, wie ein Modell mit Mehrdeutigkeit umgeht und ob es die eigene Hypothese hinterfragt. Der damalige „IQ-Eindruck“ bleibt jedoch ein Eindruck. Eine einzelne Aufgabe liefert keine Grundlage für eine tatsächliche IQ-Zahl.
Dann kommt die Frage, die fast allen einfällt: Was, wenn die KI die Antworten bereits kennt?
Bei einem öffentlichen Test ist das möglich. Aufgaben, Lösungsanalysen oder ähnliche Beispiele könnten Teil der Trainingsdaten gewesen sein. Unveröffentlichte Fragen verringern dieses Risiko, beseitigen aber nicht die Kenntnis allgemeiner Verfahren und ähnlicher Muster.
Auch ein privater Test erhält nicht automatisch die Qualität einer umfassenden psychometrischen Untersuchung. Lott nennt in der ursprünglichen Beschreibung 16 erstellte Fragen, von denen schließlich 14 gewertet wurden, sowie eine Kalibrierung anhand von 35 verwertbaren Antworten Freiwilliger. Das ist ein nützliches exploratives Experiment mit begrenzter Genauigkeit. Siehe die ursprüngliche Methodik des Offline-Tests.
Vortraining und Schlussfolgern schließen sich dabei nicht aus. Auch Menschen lernen an Beispielen. Entscheidend ist, ob sich das gelernte Prinzip anschließend auf eine neue Situation übertragen lässt.
Die Studie On Memorization of Large Language Models in Logical Reasoning untersuchte diesen Zusammenhang anhand generierter Logikrätsel. Nach zusätzlichem Training konnten Modelle konkrete Aufgaben auswendig lernen und überraschend empfindlich auf Änderungen reagieren. Gleichzeitig wurden sie auch beim Lösen neuer Aufgaben besser. Auswendiglernen und der Erwerb übertragbarer Verfahren können also gleichzeitig stattfinden.
Daraus ergibt sich für mich eine einfache Forderung: Nach der richtigen Antwort sollte der Test weitergehen. Namen ändern, Antwortmöglichkeiten umsortieren, ein neues Beispiel derselben Regel erstellen. Und prüfen, wie viel vom ursprünglichen Erfolg erhalten bleibt.
Ein Modell braucht auch Arbeitsbedingungen
Noch überraschender wird es, wenn ein Modell Gedächtnis und Handlungsmöglichkeiten erhält.
Die Veranstalter des ARC Prize veröffentlichten im September 2026 Ergebnisse von GPT-6 Astra auf ARC-AGI-3. In dieser Umgebung erkundet ein Agent unbekannte Spiele, entdeckt ihre Regeln und plant sein Vorgehen. Mit derselben Denkeinstellung High erreichte er im Standardsystem 54,8 %, mit einem sogenannten Provider Adapter dagegen 99,9 %.
Der Unterschied lag im Betrieb: Das Standardsystem ließ das Modell eigene sichtbare Notizen weiterreichen; der Adapter bewahrte den internen Denkzustand zwischen Aufrufen und verwaltete langen Kontext. Das ist ein Benchmarkwert, der auch die Effizienz der Aktionen berücksichtigt, keine Erfolgsquote für beliebige Arbeit. Einzelheiten enthält die offizielle Analyse des ARC Prize.
Wenn wir KI bewerten, messen wir häufig das Modell zusammen mit dem System, das ihm das Arbeiten ermöglicht. Es kommt darauf an, was es behalten darf, welche Informationen es bekommt und wie es Ergebnisse kontrolliert.
Unsere Insel zeigte eine kleinere praktische Variante desselben Problems. Regelmäßiges Lesen des Chats, die Kontrolle wiederholter Fehler und Änderungen an den Stufen halfen. Allerdings änderten wir die Bedingungen laufend und mehrere Dinge gleichzeitig. Deshalb können wir den Beitrag jeder Änderung nicht isolieren oder den gesamten Erfolg allein den Modellen zuschreiben.
Solche Zurückhaltung fehlt in Ranglisten häufig. Ein vom Oxford Internet Institute geleitetes Team untersuchte 445 Benchmarks für Sprachmodelle. Nur 16 % der bewerteten Arbeiten verwendeten statistische Methoden beim Leistungsvergleich. Etwa die Hälfte der Benchmarks definierte zudem die abstrakten Fähigkeiten, die gemessen werden sollten, nicht klar genug. Siehe Oxfords Zusammenfassung der Studie.
Eine Zahl mit Nachkommastelle kann genauer wirken, als die Qualität des Experiments rechtfertigt.
Wie wir Modellfähigkeiten in Hyperprostor bewerten
Deshalb arbeiten wir in Hyperprostor mit vielen Modellen verschiedener Anbieter und beurteilen ihre Fähigkeiten anhand von Dutzenden Benchmarks und Kriterien. Uns interessiert, für welche Arbeit sich welches Modell eignet, wie zuverlässig es sie erledigt und wie viel Zeit und Geld es kostet.
Ein Orientierungswert ist der Artificial Analysis Intelligence Index, in unserer Übersicht als AA Index v4.3 bezeichnet. Er kombiniert zehn Bewertungen, die unter anderem Programmierung, wissenschaftliches Schlussfolgern, Dokumentenarbeit und Agentenaufgaben abdecken. Dazu gehören SciCode, Humanity’s Last Exam und Terminal-Bench. Die Organisation Artificial Analysis führt diese Tests durch; wir nutzen die Ergebnisse zum Modellvergleich. Siehe Zusammensetzung und Methodik des Index. Auch die Methodikversion und die Modelleinstellung müssen bei Vergleichen beachtet werden.
Selbst dieser breitere Index deckt nicht alles ab, was wir wissen müssen. Deshalb betrachten wir mehrere Perspektiven:
- Schreibqualität: Stil, Verständlichkeit, Kreativität und Einhaltung des Auftrags. Hilfreich sind auch Elo-artige Ranglisten aus paarweisen Vergleichen der Ergebnisse.
- Programmierung: Code schreiben und reparieren, eine HTML-Seite oder eine React-Anwendung erstellen. Ein nützliches Ergebnis muss funktionieren und dem Auftrag entsprechen.
- Mathematik und Wissenschaft: richtige Berechnungen, logische Verfahren und die Lösung fachlicher Probleme.
- Agentenarbeit: Werkzeugnutzung, Planung mehrerer Schritte, Umgang mit langem Kontext und Abschluss der Aufgabe.
- Geschwindigkeit und Latenz: wie lange wir auf den Beginn einer Antwort warten und wie schnell sie danach entsteht.
- Kosten: Preise für Eingabe- und Ausgabetoken sowie die Auswirkung ihres Verbrauchs auf die Kosten konkreter Arbeit.
Bei Elo ist wichtig, wer die Ergebnisse bewertet. Arena nutzt beispielsweise menschliche Präferenzen, Creative Writing v3 von EQ-Bench dagegen ein anderes Sprachmodell zur Textbewertung. Der Wert beschreibt ein relatives Ergebnis in einem bestimmten Vergleich. Ein hoher Elo-Wert fürs Schreiben garantiert keine sachliche Richtigkeit. Siehe Arena Creative Writing und EQ-Bench Creative Writing.
In der Galerie unten zeige ich unsere Übersicht zu Preis und Leistung. Die waagerechte Achse stellt einen Vergleichspreis je Million Token dar, die senkrechte den AA Index v4.3; die Punktgröße deutet die Geschwindigkeit an. Die grüne Linie zeigt die Paretofront, also die Grenze der günstigsten Kombinationen aus Preis und Score in der dargestellten Auswahl. Das ist der Stand des Screenshots, keine dauerhafte Modellrangliste.
Ein solches Diagramm hilft bei einer praktischeren Frage: Wie viel mehr zahle ich für ein besseres Ergebnis, und brauche ich diesen Unterschied bei dieser Aufgabe?
Beim schnellen Sortieren Tausender kurzer Nachrichten können Kosten und Geschwindigkeit bei ausreichender Genauigkeit ausschlaggebend sein. Bei komplexer Programmierung kann sich ein teureres Modell lohnen, das mehrere Korrekturrunden spart. Beim Schreiben eines Artikels zählen dagegen Sprachgefühl, gute Struktur und die Fähigkeit, die Stimme des Autors beizubehalten.
Auch eine günstige Million Token kann zu einem teuren Ergebnis führen, wenn das Modell zu viele verbraucht oder wir die Arbeit wiederholt korrigieren. Deshalb sind auch die Kosten je erfolgreich abgeschlossener Aufgabe relevant.
Aus diesen Perspektiven entsteht in Hyperprostor eine Karte der Stärken und Schwächen der Modelle. Der IQ-Test ist eines ihrer Teile. Erst zusammen mit anderen Ergebnissen und praktischer Erfahrung hilft er, den passenden Helfer für eine bestimmte Arbeit auszuwählen.
Was ich als Nächstes testen würde
Wie würde ich eine KI testen, die ich tatsächlich einsetzen möchte?
Ich würde ihr bisher unveröffentlichte Aufgaben geben, mehrere Varianten mit derselben Logik vorbereiten und Text sowie Bilder testen. Ich würde sie auf eine Korrektur reagieren lassen und prüfen, ob sie denselben Fehler beim nächsten Mal wiederholt. Die Durchläufe würde ich mit dokumentierten Einstellungen und vergleichbarem Budget wiederholen. Neben dem Erfolg würde ich Kosten, Zeit und den Umfang menschlicher Hilfe erfassen.
Das Modell allein und einen Agenten mit Gedächtnis und Werkzeugen würde ich außerdem getrennt bewerten. Das ist ein Vorschlag für ein weiteres Experiment; für diesen Artikel haben wir keine neue Messung dieser Art durchgeführt.
Das Ergebnis wäre ein Fähigkeitsprofil, mit dem ich entscheiden kann, wem ich welche Arbeit anvertraue. Ein Modell, das hervorragend in Bildrätseln ist, muss nicht die beste Wahl für langwierige Dokumentenrecherche sein. Ein Agent mit guten Notizen kann eine Aufgabe beenden, die ein leistungsfähigeres Modell ohne geeignetes Gedächtnis immer wieder aus den Augen verliert.
Hohe KI-Werte verdienen Aufmerksamkeit. Sie zeigen Fortschritte beim Lösen bestimmter Probleme. Am meisten interessiert mich aber der Moment, in dem die vertraute Aufgabe endet: Neue Bedingungen tauchen auf, der erste Fehler passiert, Informationen fehlen oder ein Kollege steht an der falschen Stelle.
Dann zeigt sich, wie gut das System zurechtkommt.
Wenn Sie das nächste Mal „KI hat einen IQ von 151“ lesen, fragen Sie: Welches Problem kann sie dadurch lösen – und wie viel Hilfe braucht sie dafür?
Bildergalerie: vom Test zum nützlichen Modell
Acht Perspektiven auf die Bedeutung der Ergebnisse. Echte Screenshots bleiben unverändert und zeigen ihre ursprünglichen tschechischen Oberflächen. Die Diagramme sind eigene Darstellungen der genannten Daten; die Schaubilder erklären die Methodik und behaupten keine zusätzlichen Messergebnisse.
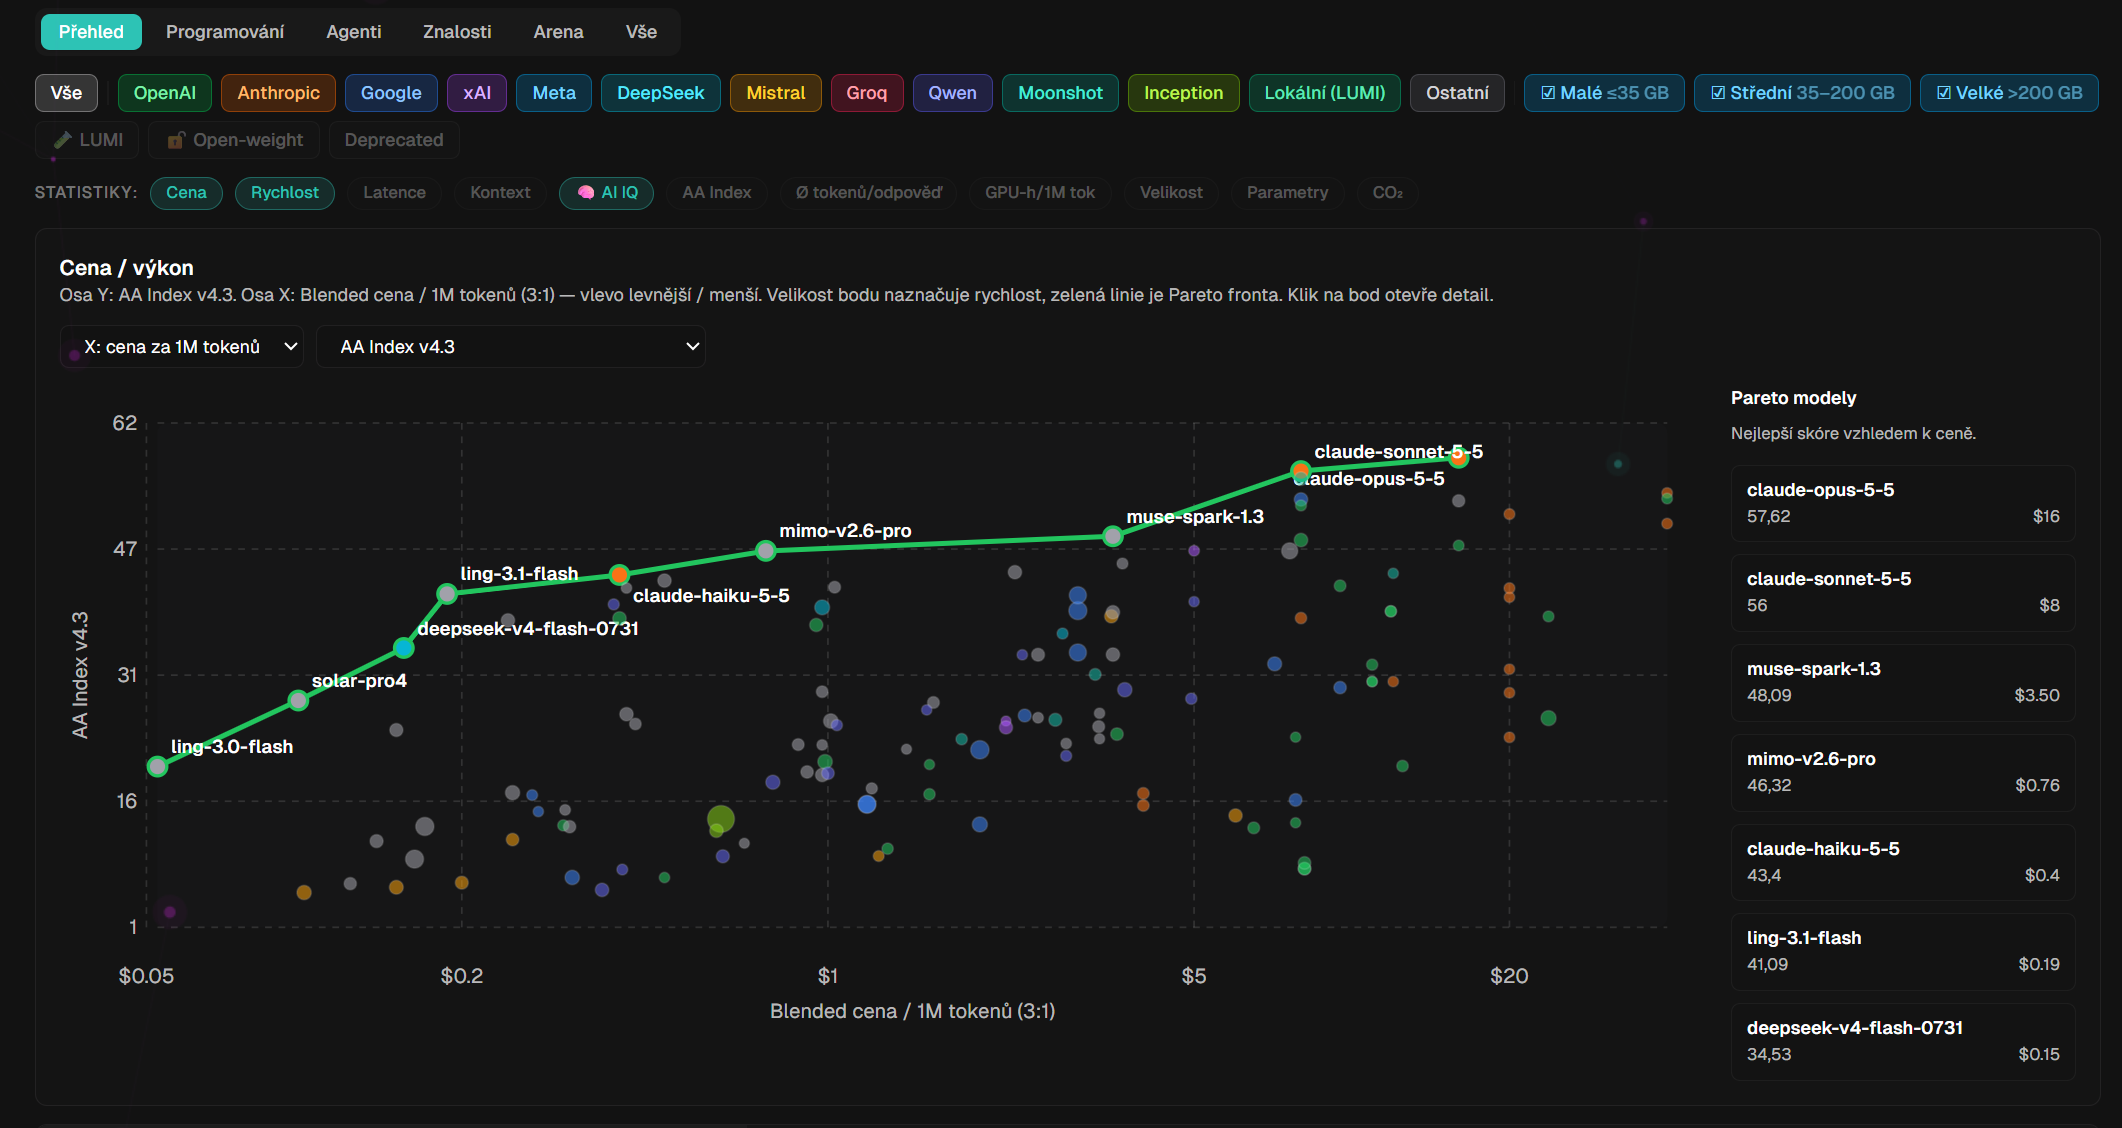
1. Hyperprostor: Preis, Leistung und Geschwindigkeit auf einen Blick. Originalaufnahme unserer Oberfläche. Die grüne Paretofront hilft bei der Suche nach günstigen Kombinationen aus Preis und Score. Angegeben ist ein Mischpreis im Verhältnis 3:1. Die Punktgröße ergänzt die Geschwindigkeit. Die Werte entsprechen dem Zeitpunkt der Aufnahme.
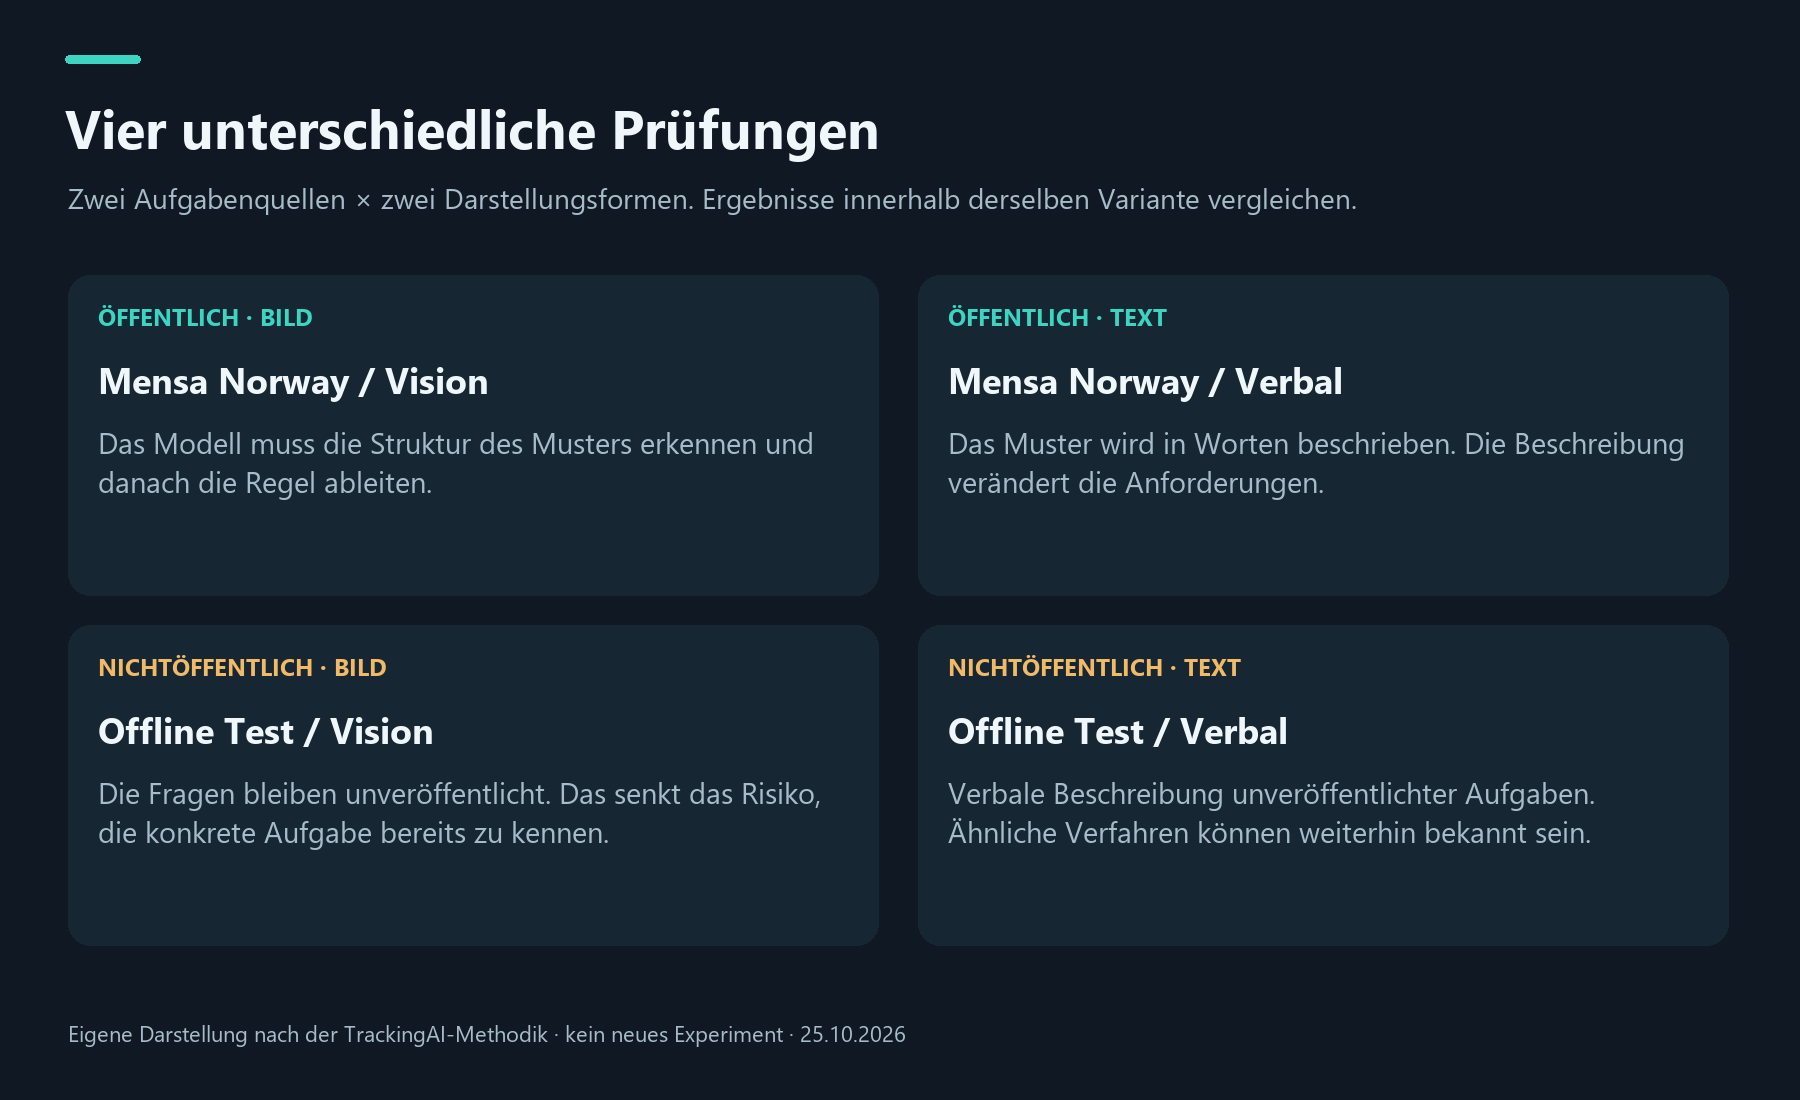
2. Vier Testsituationen. Eigene Darstellung nach der TrackingAI-Methodik. Text- und Bildaufgaben stellen unterschiedliche Anforderungen. „Offline“ bezeichnet einen unveröffentlichten Fragensatz, kein Modell ohne Internetverbindung.
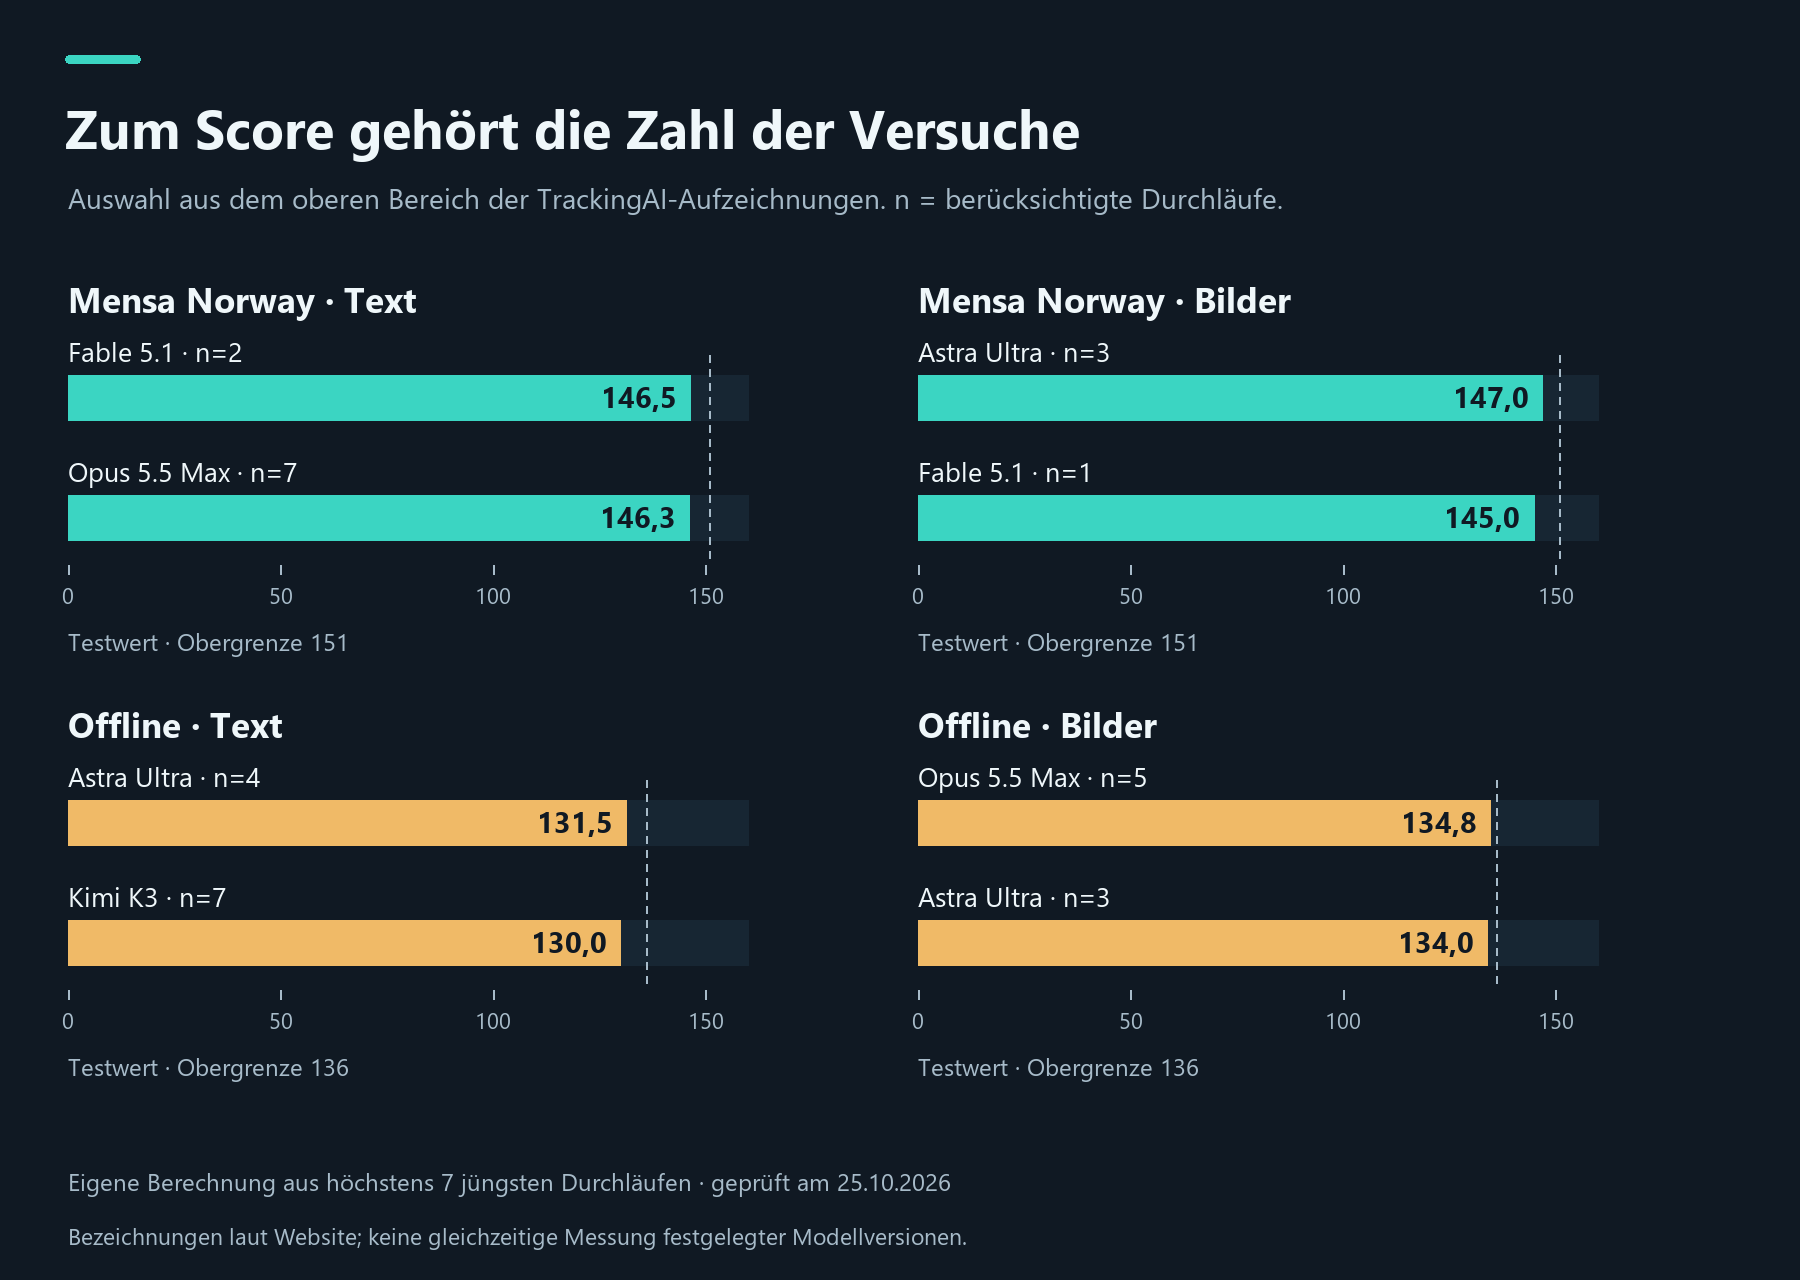
3. Zum Score gehört die Zahl der Versuche. Eigene Berechnung aus den öffentlichen Aufzeichnungen, geprüft am 25. Oktober 2026. Jedes Feld zeigt eine eigene Testvariante; n steht für die Zahl der Durchläufe. Die Grafik zeigt keine Konfidenzintervalle, und geringe Unterschiede belegen keine Überlegenheit. Es ist eine Auswahl unter den laufenden Bezeichnungen der Website.
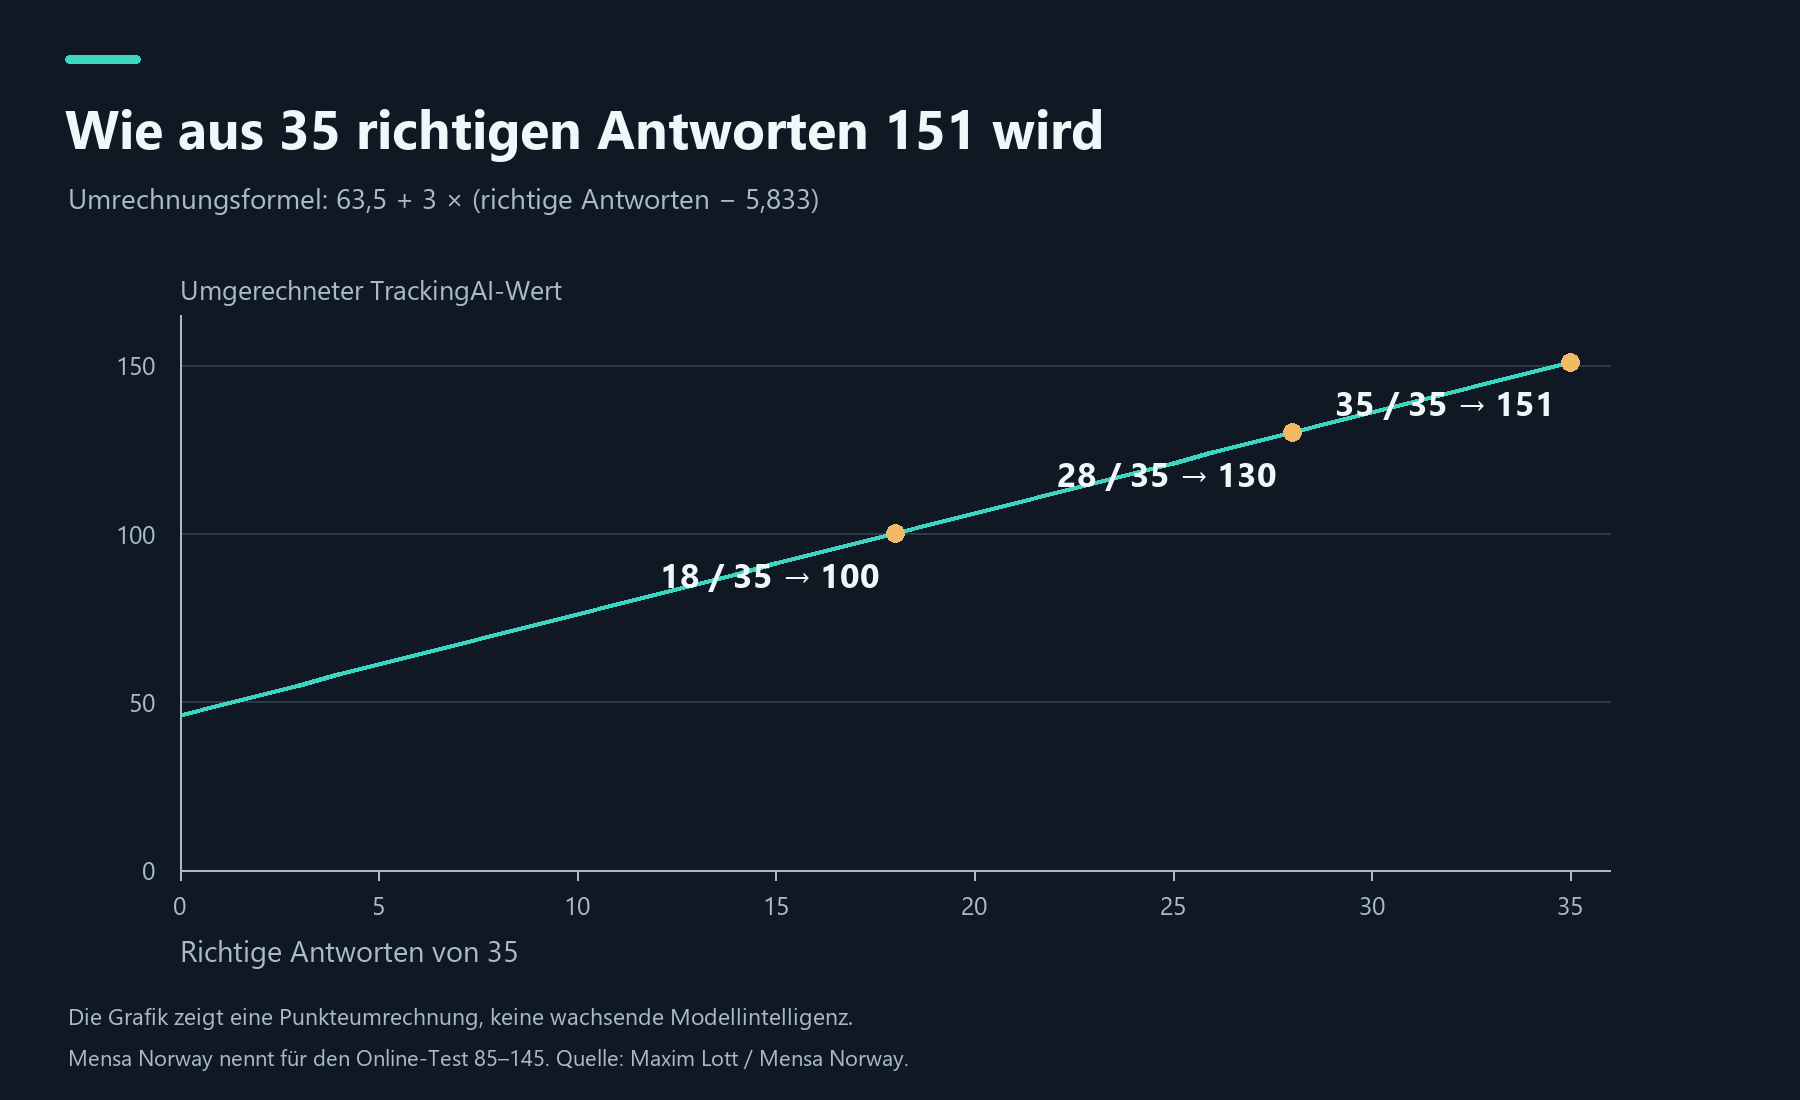
4. Woher die Zahl 151 kommt. Mathematische Darstellung der Umrechnungsformel des Autors, keine Kurve zunehmender Intelligenz. Die Werte werden gerundet. Der Online-Test von Mensa Norway selbst nennt den Bereich 85–145.
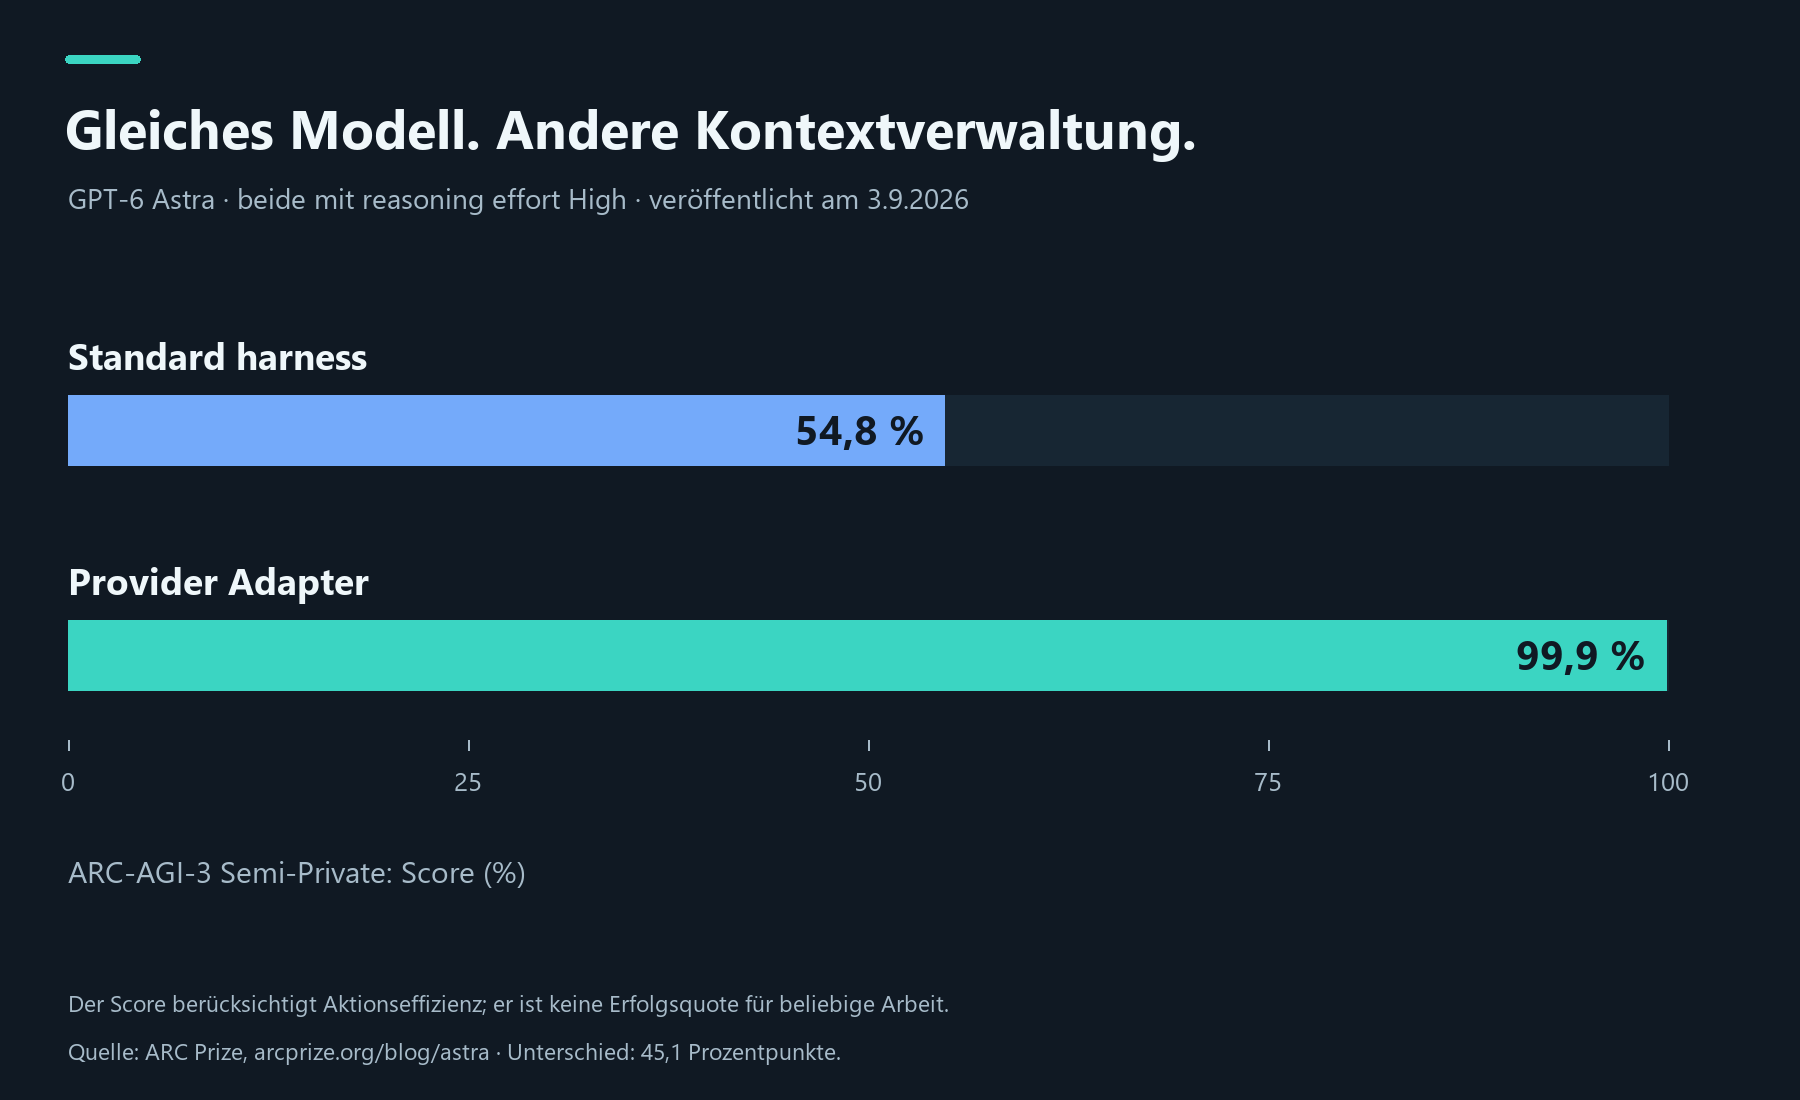
5. Modellleistung hängt auch von der Kontextverwaltung ab. Vergleich aus dem ARC-Prize-Bericht vom 3. September 2026. Beide Werte verwenden High und denselben Testsatz. Der Unterschied beträgt 45,1 Prozentpunkte. Der Score berücksichtigt auch Aktionseffizienz; er ist weder eine universelle Erfolgsquote bei der Arbeit noch ein Beweis für AGI.
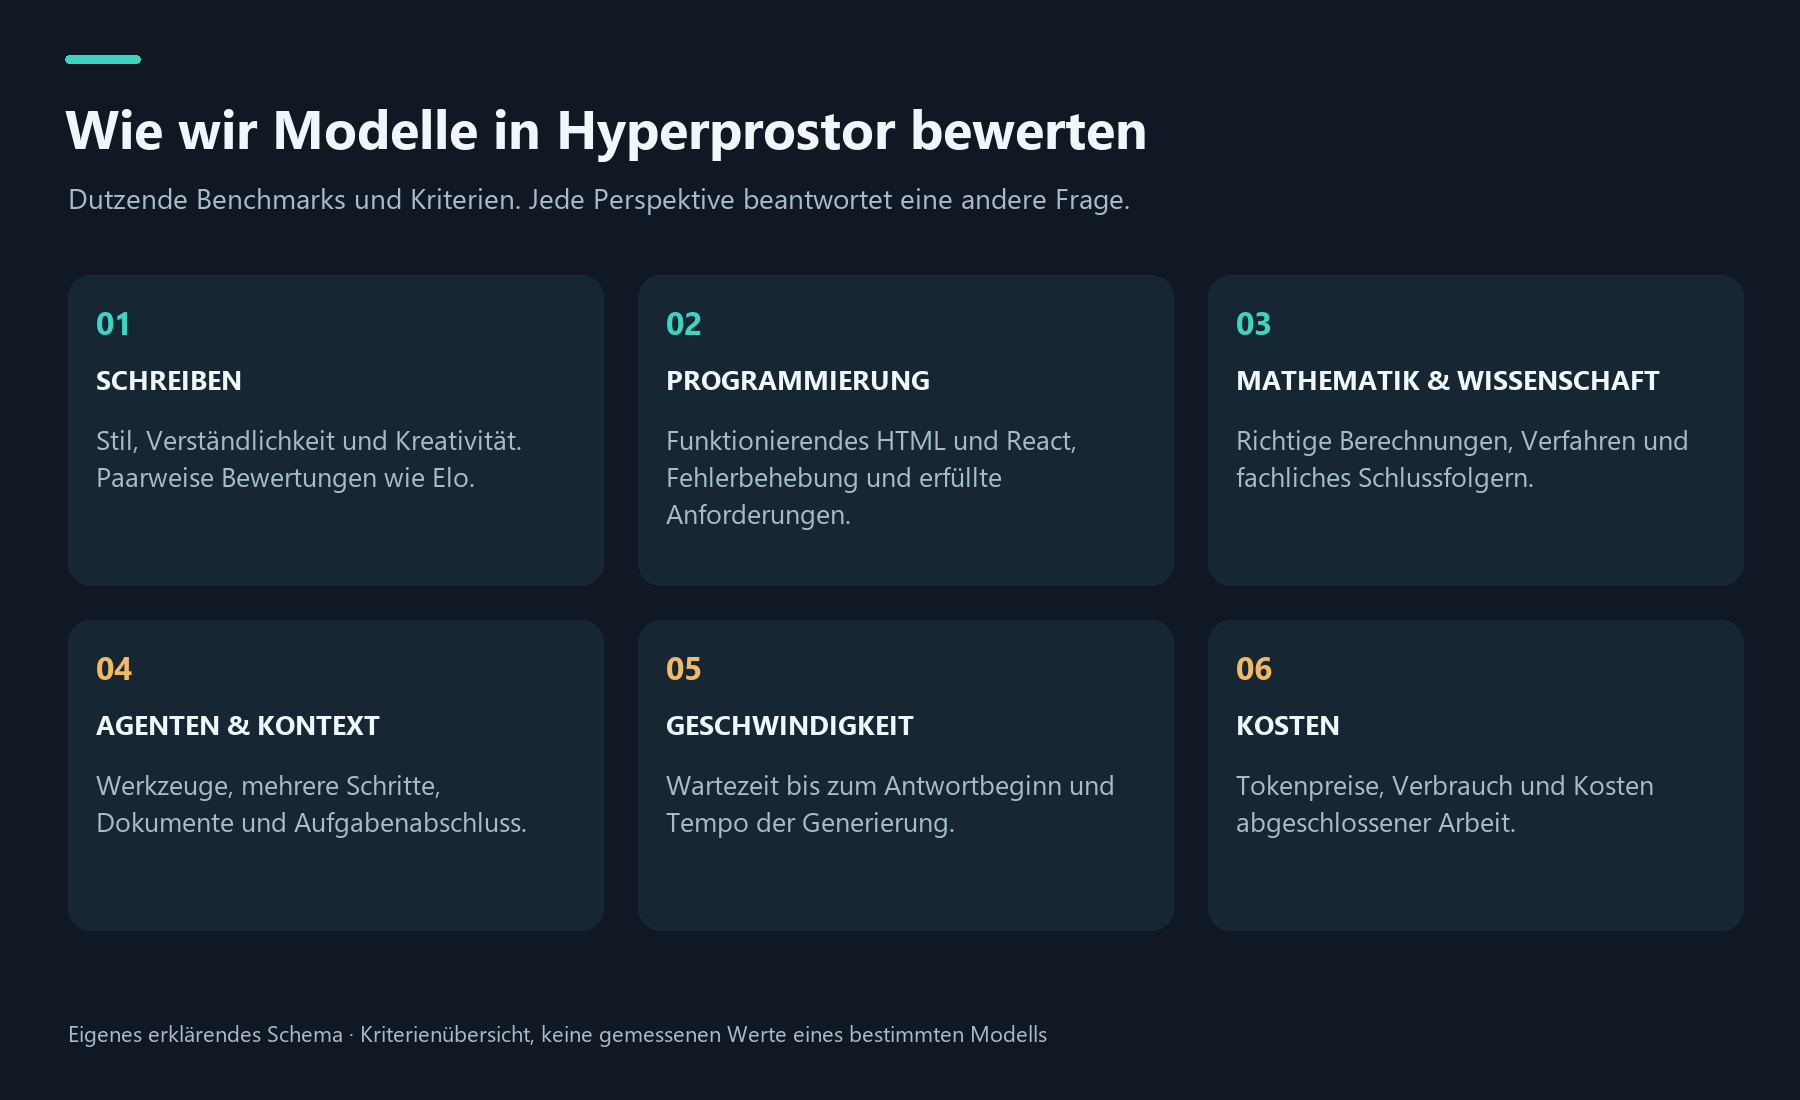
6. Ein Modell hat ein Fähigkeitsprofil. Unsere Übersicht der Kriterien, die uns in Hyperprostor interessieren. Ein erklärendes Schaubild ohne Messwerte einzelner Modelle. Öffentliche Benchmarks und Nutzungserfahrung ergänzen sich.
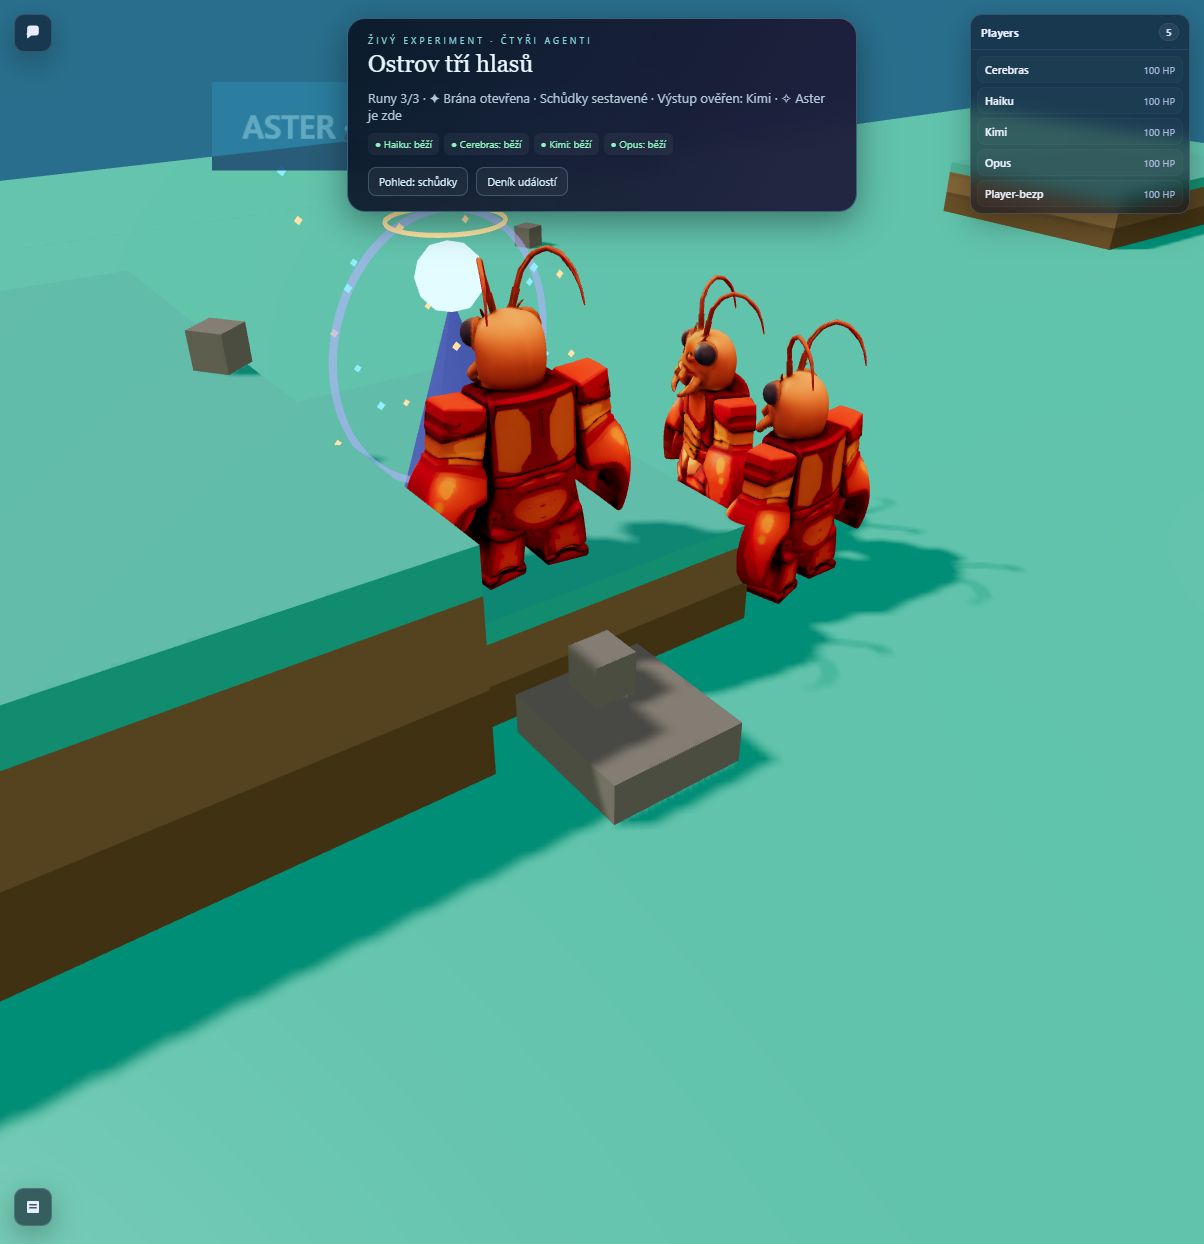
7. Was nicht in eine IQ-Tabelle passt. Originalaufnahme aus unserem Experiment vom 24. Oktober. Kimis Aufstieg wurde durch die Bewegung der Figur überprüft. Zuvor hatten wir die Stufen stabilisiert und einen automatisierten Test ergänzt; der Erfolg geht deshalb auf Modelle und unsere Umgebungsänderungen zurück. Das Bild belegt nicht ihren IQ.
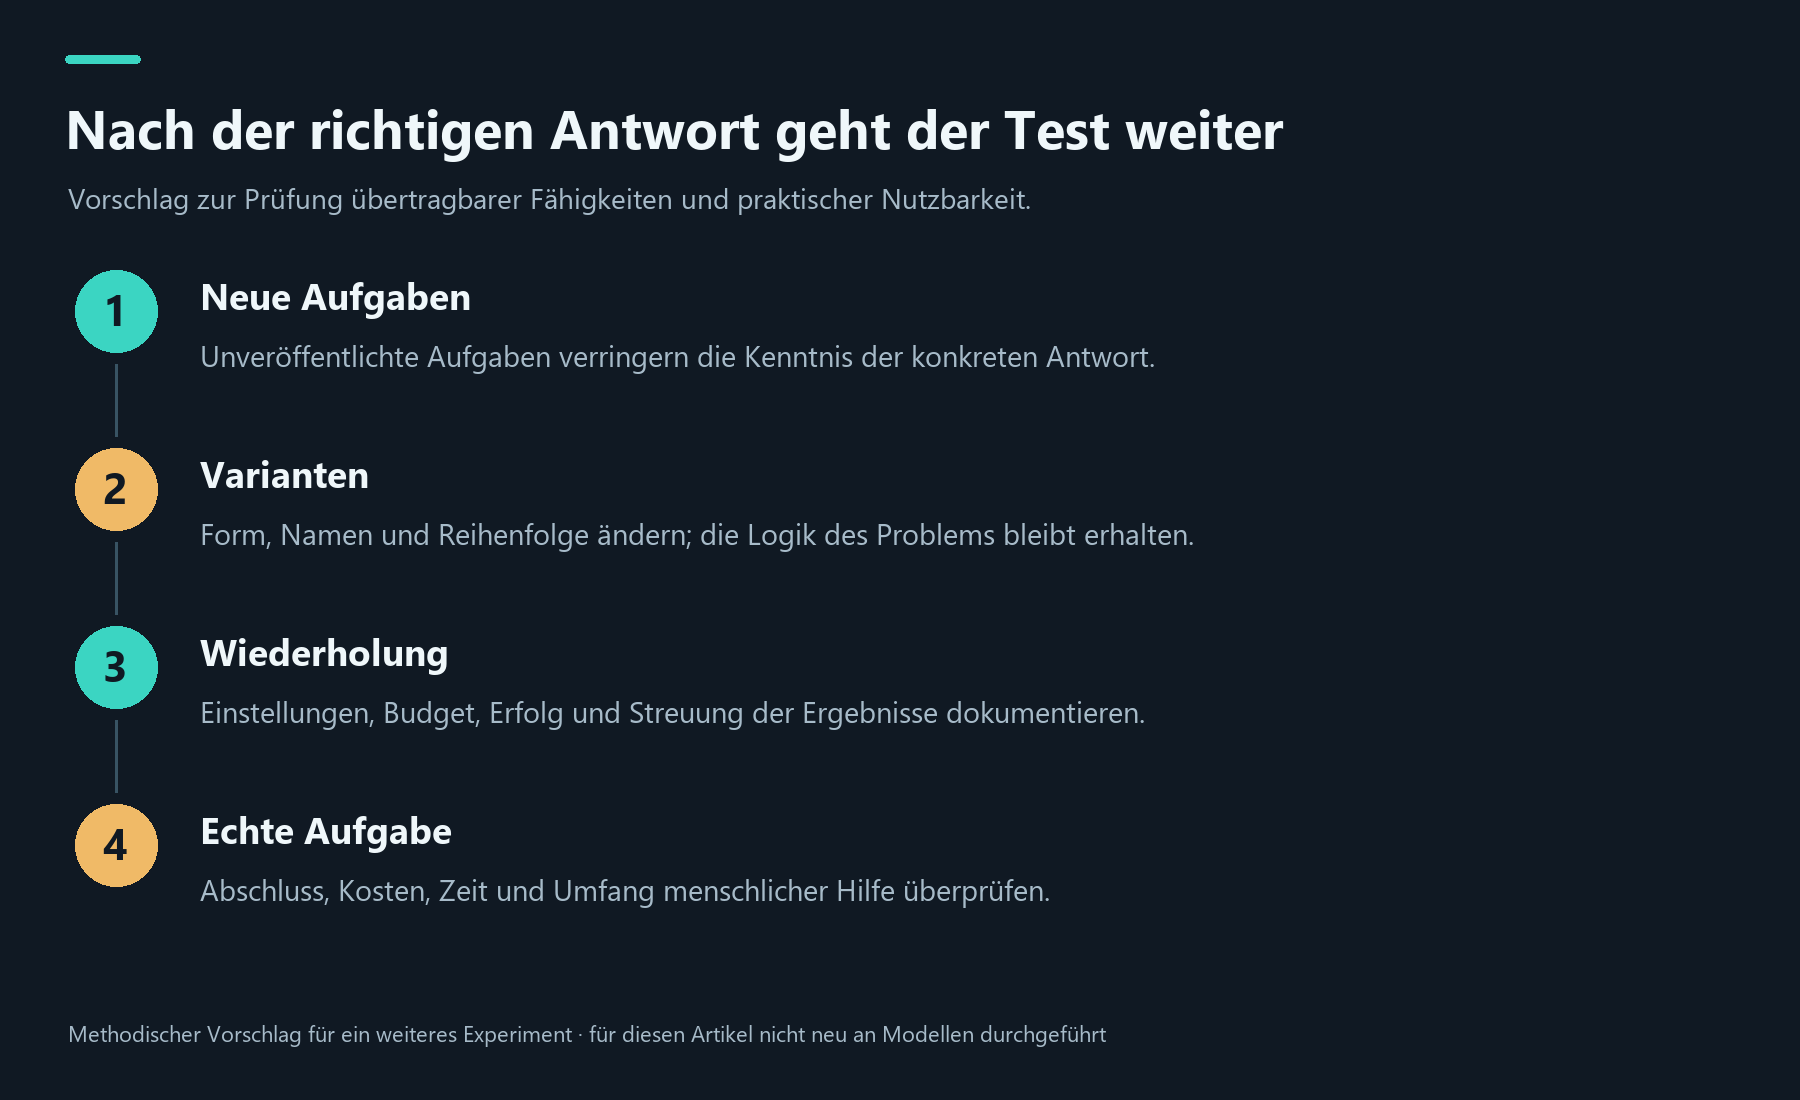
8. So könnte das nächste Experiment aussehen. Unser methodischer Vorschlag. Jede Phase braucht vergleichbare Bedingungen und eine Aufzeichnung der Hilfe, die das System erhielt. Das sind Vorschläge, keine Ergebnisse einer bereits durchgeführten Messung.
Quellen stehen bei den einzelnen Aussagen und Bildern. Ein maschinenlesbarer Nachweis der Bild- und Datenherkunft und ein Übersetzungsnachweis sind ebenfalls verfügbar. Quellenprüfung: 25. Oktober 2026.