Tri mesiace na LUMI: správnu odpoveď AI často má. Len ju nevie vybrať.
Tri mesiace a 4 703 GPU hodín na fínskom superpočítači. Kedy pomôže spolupráca modelov, čo prinieslo dotrénovanie ThinkingCapu a prečo býva ťažšie správnu odpoveď vybrať než vygenerovať. Výsledky, grafy aj datasety na vlastné overenie.

Môj projekt Fusion Playground na fínskom superpočítači LUMI sa blíži ku koncu. Za tri mesiace som použil 4 703 z pridelených 5 000 GPU hodín, vykonal som viac ako dvadsať experimentov a zhromaždil som viac ako 305 000 ohodnotených odpovedí. Takmer celý výskum a vývoj si robím sám, s podporou českého tímu LUMI AI Factory v IT4Innovations.
Prišiel som v júli s jednoduchou otázkou: Kedy viaceré modely AI spolupracujú lepšie ako jeden silný model? A koľko to stojí?
Najzaujímavejšie zistenie sa ukázalo byť o niečom inom ako o veľkosti modelu. V zložitých vedeckých otázkach bol aspoň jeden z Gemminých ôsmich pokusov správny v 95,5 % prípadov. Pri hlasovaní sa však správna odpoveď vybrala iba v 86 % prípadov. Riešenie tu často už bolo. Len sa stratilo na ceste k používateľovi.
Čo si odnášam z LUMI
- Vygenerovanie ďalších odpovedí nestačí. V tomto experimente bol najväčšou nevyužitou príležitosťou výber tej správnej.
- Schopný model so stručným uvažovaním je ťažké prekonať. Gemma-4-31B dosiahla skóre 91,3 % v hlavnom porovnaní kvality a 91,4 % na novej sade. Panely a routery, ktoré som testoval, ho v priemere neprekonali.
- Spolupráca má zmysel tam, kde na to máme dobrý dôvod. Testy pomohli pri programovaní, opakované pokusy pomohli pri niektorých matematických úlohách. Z toho však nevznikol univerzálny recept.
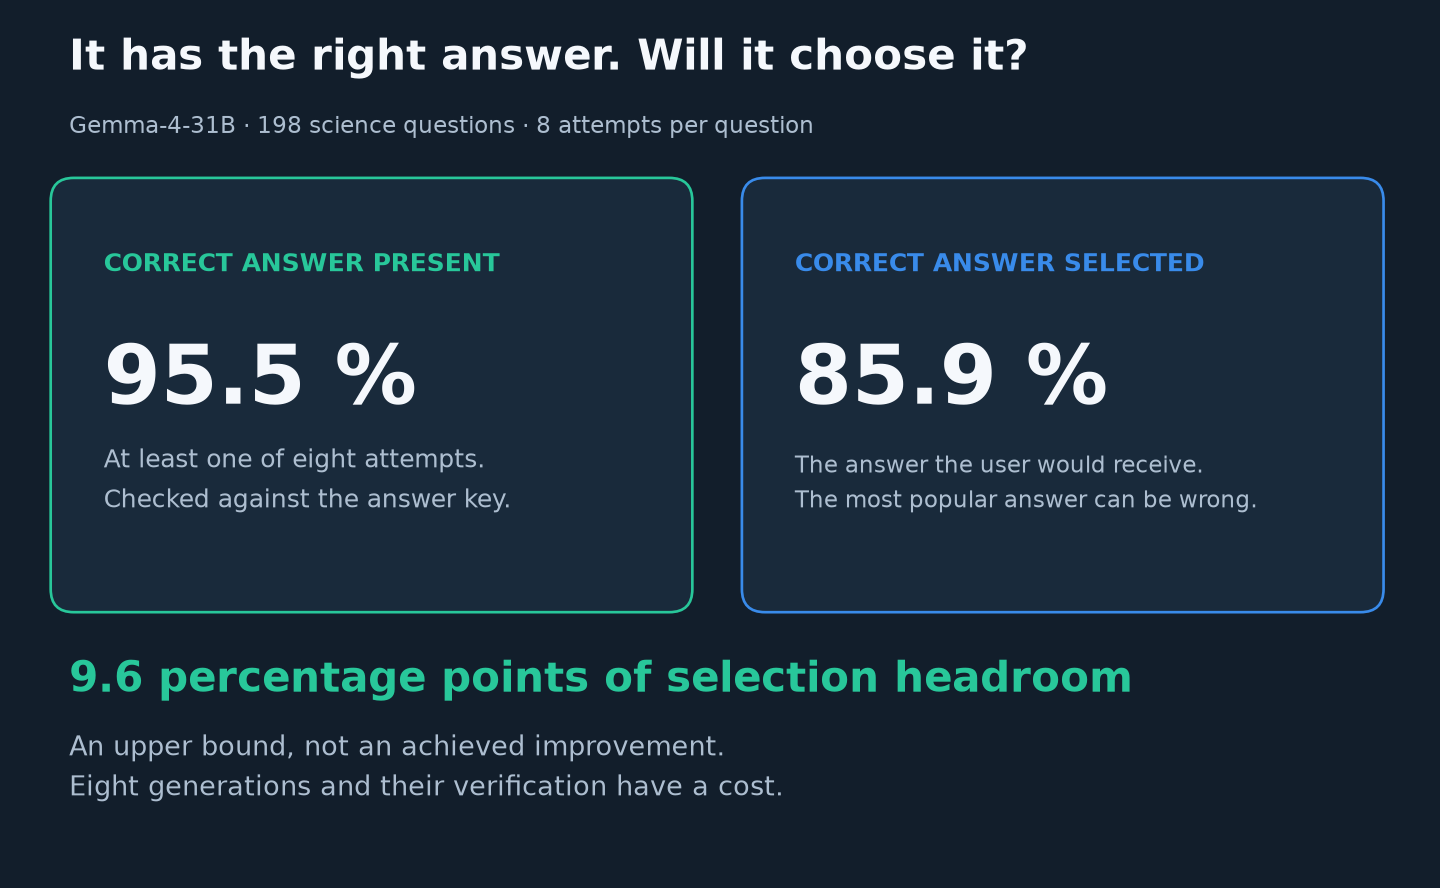
Rovnakých osem pokusov na otázku s použitím Gemma-4-31B na 198 otázok GPQA. Ľavé číslo zistíme až porovnaním so známymi správnymi odpoveďami. Nie je to presnosť systému, ktorý dnes dokážem nasadiť.
Osem odpovedí od AI. Ktorej z nich veriť?
Predstavte si stretnutie, na ktorom niekto povie správne riešenie, no väčšina sa prikláňa k inému. Presne toto sa stalo pri mojich pokusoch. Viac vygenerovaných odpovedí neznamená lepšie rozhodnutia.
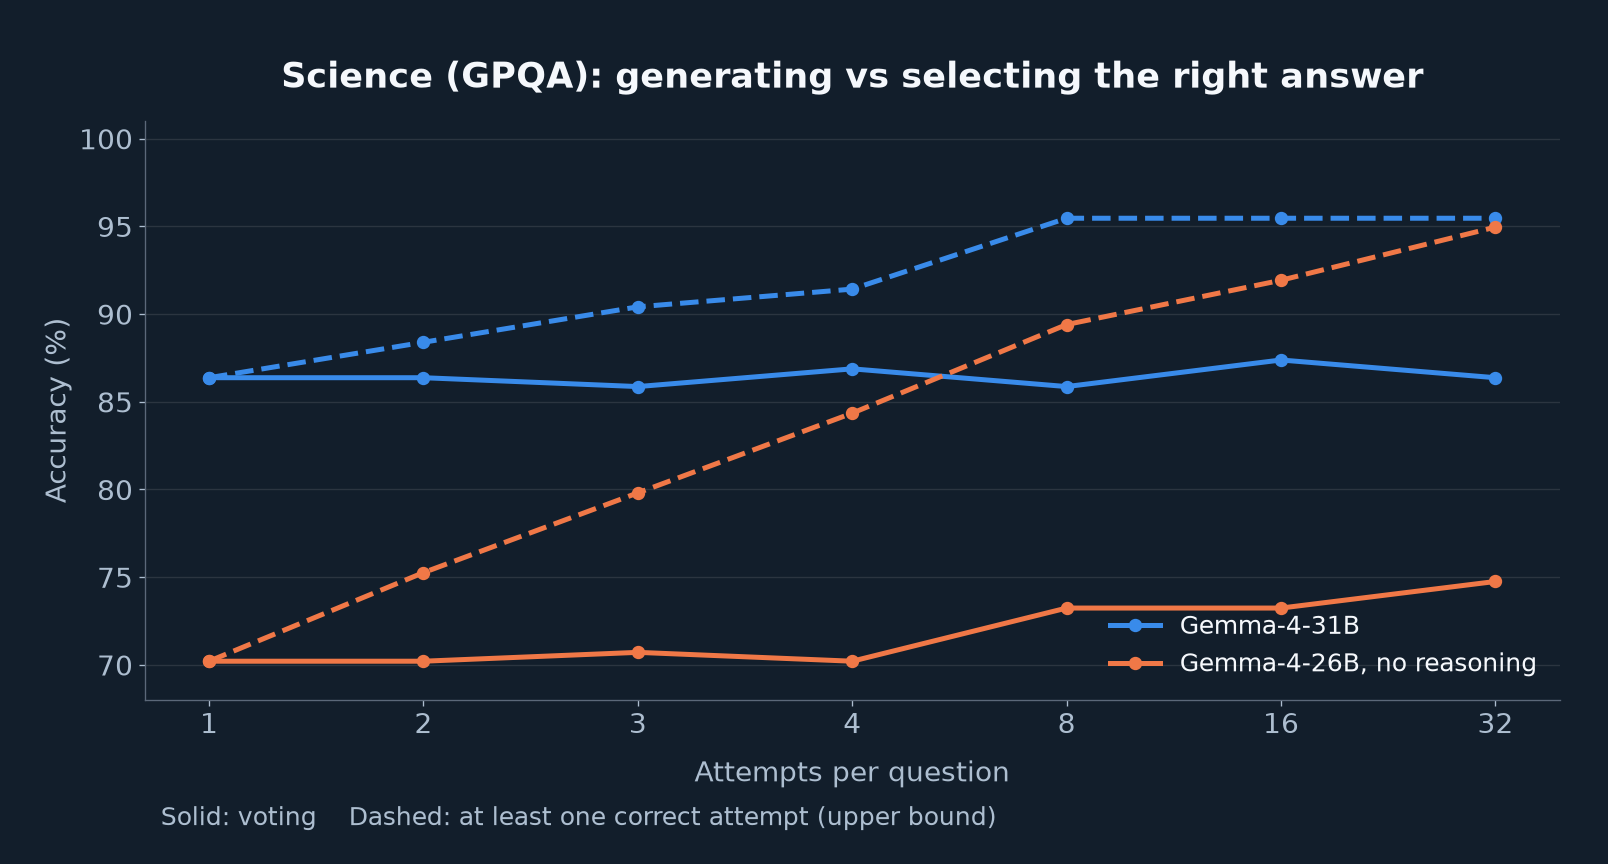
Plné čiary: skutočný výsledok hlasovania. Prerušované čiary: aspoň jedna správna odpoveď medzi pokusmi. Táto horná hranica využíva znalosť riešenia. Ani 32 pokusov nezvýšilo presnosť hlasovania Gemmy-4-31B nad 86,4 %.
Hovorím tomu stena výberu. Spoľahlivý výber správnej odpovede z týchto ôsmich kandidátov by mohol bez nového základného modelu pridať takmer desať percentuálnych bodov. Nebolo by to zadarmo: vygenerovanie ôsmich odpovedí aj ich kontrola niečo stoja.
Nechať rozhodnúť inú AI je zrejmý ďalší krok. V samostatnom experimente s dodržiavaním pokynov IFEval však sudcovia, ktorých som testoval, nesúhlasili s kontrolami založenými na pravidlách v 20 až 25 % prípadov. Na opätovnú otázku zmenili svoj verdikt na rovnakú odpoveď v 9 až 25 % prípadov. To nevylučuje rozhodcov AI. Znamená to, že títo konkrétni sudcovia a nastavenia potrebujú overenie. Nemožno tiež predpokladať, že sa čísla vzťahujú na vedecké otázky GPQA.
Kontroly na pevnom základe fungovali najlepšie: spustite testy programu, prepočítajte výsledok, skontrolujte pravidlá formátovania. Model hovoriaci „toto vyzerá dobre“ je iný druh dôkazu.
Čo vlastne znamená spolupráca modelov?
V Hyperpriestore vyvíjam HyperFusion, systém pre spoluprácu medzi modelmi, a Atlas, ktorý na základe zadania vyberie vhodný postup. Pri čítaní výsledkov je užitočné rozlišovať štyri veci:
| Postup | Čo sa deje |
|---|---|
| Hlasovanie | Model odpovedá opakovane alebo hlasuje niekoľko modelov. Najčastejšia odpoveď vyhráva. |
| Výber | Z hotových odpovedí sa vyberie jedna, napríklad podľa výsledkov testov. |
| Kaskáda | Najprv odpovedá lacnejší model. Ak jeho odpoveď nie je možné dostatočne overiť alebo neprejde kontrolou, nastupuje silnejší model. |
| Syntéza | Ďalší model spája kandidátov do novej odpovede. |
Výsledky jedného postupu nie sú automaticky výsledkami ostatných. V záverečnom experimente som meral skutočnú syntézu pri dodržiavaní pokynov a otázkach nad dokumentmi. Pri ostatných úlohách šlo najmä o hlasovanie, výber či kaskádu. Pre kód boli použité verejné testy na výber a samostatné skryté testy na finálne vyhodnotenie.
Hyperpriestor funguje aj s veľkými hostovanými modelmi, ktoré majú rôzne ceny a funkcie. Preto z meraní otvorených modelov na LUMI nevyvodzujem univerzálny verdikt o jeho produkčnej fúzii.
Jeden silný model je ťažké poraziť
Finálne porovnanie zahŕňalo jedenásť modelových konfigurácií a pätnásť typov úloh. Okrem prírodovedných otázok a matematiky to boli programovanie, spracovanie textu, dodržiavanie pokynov a česká maturita. Na jednu úlohu v hlavnej matrici bolo zvyčajne štyri až osem pokusov; niektoré následné testy využívali viac opakovaní.
Router vyberá model alebo postup podľa zadania. Pôvodné pravidlá a naučené varianty som porovnal s jednoduchou stratégiou: vždy použiť ten istý model.
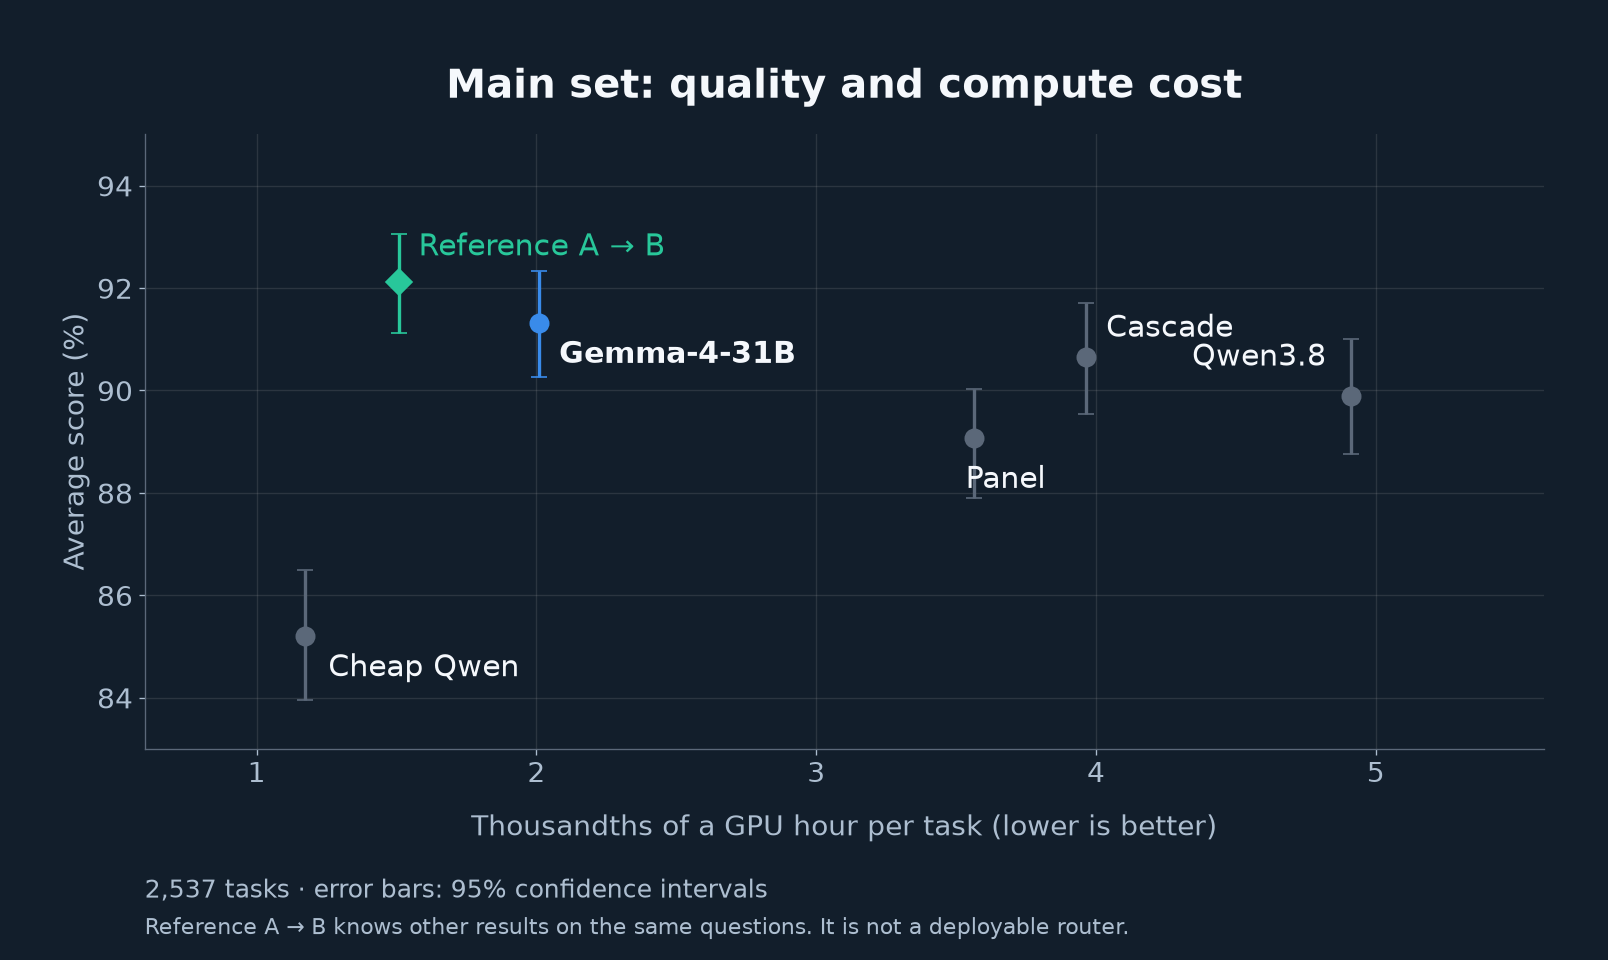
Vľavo hore je lepšie. Referenčná voľba A → B pozná výsledky iných pokusov na rovnaké otázky, takže nejde o nasaditeľný smerovač. Optimistický výber len na základe vyhodnotených výsledkov tu nie je zobrazený.
| Postup | Hlavná sada | Nové typy úloh | Cena hlavná / nová* |
|---|---|---|---|
| Qwen3.6-35B-A3B bez uvažovania | 85,2 % | 88,7 % | 1,17 / 0,71 |
| Qwen3.8-27B s uvažovaním | 89,9 % | 89,9 % | 4,91 / 3,44 |
| Gemma-4-31B s uvažovaním | 91,3 % | 91,4 % | 2,01 / 1,62 |
| Panel troch modelov | 89,1 % | 88,5 % | 3,56 / 1,30 |
| Kaskáda | 90,7 % | 90,1 % | 3,96 / 1,96 |
| Naučené smerovače | 90,2 až 91,3 % | 90,3 až 91,4 % | podľa nastavenia |
| Výber referencie A → B | 92,1 % | 92,8 % | 1,51 / 0,96 |
Tisíciny GPU hodiny na úlohu. Ide o priemerné skóre pre konkrétnu zmes úloh, nie o univerzálne hodnotenie modelov. Hodina GPU tu znamená hodinu práce pre jeden modul AMD MI250X.
Gemma spojila silný výkon so stručnou úvahou. V hlavnej sade lacnejší Qwen využíval približne 1/1,7 času GPU, no zaostával o šesť bodov. Router tak mal malý priestor na chyby. Pri inej dvojici modelov a rozdielnych cenách môže byť situácia výrazne priaznivejšia.
Ako veľmi dôverujeme číslam?
Hlavná sada obsahovala 2 544 unikátnych úloh, z ktorých 2 537 vstúpilo do prísneho porovnania so všetkými potrebnými odpoveďami. Nová sada pridala 1 455 problémov šiestich ďalších typov. Pravidlá routera boli pevne stanovené pred otvorením výsledkov novej sady. Výber postupov a hodnotenie používali oddelené opakovania. Pri učení routerov sa oddeľovali aj samotné otázky.
Nie každá desatina bodu je zlepšenie. Napríklad 91,3 % pre Gemmu má 95 % interval spoľahlivosti približne 90,3 až 92,3 % v hlavnej analýze. Preto malé rozdiely popisujem ako pozorované výsledky, nie ako preukázanú nadradenosť. Opakované odpovede na rovnakú otázku tiež nie sú nezávislými novými otázkami.
Neskoršie experimenty s inými receptami a overovateľmi znovu použili údaje, ktorých výsledky už boli skontrolované. Sú užitočné na nájdenie ďalšieho smeru, ale potrebujú ďalší samostatný test. To platí najmä pre úspory s JEV nižšie.
Kedy sa viacnásobné pokusy naozaj vyplatili?
| Situácia | Čo fungovalo | Pozorovaný výsledok |
|---|---|---|
| Programovanie s testami | Lacný model, overenie, v prípade potreby potom silnejší model | Porovnateľná kvalita za približne polovičný čas GPU: 85,2 % pri 3,0 oproti 84,8 % pri 5,6 tisícinách hodiny GPU |
| Programovanie s dôrazom na kvalitu | Opakované odpovede silného modelu a kontrola pomocou testov | Približne +1,4 až +1,9 bodu za o 17 až 40 % vyššiu cenu |
| Súťažná matematika | Hlasovanie viacerých pokusov alebo vhodná porota modelov | V jednom porovnaní +3,4 bodu za 2,2-násobok ceny |
| Odborné vedecké otázky | Rôzne modely alebo kaskáda | Približne +1,3 až +2,0 bodu za dvojnásobok až šesťnásobok nákladov |
| Vyhľadávanie a výpočet z textu | Lacný model bez rozšíreného uvažovania | Podobná alebo lepšia kvalita, tri až sedemkrát lacnejšie |
V matematike ma prekvapilo, ako veľmi záležalo na vzorci chýb. Menšia Gemma s vypnutým uvažovaním sa opakovanými pokusmi značne zlepšila. Silnejšia Gemma-4-31B sa sotva zlepšila. Hlasovanie pomáha, keď sa pokusy líšia užitočnými spôsobmi. Opakovaná rovnaká chyba väčšinovým hlasovaním nezmizne.
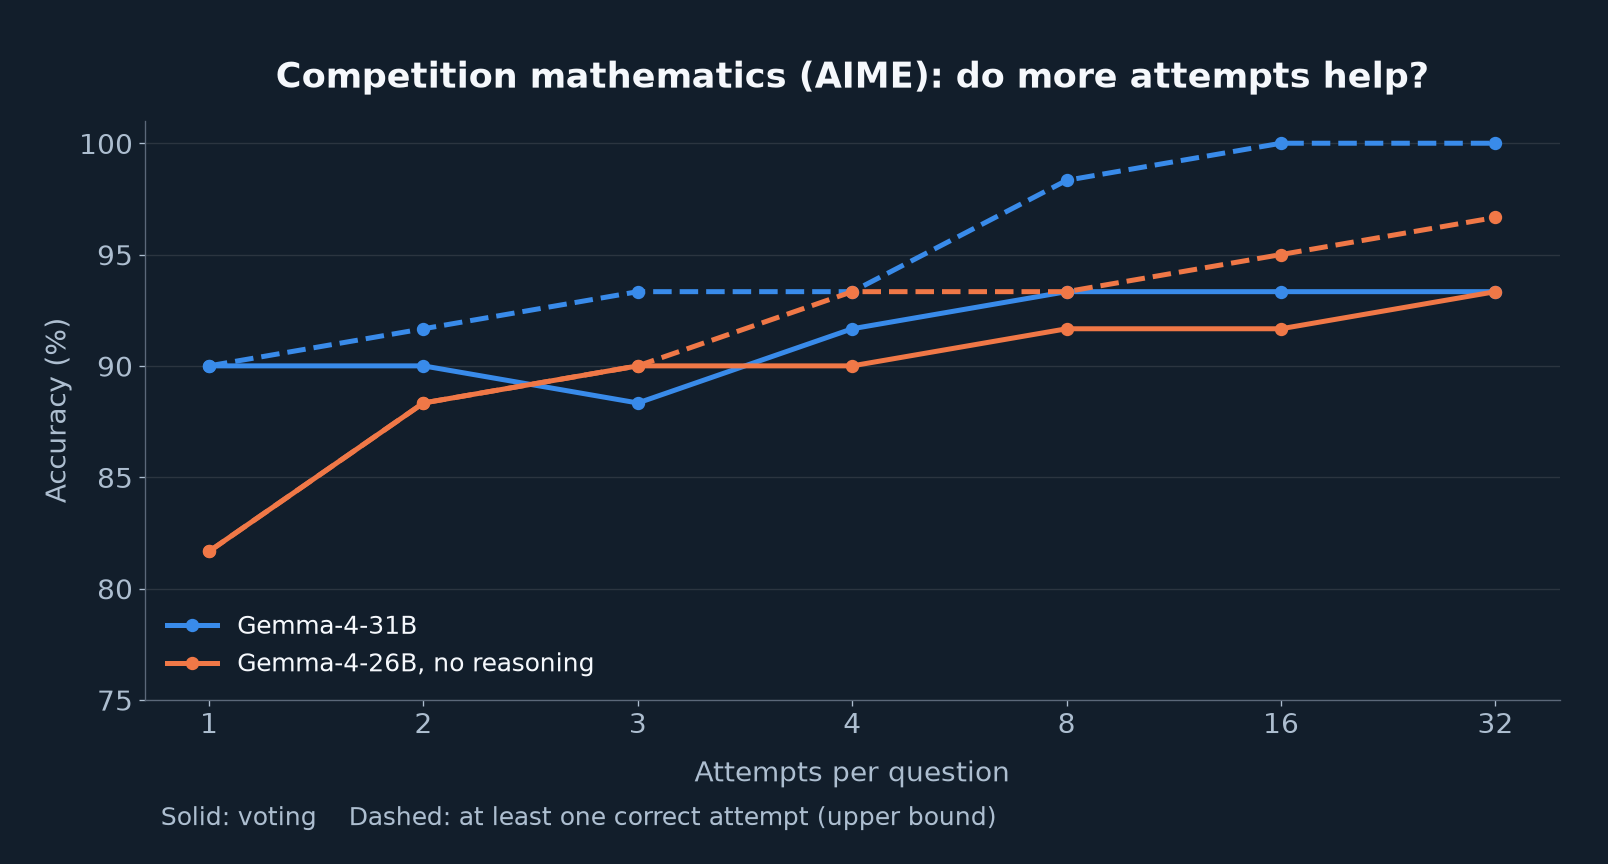
AIME obsahuje 60 súťažných úloh. Plná čiara je hlasovanie, prerušovaná čiara znamená aspoň jeden správny pokus. Malý počet otázok je ďalším dôvodom, prečo nepreceňovať drobné rozdiely.
ThinkingCap: lepšia matematika za 30 hodín GPU
Jeden z najpovzbudivejších výsledkov prinieslo dotrénovanie ThinkingCap-Qwen3.6-27B od BottleCap AI, spoločnosti Tomáša Mikolova. Model si už kladie za cieľ udržať svoje zdôvodnenie stručné. Chcel som zistiť, či to dokážem posunúť ďalej.
Pre variant zobrazený v grafe som použil 1 400 matematických príkladov a 469 odpovedí z oblasti vedy a programovania vygenerovaných pôvodným modelom. Pre jednoduchšiu matematiku som volil krátke správne riešenia, pre ťažšie príklady dlhšie. Pôvodné odpovede mali pomôcť zachovať ostatné schopnosti. Jeden takýto tréning trval približne 30 hodín GPU. Celá séria skúšok a hodnotení stála viac.
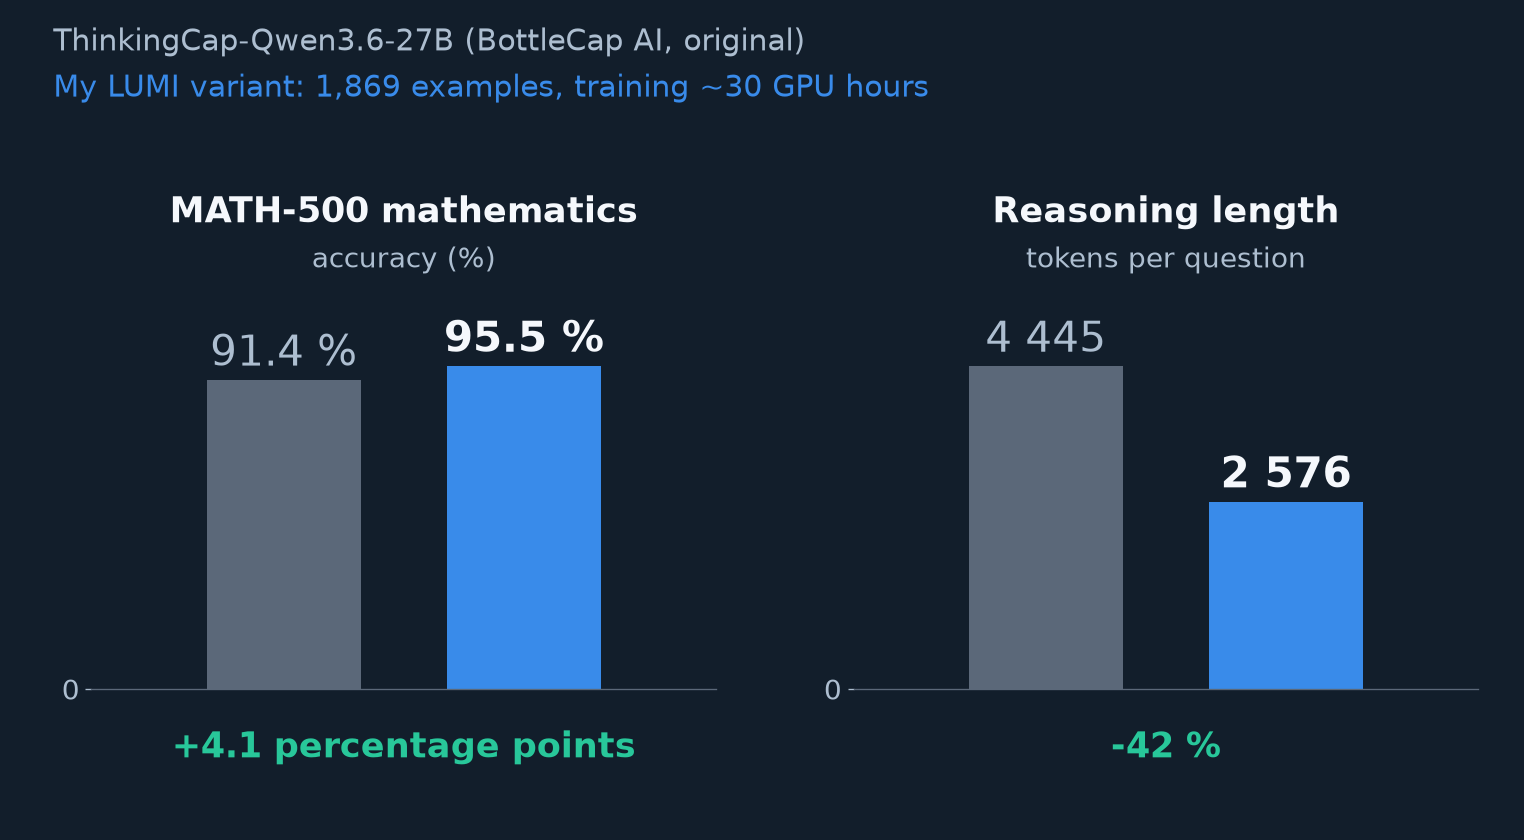
MATH-500: 500 otázok, každá trikrát, t.j. 1500 pokusov na variant. Ten istý doladený variant získal 4,1 percentuálneho bodu a skrátil uvažovanie o 42 %.
Presnejšie a zároveň výstižnejšie ako pôvodný ThinkingCap. Pre konkrétnu matematickú zostavu je to veľmi pekný výsledok za malý tréningový rozpočet.
Má to však svoju cenu: rovnaký variant klesol o 3,3 bodu v súťažnej matematike AIME a 5,6 bodu vo vedeckých otázkach GPQA. Ďalší z piatich receptov stratil na vede menej, ale bol to iný model. Ich najlepšie čísla nemožno spojiť do jedného víťaza. Zlepšil som konkrétnu matematickú schopnosť modelu, neprekonal som ThinkingCap vo všetkom.
Pred tréningom som skontroloval presné aj blízke textové prekryvy s testami MATH-500, AIME a GPQA; použitá kontrola žiadne nenašla. Nie je úplnou zárukou, že podobné úlohy sa nevyskytli v pôvodnom predtréningu. A je to verzia založená na Qwen3.6: BottleCap medzitým vydal novší ThinkingCap-Qwen3.8, s ktorým tento výsledok nemeriam.
Lepší overovač namiesto väčšieho modelu?
Atlas používa na odhad vstupných vlastností rýchly špecializovaný model JEV od TypeSafe. Skúsil som to aj na kontrolu odpovedí, ktoré už boli vygenerované. V týchto následných pokusoch to fungovalo lepšie ako samotné odhadovanie náročnosti otázky.
| Signál pre rozhodnutie, kedy stačí lacný model | AUC | Kvalita pri približne polovičnom čase GPU oproti Gemme |
|---|---|---|
| Pôvodné otázky JEV o vlastnostiach úlohy | 0,77 | 88,8 % |
| Nové otázky JEV o obtiažnosti | 0,79 | 89,3 % |
| Vlastnosti textu bez JEV | 0,61 | 88,3 % |
| Kontrola odpovede pomocou Gemmy-4-31B | 0,77 | 89,4 % |
| Kontrola odpovede pomocou Qwen3.6 | 0,82 | 88,8 % |
| Kontrola odpovede pomocou JEV | 0,84 | 89,8 % |
AUC popisuje, ako dobre signál zoraďuje prípady podľa rizika chyby. Hodnota 0,5 zodpovedá náhodnému poradiu, 1 dokonalému. AUC 0,84 neznamená 84% presnosť odpovedí.
V tomto nastavení ušetríte približne 30 % času GPU za pol percentuálneho bodu kvality. Úspora polovice času GPU stojí asi jeden a pol bodu. Ide o body vybrané z nameranej krivky na už použitých údajoch, nie o hotovú záruku na nové dopyty zákazníkov. Volania API na JEV stoja dodatočných 0,00005 USD za úlohu; tieto dolárové náklady nie sú zahrnuté v GPU hodinách.
JEV je stále model, ktorý môže robiť chyby. Nie je ekvivalentom spustiteľného testu. Skúšal som aj ostatné overovače v konkrétnom úspornom nastavení, nie vo všetkých možných formách. Napriek tomu je to sľubnejší návod na ďalšiu prácu, ako obyčajný dojem o náročnosti zadania.
Na novej generácii môže záležať viac ako na miliardách ďalších parametrov
Aj samotné modely sa v priebehu troch mesiacov zmenili. V porovnaní s rovnako veľkým Qwen3.6-27B získal Qwen3.8-27B v týchto testoch približne 13 percentuálnych bodov v súťažnej matematike a 18 v programovaní. Zároveň na tieto úlohy spotreboval približne polovicu času GPU.
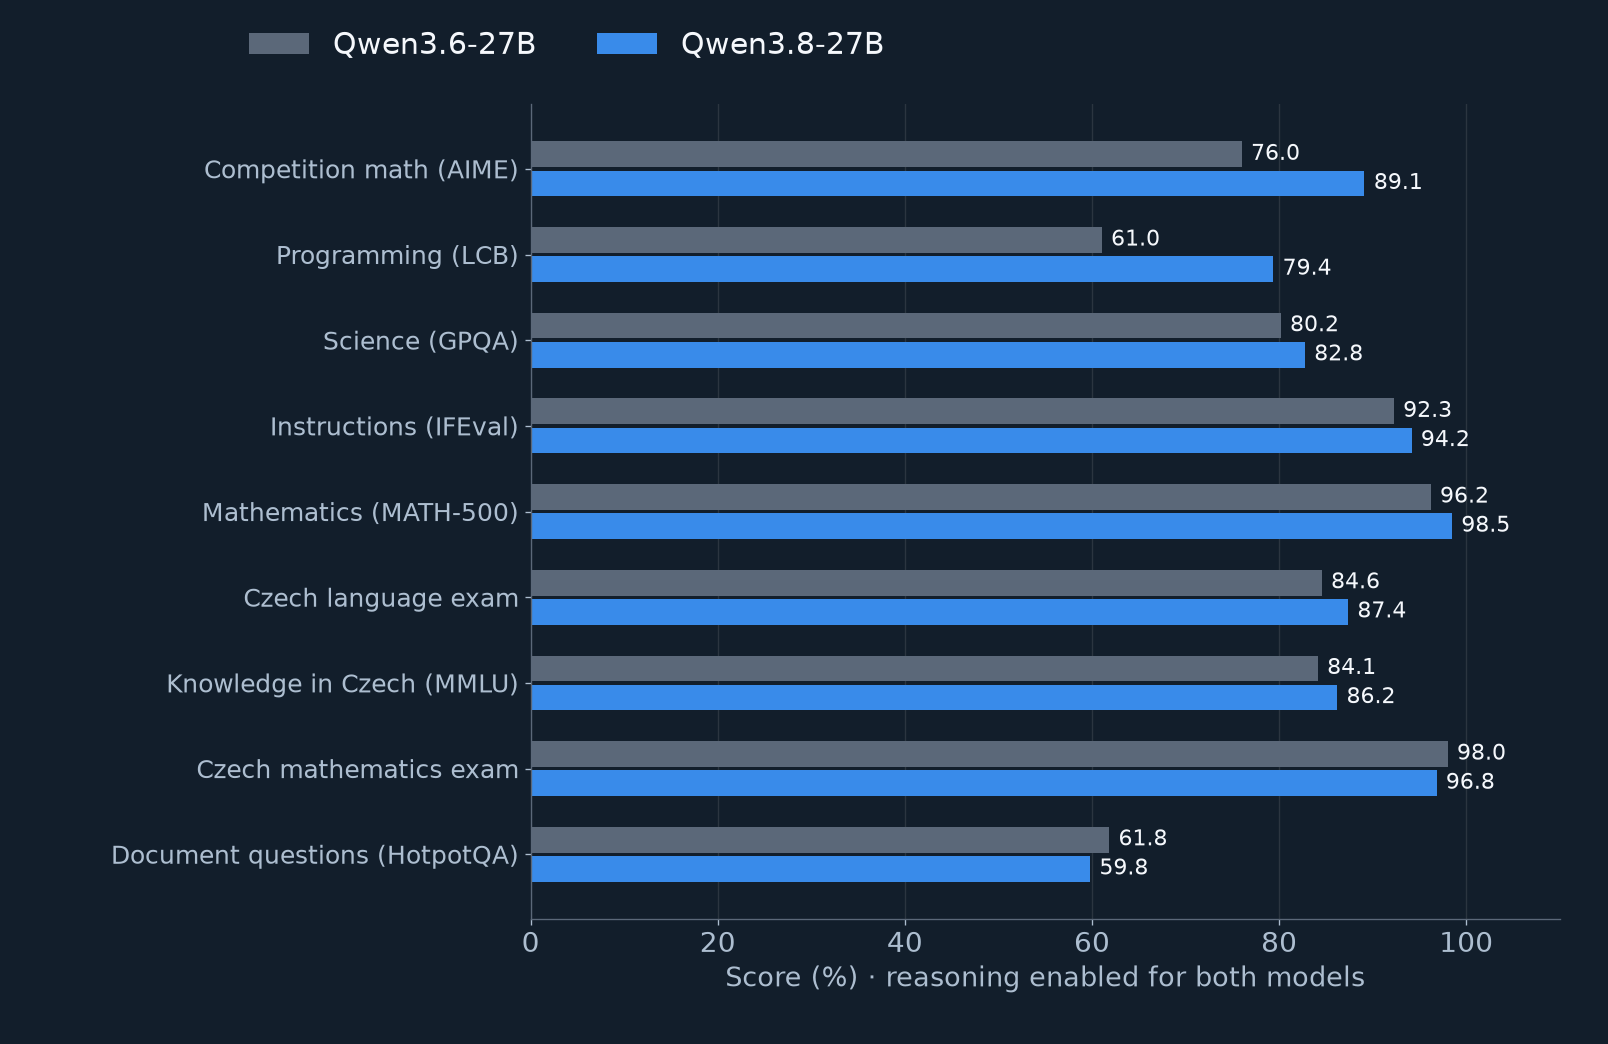
Uvažovanie bolo povolené pre oba modely. Zlepšenie nebolo univerzálne: na niektorých úlohách s textom a českou matematikou novší model mierne stratil. Má zmysel neustále merať modely na svojich vlastných úlohách.
Opačné prekvapenie priniesol MiMo-V2.6-Pro s približne jedným biliónom parametrov, najväčší model v konečnom porovnaní. Na jeden uzol sa zmestil v komprimovanej forme s priemerom 3,5 bitov na parameter.
| MiMo-V2.6-Pro, 3,5 bit | Gemma-4-31B | |
|---|---|---|
| Vedecké otázky GPQA | 78,3 % | 85,9 % |
| Maturita z českého jazyka | 92,2 % | 91,0 % |
| Hodiny GPU na otázku GPQA | približne 0,52 | približne 0,005 |
MiMo obstál dobre na skúške z českého jazyka, ale bol oveľa drahší a menej presný na GPQA. Pätina zložitých otázok narazila na limit dĺžky odpovede. Variant MXFP4 s vyššou presnosťou dosiahol o 4,7 bodu vyššie skóre na 64 otázkach, ktoré dokončili oba varianty, a nemal žiadnu urezanú odpoveď. To je zaujímavá stopa, ale aj malá, vybraná vzorka.
Dôvodom môže byť kompresia, kvalita konkrétnej verzie modelu, spôsob spustenia a nastavené limity. MiMo bežal cez llama.cpp, Gemma cez vLLM. MiMo navyše využíva architektúru MoE, ktorá pre každý token aktivuje len časť parametrov. Toto nie je čistý experiment „bilión vs. 31 miliárd“ a nemožno ho použiť na odsúdenie modelu ako takého.
Skoršie porovnania platených rozhraní API interpretujem s rovnakou opatrnosťou:
| Malý porovnávací test | Cez API | V LUMI |
|---|---|---|
| GPQA, 138 otázok | Gemini 3.1 Pro 93,5 %, Claude Sonnet 5 86,2 % | Gemma-4-31B 84,1 % |
| GLM-5.2, hodnotená úloha s otvoreným koncom | 60 bodov zo 60 | 4-bitová verzia: 35 bodov zo 60 |
| Kimi K3, 40 programovacích úloh | 31 správne | 2-bitová verzia: 28 správnych |
Posledný riadok znamená asi 90 % relatívneho výsledku v tomto teste, nie zachovanie 90 % všetkých schopností Kimi. Rozdiely medzi API a lokálnou verziou tiež samy osebe neizolujú efekt kvantizácie, teda kompresie číselných váh modelu. Môže to fungovať dobre, ale je potrebné skontrolovať každý konkrétny súbor a spôsob vykonania.
Dve zistenia, na ktoré by bola škoda zabudnúť
Dlhé dokumenty otestujú inú schopnosť ako krátky benchmark. V teste otázok týkajúcich sa dokumentu som pridal rušivý text a rozšíril kontext z približne 8 000 na 120 000 tokenov. Testované Qweny stratili asi 2-5 bodov F1 skóre, gpt-oss asi 18. Toto nie je verdikt pre všetky dlhé dokumenty, ale dobre ukazuje, prečo veľkosť kontextového okna ako meradlo kvality nestačí.
Záleží na tom, kto hodnotí. Pri skoršom pokuse o zhrnutie vyšla syntéza ako víťazná v 92,7 % porovnaní, keď ju vyhodnotil rovnaký model, ktorý ju vyrobil. U nezávislého hodnotiteľa Llama to bolo 57,3 %. Zmenil sa hodnotiteľ, nejde teda o presné meranie jednej príčiny. Ale ten rozdiel stačí ako výstraha pred tým, aby si model sám vystavoval vysvedčenie.
Ako to súvisí s iným výskumom
Moje pokusy nie sú prvou prácou na spolupráci modelov. Pomáhajú mi začleniť všeobecné myšlienky do konkrétnych nákladov a obmedzení v LUMI:
- Self-Consistency ukazuje výhody viacerých ciest k riešeniu a hlasovaniu. Moje výsledky mi pripomínajú, že záleží aj na tom, aké podobné chyby robia pokusy.
- Mixture-of-Agents skúma syntézu viacerých modelových odpovedí. Ide o odlišný proces od samotného hlasovania.
- RouteLLM rieši výber modelu podľa pomeru kvality a ceny. Výsledok takéhoto smerovača vždy závisí od toho, aké modely si vyberie.
- Let’s Verify Step by Step skúma trénovanie modelov na kontrolu jednotlivých krokov riešenia. Moje dáta väčšinou vyhodnotia len konečnú odpoveď, takže pre podobný prístup by bolo potrebné pridať ďalší druh anotácií.
- Quantization Inflates Reasoning opisuje, že kompresia môže predĺžiť uvažovanie. Je to možné vysvetlenie časti mojich pozorovaní, nie dôkaz príčinnej súvislosti v konkrétnom behu MiMo.
Čo som sa naučil o samotnom superpočítači
Počas posledných experimentov bežalo súčasne až 140 úloh plánovača. Každá spracovala veľa otázok. Táto súbežnosť umožnila približne 2 900 GPU hodín zmestiť sa do jedného dňa a noci; neznamená to, že jeden používateľ tak dlho čakal na odpoveď.
Veľký rozdiel urobila deľba práce. Jeden uzol LUMI má štyri moduly MI250X, celkovo osem výpočtových čipov GCD. Pre model, ktorý sa zmestí do pamäte dvoch čipov, by som mohol spustiť štyri samostatné kópie namiesto jednej kópie na ôsmich čipoch.
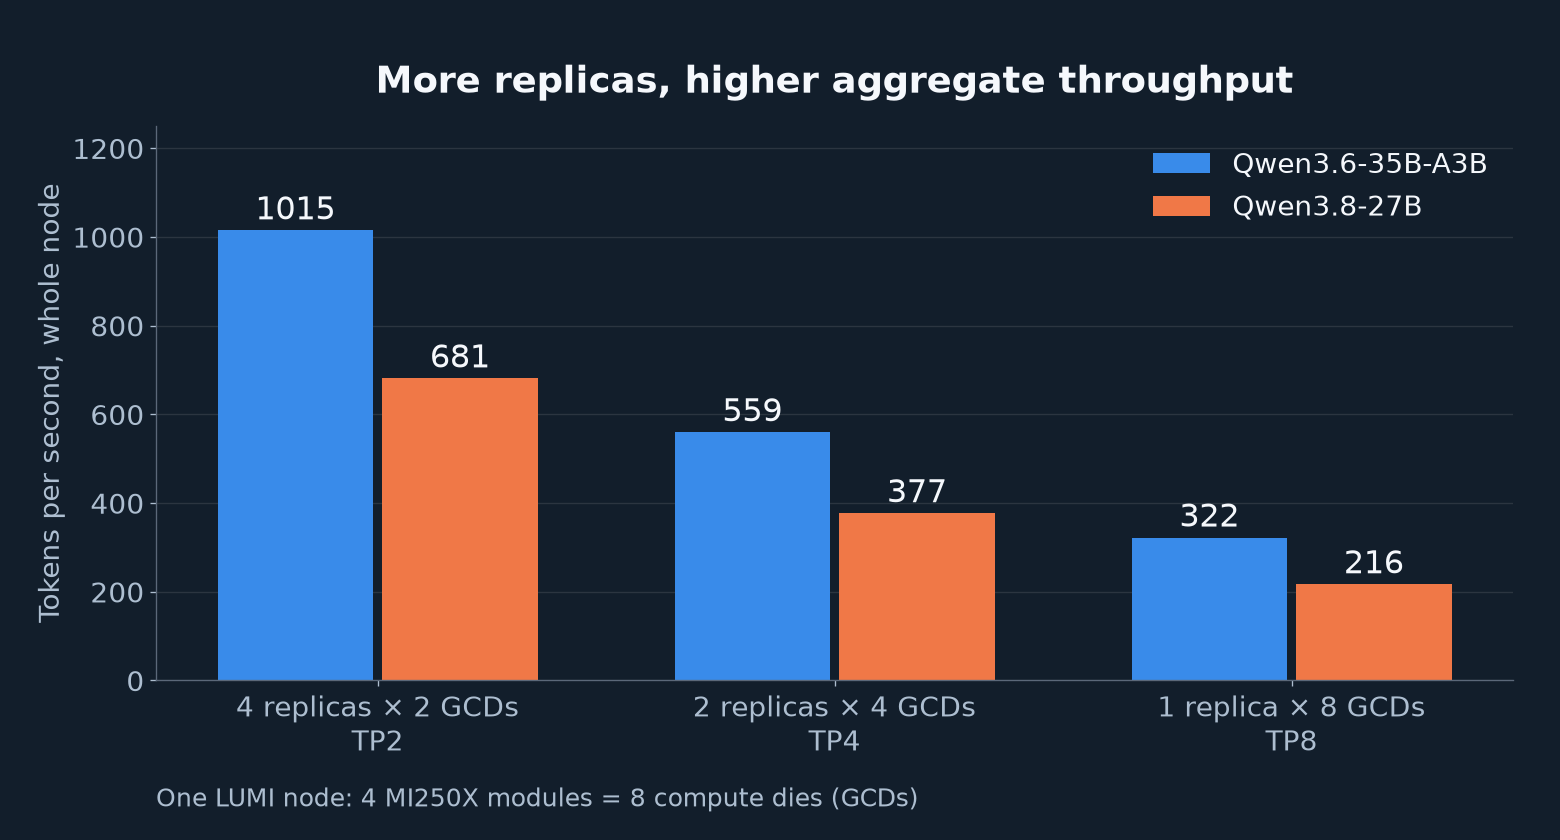
Qwen3.6-35B-A3B: približne 1015 vs 322 tokenov za sekundu. Meriam súhrnnú priepustnosť uzla pri mnohých dopytoch, nie rýchlosť jednej odpovede. Menšie kópie pomôžu, ak sa model zmestí do pamäte a majú dostatok práce.
Priebežne som meral aj elektrický príkon GPU. Podľa týchto meraní konečné experimenty spotrebovali 562 kWh pre urýchľovače. Nezahŕňa celý server, sieť ani chladenie.
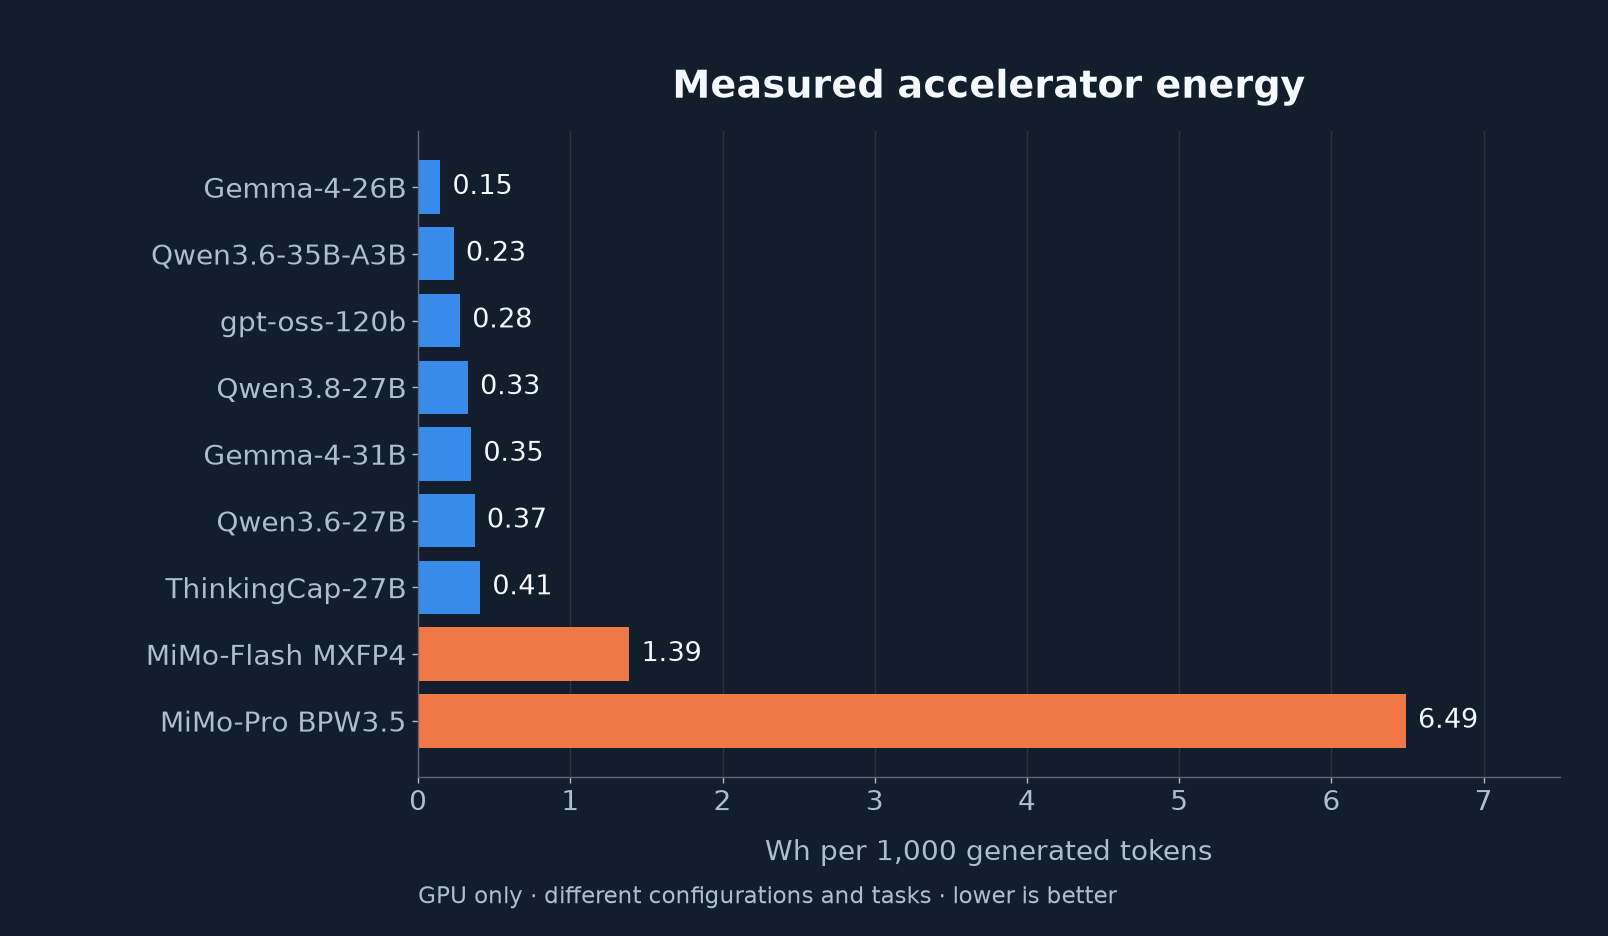
Energia na token pomáha porovnávať efektivitu prevádzky. No pre reálnu aplikáciu je dôležitejšia energia na správne vyriešenú úlohu. Kratšia odpoveď môže byť celkovo ekonomickejšia aj s drahším tokenom.
Čo sa pokazilo a koľko to stálo
Niektoré výsledky stáli zbytočne veľa času. Dvakrát som nastavil hranicu myslenia príliš krátko. Regenerácia skrátených odpovedí si vyžiadala 777 hodín GPU, čo je zhruba šestina rozpočtu. Naučil som sa tiež nedôverovať priebežným výsledkom: jednoduchšie otázky končia ako prvé, takže prvé výsledky vyzerajú lepšie.
V prvej analýze som tiež porovnával panely z jedného pokusu s jednotlivými modelmi spriemerovanými z viacerých pokusov. Opravil som metodiku; hlavná tabuľka vyššie už používa samostatné opakovania a porovnateľné hodnotenia.
U kódovacieho agenta na SWE-bench sa miera úspešnosti dostala zo 42 na 61 %, no zásluhu na tom mali lepšie nástroje a riadenie práce, nie dotrénovanie. Aj negatívny výsledok pomôže vyhnúť sa ďalšej slepej uličke.
| Položka | Výsledok |
|---|---|
| Použitý prídel | 4 703 z 5 000 hodín GPU, rezerva 297 |
| Záverečné experimenty | približne 2 900 GPU hodín |
| Energia finále | 562 kWh, iba GPU |
| Ohodnotené výstupy | 305 051 odpovedí a ďalších 5 314 programových riešení |
| Platené API | približne 42 USD, z čoho celkovo približne 0,85 USD za JEV |
305 000 odpovedí nie je 305 000 rôznych otázok. Číslo zahŕňa rôzne modely a opakovania. Uvedené hodiny GPU sú spotrebou prideleného grantu, nie faktúrou, ktorú som zaplatil v hotovosti.
Tri mesiace, na ktorých chcem stavať
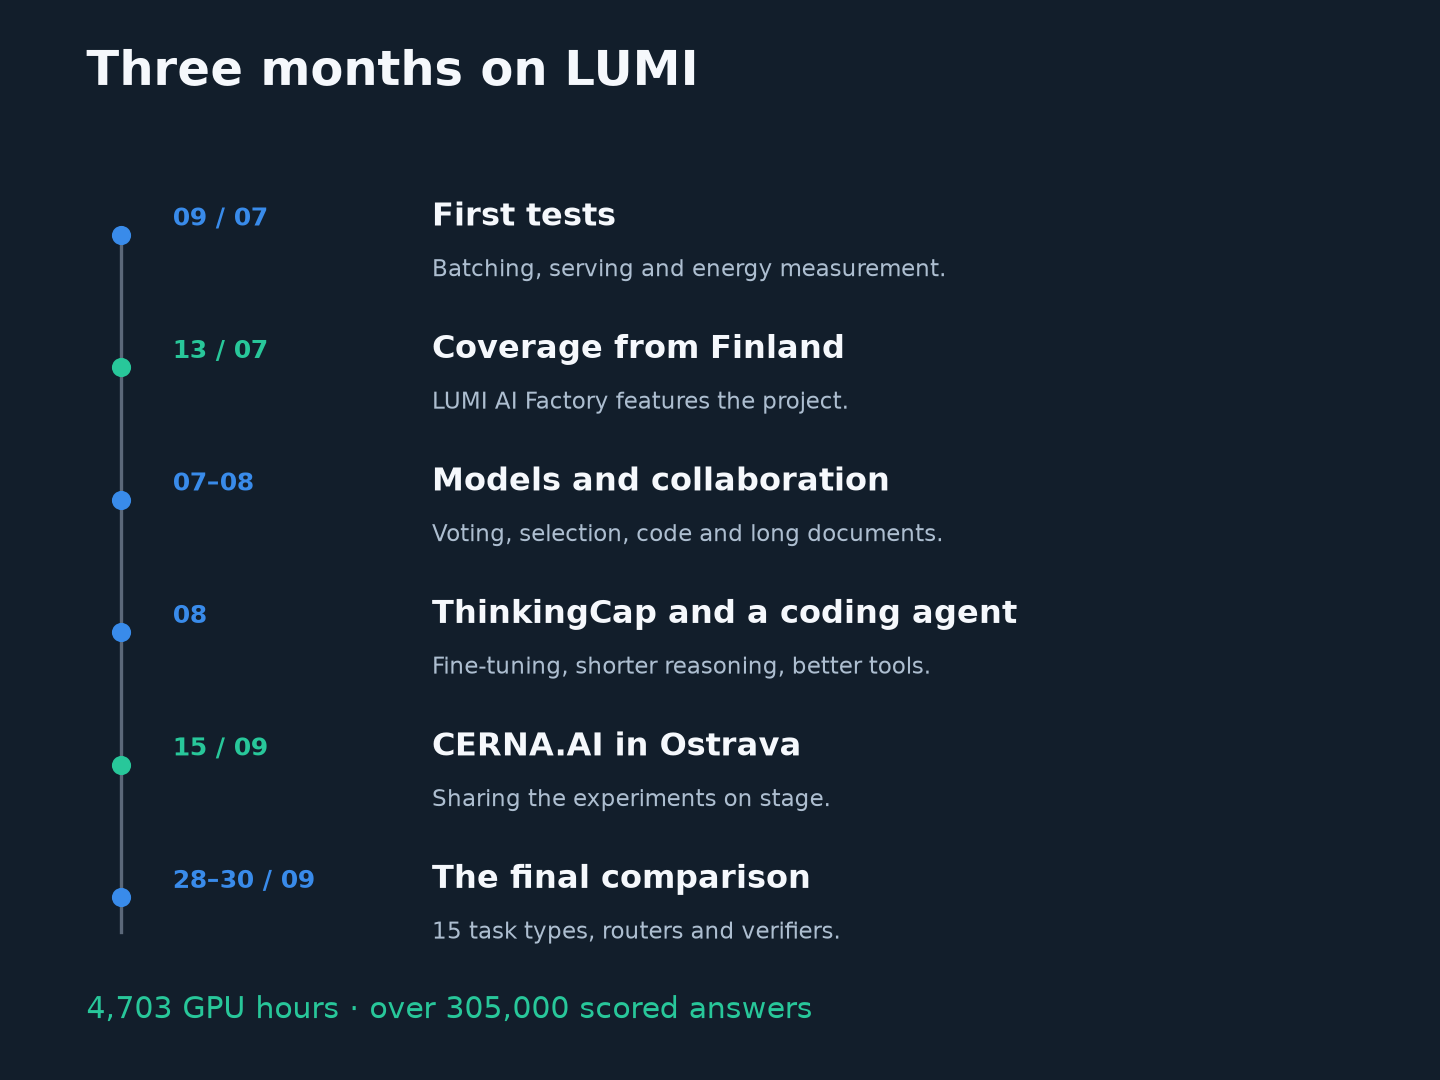
Prvé skúsenosti som opísal v článkoch o LUMI a vykurovaní Kajaani a o prvých fúziách a GLM-5.2. V júli o projekte písala aj LUMI AI Factory.
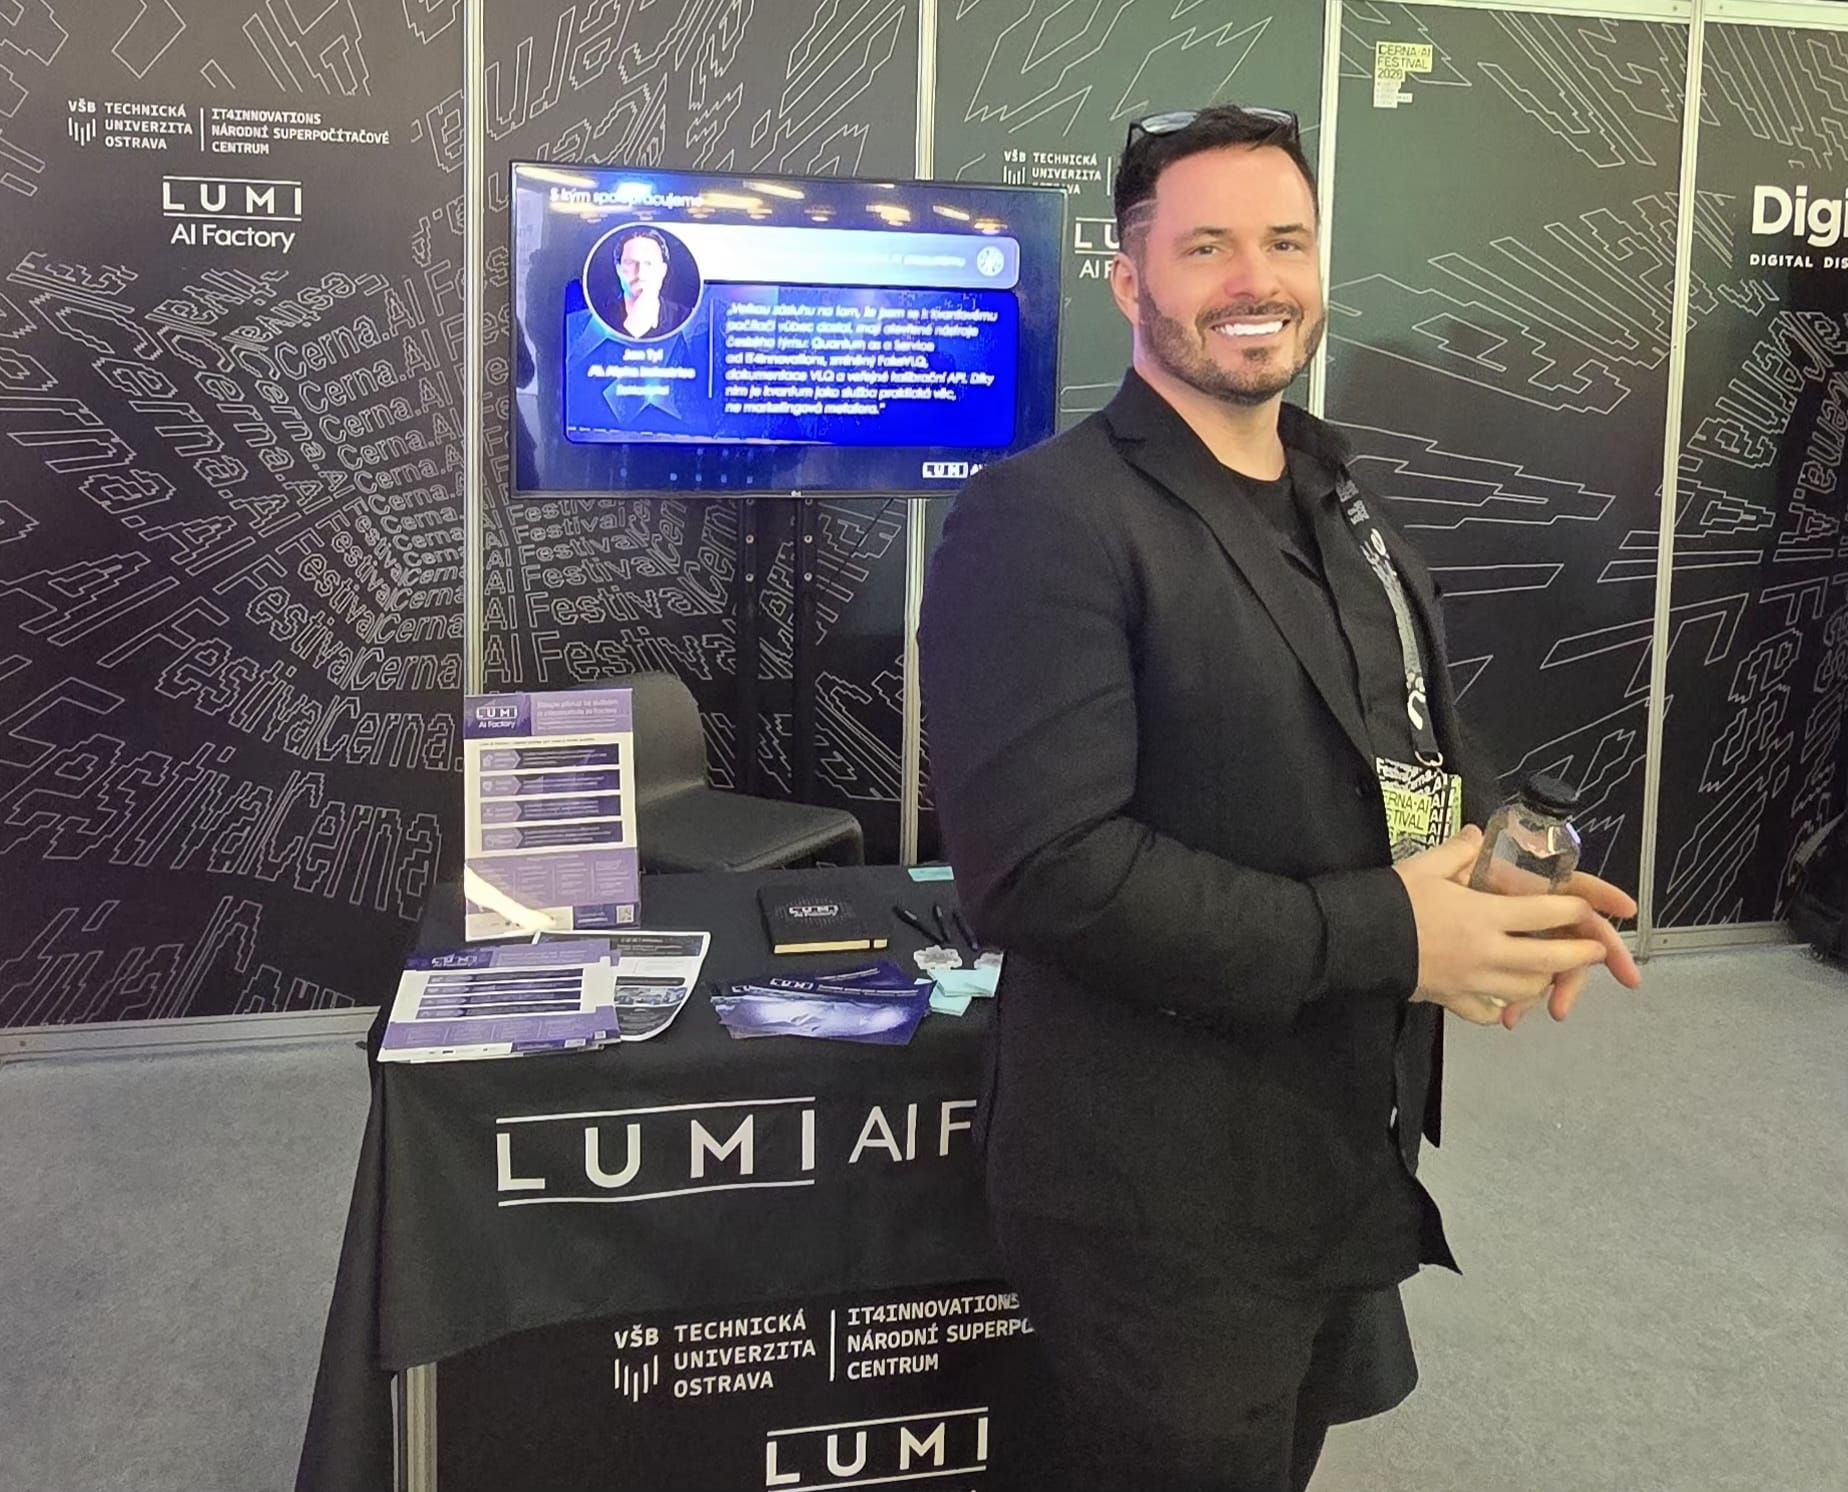
V septembri som hovoril o experimentoch na CERNA.AI v ostravskom Gongu, festivale s viac ako dvetisíc účastníkmi. Z prednášky vznikol článok 20 + 5 = 29. Overené. a LUMI AI Factory opäť napísala o podujatí a spolupráci. Paralelne som rozbehol samostatný kvantový projekt na českom VLQ; jeho výsledky nie sú súčasťou experimentov uvedených tu na LUMI.
Ďalší výskumný krok vidím v lepšom výbere a overovaní odpovedí. Na začiatok mám rozsiahly súbor ohodnotených výstupov. Najprv však potrebujem oddeliť dáta na učenie a skutočne nový test, aby si kontrolór nepamätal len známe otázky. Chcem uvoľniť dáta, skripty a zmrazené súbory na nezávislé overenie.
Tiež som začal spolupracovať s Radimom Vavříkom na príprave analýzy výkonu POP mojich AI úloh na LUMI. Dodal som testovací prípad a podporný materiál; samotná analýza sa ešte nezačala. Cieľom je zistiť, kde sa zbytočne zastavuje výpočet a ako efektívnejšie využívať hardvér.
Pre Hyperpriestor si odnášam jednoduché pracovné pravidlo: začať s dobrým samostatným modelom a pridať zložitejšie spolupráce, kde meriam skutočný prínos. Najzaujímavejšia otázka na najbližšie mesiace teda znie: Ako môžeme používateľovi dostať správnu odpoveď, keď ju už AI vygenerovala?
Ďalšia alokácia, Aitta a vzdelávací model
Moja prvá skúsenosť s LUMI bola veľmi pozitívna. Preto zvažujem žiadosť o väčšiu následnú alokáciu výpočtového času. Prirodzeným ďalším krokom by mohol byť Fast Lane Access, v ktorom možno požiadať až o 50 000 GPU hodín počas maximálne troch mesiacov. Zatiaľ je to plán, nie schválená alokácia.
Určite chcem vyskúšať Aitta, službu CSC na spúšťanie modelov s otvorenými váhami na LUMI prostredníctvom API kompatibilného s OpenAI. Zabezpečuje prípravu modelu aj získanie zdrojov z fronty. V prípade výskumu a prototypovania by mi to mohlo ušetriť značnú prácu na infraštruktúre. Jej dokumentácia však uvádza, že dostupnosť pre produkčné použitie nie je zaručená.
Tri smery vyzerajú obzvlášť hodnotne:
- Overovateľ, ktorý dokáže identifikovať správnu odpoveď. Chcem otestovať na nových otázkach, či menší vyladený model dokáže vybrať kandidátov lepšie ako hlasovanie a či sa to po zahrnutí vlastných nákladov overovateľa oplatí.
- Model pre vzdelávanie. Chcem začať dotrénovaním otvoreného modelu, ktorý rozpozná chyby v úvahe študenta a ponúkne užitočnú nápovedu namiesto hotového výsledku. Chcem to porovnať so základným modelom a s modelom, ktorý získava podporný materiál. Samotná presnosť odpovede nestačí; dôležitá je aj kvalita vedenia študenta.
- Noetica ako kognitívna architektúra. Chcem nadviazať na moje staršie experimenty s Noeticou prepojením pamäte, plánovania, Atlasu, modelovej spolupráce a overovania výsledkov. Príspevok každého komponentu by som zmeral tak, že by som ho postupne vypínal, pričom by som zachoval konštantný výpočtový rozpočet.
Tieto smery do seba zapadajú: edukačná úloha potrebuje dobré vysvetlenie, overovateľ skontroluje jej správnosť a architektúra rozhodne, kedy stačí jednoduchá metóda. Použil by som väčší rozpočet na testovanie tejto spolupráce na nových úlohách, a nie len na výrobu ďalšej tabuľky väčších modelov.
Poďakovanie a kde začať svoj vlastný projekt
Za výpočtový čas, podporu a prevádzku stroja ďakujem EuroHPC JU, LUMI AI Factory, IT4Innovations, CSC (IT Center for Science) a konzorciu LUMI. Ďakujem aj organizátorom CERNA.AI za pozvanie.
Osobne ďakujem Jakubovi Siwekovi, ktorý ma ako prvý oslovil a zoznámil ma s Filipom Oborníkom. Následne ma pozval do svojho podcastu.
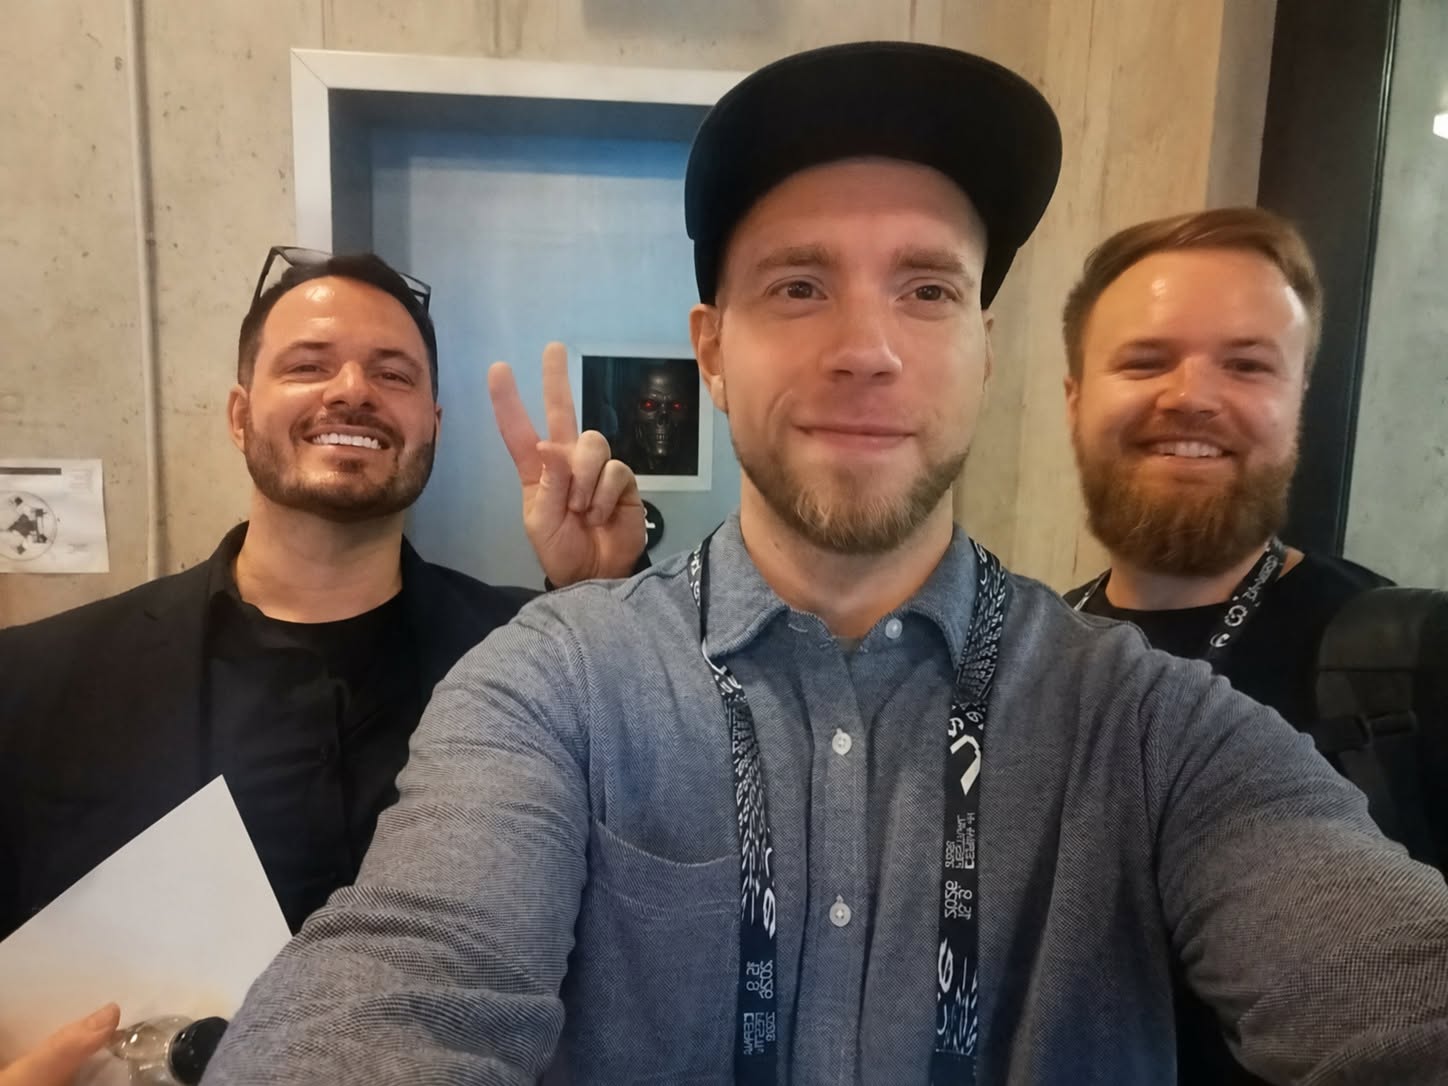
Zľava Jan Tyl, Jakub Siwek a Filip Oborník.
We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-843 access to LUMI at CSC, Finland.
Máte vlastnú predstavu? Kontaktujte český tím LUMI AI Factory v IT4Innovations na ai-factory@it4i.cz. Sám som začal s menším projektom.
A ak si chcete spoluprácu modelov priamo vyskúšať, vstúpte do Hyperpriestoru.
Súbory údajov a materiály na replikáciu
Tu sú zdroje pätnástich typov úloh zo záverečného porovnania. Počty označujú jedinečné otázky, nie počet odpovedí zo všetkých modelov. Odkazy vedú na zdrojové súbory údajov; nie vždy som použil celé ich aktuálne vydanie.
Hlavná sada: 2 544 úloh
| Súbor údajov | Použitá časť | Počet |
|---|---|---|
| GPQA | Diamond, predtým rozdelený na 60 a 138 otázok, rovnaké poradie možností odpovedí | 198 |
| MATH-500 | Celý test | 500 |
| AIME 2024 a AIME 2025 | Zmrazené sady, 30 úloh z každého ročníka | 60 |
| IFEval | 541 záznamov, prísne vyhodnotenie všetkých pokynov v odpovedi | 541 |
| HotpotQA | Vlastný výber z variantu distractor | 120 |
| LiveCodeBench | Zmrazený výber LCB-60 zo súboru test6 | 60 |
| CERMAT: čeština | Úlohy s výberom odpovede | 649 |
| CERMAT: Matematika | Úlohy s výberom odpovede | 126 |
| MMLU v češtine | Päť otázok na načítaný odbor, seed 42; uložený výber má 290 položiek | 290 |
2 537 úloh vstúpilo do prísneho porovnania smerovačov: sedem položiek IFEval nemalo všetky požadované výstupy. V tejto hlavnej tabuľke je skóre HotpotQA presnou zhodou odpovede; pre dlhý kontextový experiment uvádzam F1. Toto nie sú zameniteľné metriky.
Nové typy úloh: sada A8, 1 455 otázok
| Súbor údajov | Použitá časť | Počet |
|---|---|---|
| BIG-Bench Hard | 15 položiek z každej z 27 konfigurácií | 405 |
| MMLU-Pro | Test, 25 položiek zo 14 odborov | 350 |
| Belebele | Test, česká verzia ces_Latn | 200 |
| CzechBench Agree | Test gramatickej zhody | 150 |
| DROP | Výber z overovacej sady | 200 |
| Klokan QA | Test, konfigurácia balanced | 150 |
Výberový skript A8 používa seed 42. Záleží tiež na poradí načítania množiny údajov, takže samotný seed nešpecifikuje výber úplne.
Stiahnuť zoznam množín údajov, vybratých ID úloh a kontrolných súčtov (JSON)
Súbor obsahuje identifikátory všetkých 3 999 úloh v oboch súboroch a hash SHA-256 uložených vstupných súborov. Uvádza tiež nastavenia generovania zo skriptu a príklady verzií runtime z protokolov. Nekopírujem doň zadania ani správne odpovede; môžete ich získať od autorov súborov údajov podľa ich podmienok. Napríklad GPQA vyžaduje prijatie podmienok prístupu.
Pre presnú replikáciu celého experimentu ešte potrebujem zverejniť kompletný balík: prompty, presné revízie modelu a množiny údajov, opravené limity pre jednotlivé spustenia, skórovacie skripty a uzamknuté pravidlá routera. Tento zoznam je prvým konkrétnym základom, nie tvrdením, že celý experiment je už reprodukovateľný jediným príkazom.
ThinkingCap som doladil na vybraných príkladoch z OpenR1-Math-220k a vlastných odpovediach pôvodného modelu na zadania z Mixture-of-Thoughts. Toto sú tréningové zdroje, oddelené od vyššie uvedených hodnotiacich súborov.