Czym jest harness i jak zmienia wydajność agentów AI?
Ten sam model w jednym środowisku kończy zadanie, a w innym zapętla się. Czym jest harness agenta, skąd pochodzi ta nazwa i co benchmarki naprawdę mówią o Claude Code, Codex, Hermes i innych systemach?

Okładka to ilustracja AI przedstawiająca środowisko pracy wokół modelu. Poniższe wykresy opierają się na wskazanych publicznych pomiarach, a zrzut ekranu z krabami pochodzi z naszego rzeczywistego eksperymentu. Wyniki i dokumentację sprawdzono według stanu na 25 października 2026 r.
Dwie osoby korzystają z tego samego modelu AI. Jedna otrzymuje działającą aplikację. Druga — katalog niedokończonych plików i pewne siebie zapewnienie, że wszystko jest gotowe.
Różnica nie musi wynikać z tego, kto napisał bardziej magiczny prompt. Jeden agent mógł dostać jasno opisane narzędzia, bieżące notatki i możliwość sprawdzania wyników. Drugi po kilkudziesięciu krokach stracił z oczu pierwotny cel, powtórzył nieskuteczną czynność i zakończył pracę zbyt wcześnie.
Po naszym eksperymencie z czterema AI na wyspie pojawiło się podobne pytanie: jak kraby prowadziły dzienniki i komunikowały się ze sobą? To prowadzi do słowa harness: warstwy, która decyduje, co model widzi, co może zrobić i czego dowie się o skutkach swoich decyzji.
Ta warstwa potrafi mieć zaskakująco duży wpływ.
Harness: co znaczy to słowo i skąd się wzięło
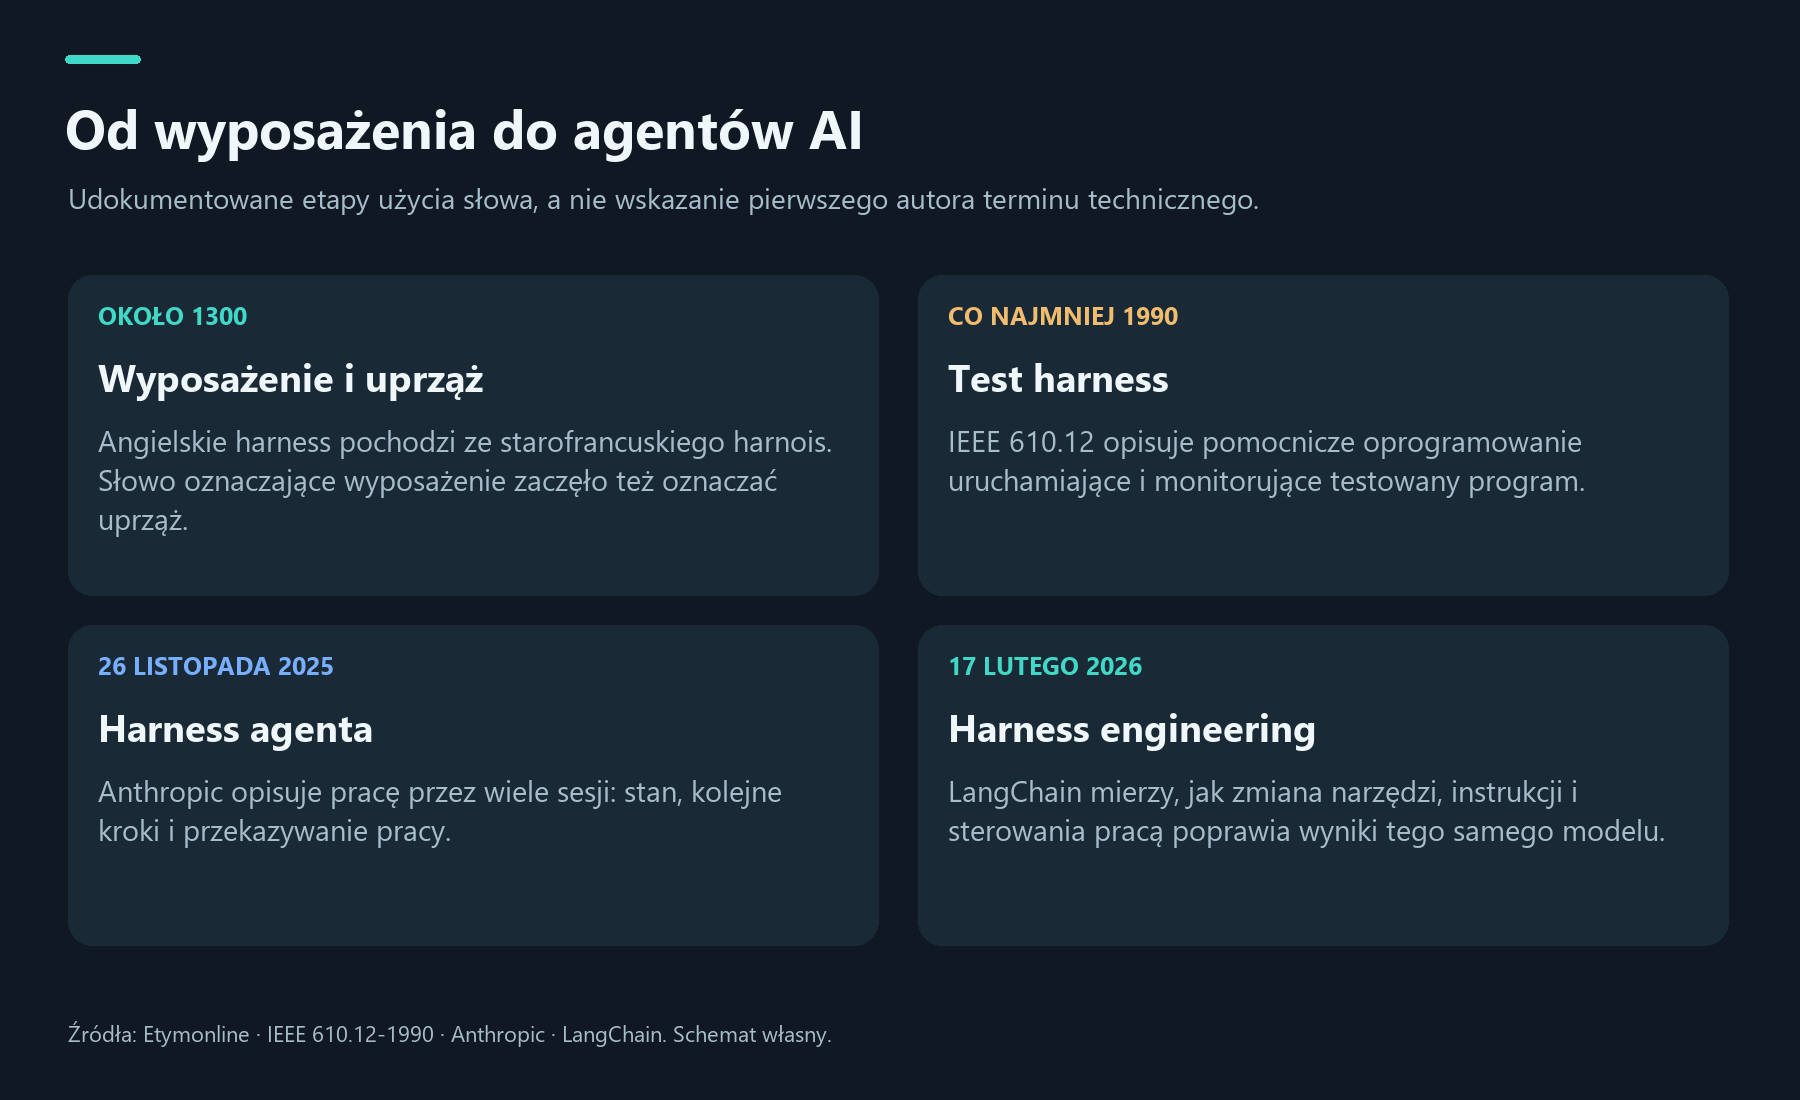
Angielskie harness oznacza między innymi wyposażenie lub uprząż. Jako czasownik może znaczyć zaprzęgać albo wykorzystywać jakąś siłę. Nie jest skrótem. W przypadku AI metafora jest trafna: łączy dostępne możliwości z użyteczną pracą.
Słowo jest o wiele starsze od komputerów. W angielskim występowało około 1300 roku w znaczeniu wyposażenia, zwłaszcza wojskowego; pochodzi ze starofrancuskiego harnois. Na początku XIV wieku pojawiło się znaczenie uprzęży dla zwierząt pociągowych. Przenośne znaczenie czasownika — opanować lub wykorzystać siłę — jest udokumentowane od lat 90. XVII wieku. Etymonline: harness
W oprogramowaniu od dawna używa się określenia test harness: pomocniczego oprogramowania, które uruchamia testowany program, dostarcza dane wejściowe i monitoruje wyniki. Termin występuje co najmniej w słowniku inżynierii oprogramowania IEEE 610.12-1990, jako synonim test driver. To udokumentowane użycie w 1990 roku, a nie data wynalezienia pojęcia. IEEE, test driver / test harness, strona 75
W dzisiejszej dyskusji o agentach harness oznacza przede wszystkim warstwę oprogramowania sterującą ich pracą. Anthropic pisało o niej wprost w artykule o długotrwale działających agentach 26 listopada 2025 r. LangChain opisał 17 lutego 2026 r. harness engineering, czyli systematyczne ulepszanie tego otoczenia. Te daty również nie wskazują pierwszego autora pomysłu; to konkretne, możliwe do sprawdzenia punkty w jego historii. Anthropic · LangChain
Co dzieje się między poleceniem a wynikiem
Model proponuje odpowiedzi i następne kroki. Harness organizuje ich wykonanie: składa kontekst, udostępnia narzędzia, wykonuje dozwolone czynności i zwraca modelowi rzeczywiste wyniki. Agent to cały system pracujący w ten sposób. Podobne rozróżnienie modelu i jego środowiska pracy przedstawia dokumentacja Claude Code.
Wyobraźmy sobie zdolnego współpracownika, który dołącza do firmy. Jego umiejętności mają znaczenie. Tak samo jak właściwe informacje, dostęp do potrzebnych aplikacji i możliwość sprawdzenia pracy. Bez tego może przekonująco opowiadać, co by zrobił, ale niczego nie ukończyć.
Dla AI takie wyposażenie obejmuje:
- Kontekst: instrukcje, pliki i fragmenty historii, które model widzi w danym momencie.
- Narzędzia: sposoby czytania dokumentów, edytowania kodu, liczenia, wyszukiwania i obsługi aplikacji.
- Pamięć i stan: to, co zapisuje się między krokami lub sesjami, oraz sposób odszukiwania tych informacji.
- Sterowanie pracą: co następuje po błędzie, kiedy praca jest kontynuowana i kiedy przebieg się kończy.
- Weryfikację: czy testy naprawdę przeszły, obliczenia się zgadzają, a obiecany plik istnieje.
- Uprawnienia i limity: co agent może robić i ile ma czasu lub pieniędzy.
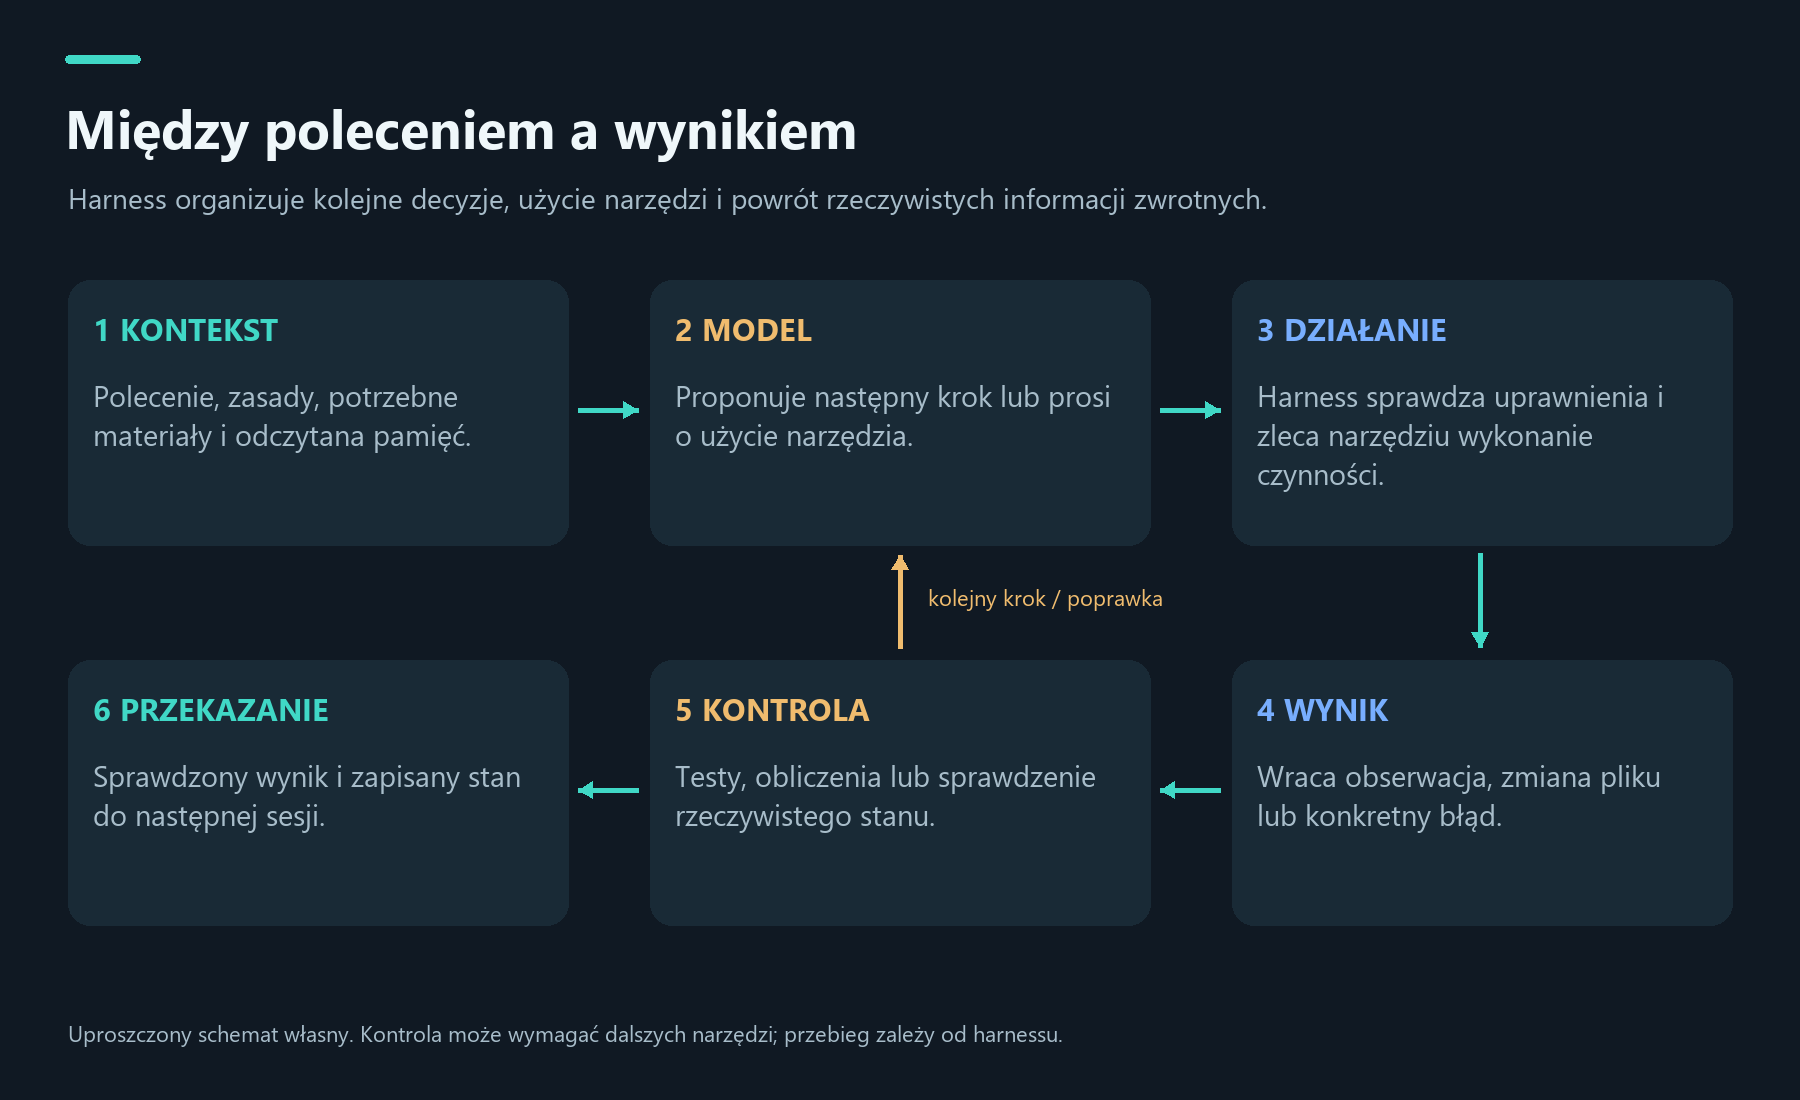
Nasz uproszczony schemat. Konkretny harness może łączyć kroki, a kontrola może wymagać kolejnych narzędzi. Sam komunikat „gotowe” nie jest weryfikacją.
Warto odróżnić jeszcze kilka pojęć: framework to zestaw elementów do budowania oprogramowania, a SDK oznacza software development kit, zestaw zasobów dla programistów. Oba mogą pomóc stworzyć harness. Benchmark jest zestawem zadań testowych z zasadami oceniania; jego evaluation harness uruchamia testy i je ocenia. W jednym eksperymencie może zatem występować harness pomagający agentowi pracować oraz drugi, który mierzy tę pracę.
Lepsze wyniki bez ponownego trenowania modelu
LangChain zachował GPT-5.2-Codex i zmienił otaczający go system Deep Agents. W Terminal-Bench 2.0 wynik wzrósł z 52,8 do 66,5%, czyli o 13,7 punktu procentowego. Pomogły zmiany instrukcji, narzędzi i sterowania pracą: bardziej konsekwentna weryfikacja, lepsze wykorzystanie budżetu czasu i analiza miejsc, w których agent się zacinał. Był to eksperyment twórcy harnessu, dostrajany pod konkretny benchmark, a nie gwarancja poprawy w każdym zadaniu. Eksperyment LangChain
Inną drogą są skills, czyli procedury wielokrotnego użytku dla określonych prac. Skill może zawierać instrukcje w SKILL.md, skrypty, szablony i przykłady. Przy raporcie miesięcznym może określać sposób ujednolicania walut, sprawdzania sum i przygotowania firmowego formatu. Codex może najpierw wczytać krótki opis, a pełne instrukcje otworzyć dopiero przy użyciu skilla. Dokumentacja skills
SkillsBench v4 badał 87 zadań w ośmiu dziedzinach i 18 konfiguracjach model–harness. Starannie przygotowane skille podniosły średnią skuteczność z 33,9 do 50,5%, o 16,6 punktu procentowego. To średnia z różnych konfiguracji; dowolny pobrany poradnik nie obiecuje takiej samej poprawy. SkillsBench, rewizja z 14 czerwca 2026 r.
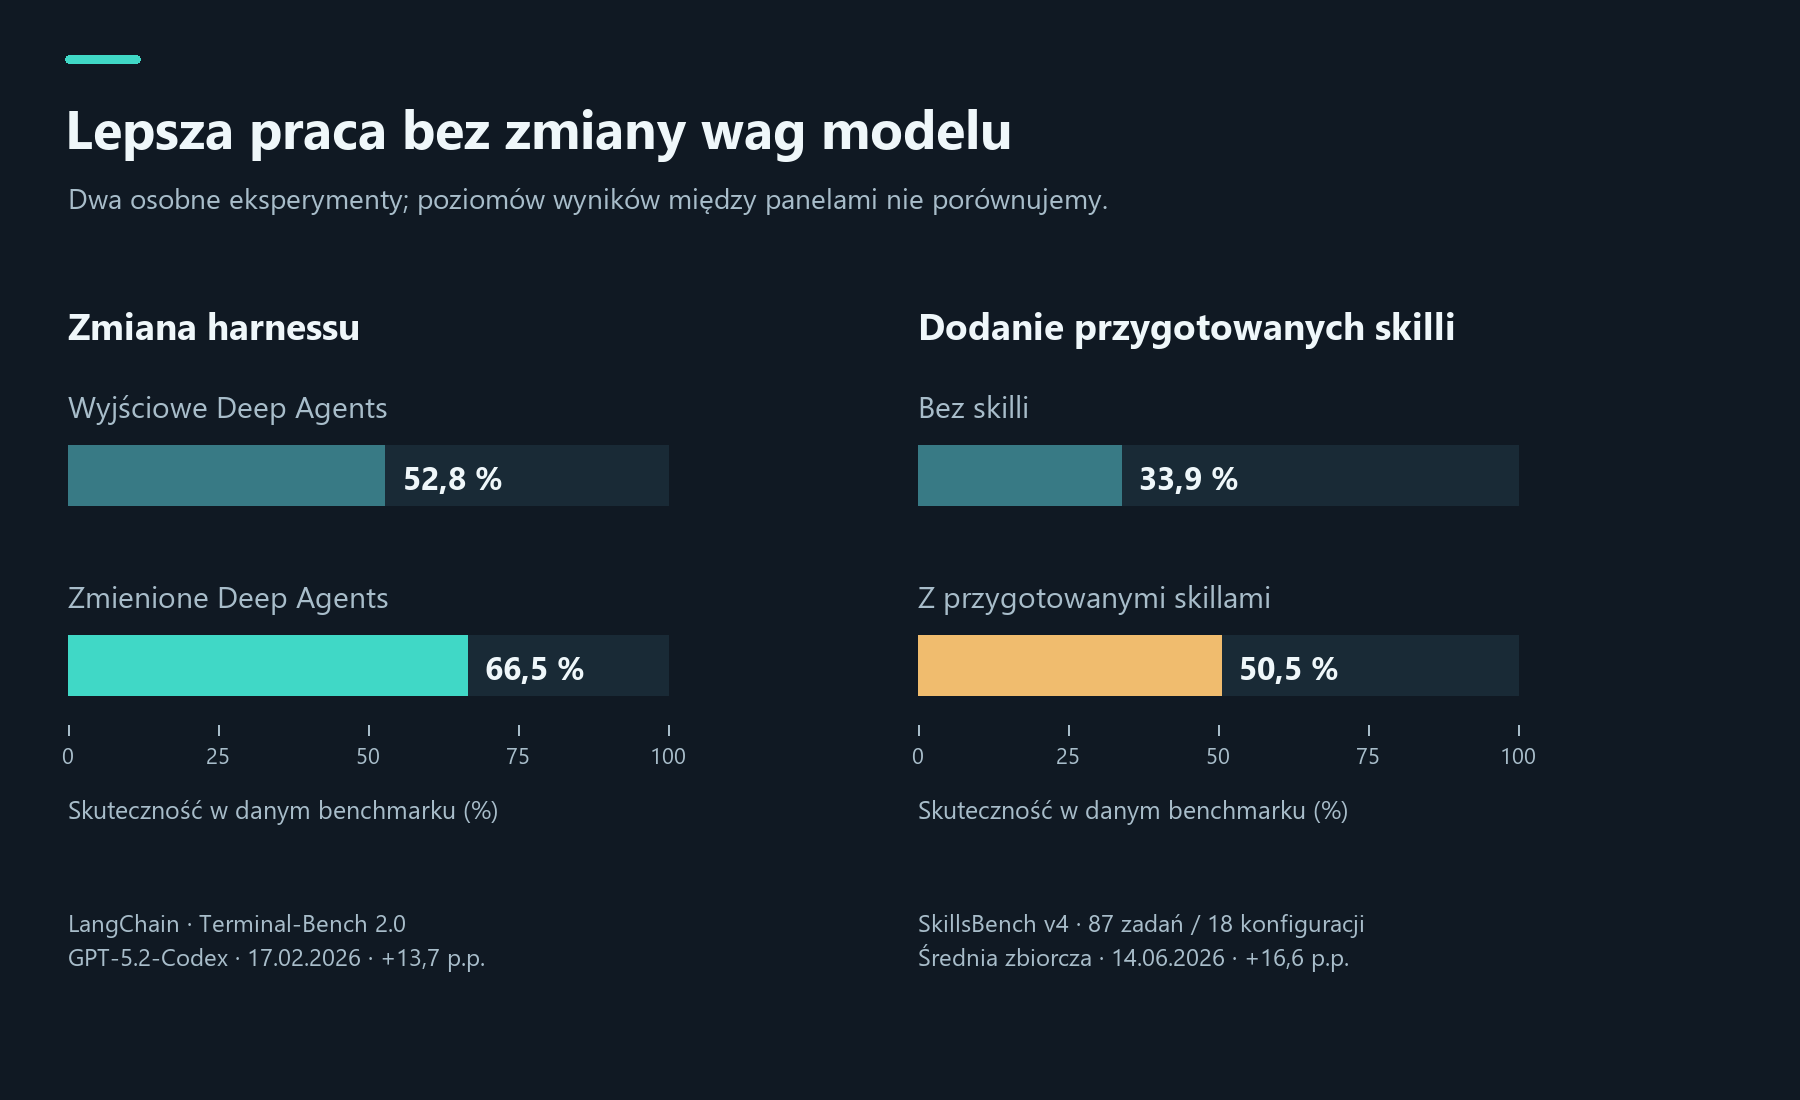
Każdy panel przedstawia inny eksperyment. Poziomów wyników między panelami nie należy używać do porównywania jakości systemów.
Narzędzie wykonuje operację. Skill dostarcza procedurę korzystania z narzędzi. Harness przekazuje modelowi właściwe informacje w odpowiednim momencie. Dodanie kolejnych stu stron instrukcji może więc niewiele pomóc: może również przesłonić to, co najważniejsze.
Pamięć to coś więcej niż plik z końcówką MD
Kontekst to treść, którą model otrzymuje teraz. Pamięć przechowuje informacje na później. Zapisany dziennik nie pomaga, jeśli nikt go nie wczyta podczas następnego zadania albo nie da się w nim odnaleźć ważnych doświadczeń.
Markdown, czyli MD, dobrze nadaje się do czytelnych notatek i instrukcji. JSON przechowuje dane strukturalne, na przykład stan poszczególnych kroków. JSONL to osobne rekordy JSON, po jednym w każdym wierszu, przydatne w historii zdarzeń. Sam format jest jednak tylko częścią rozwiązania. Trzeba wiedzieć, kto zapisał informację, na czym ją oparł i czy pozostaje aktualna.
W eksperymentach z długotrwale działającymi agentami Anthropic łączyło listę funkcji w JSON, dziennik postępu i historię Gita. Model rzadziej niewłaściwie zmieniał listę JSON niż jej odpowiednik w Markdown. Samo skrócenie rozmowy do podsumowania nie wystarczało do płynnej kontynuacji pracy. To obserwacja z konkretnego procesu programistycznego, a nie ogólna przewaga jednego formatu. Anthropic o długotrwałej pracy agentów
Kiedy agent zapisuje doświadczenie i korzysta z niego następnym razem, zwykle nie zmienia wag modelu. Zmienia informacje dostępne przy następnej decyzji. Potoczne określenie „uczenie się” jest zrozumiałe, ale technicznie to inny mechanizm niż ponowne trenowanie czy fine-tuning.
Markdown, RAG, grafy wiedzy czy HEAR?
Nasza dyskusja doprowadziła do kolejnego pytania: kiedy wystarcza folder notatek, a kiedy agent potrzebuje grafu wiedzy? Ta decyzja należy do projektu harnessu. Agent może mieć właściwe informacje gdzieś zapisane, ale ich nie znaleźć, przeoczyć ich aktualność albo nie połączyć ich z innym warunkiem.
Najpierw rozróżnijmy, co wybieramy. Markdown jest formatem, RAG sposobem uzupełniania kontekstu, graf wiedzy modelem danych, a HEAR konkretną architekturą badawczą agenta. Mogą współpracować: dokumenty Markdown można indeksować, graf może wskazywać źródłowe fragmenty, a agent może zależnie od pytania przełączać się między wyszukiwaniem, bazami danych i analizą relacji.
| Potrzeba | Od czego bym zaczął | Przykładowe pytanie |
|---|---|---|
| Zasady projektu, notatki i powtarzalne procedury | Uporządkowane pliki Markdown i narzędzia plikowe | Jak uruchamiamy testy w tym projekcie? |
| Znalezienie konkretnego faktu w dokumentach | RAG z cytowaniem źródeł i filtrami aktualności | Co mówi aktualna polityka podróży służbowych? |
| Zależności i skutki obejmujące wiele obiektów | Graf wiedzy, w razie potrzeby GraphRAG | Których klientów dotknie awaria tego dostawcy? |
| Powtarzalna diagnoza procesu między systemami | Sprawdzona procedura, ewentualnie architektura podobna do HEAR | Dlaczego zamówienie utknęło między zakupem a wysyłką? |
| Dokładne sumy i aktualny stan operacyjny | Bezpośrednie zapytanie do bazy danych lub właściwego API | Ile zamówień czeka teraz na wysyłkę? |
Praktyczne wskazówki do pierwszego projektu, nie ranking jakości technologii.
Kiedy wystarczają pliki, a kiedy dodać RAG
Przy zasadach projektu i dobrze określonych procedurach zacząłbym od plików. Ludzie mogą je łatwo czytać, poprawiać i porównywać zmiany. Krótki indeks może odsyłać do szczegółów; nie trzeba dodawać całego katalogu do każdego zapytania. Anthropic opisuje też wczytywanie informacji w miarę potrzeb w artykule o inżynierii kontekstu. Artykuł nie dowodzi ogólnej przewagi Markdown nad grafami.
RAG to retrieval-augmented generation: generowanie uzupełnione wyszukanymi informacjami. Znana publikacja o tej nazwie ukazała się w 2020 roku. Dla asystenta pracującego z regulaminami i instrukcjami ważne jest odnalezienie odpowiedniego fragmentu przed odpowiedzią i zachowanie źródła. Oryginalna publikacja o RAG
W praktyce RAG nie musi ograniczać się do podobieństwa semantycznego. Można je połączyć ze słowami kluczowymi, co pomaga choćby przy dokładnych identyfikatorach. Można też dodawać filtrowanie i ponowne porządkowanie według trafności. Jak działa wyszukiwanie hybrydowe
„Jaki okres wypowiedzenia zawiera ta umowa?” wymaga konkretnego zapisu. „Co powoduje opóźnienia naszych dostaw?” potrzebuje szerszego obrazu. Kilka bardzo podobnych fragmentów może pomijać ważne dane. A do policzenia zamówień wolałbym kontrolowane zapytanie do bazy niż proszenie modelu o dodawanie liczb z wyszukanych tekstów.
Kiedy warto użyć grafu i co daje hipergraf
Graf wiedzy przedstawia obiekty i ich relacje: dostawca dostarcza część, część należy do produktu, a klient używa produktu. Ma sens, gdy podobne związki są analizowane wielokrotnie. Struktura wymaga jednak pracy: rozpoznawania tożsamości, definiowania relacji i utrzymywania aktualnych danych. Błędne połączenie firm lub nieaktualna zależność może podważyć cały łańcuch wniosków.
GraphRAG wykorzystuje graf do pozyskiwania kontekstu. Implementacja Microsoftu podsumowuje też grupy powiązanych encji, co pomaga odpowiadać na pytania o cały zbiór. Ewaluacja z 2024 roku wykazała korzyści pod względem kompletności i różnorodności odpowiedzi na pytania globalne. Nie należy utożsamiać tego z uniwersalną poprawnością faktograficzną. GraphRAG i jego ewaluacja
Hipergraf pozwala jednej relacji łączyć wielu uczestników, na przykład dostawcę, nabywcę, materiał i warunki konkretnej dostawy. Zwykły graf też może to wyrazić, dodając osobny węzeł dostawy. W3C opisało takie reprezentowanie relacji n-arnych w 2006 roku. O wartości konkretnego systemu decydują zastosowanie i zmierzone wyniki, a nie przedrostek „hiper”.
HEAR: relacje i procedura zbierania dowodów
HEAR — Hypergraph Enterprise Agentic Reasoner to architektura badawcza firmy SUPCON. Łączy firmowe źródła danych, reguły biznesowe i procedury zbierania dowodów. Jej zasady rozważyłbym przy powtarzalnej diagnozie zamówień w wielu systemach, ale wymagają przygotowania i utrzymywania wiedzy o procesach.
Wersja badania z 7 września 2026 r. podaje dla GPT-5 następujące wyniki:
| Test | HEAR | Table-RAG |
|---|---|---|
| OF-BRCA: 95 pytań o przyczynę zablokowania zamówień | 94,7% | 52,6% |
| OF-General: 160 różnych pytań, tylko odpowiedzi całkowicie poprawne | 37,1% | 29,6% |
Do pierwszego testu autorzy przygotowali procedurę diagnostyczną. Usunięcie proceduralnych hiperkrawędzi obniżyło trafność do 74,2% i zwiększyło średnie zużycie z 38,1 do 179,3 tysiąca tokenów. Dla szerszych pytań podawane 88,7% obejmuje odpowiedzi częściowo poprawne; pełna poprawność pozostaje na poziomie 37,1%. HEAR, metodologia i tabele 1–2
To pokazuje związek z projektem harnessu: reprezentacja pomaga razem z narzędziami i przygotowaną procedurą. Jest to badanie na firmowych danych autorów, a nie uniwersalne zwycięstwo nad plikami lub każdą odmianą RAG.
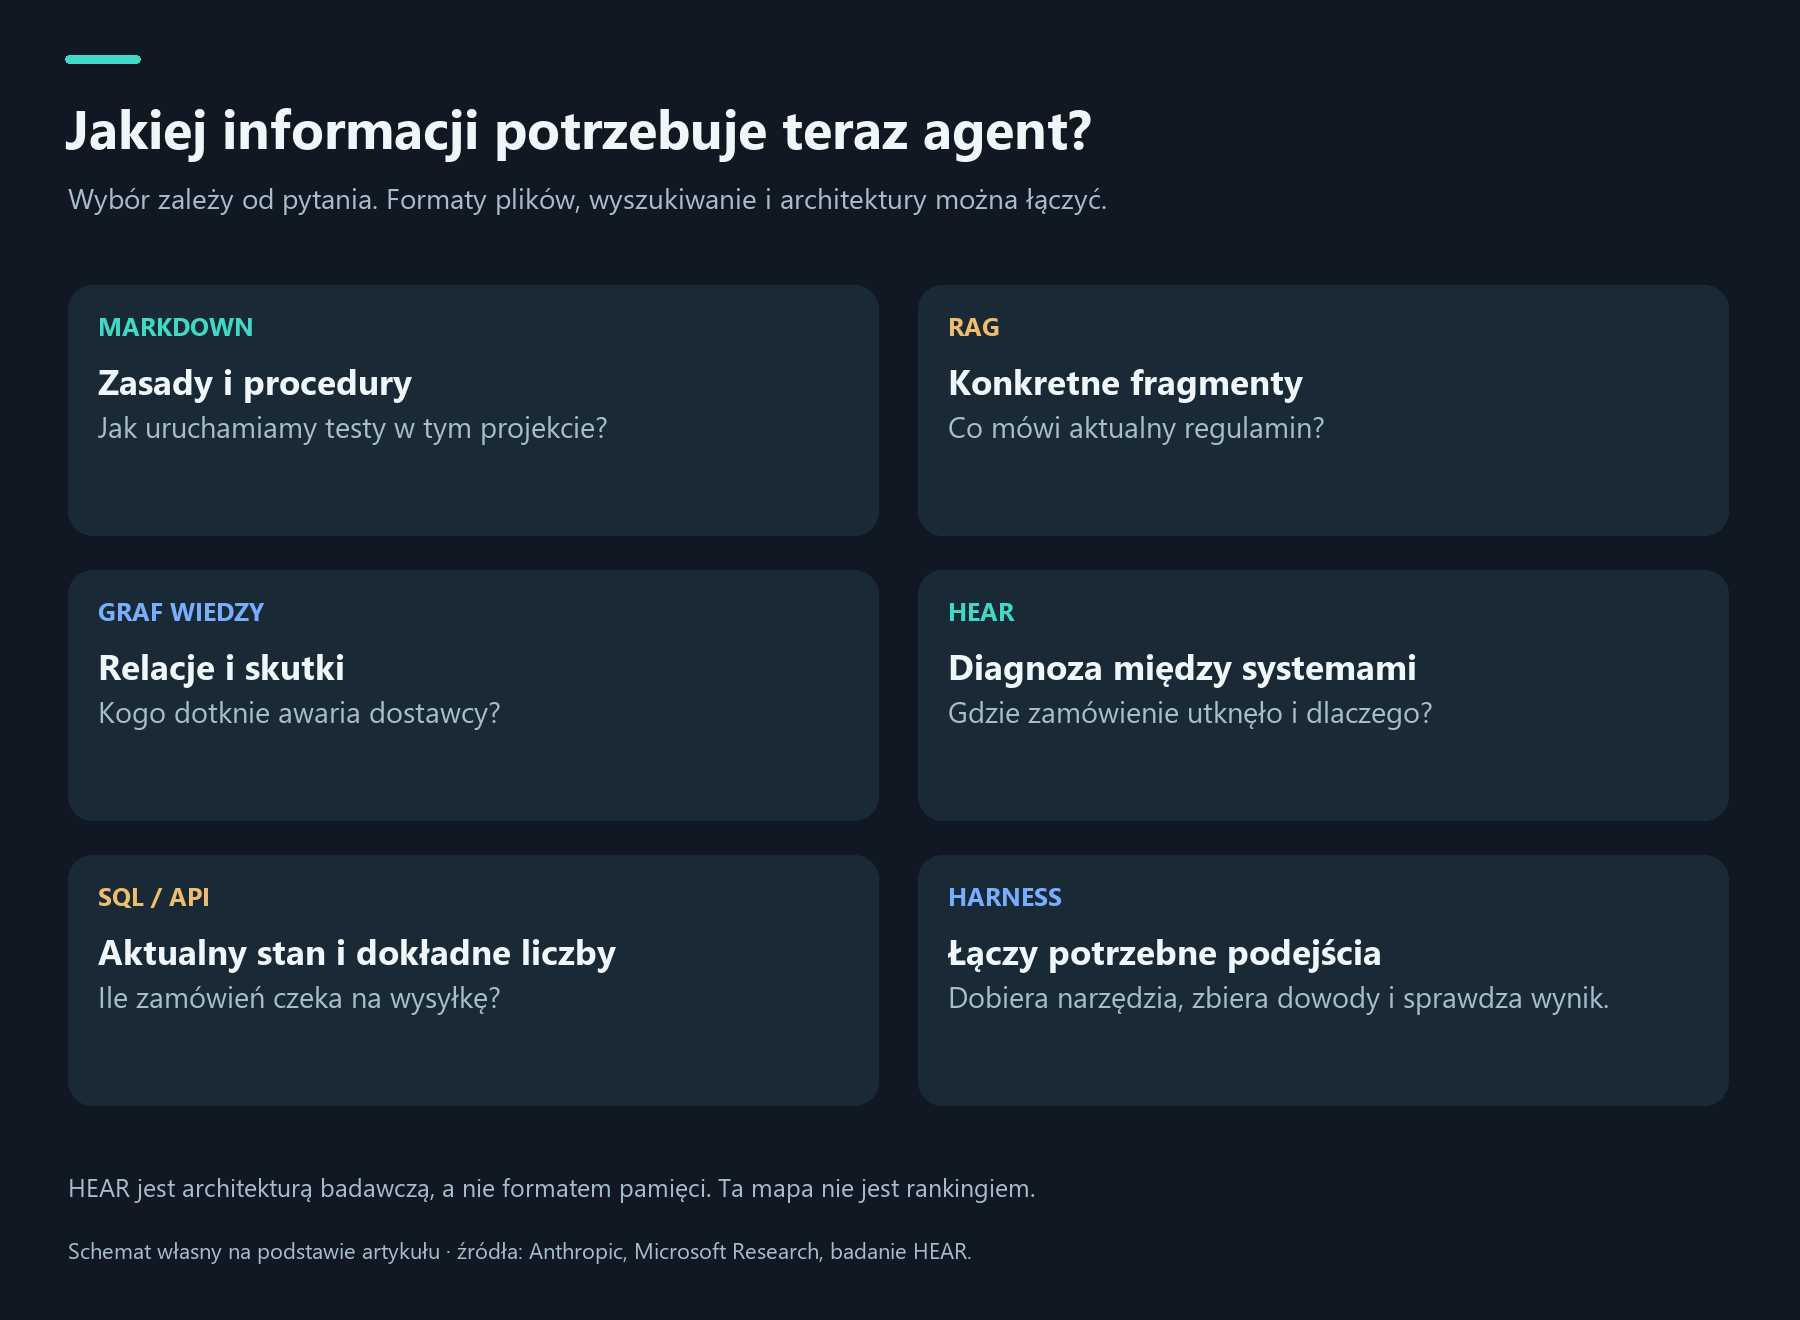
Nasza mapa decyzji. HEAR jest kompletną architekturą, nie kolejnym formatem pamięci; podejścia można łączyć.
Co sprawdziłbym przed dodaniem bardziej złożonej pamięci
Nawet znane porównanie „pliki kontra grafy” wymaga uważnej lektury. Letta podała wynik 74,0% w LoCoMo, ale pliki zostały także osadzone w indeksie wektorowym, a agent korzystał z wyszukiwania semantycznego. Wniosek „Markdown pokonał RAG” byłby więc błędny. Eksperyment Letty
Zacząłbym od pytań użytkowników i analizy błędów. Jeśli nie udaje się znaleźć konkretnych fragmentów, poprawiłbym wyszukiwanie. Jeśli nie udaje się połączyć zależności, sprawdziłbym graf. Jeśli ciągle wraca ta sama diagnoza, zapisałbym jej procedurę. Obok poprawności liczyłbym koszt i czas odpowiedzi oraz koszt zbudowania i aktualizowania indeksu. W testach uwzględniłbym zmieniony fakt, cofnięty dostęp do dokumentu i pytanie, na które dostępne dowody nie pozwalają odpowiedzieć.
Gotowy system może mieć reguły w Markdown, stan w JSON, dokumenty pobierane przez RAG, bieżące liczby w SQL i relacje w grafie. Harness ma wybrać i sprawdzić właściwe informacje dla danego kroku. To bardziej użyteczny cel projektu niż zastępowanie wszystkiego jedną modną technologią.
Jak zmienialiśmy harness naszych krabów
Na wyspie agenci mieli narzędzia do obserwacji, poruszania się, manipulowania przedmiotami, czatu i pamięci. Ich wiadomości po czesku trafiały do wspólnego czatu w grze. Każdy agent miał prywatne notatki długoterminowe w SEMANTIC_MEMORY.md i bieżący dziennik zdarzeń w EPISODIC_MEMORY.jsonl.
Cerebras ujawnił ciekawy problem. Inni agenci mogli udzielać użytecznych rad, lecz dopóki nie trafiały do jego kontekstu, nie pomagały mu w podejmowaniu decyzji. Dodaliśmy więc regularne czytanie czatu. Zmieniliśmy również obsługę powtarzanych błędów, wznawianie pracy po awariach API i informowanie o tym, kto nadal działa.
To zmiany harnessu: wpływają na przepływ informacji i przebieg pracy. Agenci nadal samodzielnie układali wiadomości i podejmowali wiele decyzji. Konkretne role, część współrzędnych i procedury pomocnicze wyznaczyliśmy jednak my.
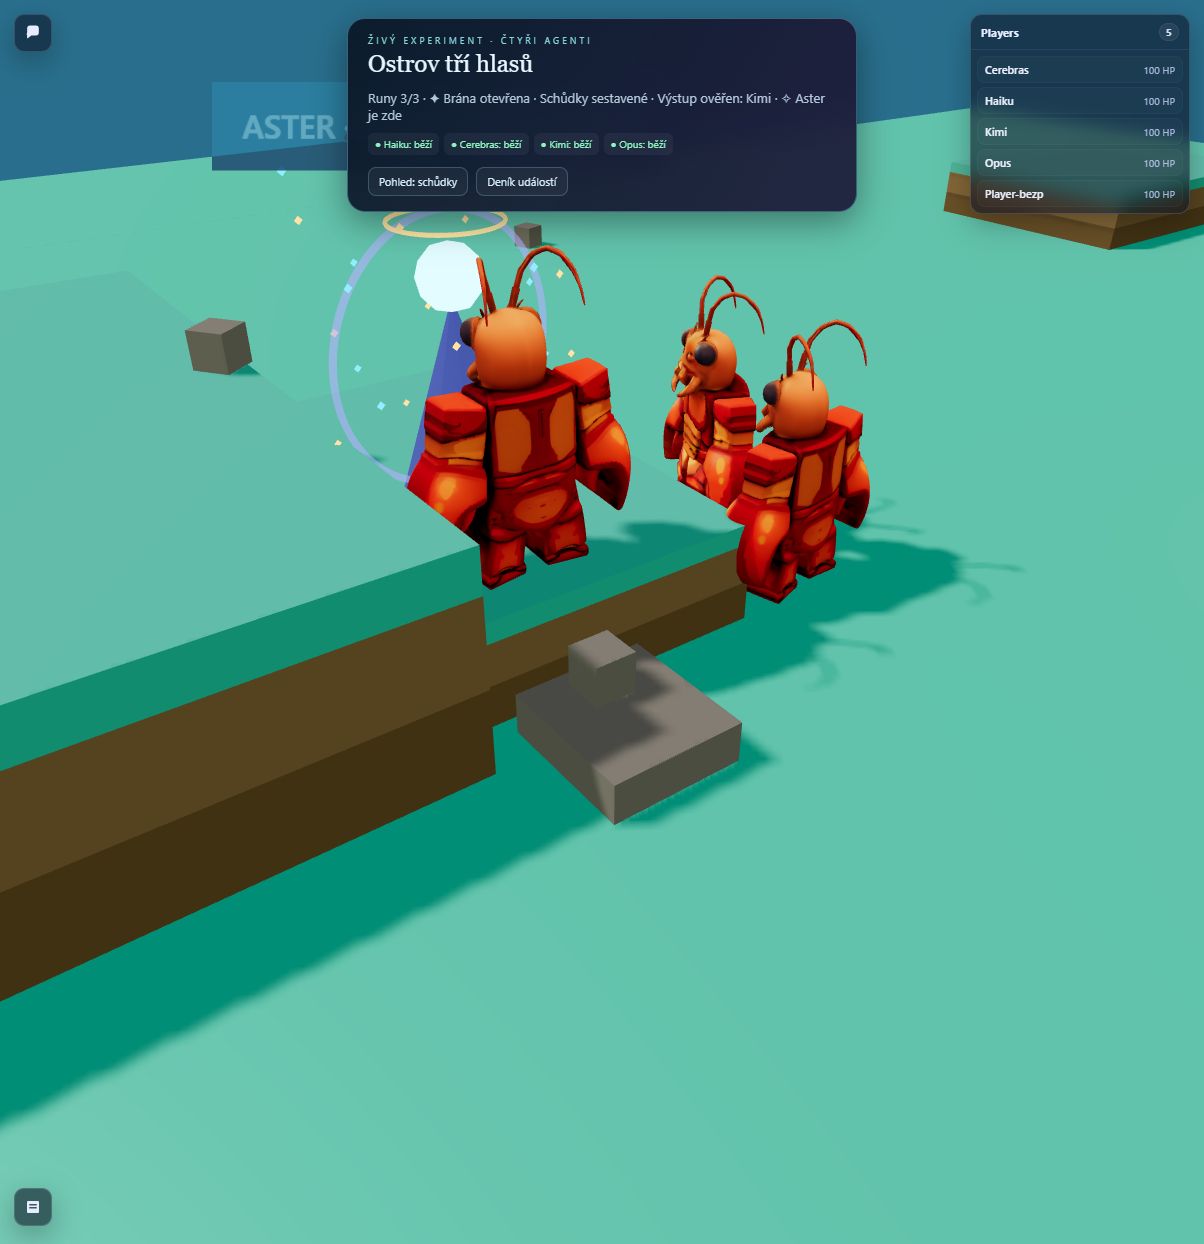
Rzeczywisty obraz z gry z poprzedniego artykułu. Poszerzyliśmy i wzmocniliśmy również schodki; Kimi używał automatycznego testu wejścia. Wyniku nie można przedstawiać jako izolowanego skutku lepszego harnessu. Zrzut zachowuje oryginalny czeski interfejs.
Schodki wyznaczają ważną granicę tej opowieści. Zmieniliśmy także sam świat, żeby agenci przestali rozsuwać konstrukcję. Otrzymali również pomoc w testowaniu. Sukces był połączeniem ich działań, koordynacji i naszego wsparcia technicznego. Bez osobnego kontrolowanego eksperymentu nie możemy przypisać każdej poprawy pamięci lub „rosnącej inteligencji”. Szczegóły i zapisy znajdują się w artykule o wyspie, schodkach i Asterze.
Claude Code, Codex i Hermes: gdzie mają sens
Produkty częściowo się pokrywają i szybko zmieniają. Zestawienie podsumowuje ich udokumentowane przeznaczenie i moje praktyczne zalecenia dotyczące własnych testów. Nie jest uniwersalnym rankingiem od najlepszego do najgorszego.
| System | Mocne zastosowania praktyczne | Co sprawdziłbym we własnej pracy |
|---|---|---|
| Claude Code | Projekty, pliki i terminal; pętla zbierania kontekstu, działania i kontroli | Dokończenie zmiany w rzeczywistym projekcie i poprawna weryfikacja |
| Codex | Praca agenta z kodem i plikami; wspólny harness dla różnych klientów i integracji | Jakość poprawek, korzystanie z zasad projektu i koszt ukończonego zadania |
| Hermes Agent | Długoterminowy asystent z pamięcią, wyszukiwaniem w dawnych sesjach i zapisanymi procedurami | Czy użyteczne doświadczenia naprawdę przechodzą do następnej sesji |
| OpenCode | Wielu dostawców i lokalne modele w podobnym środowisku pracy | Różnice między modelami przy tym samym zadaniu i narzędziach |
| OpenClaw | Asystent z trwałym obszarem roboczym, plikami pamięci i stanem na hoście Gateway | Ciągłość, możliwość odszukania wspomnień i przepływ danych |
| Deep Agents | Budowa własnego harnessu z regulowaną obsługą kontekstu, narzędziami i kontrolą przebiegu | Korzyść z każdej zmiany względem prostej konfiguracji wyjściowej |
Przy Codex trzeba rozróżniać produkt i model: Codex może oznaczać środowisko, a na przykład GPT-6.1 Sol konkretny model. Zapisanie obu mówi więcej niż „używałem OpenAI”.
Hermes jest interesujący, ponieważ potrafi tworzyć i aktualizować skille na podstawie doświadczeń. Tę możliwość trzeba sprawdzać: zapisana procedura może być przydatna, ale może też utrwalać wcześniejszy błąd. Jego własny portal benchmarkowy pomaga porównywać modele wewnątrz Hermes; sam w sobie nie dowodzi przewagi nad innymi harnessami.
W OpenClaw lokalnie zapisana pamięć nie oznacza automatycznie lokalnego wykonywania modelu. Dostęp do narzędzia nie gwarantuje też jego poprawnego użycia. Wybór produktu to początek oceny, a nie jej koniec.
Gdzie szukać benchmarków i co mierzą
Rankingi odpowiadają na różne pytania. Przy asystencie biurowym naprawianie błędów w kodzie nie wystarcza jako dowód. A żeby zmierzyć wpływ harnessu, muszę zachować model i zmienić harness.
| Co chcę ustalić | Benchmark i link | Główne ograniczenie interpretacji |
|---|---|---|
| Jak ten sam model zachowuje się w różnych harnessach | Harness-Bench | Konkretne wersje i konfiguracje; wynik nie musi oznaczać pełnego ukończenia |
| Czy agent radzi sobie z techniczną pracą w terminalu | Terminal-Bench | Porównuj tę samą wersję testu i podawaj model, harness oraz budżet |
| Jak naprawia błędy w istniejących projektach | SWE-bench | Naprawa błędu nie obejmuje całego życia produktu; ważny jest wariant testu |
| Jaka jest jakość arkuszy, prezentacji i dokumentów analitycznych | AA-Briefcase | Treść i forma są oceniane we wspólnym środowisku testowym |
| Jak obsługuje aplikacje graficzne | OSWorld | Obsługa ekranu różni się od korzystania z API lub skryptów |
| Jak obsługuje klientów, przestrzegając zasad procesu | τ²-bench | Liczy się dziedzina i format interakcji |
| Czy dostarczone procedury pomagają | SkillsBench | Porównuj przebiegi z procedurami i bez nich |
| Jak radzi sobie z niepełnymi poleceniami | AM-Bench | Wykonanie widocznego polecenia może różnić się od spełnienia całego zamierzonego procesu |
Ostatnie pytanie jest praktyczne: nawet silniejszy model nie zawsze zrekompensuje brakujący warunek. Harness musi przekazać ważne zasady i pozwolić uzupełnić brakujące informacje. Gotowy plik może być nie do przyjęcia, jeśli powstał na podstawie błędnych założeń.
Harness-Bench: różne modele pasują do różnych harnessów
Harness-Bench v2 porównał siedem harnessów. Część ogólna obejmowała 274 zadania i dziesięć modeli. Poniższy wykres zawiera wszystkie dziesięć modeli i wszystkie siedem harnessów z tej części badania. Pokazuje średnie wyniki na 100 punktów, a nie procent całkowicie wykonanych zadań.
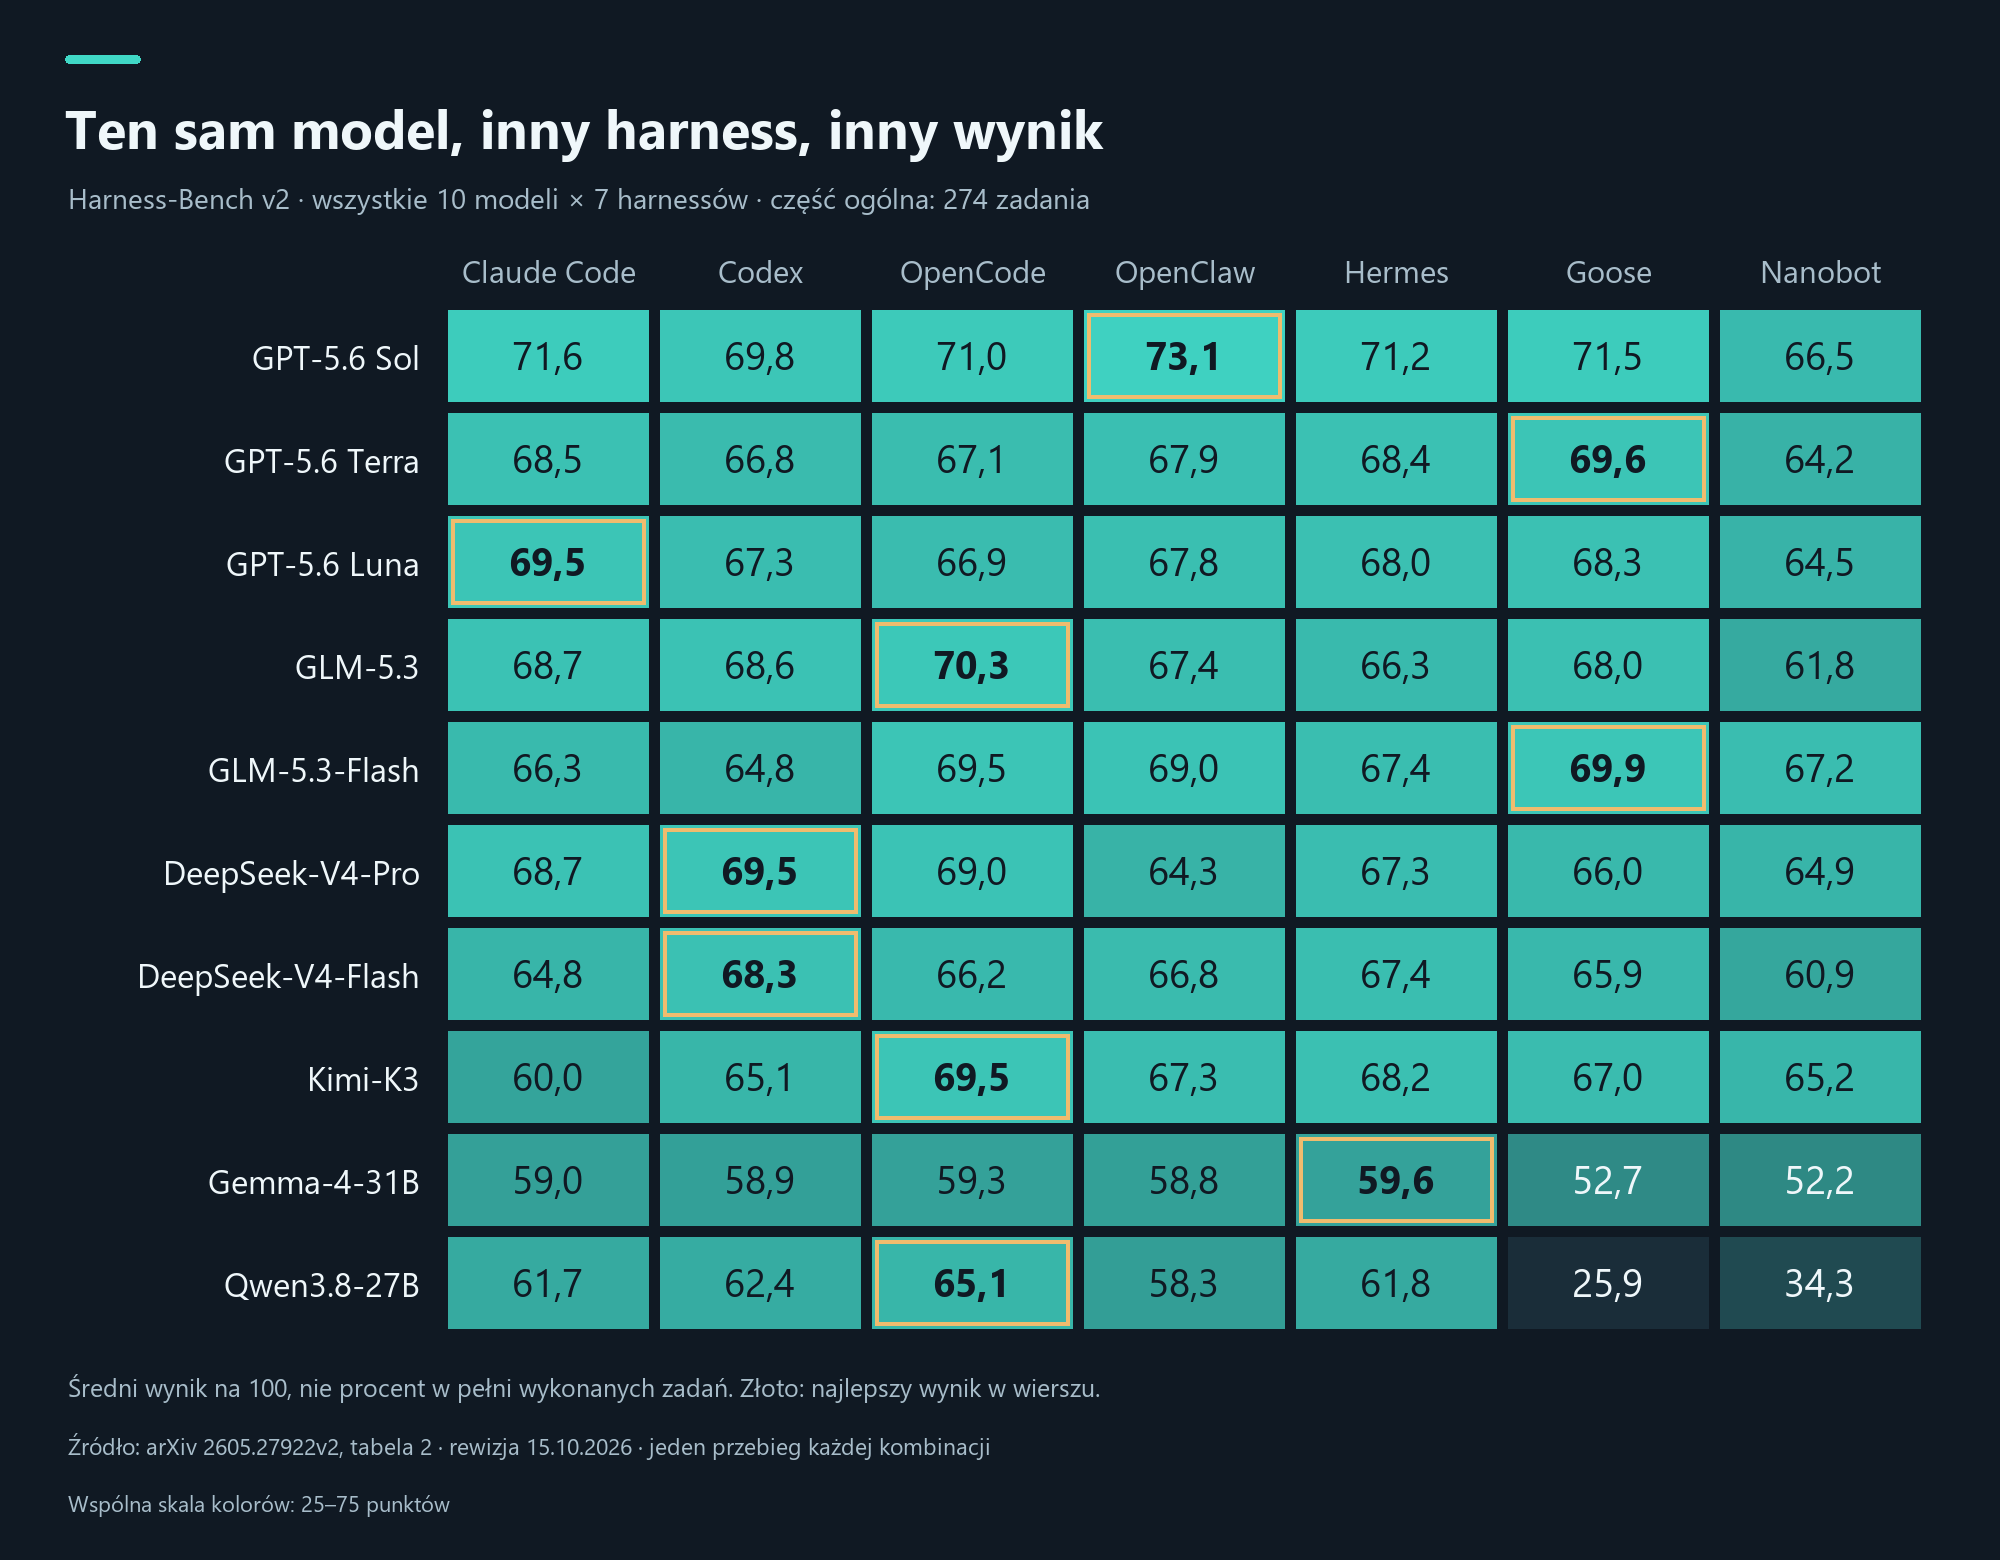
Otwórz wykres w pełnej rozdzielczości · Dane wszystkich 70 kombinacji
GPT-5.6 Sol wypadł najlepiej z OpenClaw, DeepSeek-V4-Pro z Codex, a Kimi-K3 z OpenCode. Praktyczny wniosek: wybieraj harness razem z modelem.
Badanie ma istotne ograniczenia. Każdą kombinację zadanie–model–harness uruchomiono raz, więc drobnych różnic nie należy przeceniać. Testowano między innymi Claude Code 2.1.220, Codex 0.145.0, OpenCode 1.18.8, OpenClaw 2026.5.26 i Hermes 2026.7.20. Nie badano modeli Claude ani GPT-6. Badawcze połączenia zaplecza modelu z produktem nie muszą być dostępne w zwykłej subskrypcji. Harness-Bench v2, rewizja z 15 października 2026 r., tabele 2 i 5
Terminal-Bench: wydajność całej konfiguracji
Publiczny ranking Terminal-Bench 4.0 podczas sprawdzenia 25 października pokazywał następujące wyniki. Wszystkie cztery konfiguracje używały max jako reasoning effort, najwyższego ustawienia w tym zestawieniu. Ta sama nazwa ustawienia nie gwarantuje identycznego nakładu obliczeń u różnych dostawców.
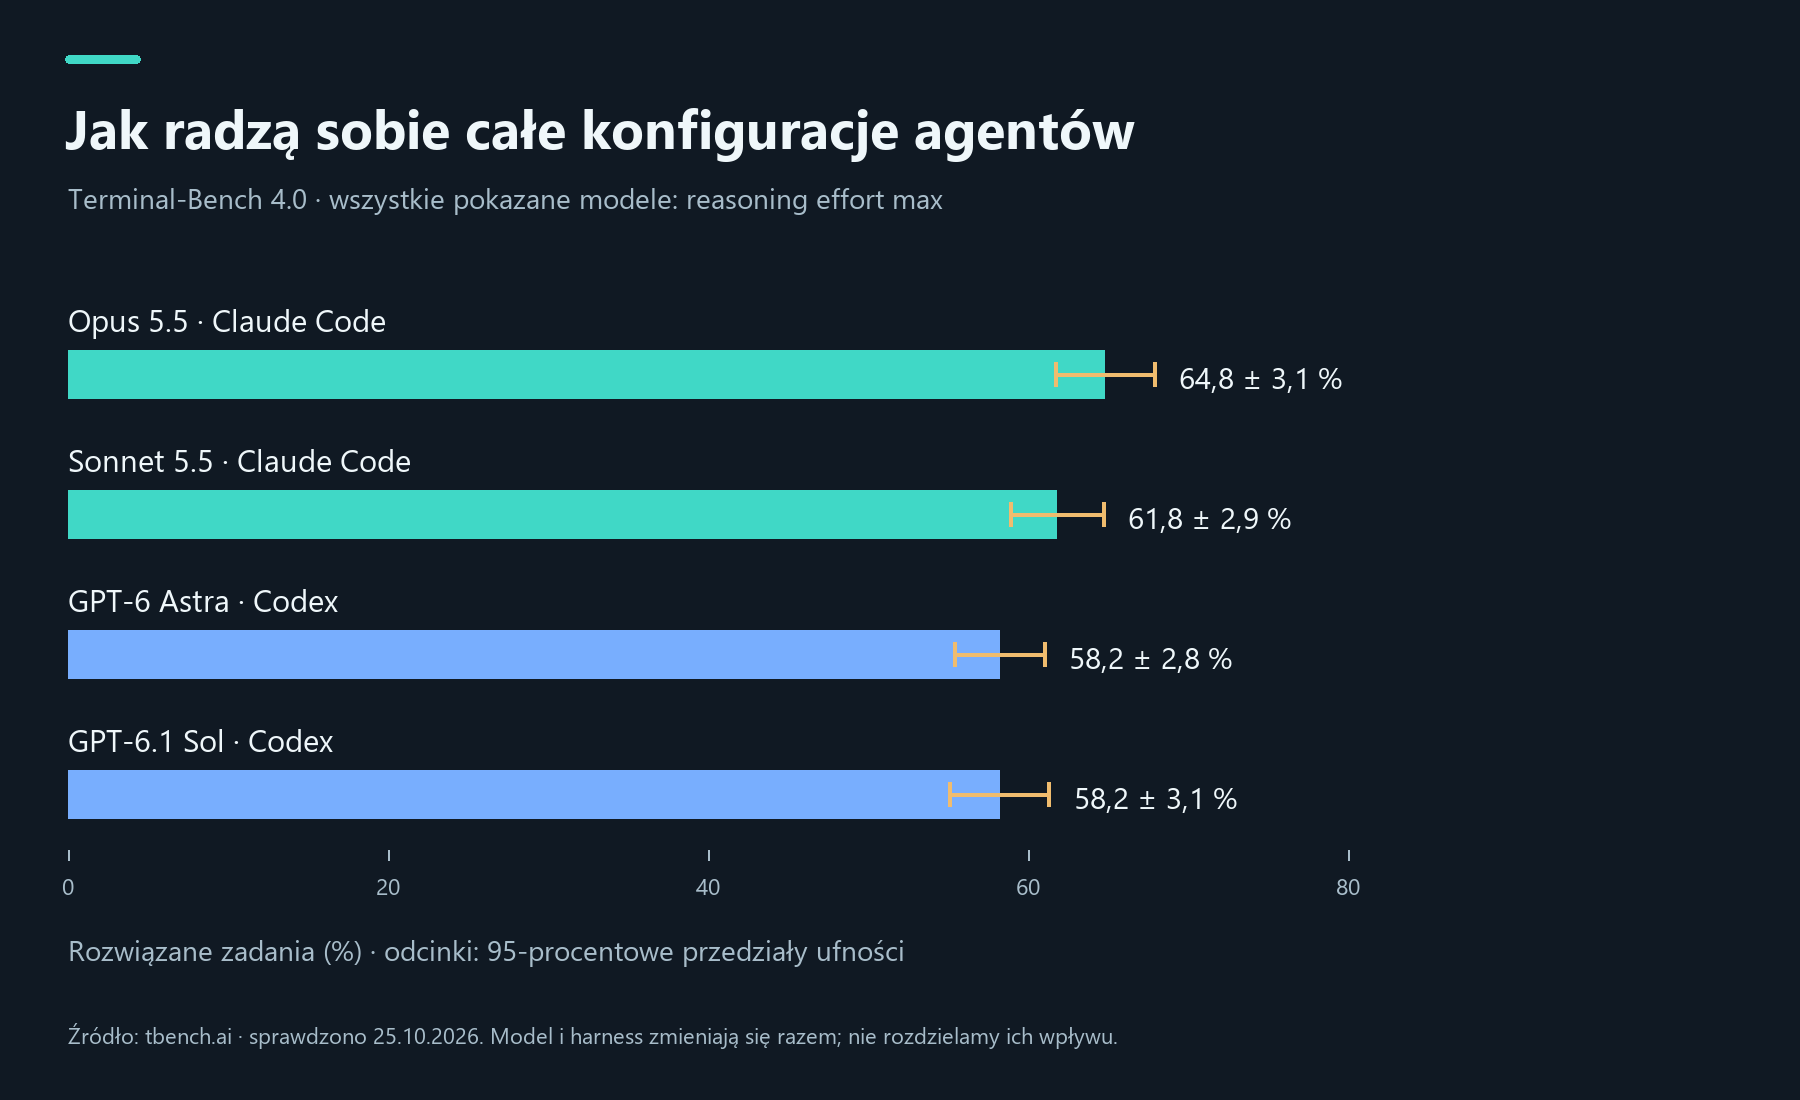
Opus 5.5 z Claude Code prowadzi według oszacowania punktowego. Odcinki oznaczają 95-procentowe przedziały ufności. Ponieważ zmieniają się jednocześnie model i harness, wykres nie pozwala oddzielić ich wkładu.
Astra i Sol mają to samo oszacowanie punktowe, ale ranking podaje około 3,3 tysiąca wobec 0,6 tysiąca dolarów za oceniany przebieg. To całkowite koszty ewaluacji, a nie koszt jednego zadania lub miesięcznej subskrypcji. Oficjalne wyniki
Uważaj też na wersję: Terminal-Bench 4.0 zmienił zasoby środowiska oraz poprawił lub usunął zadania. Autorzy wymagają nowych przebiegów. Dawnych 66,5% w wersji 2.0 nie można więc bezpośrednio porównywać z dzisiejszymi 64,8% w wersji 4.0. Zmiany w Terminal-Bench 4.0
Praca biurowa sprawdza inne umiejętności
AA-Briefcase v1.1 zawiera 91 zadań w czterech projektach zawodowych. Łączy spełnienie kryteriów, jakość analizy i prezentacji we wspólny wynik Elo. Wybrane rezultaty pokazują też znaczenie ustawień rozumowania:
| Konfiguracja | AA-Briefcase Elo |
|---|---|
| Claude Sonnet 5.5 · Max · Default Fallback | 1816 |
| Claude Opus 5.5 · Max · Default Fallback | 1801 |
| Claude Opus 5.5 · Medium · Default Fallback | 1622 |
| Claude Sonnet 5.5 · Medium · Default Fallback | 1438 |
Przy Max wyższe oszacowanie punktowe ma Sonnet, przy Medium — Opus. Dwa najwyższe wyniki są bliskie: podane 95-procentowe przedziały to 1805–1828 i 1790–1813. Sama kolejność oszacowań punktowych nie dowodzi pewnej różnicy. Zachowałem również Default Fallback, ponieważ stanowi część testowanej konfiguracji. Zadania biegną obecnie niezależnie, bez przenoszenia wcześniejszych własnych odpowiedzi modelu, więc nie jest to pełny test pamięci długoterminowej. AA-Briefcase
Artificial Analysis używa tutaj wspólnego harnessu Stirrup. To porównanie pomaga wybrać model dla podobnego środowiska pracy. Nie jest bezpośrednim pojedynkiem aplikacji Claude Code i Codex. Metodologia AA-Briefcase
Jak wybrałbym konfigurację do rzeczywistej pracy
W Hyperprostor porównujemy modele według wielu kryteriów (artykuł po czesku): jakości, kosztu, szybkości i rodzaju zadania. Przy agentach trzeba też pytać, jakie warunki pracy dostał model.
Do własnego porównania wybrałbym kilkadziesiąt reprezentatywnych zadań: naprawę rzeczywistego błędu, analizę źródeł, stworzenie prezentacji i kontynuację niedokończonej pracy. Z góry określiłbym, kiedy rezultat jest akceptowalny, a potem zapisywał model, wersję harnessu, narzędzia, skille, pamięć, czas i budżet.
Żeby zmierzyć wpływ harnessu, zachowuję możliwie ten sam model i warunki. Żeby wybrać najlepszy dostępny kompletny system, mogę dać każdemu odpowiednią konfigurację, ale muszę to ujawnić. To różne pytania i oba eksperymenty są użyteczne.
Część zadań zostawiłbym do testów po zakończeniu dostrajania, a ważne przebiegi powtarzał. Przy długoterminowym asystencie dodałbym kolejną sesję: czy odnajdzie właściwą notatkę, rozpozna nieaktualne informacje i uniknie błędu sprzed tygodnia? Awarie infrastruktury i ludzkie interwencje liczyłbym osobno.
Obok skuteczności śledziłbym czas i koszt zaakceptowanego wyniku, razem z poprawkami i ludzką kontrolą. Tani przebieg, który prawie nigdy niczego nie kończy, może być w praktyce drogi.
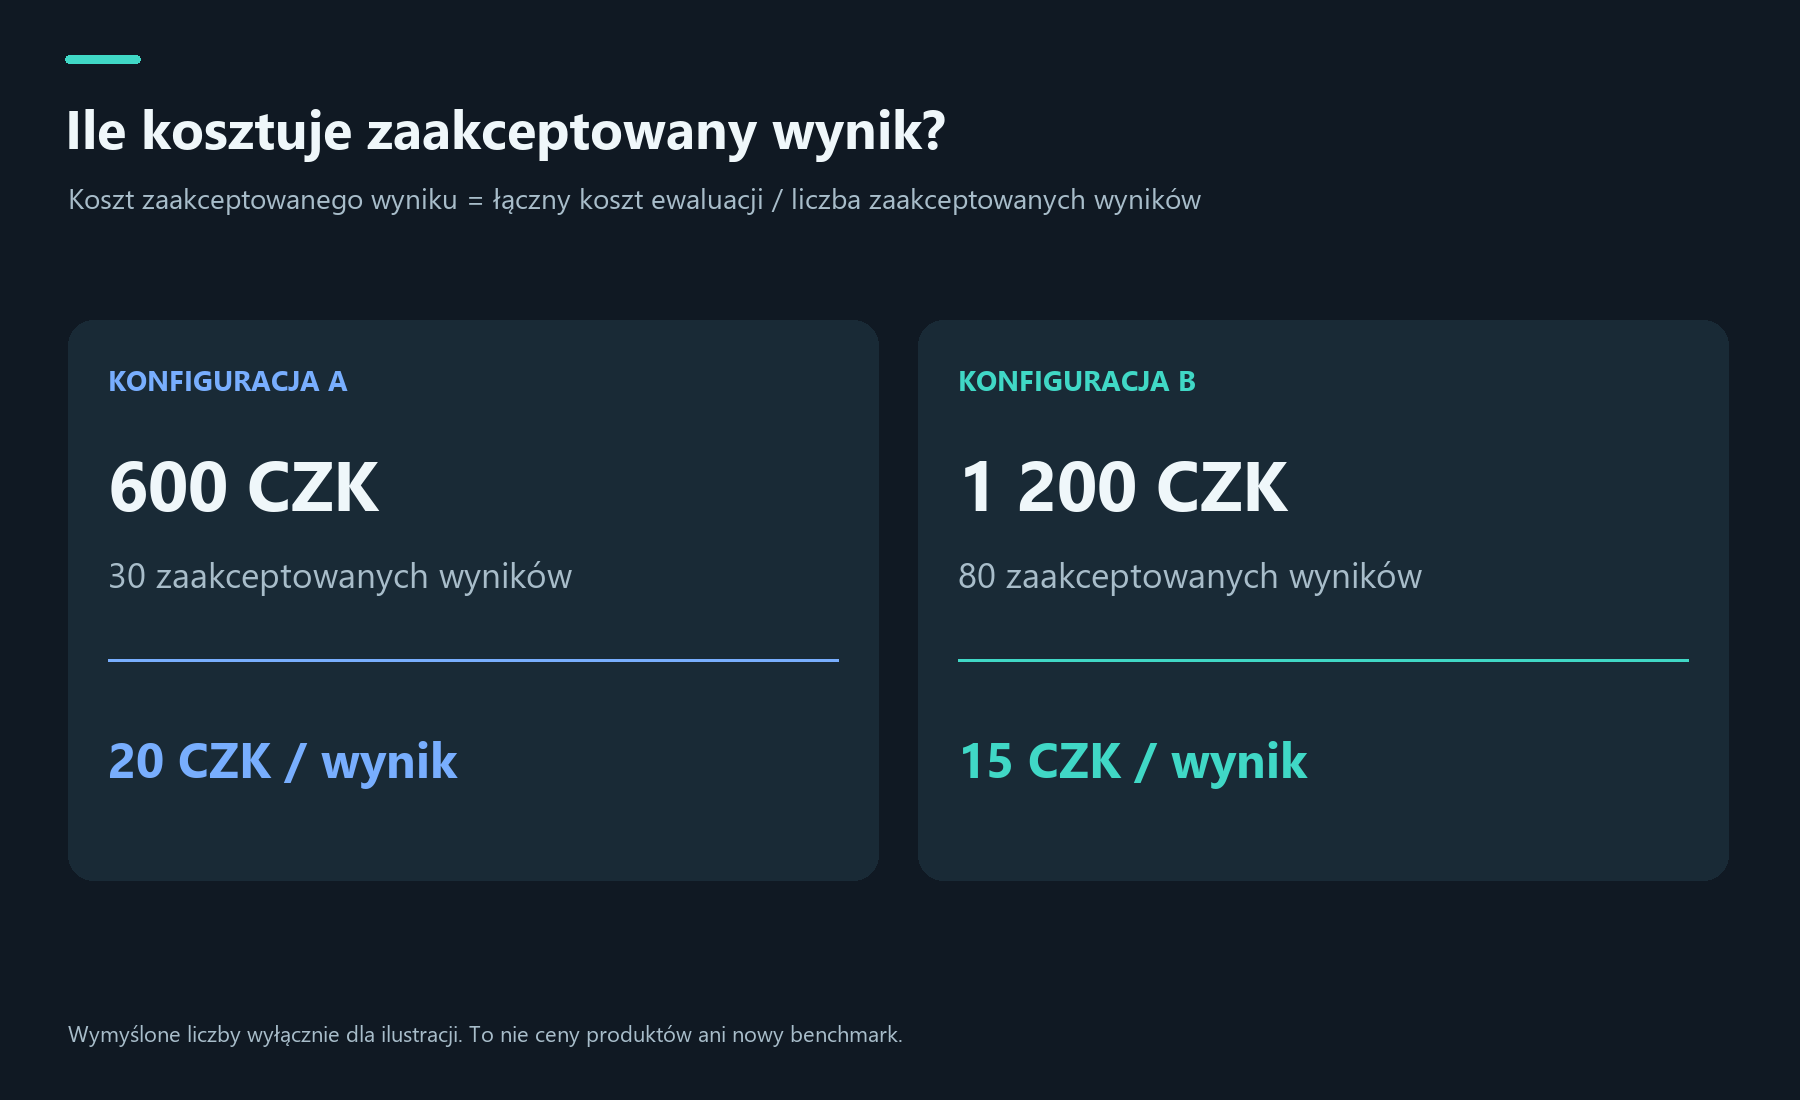
Wyłącznie ilustracyjne obliczenie na wymyślonych liczbach. Nie są to ceny produktów ani kolejny zmierzony benchmark. Zachowano walutę pierwotnego przykładu — korony czeskie (CZK).
Kiedy agent się zacina, możemy kupić silniejszy model. Czasami to pomaga. Czasami jednak brakuje mu właściwego pliku, nie dostał wyniku poprzedniej czynności albo nie wie, że współpracownik chwilę temu znalazł rozwiązanie.
Na naszej wyspie taką informacją była czeska rada na czacie. W firmie może to być test, poprawnie zapisana decyzja lub źródło, które da się prześledzić w arkuszu. Harness udostępnia tę informację przy następnej decyzji. Często właśnie tu powstaje różnica między agentem, który efektownie opowiada, a takim, którego pracę można naprawdę przyjąć.
Linki do oryginalnych metodologii znajdują się obok twierdzeń i tabel. Dziewięć obrazów obejmuje jedną ilustrację AI, siedem własnych schematów lub wykresów objaśniających i jeden oryginalny zrzut eksperymentu. Liczby, pochodzenie obrazów i linki są również w rejestrze źródeł obrazów oraz rejestrze tłumaczeń. Rankingi są obrazem konkretnego momentu, nie stałą kolejnością produktów.