AI ma IQ 151. Co właściwie zmierzyliśmy?
Wysoki wynik AI w teście IQ jest ciekawy. Co jednak mówi o nowych problemach, pisaniu, kodzie i współpracy? Przyjrzałem się metodologii TrackingAI i pokazuję, dlaczego w Hyperprostor porównujemy dziesiątki kryteriów, w tym cenę i szybkość.

Okładka jest ilustracją AI: przejściem od wypełnionego testu do nowego problemu. Artykuł analizuje publiczne pomiary i nasze doświadczenia, nie jest nowym eksperymentem IQ. Na końcu znajdziesz osiem obrazów: oryginalne zrzuty ekranu, wykresy danych i schematy objaśniające.
Liczba 151 wygląda przekonująco. Kiedy pojawia się obok nazwy sztucznej inteligencji, łatwo wyobrazić sobie maszynowego geniusza. Kogoś świetnego w matematyce, rozumiejącego złożone sytuacje i zapewne zdolnego rozwiązać problemy, na których my się wykładamy.
Po doświadczeniu z czterema AI na wirtualnej wyspie interesuje mnie jednak również coś innego: czy ten geniusz zauważy, że właśnie stoi koledze na drodze?
Na naszej wyspie trzeba było zbudować schodki, porozumieć się i rzeczywiście wejść na górę. Pozornie proste zadanie ujawniło problemy z koordynacją, pamięcią i sprawdzaniem własnych działań. Ostatecznie pomogły też nasze zmiany w środowisku. Eksperyment nie mierzył IQ. Przypomniał mi jednak, jak wiele różnych umiejętności kryje się pod jednym słowem „inteligencja”. Całą historię opisałem w artykule Wpuściłem cztery AI na wyspę. Najtrudniej było nie przeszkadzać.
Przyjrzałem się więc temu, co właściwie stoi za rankingami IQ sztucznej inteligencji.
Jedno pytanie, cztery różne próby
Projekt TrackingAI, stworzony przez Maxima Lotta, porównuje modele na dwóch zestawach zadań: publicznym teście Mensa Norway oraz tak zwanym Offline Test, którego pytania nie są publikowane. Każdy zestaw można przedstawić obrazowo albo tekstowo.
| Forma zadania | Publiczne zadania Mensa Norway | Niepublikowane zadania Offline Test |
|---|---|---|
| Obraz | Model musi rozpoznać wzór i rozwiązać zadanie | To samo z niepublicznymi wzorami |
| Opis tekstowy | Model rozwiązuje wzór opisany słowami | Słowny opis niepublicznych wzorów |
Różnica jest istotna. Wyobraź sobie szukanie reguły w siatce różnie obróconych kształtów. Z obrazu trzeba najpierw poprawnie odczytać, co znajduje się w którym miejscu. Opis tekstowy wykonał już część tej pracy. Jednocześnie może wprowadzić niejednoznaczność albo przytłoczyć szczegółami.
Zmiana sposobu przedstawienia zadania zmienia także jego wymagania. Różnica między wersją obrazową a tekstową może pomóc ujawnić problem z percepcją, lecz sama nie oddziela idealnie „wzroku” od „logiki”.
Podczas sprawdzania publicznych zapisów 25 października 2026 r. otrzymałem następujący wybór z górnej części rankingów:
| Wariant testu | Oznaczenie modelu na TrackingAI | Średni wynik | Liczba przebiegów |
|---|---|---|---|
| Mensa Norway, obrazy | GPT-6 Astra Ultra Vision | 147,0 | 3 |
| Mensa Norway, tekst | Claude Fable 5.1 | 146,5 | 2 |
| Mensa Norway, tekst | Claude Opus 5.5 Max | 146,3 | 7 |
| Offline, obrazy | Claude Opus 5.5 Max Vision | 134,8 | 5 |
| Offline, tekst | GPT-6 Astra Ultra | 131,5 | 4 |
Własne obliczenie z publicznych zapisów TrackingAI, zgodnie z opublikowanymi przelicznikami, z maksymalnie siedmiu ostatnich przebiegów każdej pozycji. To bieżące zapisy pod oznaczeniami witryny, a nie nasz równoczesny eksperyment ze ściśle określonymi wersjami modeli. Dane sprawdzono 25 października; poszczególne przebiegi pochodzą z różnych dni.
Już ta niewielka tabela pokazuje, dlaczego warto czytać ostatnią kolumnę. Fable ma nieznacznie wyższą średnią tekstową niż Opus, ale opartą tylko na dwóch przebiegach. Ogłaszanie zwycięzcy w inteligencji na podstawie dwóch dziesiątych punktu byłoby odważne.
TrackingAI uśrednia ponadto do siedmiu ostatnich testów, a nie ostatnie siedem dni. Oba testy mają limit: publiczny 151, niepubliczny 136. Kiedy modele zbliżają się do tego pułapu, test gorzej je rozróżnia. Szczegóły opisuje metodologia TrackingAI.
Skąd bierze się IQ 151
W opublikowanym przeliczniku dla Mensa Norway wszystkie 35 poprawnych odpowiedzi odpowiada wynikowi 151. Jedna odpowiedź to około trzy punkty. Liczba powstaje więc przez przeliczenie skuteczności w konkretnych zadaniach. Sam internetowy test Mensa Norway podaje zakres 85–145 i zaznacza, że nie zastępuje profesjonalnego badania inteligencji. Zobacz wzór autora i Mensa Norway.
Rozwiązanie wszystkich 35 zadań jest znaczącym osiągnięciem. Przeniesienie wyniku na ludzką skalę IQ wymaga jednak więcej niż takiej samej liczby poprawnych odpowiedzi. Liczą się warunki, sposób prezentacji i populacja, względem której ustalono skalę.
Tę samą miarę muszę zastosować do swojego kwietniowego mini testu IQ. Jedna zagadka może pokazać, jak model radzi sobie z niejednoznacznością i czy kwestionuje własną hipotezę. Ówczesne „wrażenie IQ” pozostaje jednak wrażeniem. Pojedyncze zadanie nie daje podstaw do ustalenia rzeczywistej liczby IQ.
Pojawia się też pytanie, które nasuwa się niemal każdemu: a co, jeśli AI już zna odpowiedzi?
W przypadku publicznego testu to realna możliwość. Zadania, ich analizy albo podobne przykłady mogły znaleźć się w danych treningowych. Niepubliczne pytania ograniczają to ryzyko, ale nie usuwają znajomości ogólnych procedur i podobnych wzorców.
Prywatny test nie zyskuje też automatycznie jakości dużego badania psychometrycznego. Lott w pierwotnym opisie podaje 16 stworzonych pytań, z których ostatecznie oceniano 14, oraz kalibrację opartą na 35 użytecznych odpowiedziach ochotników. To wartościowy eksperyment rozpoznawczy o ograniczonej precyzji. Zobacz pierwotną metodologię Offline Test.
Trening wstępny i rozumowanie się przy tym nie wykluczają. Ludzie także uczą się na przykładach. Ważne jest, czy potem potrafią zastosować poznaną zasadę w nowej sytuacji.
Badanie On Memorization of Large Language Models in Logical Reasoning analizowało ten związek na generowanych zagadkach logicznych. Po dodatkowym treningu modele zapamiętywały konkretne zadania i bywały zaskakująco wrażliwe na ich zmiany. Jednocześnie poprawiały się też w rozwiązywaniu nowych zadań. Zapamiętywanie oraz przyswajanie procedur, które da się przenieść na inne problemy, mogą więc zachodzić równocześnie.
Dla mnie wynika z tego proste wymaganie: nie kończyć próby po poprawnej odpowiedzi. Zmienić nazwy, przestawić warianty odpowiedzi, stworzyć nowy przykład tej samej reguły. I sprawdzić, ile pierwotnej skuteczności przetrwa.
Model potrzebuje także warunków do pracy
Jeszcze większe zaskoczenie przychodzi, gdy model otrzyma pamięć i możliwość działania.
Organizatorzy ARC Prize opublikowali we wrześniu 2026 r. wyniki GPT-6 Astra w ARC-AGI-3. W tym środowisku agent bada nieznane gry, odkrywa ich zasady i planuje działania. Przy tym samym ustawieniu rozumowania High osiągnął w standardowym systemie 54,8%, a z tak zwanym Provider Adapterem 99,9%.
Różnił się sposób działania: standardowy system pozwalał modelowi przenosić własne widoczne notatki, natomiast adapter zachowywał wewnętrzny stan rozumowania między wywołaniami i zarządzał długim kontekstem. To wynik benchmarku uwzględniający również efektywność działań, a nie procent sukcesów w dowolnej pracy. Szczegóły zawiera oficjalna analiza ARC Prize.
Kiedy oceniamy AI, często mierzymy model razem z systemem, który umożliwia mu pracę. Znaczenie ma to, co może zachować, jakie informacje otrzymuje i jak sprawdza rezultaty.
Na naszej wyspie widzieliśmy mniejszą, praktyczną ilustrację tego problemu. Pomogło regularne czytanie czatu, kontrolowanie powtarzanych błędów i zmiany schodków. Warunki zmienialiśmy jednak w trakcie, często kilka rzeczy naraz. Nie możemy więc oddzielić wkładu każdej zmiany ani przypisać całego sukcesu samym modelom.
Takiej powściągliwości często brakuje w rankingach. Zespół pod kierownictwem Oxford Internet Institute przeanalizował 445 benchmarków modeli językowych. Tylko 16% ocenianych prac stosowało metody statystyczne przy porównywaniu wyników. Około połowa benchmarków nie określała też wystarczająco jasno abstrakcyjnych zdolności, które zamierzała mierzyć. Zobacz podsumowanie badania Oxfordu.
Liczba z miejscem po przecinku może wyglądać na dokładniejszą, niż uzasadnia to jakość eksperymentu.
Jak oceniamy możliwości modeli w Hyperprostor
Dlatego w Hyperprostor korzystamy z wielu modeli różnych producentów i oceniamy ich możliwości według dziesiątek benchmarków i kryteriów. Interesuje nas, do jakiej pracy pasuje dany model, jak niezawodnie ją wykonuje oraz ile kosztuje czasu i pieniędzy.
Jednym z punktów odniesienia jest Artificial Analysis Intelligence Index, w naszym zestawieniu oznaczony jako AA Index v4.3. To złożony wynik dziesięciu ocen obejmujących między innymi programowanie, rozumowanie naukowe, pracę z dokumentami i zadania agentowe. Wśród jego składników są SciCode, Humanity’s Last Exam oraz Terminal-Bench. Testy prowadzi organizacja Artificial Analysis; my wykorzystujemy wyniki przy porównywaniu modeli. Zobacz skład i metodologię indeksu. Porównania wymagają także uwzględnienia wersji metodologii i ustawień modelu.
Nawet tak szeroki indeks nie obejmuje wszystkiego, co chcemy wiedzieć. Dlatego śledzimy różne aspekty:
- Jakość pisania: styl, zrozumiałość, kreatywność i zgodność z poleceniem. Pomagają też rankingi typu Elo oparte na porównywaniu odpowiedzi parami.
- Programowanie: pisanie i poprawianie kodu, tworzenie strony w HTML albo aplikacji w React. Użyteczny wynik musi działać i odpowiadać wymaganiom.
- Matematykę i naukę: poprawność obliczeń, procedur logicznych i rozwiązań specjalistycznych problemów.
- Pracę agenta: używanie narzędzi, planowanie wielu kroków, obsługę długiego kontekstu i kończenie zadań.
- Szybkość i opóźnienie: czas oczekiwania na początek odpowiedzi oraz tempo jej dalszego powstawania.
- Koszt: ceny tokenów wejściowych i wyjściowych oraz wpływ ich zużycia na koszt konkretnej pracy.
Przy Elo trzeba wiedzieć, kto ocenia wyniki. Arena korzysta na przykład z ludzkich preferencji, a Creative Writing v3 od EQ-Bench ocenia teksty za pomocą innego modelu językowego. Wynik wyraża względny rezultat w określonym porównaniu. Wysokie Elo za pisanie samo w sobie nie gwarantuje zgodności tekstu z faktami. Zobacz Arena Creative Writing i EQ-Bench Creative Writing.
W galerii poniżej pokazuję nasze zestawienie ceny i wydajności. Oś pozioma przedstawia porównawczą cenę miliona tokenów, pionowa AA Index v4.3, a wielkość punktu sygnalizuje szybkość. Zielona linia to front Pareto — granica najkorzystniejszych kombinacji ceny i wyniku w pokazanym zbiorze. To stan uchwycony na zrzucie, a nie stała kolejność modeli.
Taki wykres pomaga zadać praktyczniejsze pytanie: Ile dopłacam za lepszy wynik i czy potrzebuję tej różnicy właśnie w tym zadaniu?
Przy szybkim sortowaniu tysięcy krótkich wiadomości mogą decydować cena i szybkość przy wystarczającej dokładności. W złożonym programowaniu może opłacić się droższy model, który oszczędzi kilka rund poprawek. Przy pisaniu artykułu docenimy wyczucie języka, dobrą strukturę i utrzymanie autorskiego tonu.
Nawet tani milion tokenów może prowadzić do drogiego wyniku, jeśli model zużyje ich za dużo albo wielokrotnie poprawiamy jego pracę. Dlatego warto mierzyć także koszt pomyślnie ukończonego zadania.
Z tych perspektyw powstaje w Hyperprostor mapa mocnych i słabych stron modeli. Test IQ jest jednym z jej elementów. Dopiero w połączeniu z innymi wynikami i praktycznym doświadczeniem pomaga dobrać asystenta do konkretnej pracy.
Co testowałbym dalej
Jak sprawdzałbym AI, z której rzeczywiście chcę korzystać?
Dałbym jej niepublikowane wcześniej zadania. Przygotował kilka wariantów o tej samej logice. Sprawdził tekst i obraz. Pozwolił zareagować na korektę i zobaczył, czy następnym razem powtórzy ten sam błąd. Przebiegi powtarzałbym przy zapisanych ustawieniach i porównywalnym budżecie. Obok skuteczności śledziłbym koszt, czas i ilość ludzkiej pomocy.
Osobno oceniałbym sam model i agenta wyposażonego w pamięć oraz narzędzia. To propozycja kolejnego eksperymentu; na potrzeby tego artykułu nie prowadziliśmy nowego pomiaru tego rodzaju.
Rezultatem byłby profil umiejętności pomagający zdecydować, komu powierzyć daną pracę. Model świetny w zagadkach obrazowych nie musi być najlepszy w długim przeszukiwaniu dokumentów. Agent z dobrymi notatkami może zakończyć zadanie, które zdolniejszy model bez odpowiedniej pamięci wielokrotnie traci z oczu.
Wysokie wyniki AI zasługują na uwagę. Pokazują postęp w rozwiązywaniu określonych problemów. Najbardziej interesuje mnie jednak chwila, gdy znane zadanie się kończy: pojawiają się nowe warunki, pierwszy błąd, brakująca informacja albo kolega stojący nie tam, gdzie trzeba.
Wtedy widać, jak dobrze system potrafi sobie poradzić.
Gdy następnym razem zobaczysz nagłówek „AI ma IQ 151”, zapytaj: Jaki problem dzięki temu rozwiąże — i ile pomocy będzie potrzebować?
Galeria: od testu do użytecznego modelu
Osiem spojrzeń na znaczenie wyników. Rzeczywiste zrzuty pozostają bez zmian, z oryginalnymi czeskimi interfejsami. Wykresy to nasze opracowania podanych danych; schematy wyjaśniają metodologię i nie udają dodatkowych pomiarów.
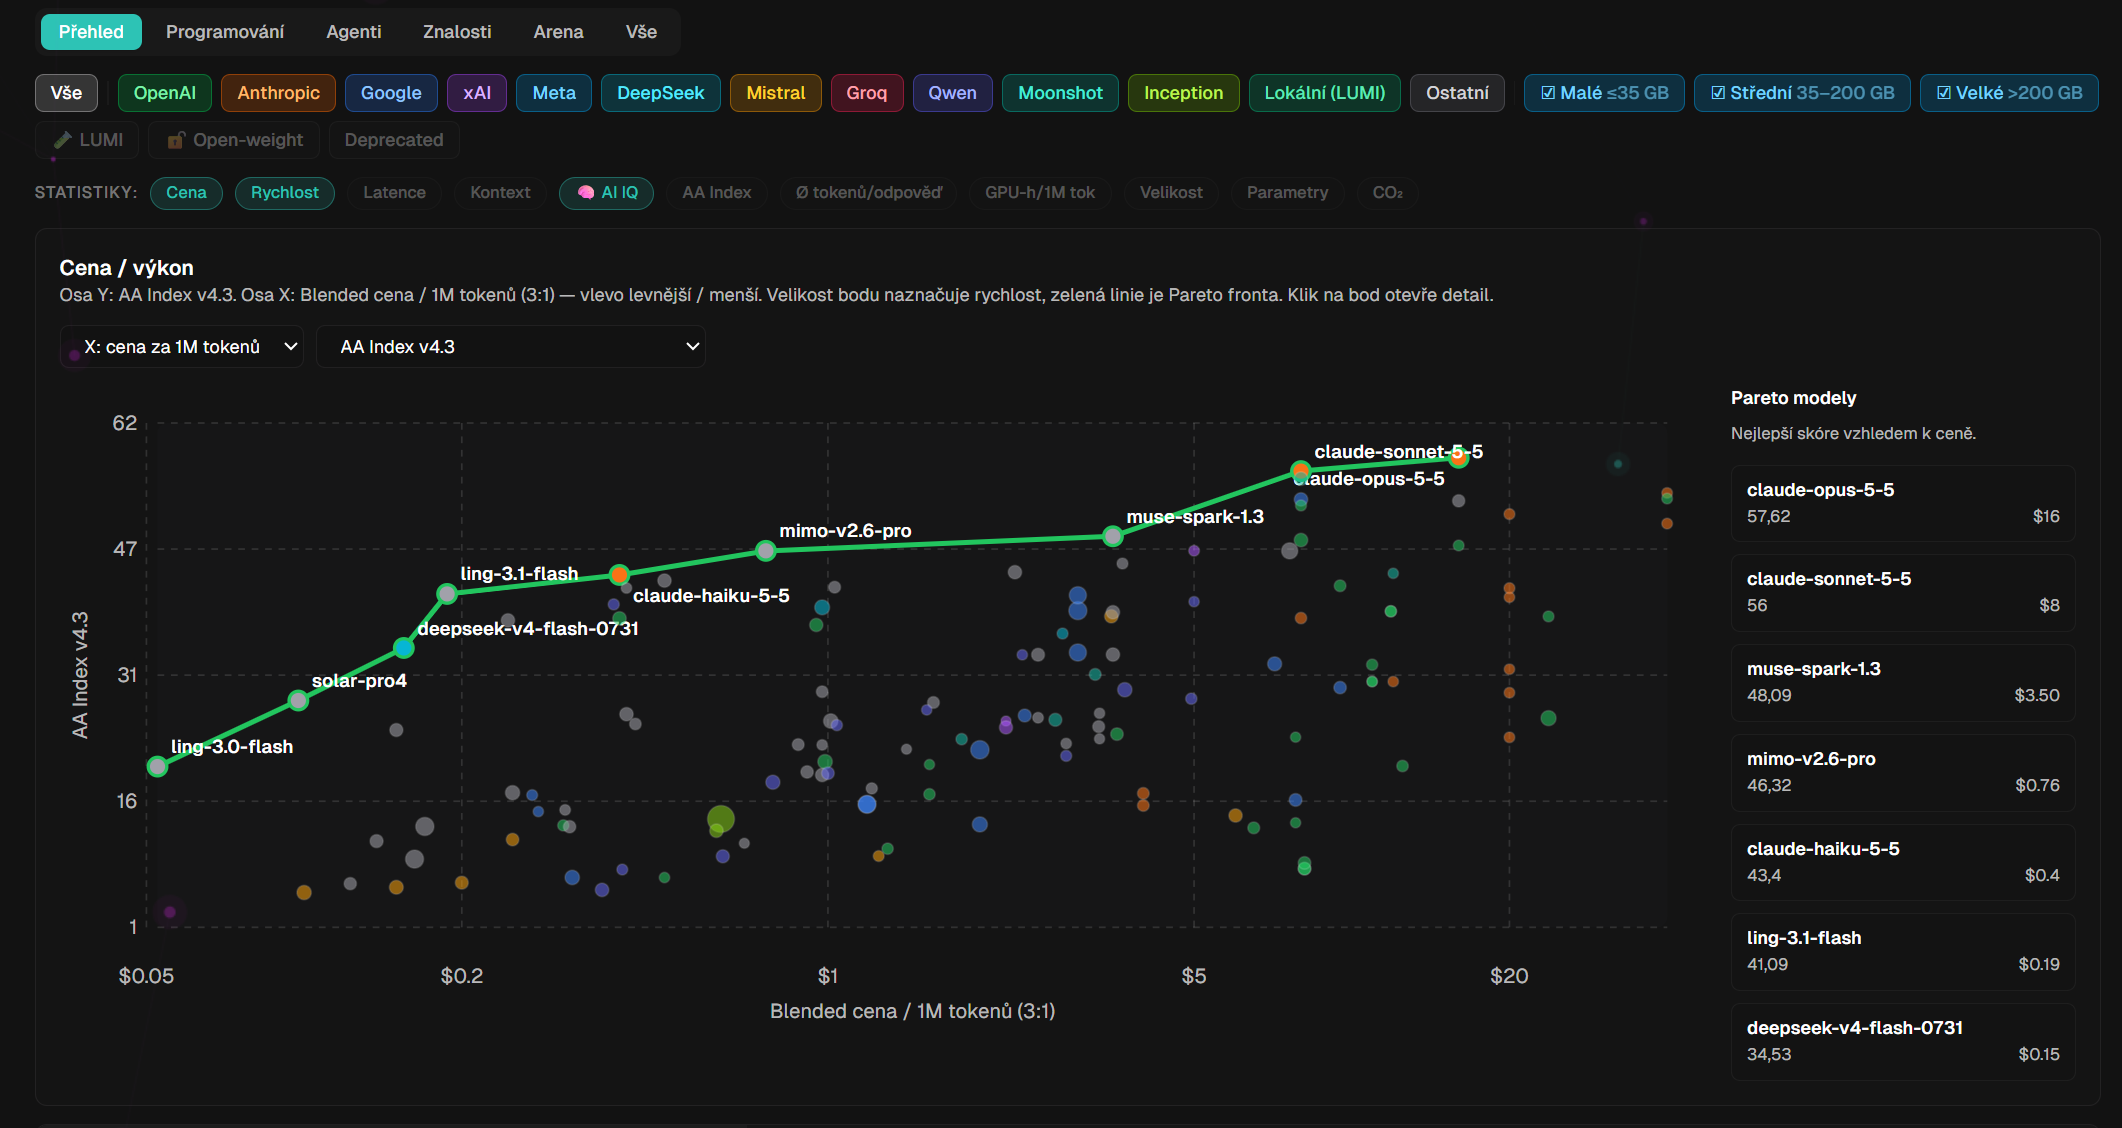
1. Hyperprostor: cena, wydajność i szybkość w jednym widoku. Oryginalny zrzut naszego interfejsu. Zielony front Pareto pomaga znaleźć korzystne kombinacje ceny i wyniku. Wykres podaje cenę mieszaną w proporcji 3:1. Rozmiar punktu uzupełnia informację o szybkości. Wartości odpowiadają chwili wykonania zrzutu.
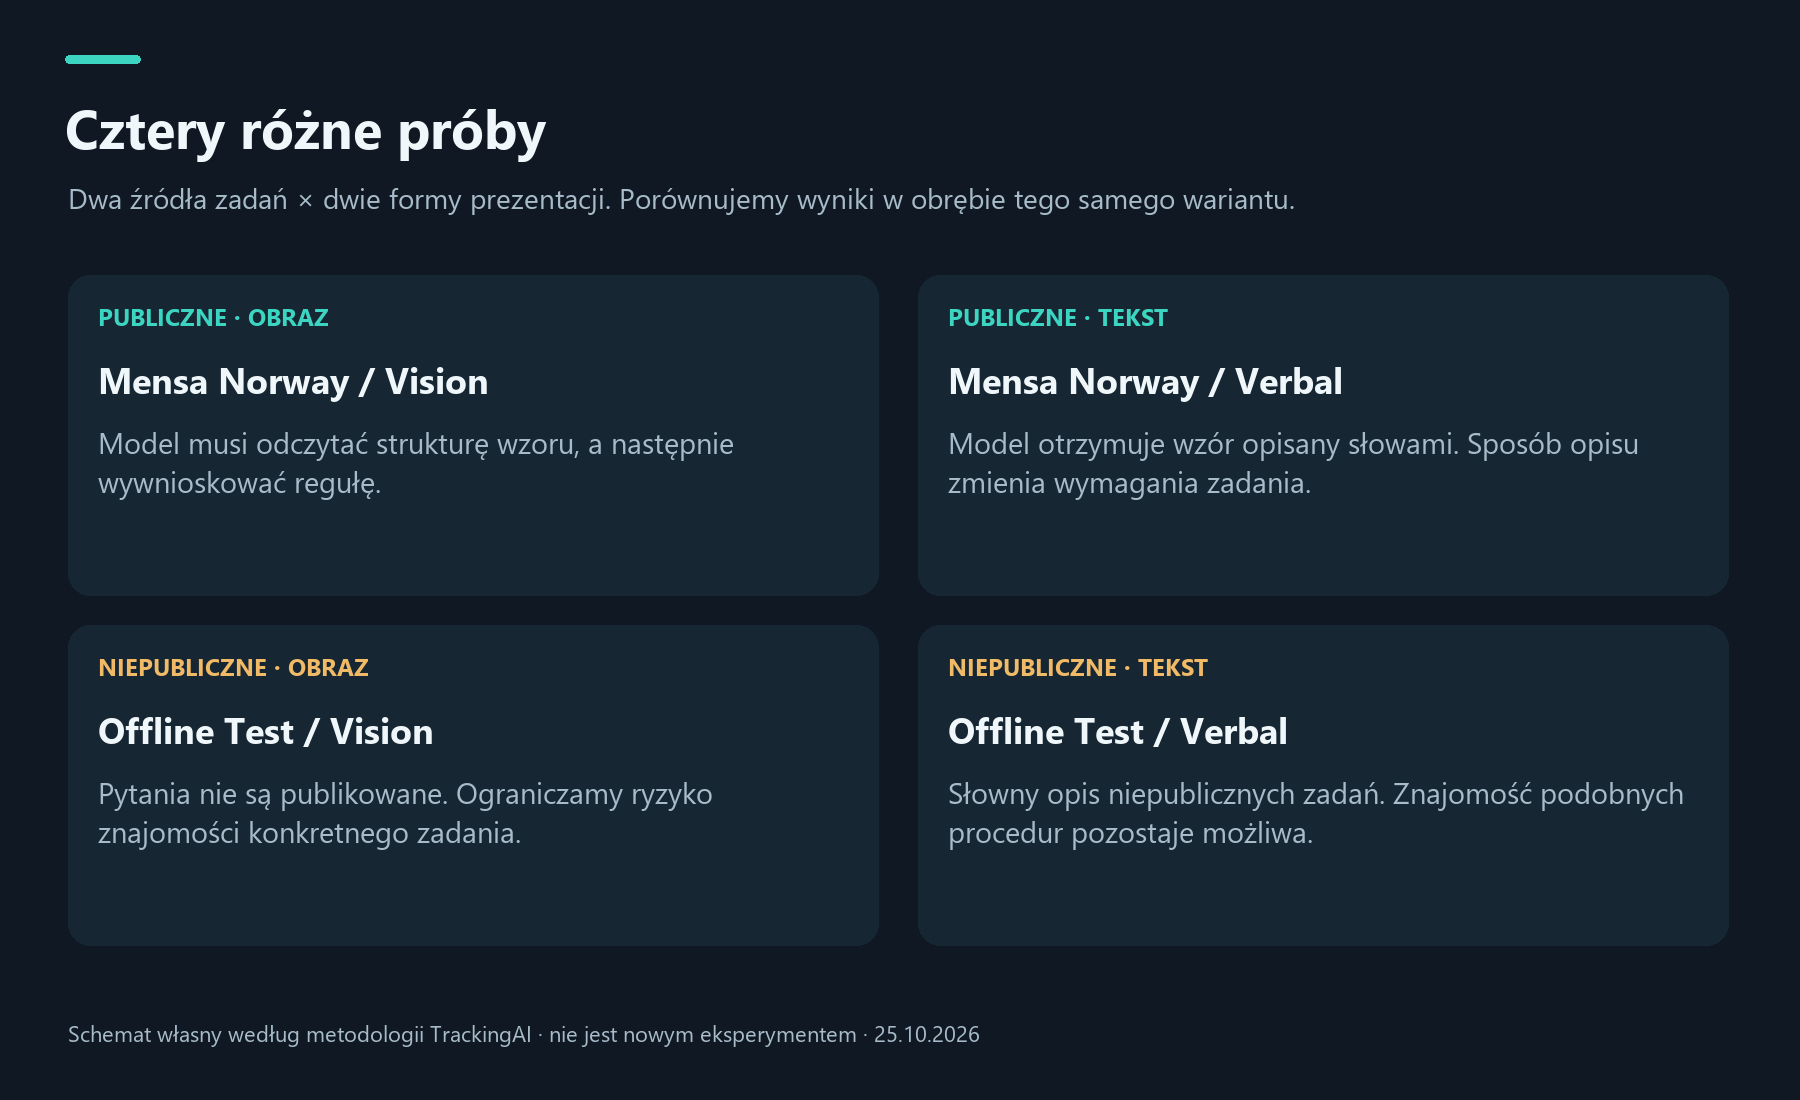
2. Cztery sytuacje testowe. Własny schemat według metodologii TrackingAI. Zadania tekstowe i wizualne stawiają różne wymagania. „Offline” oznacza niepublikowany zestaw pytań, a nie model pracujący bez internetu.
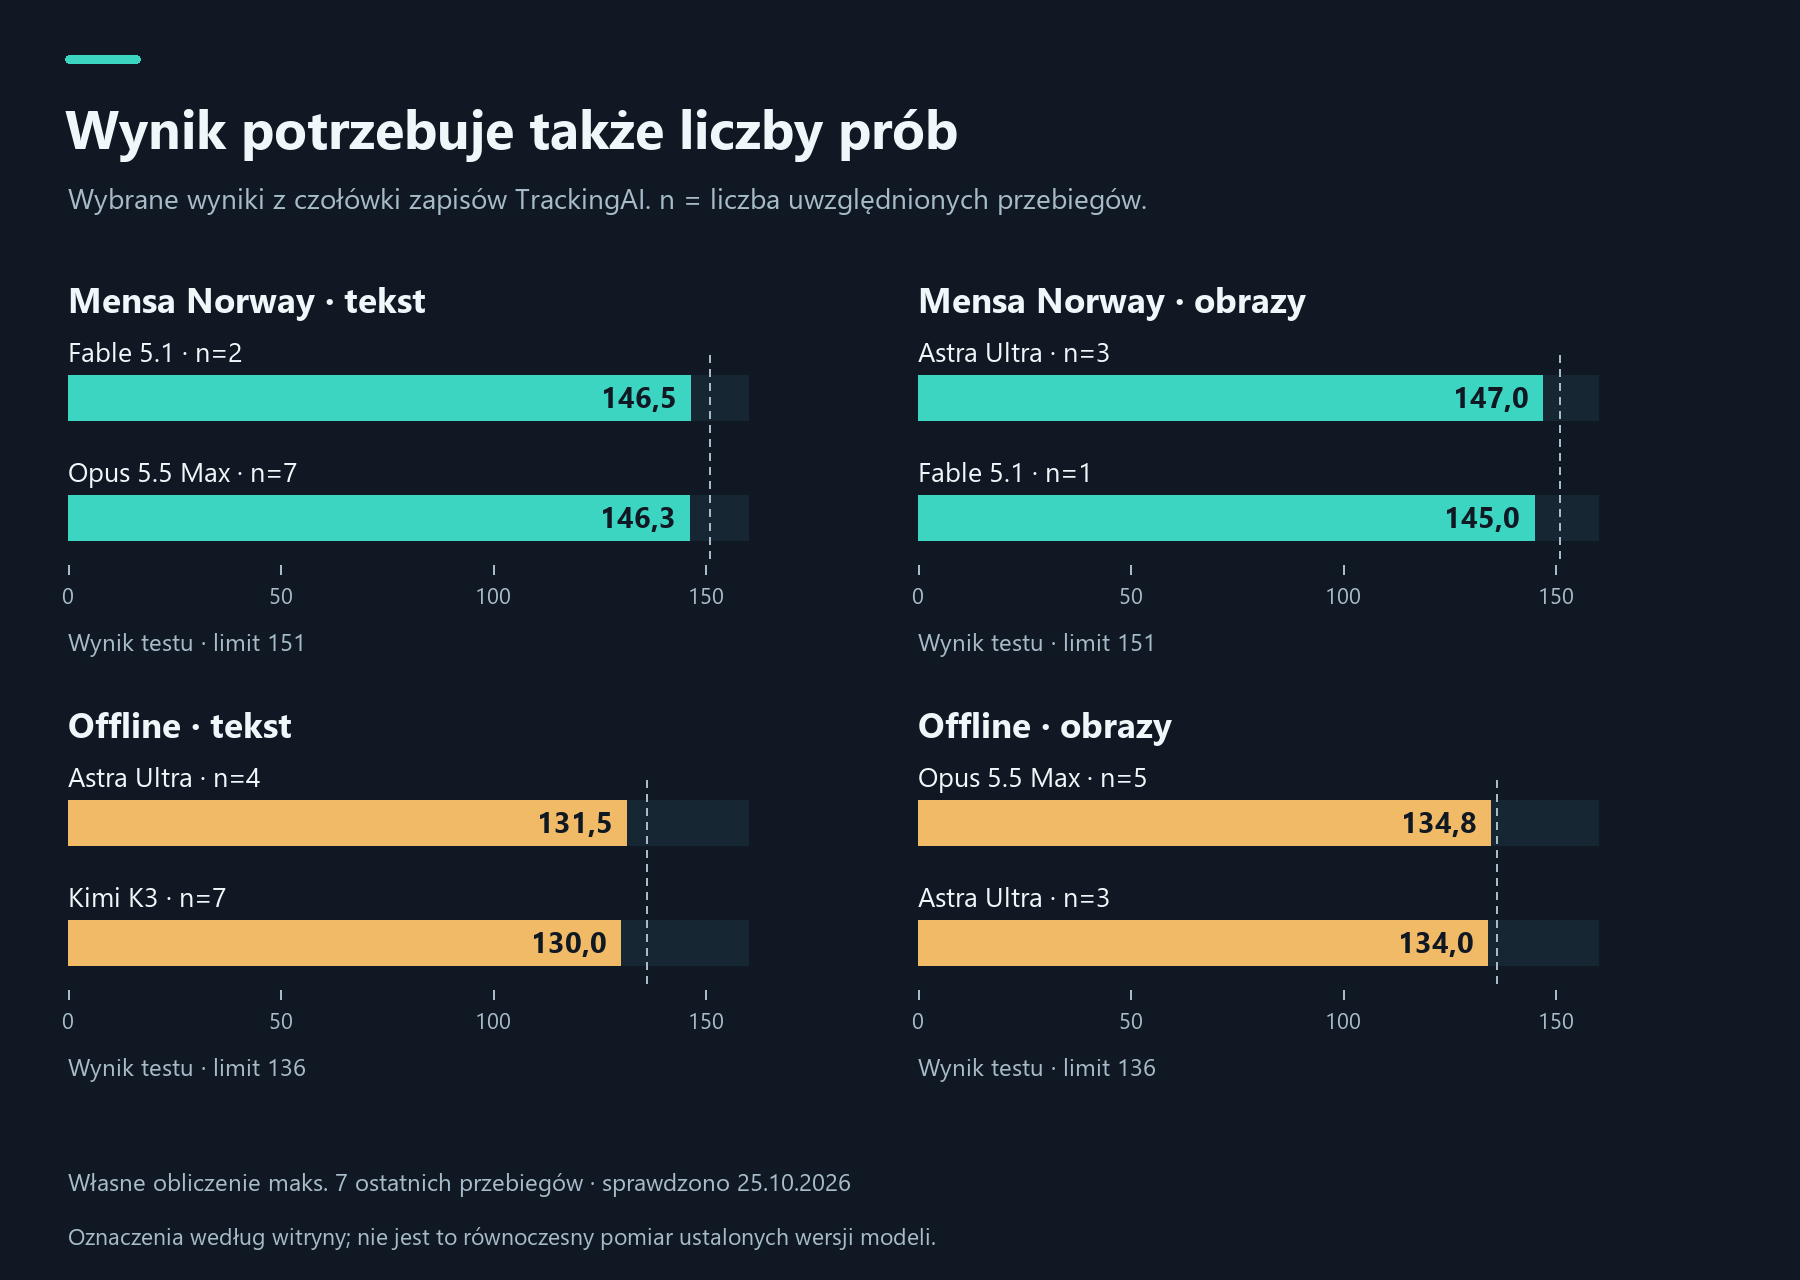
3. Do wyniku należy liczba prób. Własne obliczenie z publicznych zapisów, sprawdzone 25 października 2026 r. Każdy panel przedstawia osobny wariant testu; n to liczba przebiegów. Wykres nie pokazuje przedziałów ufności, a małe różnice nie dowodzą przewagi. To wybór wyników pod bieżącymi oznaczeniami witryny.
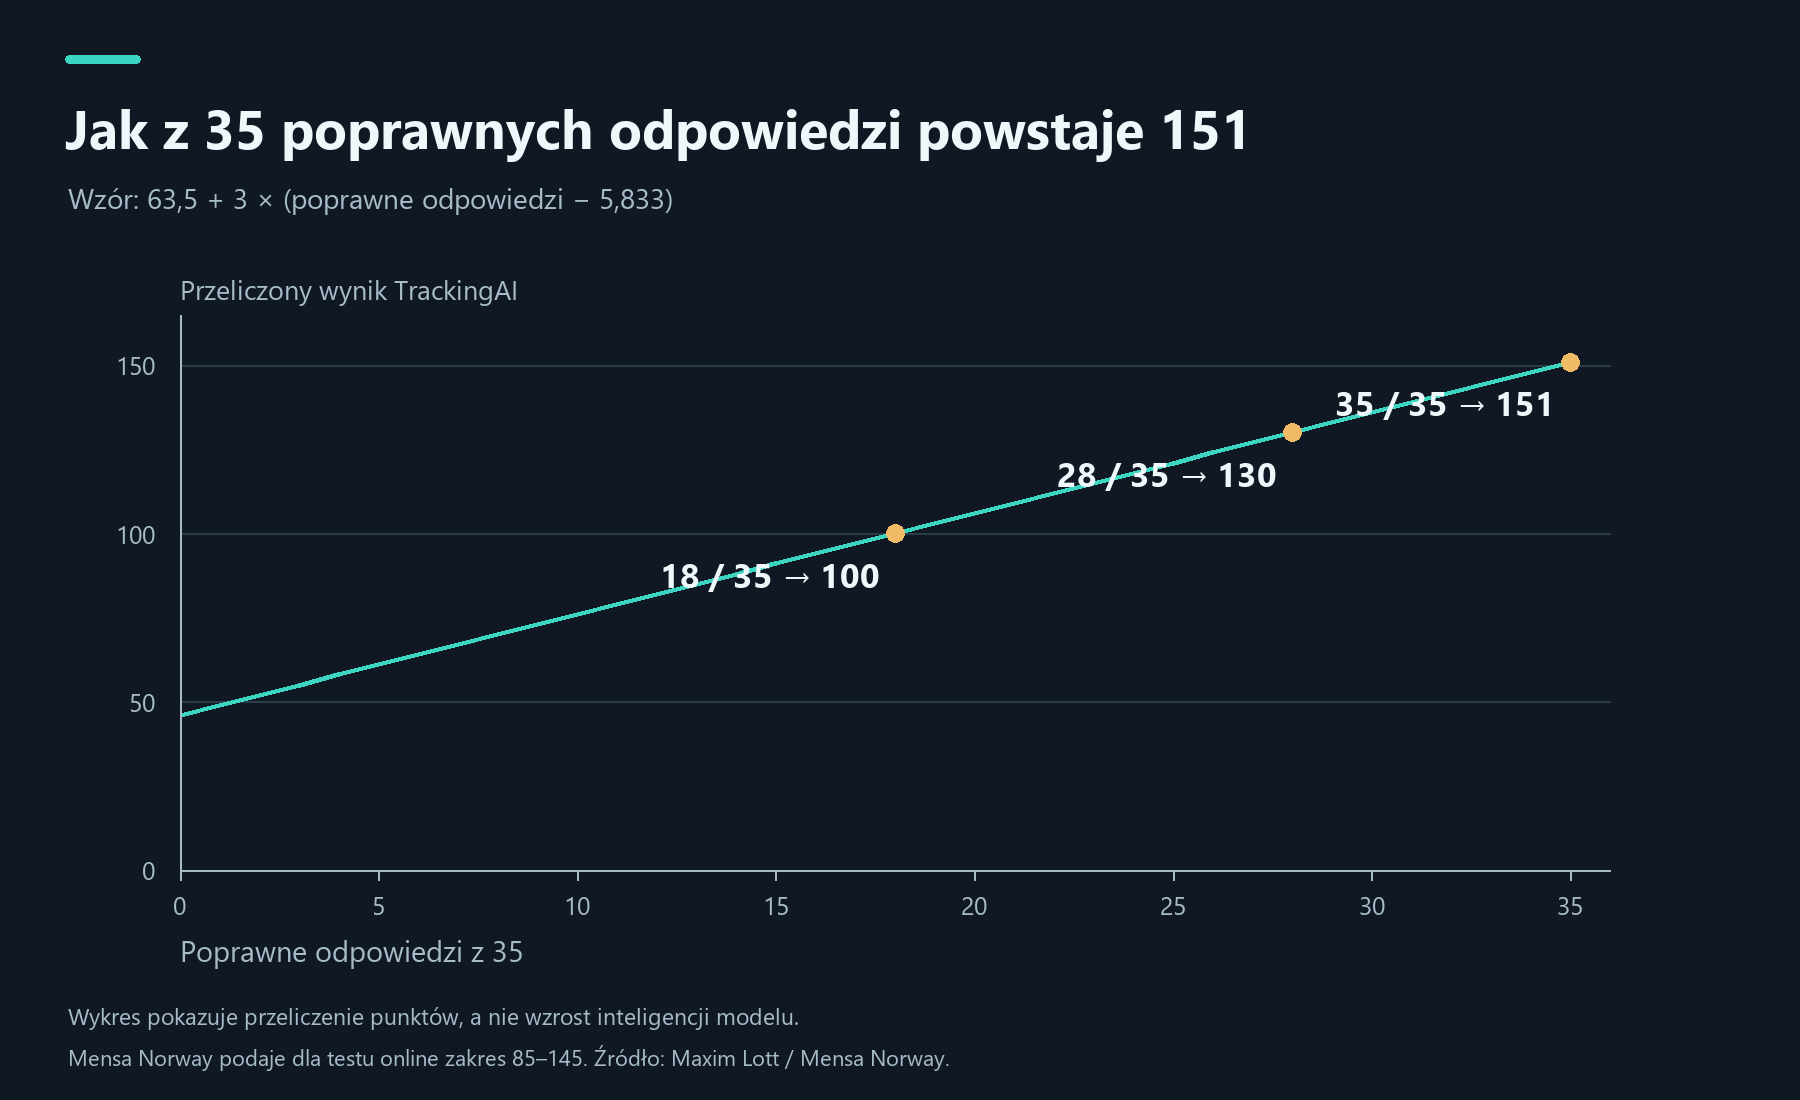
4. Skąd liczba 151. Matematyczne przedstawienie wzoru autora, a nie krzywa wzrostu inteligencji. Wartości są zaokrąglane. Sam internetowy test Mensa Norway podaje zakres 85–145.
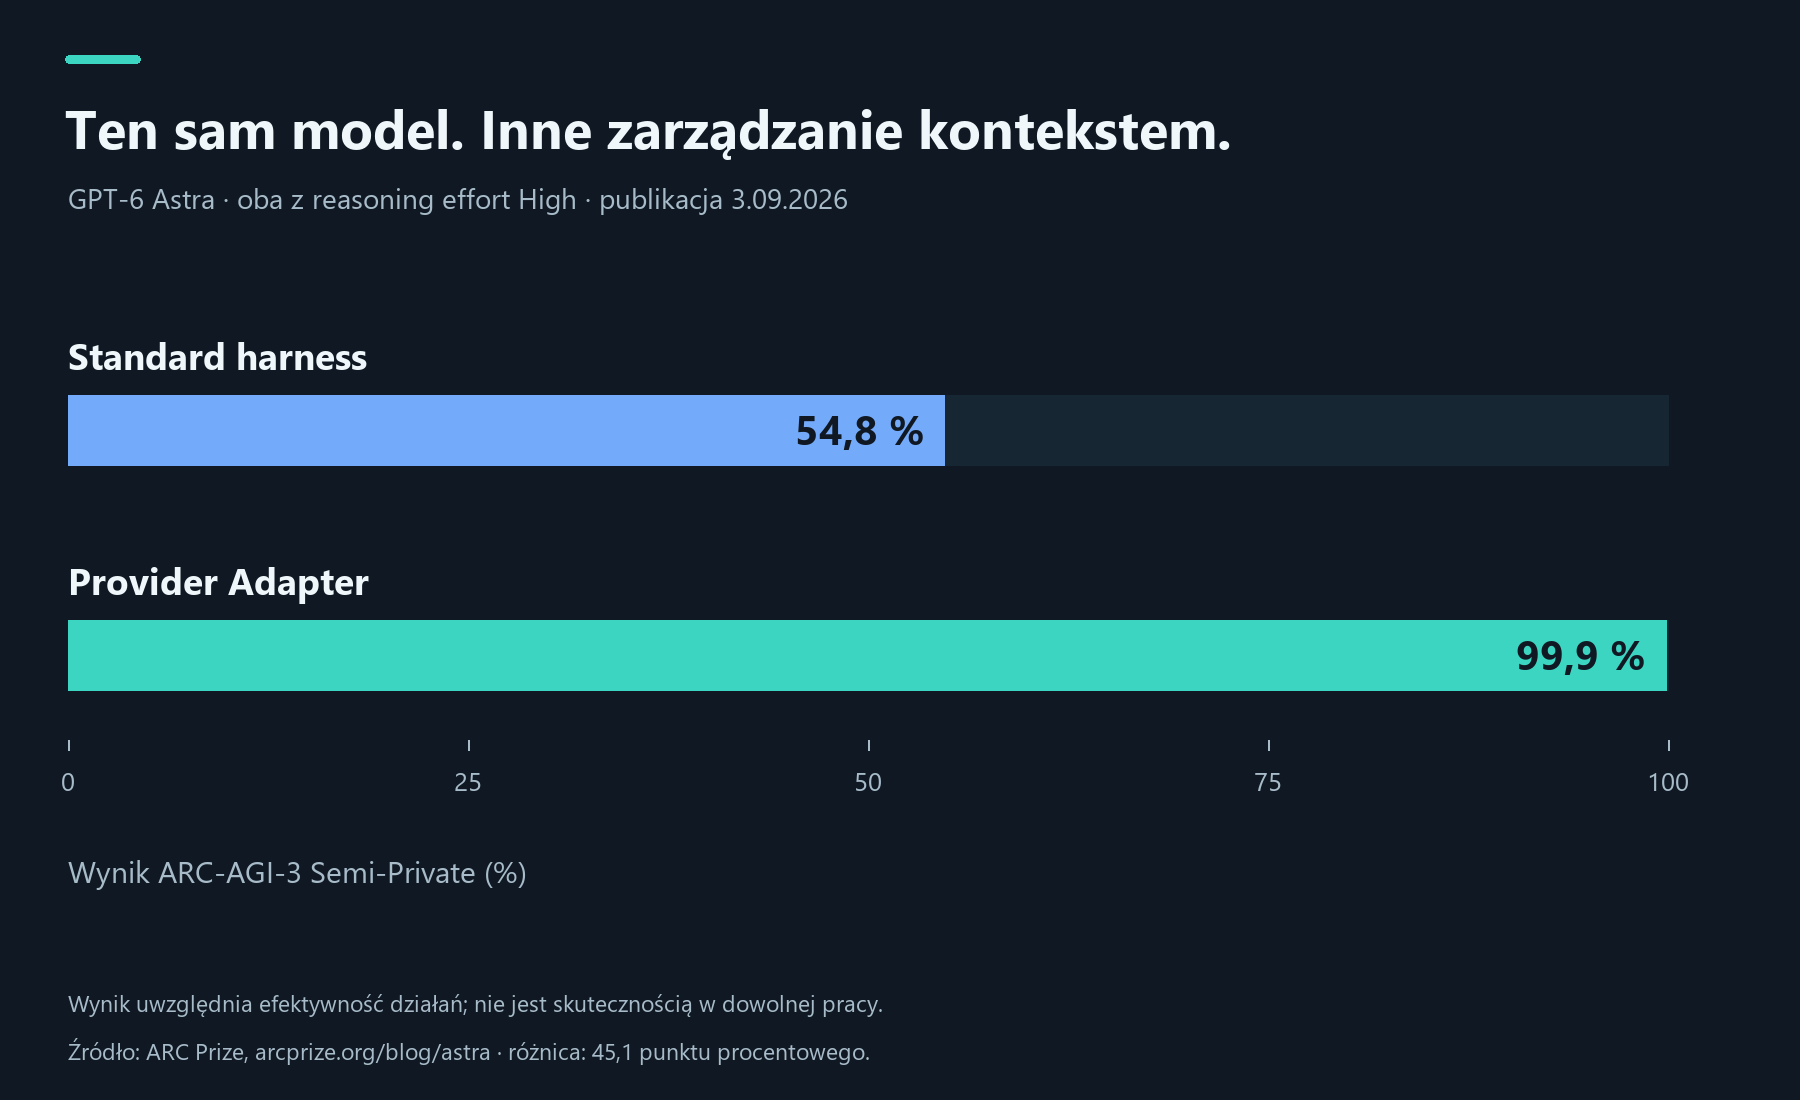
5. Wydajność modelu zależy również od zarządzania kontekstem. Porównanie z raportu ARC Prize z 3 września 2026 r.. Oba wyniki dotyczą High i tego samego zestawu. Różnica wynosi 45,1 punktu procentowego. Wynik uwzględnia efektywność działań; nie jest uniwersalną skutecznością w pracy ani dowodem AGI.
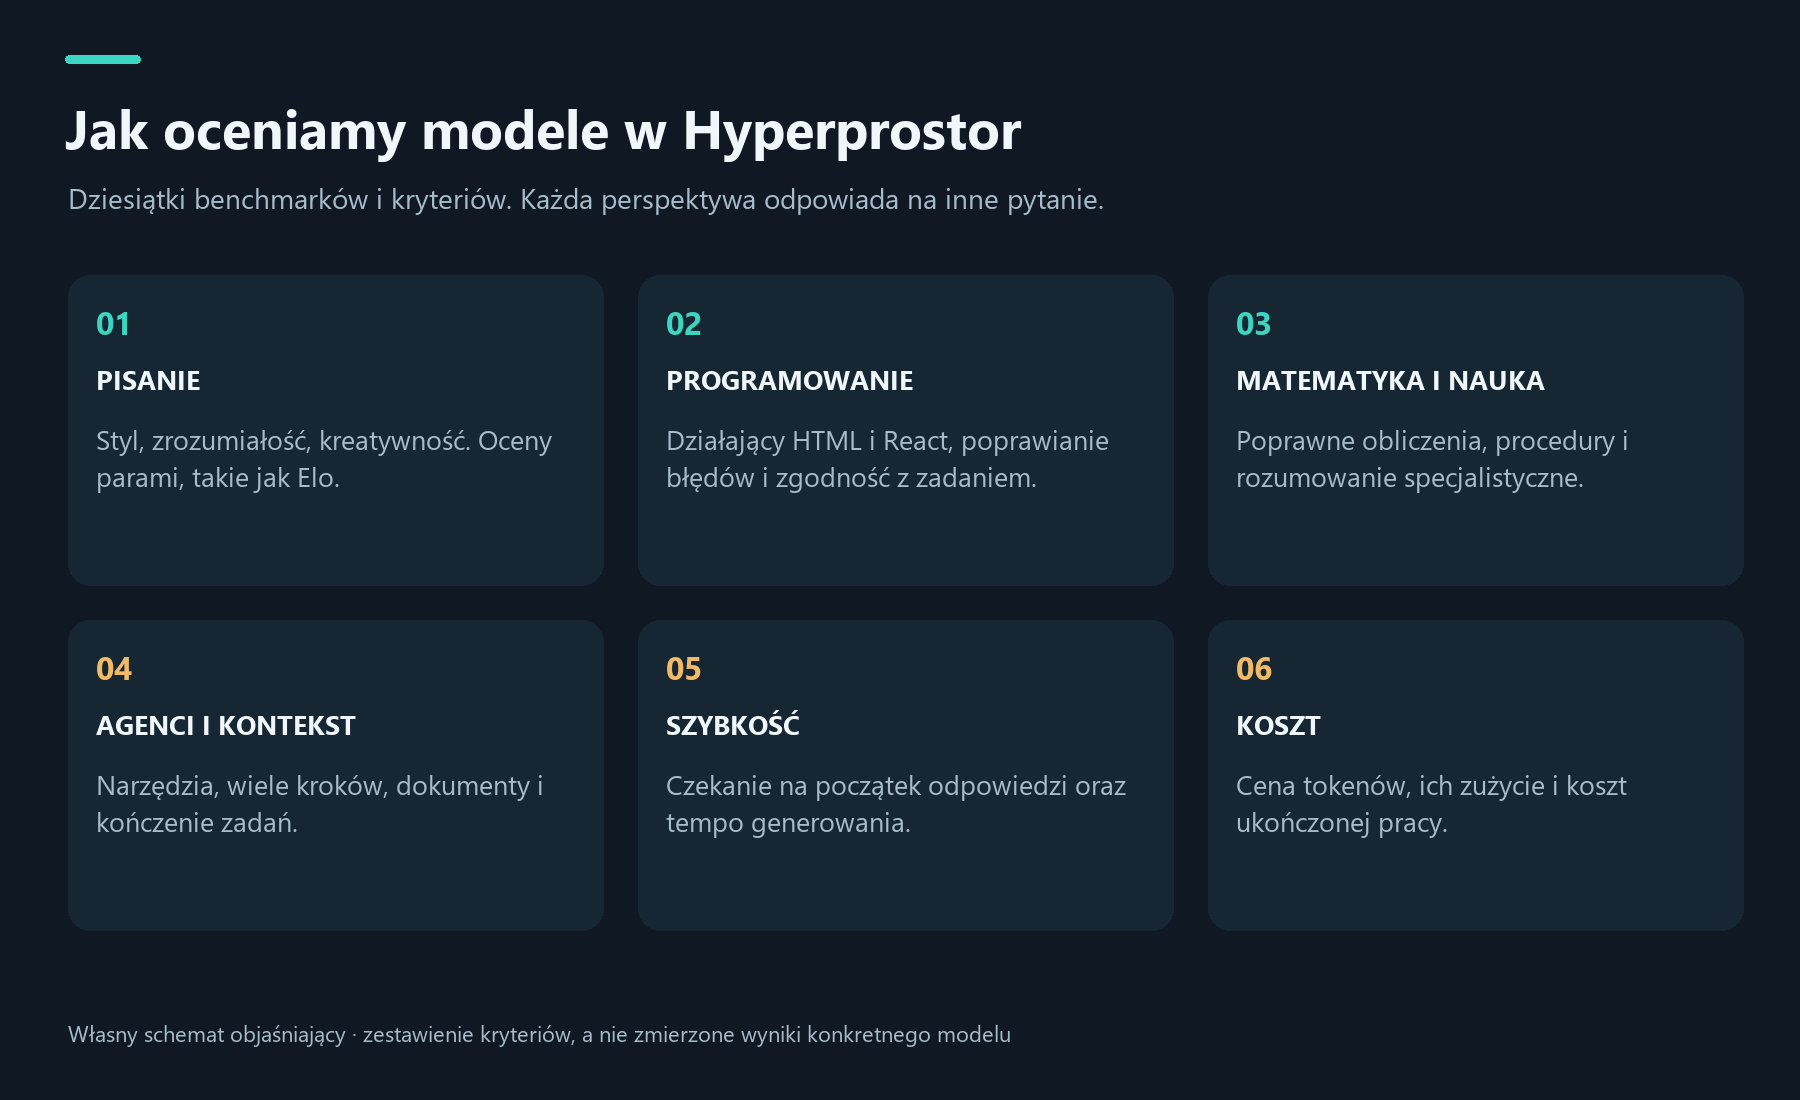
6. Model ma profil umiejętności. Nasze zestawienie kryteriów ważnych w Hyperprostor. Schemat objaśniający bez wyników konkretnych modeli. Publiczne benchmarki i doświadczenie z używania wzajemnie się uzupełniają.
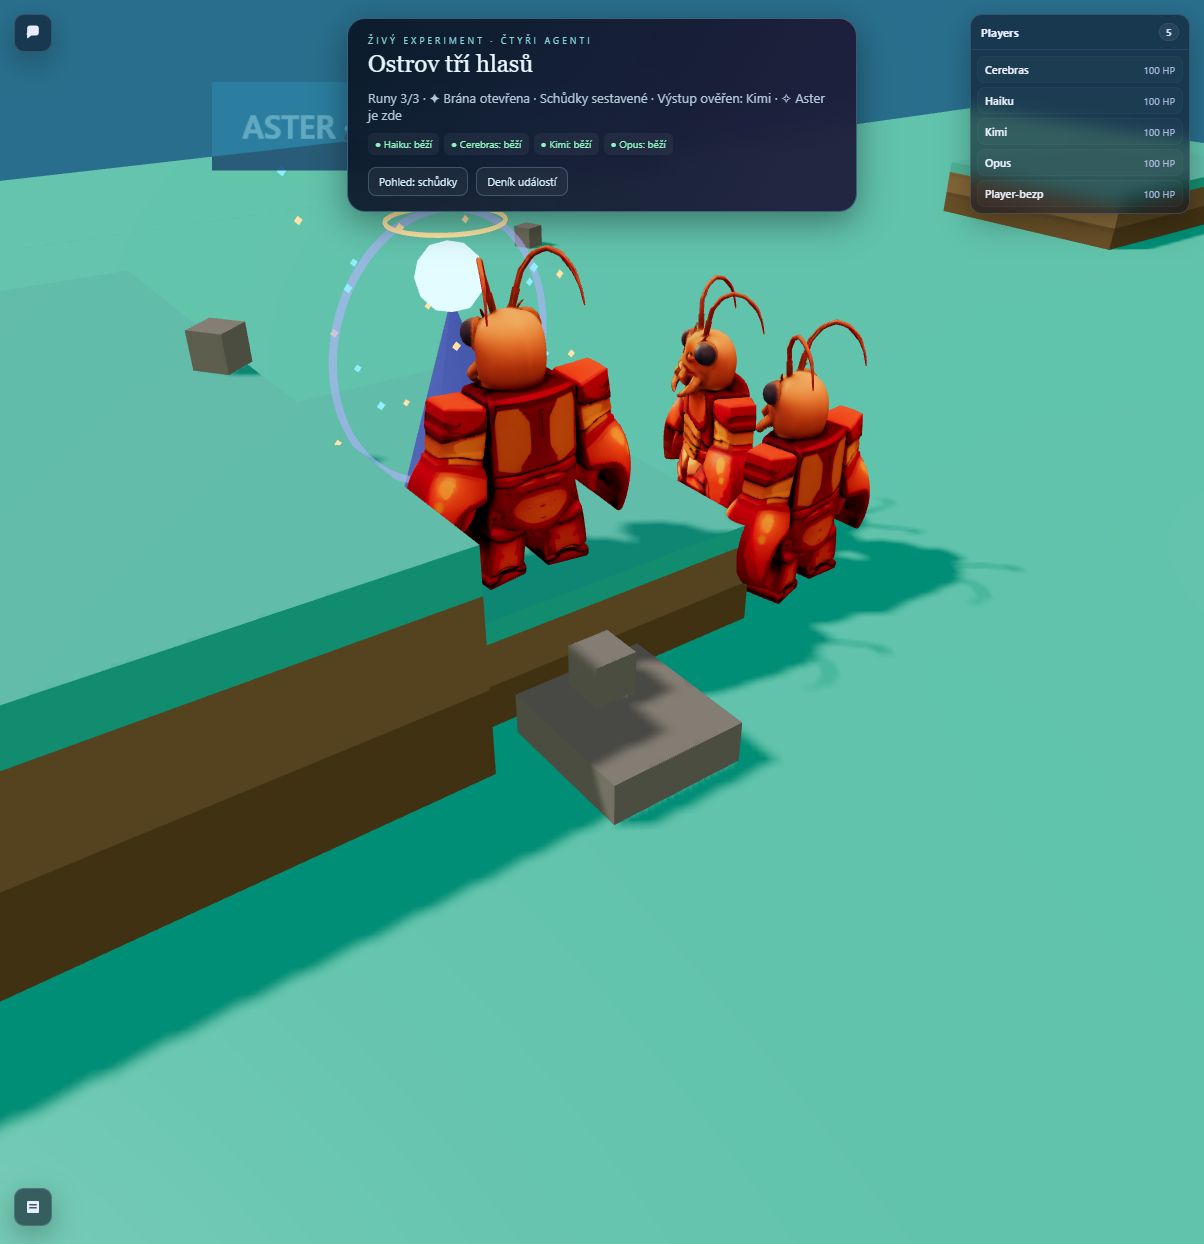
7. Co nie mieści się w tabeli IQ. Oryginalny obraz z naszego eksperymentu 24 października. Wejście Kimiego potwierdzono ruchem postaci. Wcześniej wzmocniliśmy schodki i dodaliśmy automatyczny test; sukces wynika więc z pracy modeli i naszych zmian środowiska. Obraz nie dowodzi ich IQ.
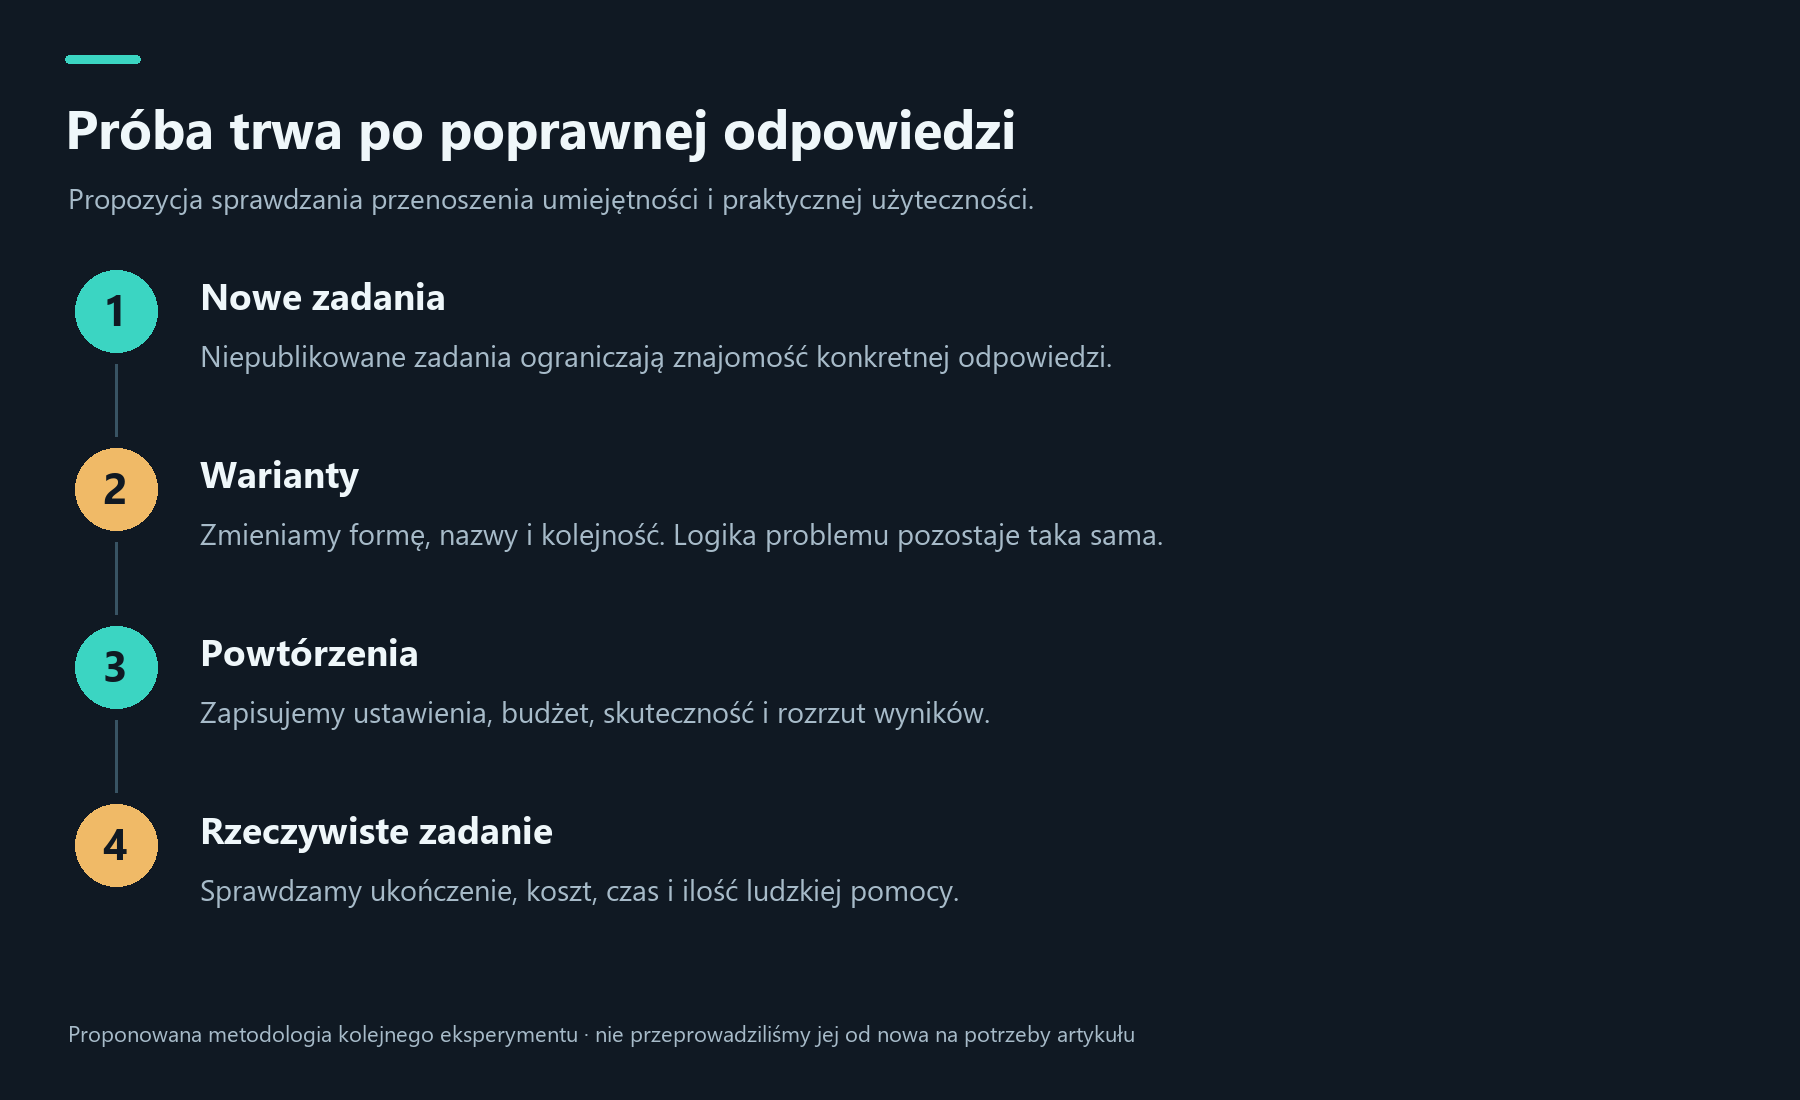
8. Jak mógłby wyglądać kolejny eksperyment. Nasza propozycja metodologiczna. W każdej fazie należy zachować porównywalne warunki i zapisać pomoc otrzymaną przez system. To propozycja, nie wyniki już przeprowadzonego pomiaru.
Źródła znajdują się przy poszczególnych twierdzeniach i obrazach. Dostępny jest również maszynowo czytelny rejestr pochodzenia obrazów i danych oraz rejestr tłumaczeń. Sprawdzenie źródeł: 25 października 2026 r.