NOESIS: Dlaczego bogaci umierają z głodu, a głosowanie AI wybiera gładki błąd
Połączyłem trzy swoje tegoroczne badania w jedno zamknięte laboratorium: wioskę Lipnice 3, ustalenia o ścianie selektora z superkomputera LUMI i sędziów falsyfikacyjnych z Laboratorium Teorii. Osiem eksperckich zespołów AI szukało w nim prawa upadku instytucji, a w bezpośrednim pojedynku zestawiłem ze sobą cztery modele, od szybkiego Gemini 4 Hydrogen i Claude Sonnet 5.5 po wagi ciężkie Gemini 4 Carbon High i Claude Fable 5.2.
W jednej z pierwszych rund mojej symulowanej wioski Lipnice 3 z głodu zmarło wszystkich ośmioro mieszkańców. Dziennikarka Eva leżała wtedy na wiejskim placu, a w portfelu miała 510 koron, czyli ponad pięć razy tyle, ile kosztowała dzienna porcja zupy. Kilka kroków dalej w sklepie kolonialnym leżały przy tym niezjedzone surowce.
Gdybyś zrzucił do takiej wioski z helikoptera worek dodatkowych pieniędzy, nie przeżyje ani jedna osoba więcej. Z banknotów zupy się nie ugotuje, skoro po śmierci właścicielki został zamknięty sklep, a piąta część poleceń po drodze zacina się o niezgrabny interfejs sterowania.
Ten obraz nie dawał mi spać, bo nie mówi tylko o jednej grze komputerowej. Tak samo zawodzą firmy, urzędy i zespoły złożone ze sztucznej inteligencji. Kiedy system się zacina, pierwszy instynkt, ludzki i modelowy, każe dołożyć budżet, zatrudnić ludzi albo zorganizować zbiórkę. Prawdziwa przyczyna leży tymczasem często w niepozornym węźle w połowie drogi, którego nikt nie odblokował.
Postanowiłem więc połączyć trzy pozornie oddzielne projekty, nad którymi pracowałem w tym roku, w jedno zamknięte laboratorium. Nazwałem je NOESIS i pozwoliłem w nim ośmiu wyspecjalizowanym naukowym zespołom AI samodzielnie odkryć z danych, dlaczego społeczeństwa upadają, kto na naradzie da się nabrać na gładki błąd i jak naprawić zasady bez jednej korony dotacji. Na koniec wpuściłem na tę samą arenę cztery modele dwóch generacji (od oszczędnego Gemini 4 Hydrogen i Claude Sonnet 5.5 po dzisiejszą najwyższą ligę Gemini 4 Carbon High i Claude Fable 5.2), żeby zobaczyć, dokąd sięga sufit dzisiejszej maszynowej inteligencji.
O co mi chodzi: połączenie trzech ślepych punktów w jedną świątynię
Kiedy patrzę na dzisiejszą sztuczną inteligencję i na to, jak rozwiązuje się z nią złożone problemy w firmach czy w państwie, w kółko trafiam na trzy ślepe punkty. Każdemu z nich poświęciłem w tym roku osobne badanie:
- Żywy świat z zasadami i tarciem (Lipnice 3). W zwykłych benchmarkach AI odpowiada na wyizolowane szkolne pytanie. W prawdziwym świecie wynik zależy jednak od współgrania wielu kroków: ktoś musi wyhodować surowiec, ktoś inny sprzedać go w sklepie kolonialnym, kolejny ugotować w gospodzie i wydać. Okazało się, że o przetrwaniu nie decyduje tylko sama bystrość modelu, ale też harness (programowa uprząż wokół agenta) i zasady instytucjonalne, na przykład to, czy żywy sąsiad może przejąć osierocony sklep.
- Ściana selektora (5 000 godzin GPU na superkomputerze LUMI). Trzy miesiące pomiarów na fińskim superkomputerze przyniosły niemiłe odkrycie: kiedy każesz silnemu modelowi wygenerować osiem prób odpowiedzi na trudne pytanie naukowe, w 95,5 % przypadków poprawna odpowiedź jest wśród nich. Ale kiedy pozwolisz modelom o niej głosować, wybiorą ją tylko w 86 %. Głosowanie nie testuje prawdy. Testuje, jak gładko i znajomo odpowiedź brzmi.
- Nieprzekupny sędzia z zapadką (Laboratorium Teorii). W zeszłym tygodniu wypróbowałem lekarstwo: odebrać modelom prawo do przekonywania się nawzajem słowami. Każdy zespół musi zapisać swoją teorię jako krótki, wykonywalny program w Pythonie
def predict(c):. Niezależny sędzia uruchamia program na danych, których zespół nie widział, a zapadka (odpowiednik matematycznego weryfikatora Lean) przepuszcza rewizję dalej tylko wtedy, gdy rzeczywiście zmniejsza błąd.
Każdy z tych trzech projektów miał osobno swój haczyk. Lipnice rodziły mocne historie, ale poprawiałem je ręcznie metodą prób i błędów. LUMI nazwało ścianę selektora, ale przy otwartych pytaniach społecznych brakowało dokładnego testu. A Laboratorium Teorii badało podręcznikowe równania narady, a nie żywą gminę z pieniędzmi, głodem i zamkniętą gospodą.
Z połączenia tych trzech gałęzi powstał NOESIS, zamknięta pętla naukowa w czterech krokach:
| Faza pętli | Z czego wychodzi | Co dokładnie robi |
|---|---|---|
| 1. Świat i ślady | Lipnice 3 | Symuluje tysiące trzydniowych losów wioski z różnymi zapasami, pieniędzmi, nierównością, zasadami i modelami. |
| 2. Osiem optyk przeciw jury | LUMI (ściana selektora) | Osiem zespołów AI o różnej specjalizacji pisze teorie upadku; ślepe jury głosuje bez danych, sędzia wykonawczy mierzy błąd kodu. |
| 3. Falsyfikacja i zapadka | Laboratorium Teorii | Zespoły dostają swoje największe pomyłki, w dwóch rundach rewizji (r0 → r1 → r2) poprawiają wzór, a zapadka odrzuca pogorszenia. |
| 4. Tunel aerodynamiczny zasad | Nowy krok NOESIS | Na podstawie odkrytego prawa testuje na próbę pięć reform zasad na 240 zamrożonych wioskach. |
Świat 3 600 wiosek: dlaczego błędy w łańcuchu się nie sumują, tylko mnożą
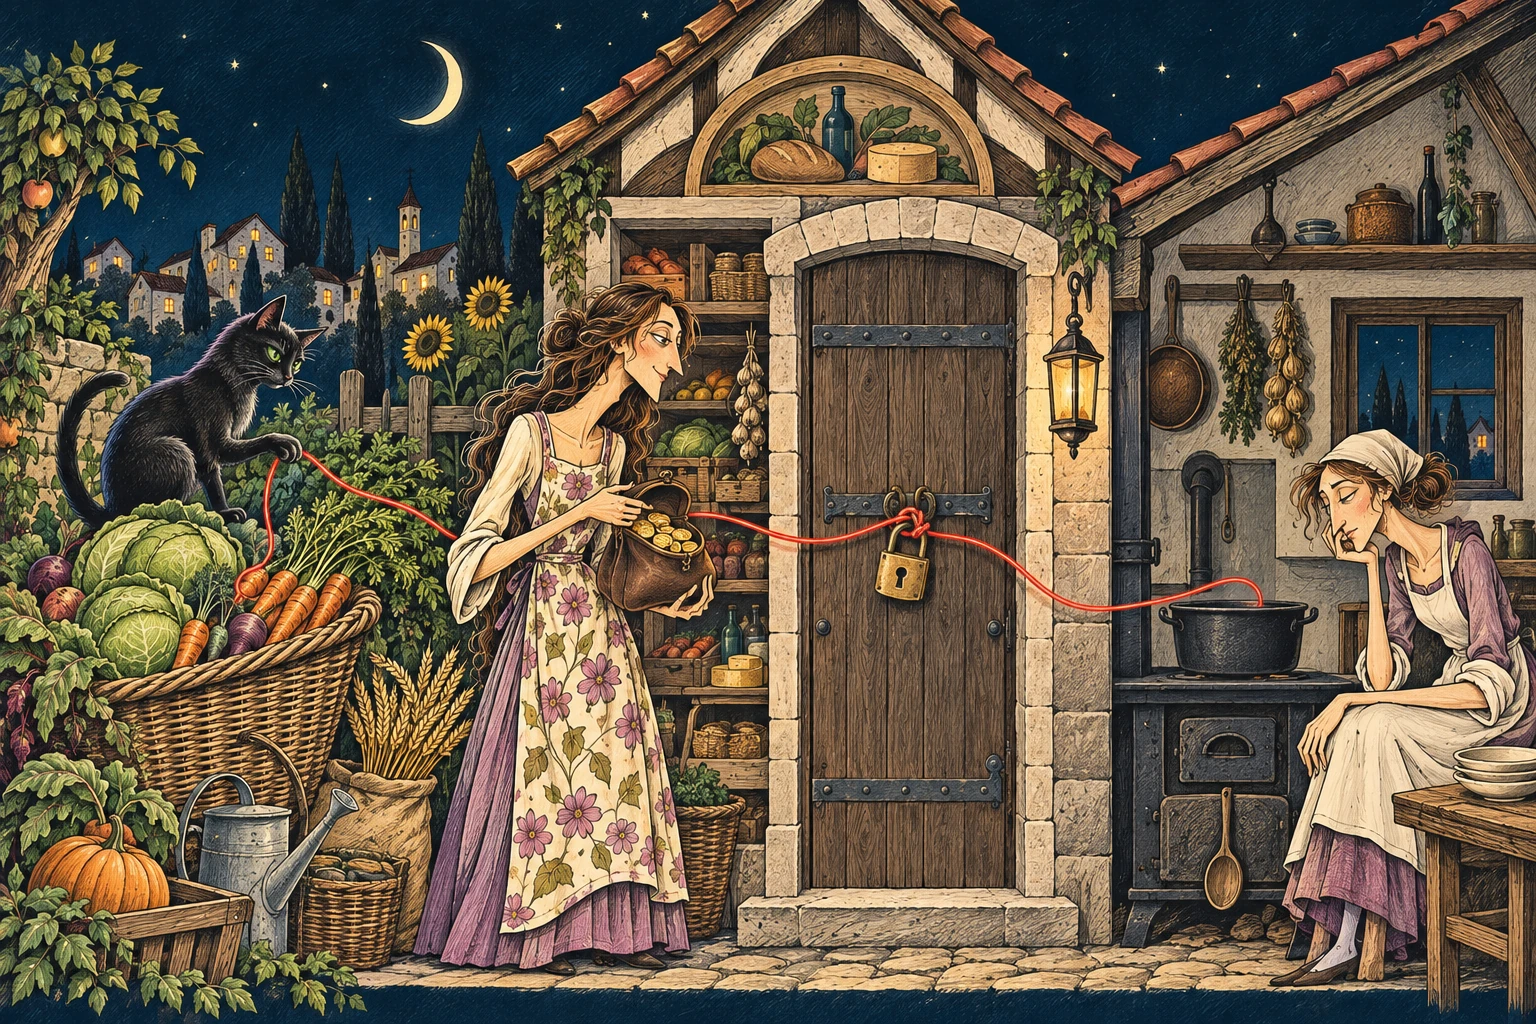
Paradoks 510 Kč: surowce z ogrodu i złote monety w sakiewce istnieją, ale dopóki na drzwiach środkowego ogniwa wisi kłódka, garnek w kuchni pozostanie zimny.
Żeby móc rzetelnie mierzyć hipotezy, przeniosłem mechanikę Lipnic 3 do szybkiego symulatora przyczynowego. Żyje w nim ośmioro mieszkańców (Eva, kucharka Anna, stolarz Tomáš, właścicielka sklepu kolonialnego Marie, karczmarz František z długiem 666 Kč, wyrobnik Petr, zielarka Ludmila i kronikarz Jan). Wioska ma przetrwać trzy dni, co oznacza 24 dzienne porcje przy cenie 100 Kč za porcję. Za upadek uznaję stan, w którym trzeciego wieczoru przeżywa mniej niż czworo z ośmiorga ludzi.
Kluczowa cecha świata jest taka sama jak w realnej gospodarce: jedzenie nie rośnie od razu na talerzu, tylko przechodzi przez łańcuch następujących po sobie kroków. Jeśli interfejs agentów ma tarcie (harness_friction) na przykład 20 %, czyli piąta część prób kończy się nieprawidłowym poleceniem, złym adresatem albo zgubioną akcją, nie traci się tylko 20 % jedzenia. Kiedy trzy kroki następują po sobie, przepustowość spada z trzecią potęgą: (1 − 0,20)³ = 0,512. Prawie połowa zdolności znika po drodze, choć magazyn jest pełny. A jeśli umrze Marie ze sklepu kolonialnego, a zasady nie pozwalają przejąć osieroconego zakładu (takeover_enabled = 0), przepustowość spada do zera.
Wygenerowałem 300 zamrożonych ustawień świata, podzielonych dokładnie jak w szkole na trzy setki:
- 100 warunków treningowych (zeszyt ćwiczeń): z nich zespoły na początku widzą próbkę 25 wiosek, a po każdej rundzie dostają średni błąd na całej setce i zestawienie swoich sześciu największych pomyłek.
- 100 warunków walidacyjnych (klasówka dla zapadki): tych zespoły nigdy nie zobaczą. Służą tylko nieprzekupnej zapadce, która przepuszcza rewizję dalej wyłącznie wtedy, gdy na walidacji dowodnie zmniejsza błąd.
- 100 warunków testowych (egzamin końcowy): zupełnie oddzielny zestaw, po który sięgnę dopiero po zablokowaniu wszystkich teorii.
Każdy z 300 warunków zasymulowałem osiem razy z różnymi losowymi rzutami (2 400 trzydniowych epizodów), żeby o wyniku nie decydował szczęśliwy traf w kapliczce. Kolejne 1 200 epizodów (5 reform × 240 wiosek) stworzyło końcowy tunel zasad. W warunkach zmieniało się dziewięć parametrów: rodzina modelu mieszkańców (gemini-3.5-flash-lite, qwen-3.8-27b, gemma-4-31b), zapas surowców (15 do 27), pieniądze w obiegu (900 do 2 400 Kč), nierówność majątkowa Giniego (0,12 do 0,62), sąsiedzki depozyt (escrow), przejęcie zakładu (takeover), tarcie interfejsu (0,03 do 0,36), szansa na pomoc anioła w kapliczce i siła koordynatorki Evy.
Dokładność mierzę średnim błędem kwadratowym (MSE) między przewidzianym prawdopodobieństwem upadku a rzeczywistym odsetkiem zakończonych upadkiem przebiegów. Zero oznaczałoby wróżbiarską zgodność bez szumu; kto za każdym razem strzela pół na pół, dostaje błąd około 0,22. Ponieważ w każdej wiosce symulator rzuca kostką osiem razy, sam test ma naturalne statystyczne dno szumu 0,0092 (przemierzone względem dokładnej wyroczni ze 160 powtórzeń). Poniżej tej granicy żadna uczciwa teoria bez kryształowej kuli zejść nie może.
Jakie rozwiązanie wybrało które podejście i dlaczego ślepe jury dało się nabrać nawet przy najmądrzejszym modelu
Zamiast osiem razy zapytać tego samego uniwersalnego asystenta, posadziłem przy stole osiem eksperckich ról (B1 do B8). Wszystkie dostały dokładnie te same dane treningowe i to samo zadanie: napisać w Pythonie czystą funkcję matematyczną predict(c) w izolowanej piaskownicy AST, bez zewnętrznych bibliotek, pętli i importów. Różniła je tylko wyjściowa optyka eksperta.
Po trzech rundach rozwoju (r0 → r1 → r2) przeprowadziłem podwójną ocenę. Najpierw zasiadło ośmioosobowe ślepe jury AI: czytało słowne uzasadnienia i przewidywania wszystkich ośmiu zespołów, ale nie miało dostępu do danych testowych ani do Pythona, dokładnie jak komisja na naradzie, która głosuje, czyja analiza brzmi najbardziej przekonująco. Potem te same osiem programów uruchomił na ukrytym teście sędzia wykonawczy NOESIS.
Zobacz, jak myślały poszczególne role i jak wypadły w trzech w pełni dokończonych turniejach (Claude Sonnet 5.5, Gemini 4 Hydrogen i flagowy Claude Fable 5.2):
| Gałąź i optyka ekspercka | Jak rozwiązywała problem | Głosy jury (Sonnet / Hydrogen / Fable 5.2) | Błąd MSE na teście (Sonnet / Hydrogen / Fable 5.2) |
|---|---|---|---|
| B1 · Klasyczny ekonomista | Szukał przyczyny w niedoborze pieniądza w obiegu i nierówności Giniego. Intuicyjna historia dla jury, ale w danych najsłabsza optyka. | 1 / 3 / 2 głosy | 0,0583 / 0,0816 / 0,0358 |
| B2 · Malthusianin zapasów | Skupił się na zwykłym deficycie kalorycznym (24 − food_supply). Brzmi to nie do obalenia, tyle że pełny magazyn wioski nie uratuje, gdy kuchnia stoi. | 4 / 2 / 2 głosy | 0,0564 / 0,0714 / 0,0227 |
| B3 · Altruista depozytu | Zaczął od wiary w sąsiedzką zbiórkę (escrow), ale po spojrzeniu na pomyłki zawrócił i dodał stromość tarcia zależną od modelu. | 0 / 2 / 1 głos | 0,0393 / 0,0564 / 0,0175 |
| B4 · Stochastyczny teolog | Wyszedł od cudów w kapliczce, ale dane zmusiły go do uwzględnienia rodziny modelu i zamkniętego zakładu; kapliczkę zostawił tylko jako tłumik. | 0 / 0 / 0 głosów | 0,0369 / 0,0382 / 0,0194 |
| B5 · Psycholog koordynacji | Rozróżnił skłonność do błędów według zdolności poznawczych modeli: słabszy Flash-Lite przy tarciu załamuje się stromiej niż Gemma-4. | 1 / 0 / 2 głosy | 0,0246 / 0,0676 / 0,0257 |
| B6 · Inżynier procesowy | Modelował straty w wielokrokowym łańcuchu. Przy Fable 5.2 napisał zwycięską teorię walidacyjną całego eksperymentu. | 2 / 0 / 0 głosów | 0,0548 / 0,0888 / 0,0170 |
| B7 · Architekt instytucjonalny | Policzył przepustowość łańcucha, ukarał nieodblokowany zakład (takeover = 0) i kruchość małych modeli. | 0 / 0 / 1 głos | 0,0437 / 0,0309 / 0,0217 |
| B8 · Syntetyk łańcucha | Połączył kwadratowe tarcie, inteligencję modelu, koordynację i instytucje w jedno nieliniowe równanie. | 0 / 1 / 0 głosów | 0,0392 / 0,0436 / 0,0160 |
W tabeli świecą dwa momenty, które pokazują ścianę selektora w pełnej nagości:
- Przy średnich modelach Architekt instytucjonalny (
B7) nie dostał ani jednego głosu z szesnastu. Jego wyjaśnienie o mnożeniu strat do trzeciej potęgi i zamkniętych zakładach brzmiało obok szlachetnych przemów o ubóstwie, kaloriach i sąsiedzkiej solidarności chłodno i technokratycznie. Tymczasem przy Gemini 4 HydrogenB7napisał w ogóle najdokładniejszą teorię całego turnieju (MSE 0,0309), a przy Sonnecie należał do zwycięskiej trójki. - Nawet najmądrzejszy model nie uchronił ślepego jury przed gładkim błędem. Kiedy zasiadło jury modelu Claude Fable 5.2, obu swoim prawdziwym mistrzom (
Inżynierowi procesowemu B6z błędem0,0170iSyntetykowi łańcucha B8z błędem0,0160) dało zgodnie zero głosów z ośmiu! Zamiast nich rozdzieliło większość głosów między Klasycznego ekonomistęB1(0,0358), MalthusianinaB2(0,0227) i PsychologaB5(0,0257). Nawet na samym szczycie dzisiejszej inteligencji sędzia wykonawczy NOESIS zmniejszył więc błąd względem głosowania jury o 33,8 % (z0,0225do0,0149).
Uwagę zwraca też moment uczciwej naukowej autorefleksji. Zespół Altruista depozytu (B3) przy modelu Claude Sonnet 5.5 dostał zadanie bronienia sąsiedzkiej solidarności. W zerowej wersji z entuzjazmem wpisał ją do wzoru i skończył z wysokim błędem 0,1281. Gdy jednak sędzia zwrócił mu konkretne wioski, w których sąsiedzi złożyli pieniądze do depozytu, a odbiorcy mimo to umarli w nocy przed pustą kuchnią, w drugiej rewizji napisał bez ogródek: „Ochronny efekt depozytu z r1 został sfalsyfikowany i zastąpiony lekko negatywnym, ponieważ sąsiedzki depozyt w przeciążonym łańcuchu dodaje dodatkowy krok.” Błąd od razu spadł do jednej trzeciej (0,0393). Dokładnie tego oczekuję od pętli naukowej: umiejętności porzucenia własnej ulubionej hipotezy pod ciężarem dowodów.
Pojedynek czterech mózgów: dokąd sięga dzisiejszy sufit inteligencji i dlaczego olbrzymi model utonął we własnych myślach
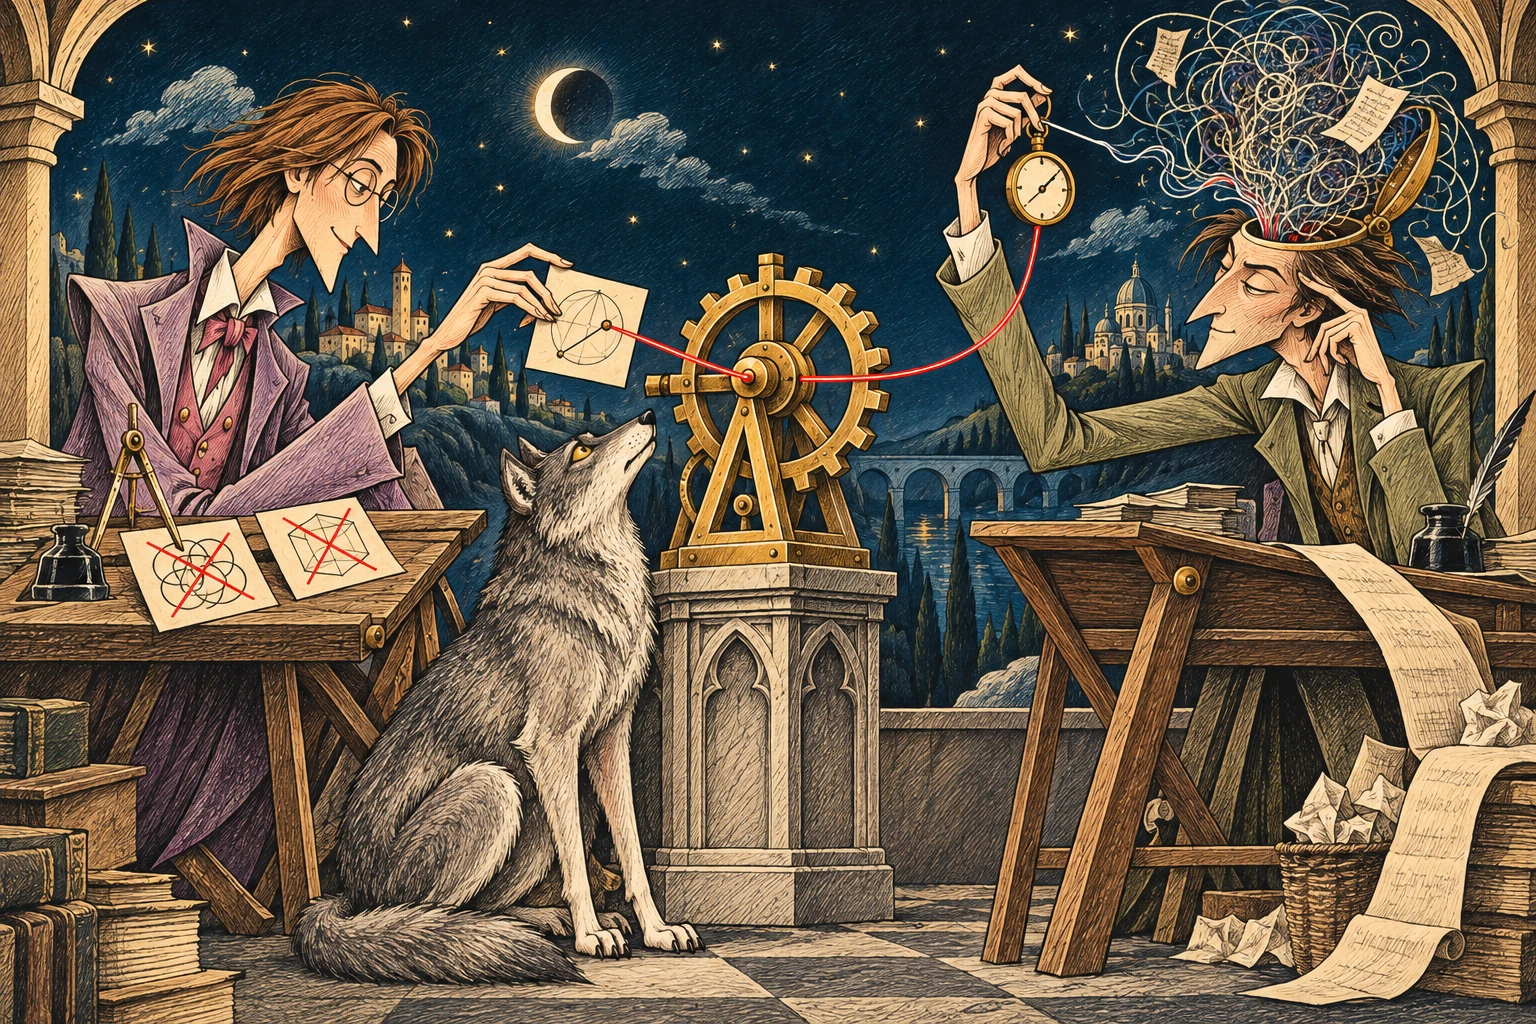
Dwa sposoby pracy naukowej: cierpliwe obalanie własnych szkiców krok po kroku (po lewej) kontra głowa przeładowana wewnętrznymi obliczeniami, którą do czystego ruchu poskramia dopiero hamulec czasowy (po prawej).
Początkowo chciałem w NOESIS porównać dwa szybkie modele robocze nowej generacji, Claude Sonnet 5.5 i Gemini 4 Hydrogen. Kiedy jednak zobaczyłem, że oba zatrzymały się tuż pod granicą błędu 0,030, nie dało mi to spokoju i zadałem sobie pytanie: czy to sufit samych danych, czy sufit ich inteligencji? Wpuściłem więc do dokładnie tego samego laboratorium także dwie najcięższe wagi dzisiejszych czasów, Claude Fable 5.2 i Gemini 4 Carbon w najwyższym trybie myślenia (High).
Wynik pięciu przebiegów pokazał przepaść między zdyscyplinowaną głębią a nieograniczonym wewnętrznym monologiem:
| Konfiguracja turnieju (8 zespołów × 3 wersje) | Czas przebiegu | Koszt API | Tokeny myślowe | Poprawki / błędy AST | Zapadka (przyjęte / odrzucone) | Końcowy błąd MSE na teście |
|---|---|---|---|---|---|---|
Claude Fable 5.2 (limit rozważań 4 200) | 245,7 s | 4,61 dolara | 80 638 | 0 (24/24 czystych) | 6 / 10 | 0,0149 (najlepsza gałąź 0,0160) |
| Claude Sonnet 5.5 | 58,9 s | 0,65 dolara | 30 110 | 4 poprawki | 9 / 7 | 0,0285 (najlepsza gałąź 0,0246) |
Gemini 4 Hydrogen (thinkingBudget = 2 200) | 56,6 s | 0,43 dolara | 33 491 | 0 (24/24 czystych) | 3 / 13 | 0,0299 (najlepsza gałąź 0,0309) |
Gemini 4 Hydrogen (bez limitu rozważań, okno 6k) | 170,3 s | 1,58 dolara | 176 141 | 24 niedokończone | bez rewizji | 0,1234 |
Gemini 4 Carbon High (effort = high, okno 32k) | 2 256 s | 13,52 dolara | 1 317 521 | 4× AST > 420 węzłów + przepełnienie 32k | 1 przyjęta (zachowane r0) | r0 gałąź B8 0,0319 (B6 0,0386) |
1. Szybka dwójka: Sonnet 5.5 iteruje, Hydrogen potrzebuje kuchennego minutnika
Claude Sonnet 5.5 przeszedł cały turniej w 58,9 sekundy i za 0,65 dolara. Jego największą bronią była pokora wobec danych: nie próbował za pierwszym razem odgadnąć doskonałego równania, przyjrzał się największym pomyłkom i w rundach r1 i r2 sensownie przebudował wzór (9 przyjętych rewizji z 16).
Kiedy zaraz potem puściłem Gemini 4 Hydrogen przez otwarty interfejs bez ograniczenia długości rozważań, czekała mnie zimna niespodzianka: 170 sekund, 176 141 tokenów myślowych i marny błąd 0,1234. Model dostał 25 wierszy tabeli i spróbował w swojej głowie z pamięci policzyć regresję nieliniową co do miejsc po przecinku przez wszystkie 25 wiosek naraz, więc za każdym razem wyczerpywał limit wyjścia, zanim wypisał def predict(c):.
Wystarczyło jednak przełączyć Hydrogen na natywny interfejs i postawić mu na stole kuchenny minutnik w postaci sztywnego budżetu thinkingBudget = 2 200 tokenów na rundę. Przemiana była natychmiastowa: 56,6 sekundy, 0,43 dolara, zero błędów składni na 24 próby i błąd fuzji 0,0299. Hydrogen okazał się przy tym świetnym strzelcem za pierwszym podejściem, który jednak przy poprawkach nie utrzyma ręki w spokoju, więc w 13 z 16 rewizji musiała go ratować zapadka przed pogorszeniem własnego wzoru.
2. Claude Fable 5.2: skok aż na fizyczne dno symulowanego świata
Użycie wagi ciężkiej Claude Fable 5.2 (z limitem 4 200 tokenów myślowych na krok) od razu odpowiedziało na pytanie, czy wyższa inteligencja przyniesie głębszy naukowy wgląd. Fable za 4,61 dolara nie zawahał się w ani jednej z 24 kompilacji i zbił błąd zweryfikowanej fuzji NOESIS do 0,0149, czyli prawie o połowę względem Sonneta i Hydrogena. Wszystkie jego osiem zespołów eksperckich zmieściło się w wąskim paśmie od 0,0160 do 0,0358.
Jeszcze ciekawsze jest przeliczenie względem czystej wyroczni ze 160 powtórzeń każdej wioski, które odfiltrowuje przypadkowy szum ośmiu rzutów kostką (0,0092). Podczas gdy Sonnet i Hydrogen miały względem prawdziwego prawdopodobieństwa świata błąd 0,0222 i 0,0224, Claude Fable 5.2 spadł do 0,0097 (średnie odchylenie poniżej dziesięciu punktów procentowych w setce niewidzianych światów, wyprowadzone z zaledwie 25 wierszy tabeli treningowej!). Wymazał tym samym ponad 70 % pozostałego możliwego do usunięcia błędu, do którego średnie modele nie dosięgły.
Co dokładnie Fable 5.2 zobaczył w danych? Porównaj jego czystą funkcję z gałęzi Syntetyk łańcucha (B8, MSE = 0,0160, w drugiej rewizji na teście nawet 0,0146) z tym, co pisały mniejsze modele:
def predict(c):
    fam = c['model_family']
    kmap = {'gemini-3.5-flash-lite': 200.0, 'qwen-3.8-27b': 130.0, 'gemma-4-31b': 50.0}
    k = kmap.get(fam, 120.0)
    fr = float(c['harness_friction'])
    coord = float(c['coord_bonus'])
    eff = fr * (1.0 - 0.5 * coord)
    shortage = max(0.0, 24.0 - float(c['food_supply']))
    z = -0.45 + k * eff * eff
    z = z - 1.0 * float(c['takeover_enabled'])
    z = z - 0.3 * float(c['escrow_enabled'])
    z = z - 2.0 * float(c['angel_prob'])
    z = z + 0.10 * shortage
    z = z + 0.5 * (float(c['gini_inequality']) - 0.33)
    z = max(-10.0, min(10.0, z))
    p = 1.0 / (1.0 + math.exp(-z))
    p = max(0.03, min(0.97, p))
    return clamp(p)
Mniejsze modele najczęściej dodawały rodzinę modelu tylko jako stały narzut (+0,8 dla Flash-Lite, −0,5 dla Gemmy). Fable 5.2 zrozumiał z 25 obserwacji prawdziwą fizykę mojego symulatora: że koordynatorka Eva najpierw tłumi efektywne tarcie eff = fr * (1.0 - 0.5 * coord), to tarcie następnie rośnie w łańcuchu z kwadratem eff * eff, a każdy model ma wobec niego wielokrotnie inną stromość upadku (k = 200 dla kruchego Flash-Lite, 130 dla Qwena i 50 dla odpornej Gemmy-4). Dokładnie odtworzył ukryty mechanizm iloczynowy świata, nie widząc ani jednej linijki jego kodu źródłowego.
3. Gemini 4 Carbon High: 1,32 miliona tokenów myślowych i ratunek bezpiecznikiem
Zupełnie inną historię napisał flagowy Gemini 4 Carbon w trybie High. Ponieważ natywny interfejs przy Carbonie ignoruje sztywny liczbowy thinkingBudget, a w trybie High kieruje się tylko poziomem wysiłku, otworzyłem mu przez interfejs z wysokim wysiłkiem olbrzymie okno wyjściowe 32 000 tokenów na jedną odpowiedź (pięć razy większe niż w zwykłym przebiegu), żeby miał pełną swobodę myślenia.
W rundzie zerowej (r0) Carbon High pokazał wspaniały wgląd: za 4,01 dolara siedem z jego ośmiu zespołów naukowych od razu napisało mocne wzory z błędem poniżej 0,042 (Syntetyk B8 trafił 0,0319, Architekt B7 0,0340, Altruista B3 0,0384 i lider walidacji Inżynier procesowy B6 0,0386).
Ale gdy tylko w rundach r1 i r2 dostał listę swoich sześciu największych pomyłek i polecenie doprecyzowania wzoru, nieograniczona głębia myślenia zamieniła się w pułapkę:
- Ptolemeuszowe epicykle w kodzie: Zamiast piętnastowierszowego prawa Carbon High próbował wyjaśnić każde odchylenie olbrzymim, rozgałęzionym drzewem warunków. Cztery jego próby uderzyły w bezpieczny sufit piaskownicy na złożoność wzoru (
424,442,537i rekordowe 600 węzłów AST wobec dozwolonych420). - Przepełnienie nawet 32-tysięcznego okna: W kolejnych dziewięciu rewizjach zaczął w głowie ręcznie optymalizować układy nieliniowe przez dziesiątki wierszy tabeli. Potrafił w jednym wywołaniu opisać wewnętrznym monologiem wszystkie 32 000 tokenów i skończyć, zanim w ogóle wypisał
def predict(c):. - Ratunek zapadką i hamulcem budżetowym: Przez 46 wywołań Carbon High spalił niewiarygodne 1 317 521 tokenów myślowych za 13,52 dolara, aż na ostatnich dwóch równoległych wątkach zadziałał mój dwudziestodolarowy bezpiecznik laboratorium (przez osiem równolegle dobiegających wątków łączny rachunek całego dnia, ze wszystkimi modelami i ilustracjami, zatrzymał się na 22,35 dolara). Gdyby nie piaskownica AST i zapadka NOESIS, Carbon High przepisałby w rewizjach prawie wszystkie swoje świetne teorie z pierwszej rundy pustymi próbami. Zapadka wadliwych rewizji jednak nie przepuściła i zachowała jego czyste hipotezy z
r0.
Z tego porównania płynie cenny w praktyce wniosek: surowa inteligencja modelu ujawnia się w pełni dopiero wtedy, gdy dostanie sztywne ramy. Claude Fable 5.2 z rozsądnym budżetem na rozważania potrafił z 25 wierszy wydobyć praktycznie całą informację, jaką zawierał świat. Natomiast równie ambitny olbrzymi model puszczony w rewizjach z łańcucha wydał trzy razy tyle na przeliczanie miejsc po przecinku w głowie.
Tunel aerodynamiczny zasad: dlaczego dotacje się spaliły, a naprawa drogi uratowała 90 % wiosek
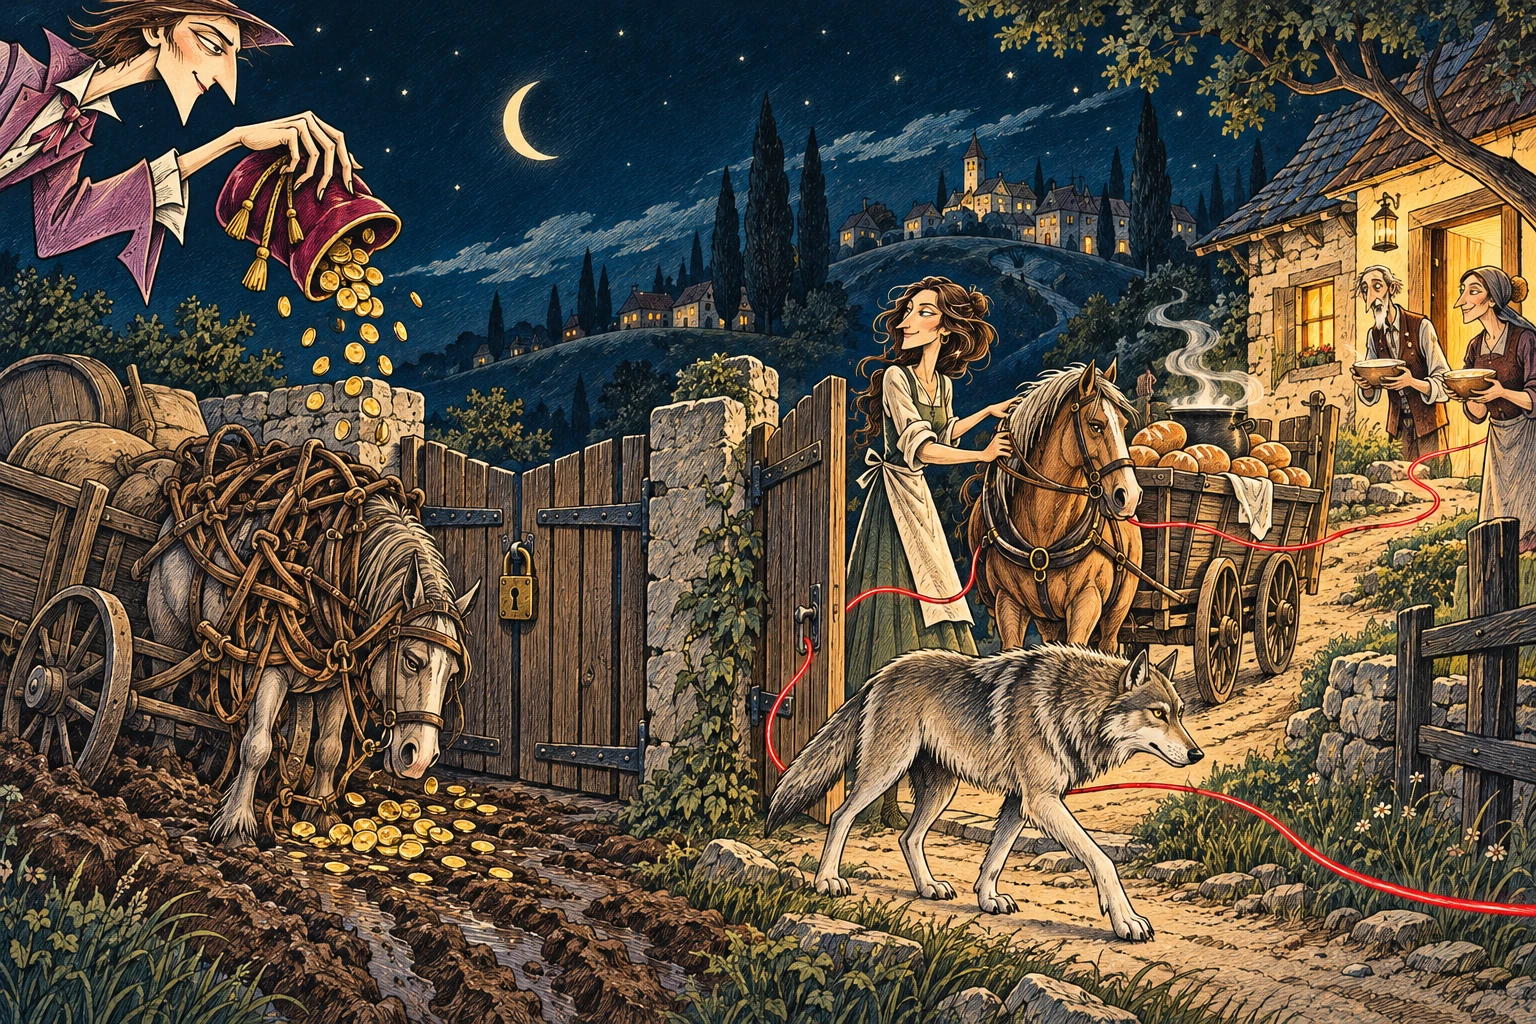
Sypanie złotych monet przed zamkniętą bramę i poplątaną uprząż (po lewej) wozu nie ruszy. Odemknięcie przejścia uprawnień i wyprostowanie uprzęży bez ani jednej monety więcej (po prawej) dowiezie zupę na czas.
Odkrycie równania upadku to tylko połowa pracy. Sens połączenia Lipnic i Laboratorium Teorii polegał na tym, żeby sprawdzić, czy odkryte prawo pomoże naprawić same zasady świata, podobnie jak inżynier lotniczy wsuwa model skrzydła do tunelu aerodynamicznego, zanim zbuduje samolot.
Wziąłem więc 240 zamrożonych wiosek (po 80 przebiegów dla gemini-3.5-flash-lite, qwen-3.8-27b i gemma-4-31b) i wszystkim ustawiłem ten sam surowy niedobór z prawdziwych Lipnic 3: tylko 21 jednostek żywności na 24 dzienne potrzeby. Nie zmieniałem mieszkańców ani losowych rzutów. Kolejno na dokładnie tych samych 240 światach wypróbowałem pięć interwencji instytucjonalnych (P0 do P4):
| Interwencja w zasady świata (zawsze 21 surowców na 24 potrzeby) | Przeżywa wiosek | Średnio żywych z 8 | Niezjedzone jedzenie w magazynie | Bogate zgony z pieniędzmi w kieszeni |
|---|---|---|---|---|
| P0 · Stan wyjściowy (bez przejęcia zakładu, 20 % tarcia, 1 400 Kč) | 12,1 % | 1,77 | 12,6 porcji | 4,34 osoby |
| P1 · Powszechna dotacja +1 000 Kč (2 400 Kč, niska nierówność Giniego 0,15, test B1) | 13,3 % | 1,72 | 12,9 porcji | 6,20 osoby |
| P2 · Sąsiedzki depozyt Escrow (wpłaty na cudze zamówienie, test B3) | 16,7 % | 2,00 | 12,0 porcji | 5,04 osoby |
| P3 · Przejęcie zakładów + kapliczka 35 %, dawne 17 % tarcia (stan z Lipnic 3) | 35,0 % | 3,10 | 9,5 porcji | 2,86 osoby |
| P4 · Projekt NOESIS (przejęcie zakładu + czysty interfejs z 4 % tarcia, 0 Kč dotacji) | 90,0 % | 5,17 | 3,9 porcji | 1,31 osoby |
Liczby z tunelu składają się na zupełnie jasny obraz:
- Dlaczego dotacja się spaliła (
P1): Kiedy wlałem do wioski tysiąc koron więcej i wyrównałem różnice majątkowe, przeżywalność ruszyła z 12,1 % na 13,3 %, czyli w granicach statystycznego szumu. Za to liczba ludzi, którzy zmarli z głodu z pełnym portfelem, wyskoczyła z 4,34 na 6,20 z ośmiu. Pieniądze nie mogły przejść przez zamknięty sklep kolonialny. Dotacja nie rozwiązała przyczyny, tylko podrożyła umieranie. - Dlaczego nie wystarczyła dobra wola (
P2): Sąsiedzki depozyt przesunął przeżywalność na 16,7 %. Pomógł tam, gdzie biednemu brakowało pięćdziesięciu koron przy otwartej ladzie, ale był bezsilny w chwili, gdy nie było komu wydać surowców. - Co zdecydowało w projekcie NOESIS (
P4): Nie dodałem ani korony dotacji, nie dodałem ani jednego ziemniaka i nie liczyłem na modlitwy w kapliczce. Zrobiłem tylko dwie rzeczy strukturalne, na które wskazały zwycięskie teorie we wszystkich modelach: pozwoliłem żywym przejąć osierocony zakład (takeover = 1) i oczyściłem tarcie w interfejsie sterowania z 17 do 20 % do 4 % (jednoznaczne identyfikatory adresatów, walidacja zamówień, bezpośrednie przekazanie kroku). Przeżywalność wyskoczyła do 90,0 %. Nawet najmniejszy i najtańszy modelgemini-3.5-flash-liteprzeżył w tak naprawionych zasadach w 82,5 % przypadków (qwen-3.8-27bw 91,2 % igemma-4-31bw 96,2 %).
Proste wnioski: co z tego eksperymentu zabrać do praktyki
Kiedy oderwę się od równań i Pythona, cały eksperyment mówi cztery całkiem zwyczajne rzeczy każdemu, kto zarządza firmą, projektuje zasady albo buduje systemy ze sztuczną inteligencją:
- Nie myl niedoboru zasobów z zatkaną rurą. Kiedy w firmie czy w usłudze publicznej wynik się zacina, pierwszym odruchem bywa dosypać pieniędzy, ogłosić program dotacji albo zatrudnić kolejnych ludzi. Jeśli jednak proces opiera się na tym, że po odejściu jednego człowieka nikt nie ma uprawnień do zatwierdzenia zamówienia albo że w każdym z trzech przekazań ginie piąta część informacji, większy budżet tylko wyprodukuje droższy korek. Odblokowanie zastępowalności i zmniejszenie tarcia między krokami bywa o rząd wielkości skuteczniejsze.
- Głosowanie bez miarki wybiera najlepszego mówcę, a nie najlepsze rozwiązanie. Dotyczy to narady zarządu tak samo jak wieloagentowych systemów AI i, jak pokazał eksperyment z Claude Fable 5.2, nie znika nawet przy najmądrzejszym modelu na rynku. Intuicyjna historia („mamy mało pieniędzy”) w ankiecie pokonuje nieintuicyjną matematykę („trzy drobne dwudziestoprocentowe straty pod rząd zabierają połowę wydajności”). Gdy tylko się da, nie pozwalaj AI ani ludziom tylko głosować nad hipotezami. Niech zapiszą prognozę tak, żeby dało się ją przeliczyć na przypadkach z przeszłości.
- Najwyższa inteligencja potrzebuje zarówno minutnika, jak i zapadki. Skok z
0,0285u Sonneta do0,0149u Fable 5.2 pokazał, że najmądrzejsze modele potrafią dziś z małej próbki danych odkryć prawie całe ukryte prawo systemu. Jednocześnie jednak przypadki Gemini 4 Hydrogen i Gemini 4 Carbon High bez hamulca ostrzegają: jeśli dasz myślącemu modelowi nieograniczoną przestrzeń do wewnętrznego monologu, łatwo spali ponad milion tokenów na ptolemeuszowe pętle i pogorszy własny pierwszy wgląd. Budżet na myślenie, limit złożoności wzoru i walidacyjna zapadka oszczędzają jednocześnie pieniądze i jakość. - Dobra uprząż wynosi nawet mały model ponad duży w chaosie. Mały
gemini-3.5-flash-litew czystym interfejsie i przy przejezdnych zasadach (82,5 %) miażdżąco pokonał siedem razy większe modele uwięzione w źle zaprojektowanym świecie (12,1 %). Inwestycja w czyste środowisko wokół agentów zwraca się szybciej niż ślepa pogoń za najdroższym modelem.
Ograniczenia: czego ten eksperyment nie dowodzi
Podobnie jak przy poprzednich eksperymentach chcę dokładnie nazwać granice, poza które moje liczby nie sięgają:
- Badam model świata, a nie żywą ludzką gminę. Symulator w NOESIS wiernie przejmuje ustalone wąskie profile z Lipnic 3 (trzykrokowy łańcuch, osierocone zakłady, dług 666 Kč, kapliczkę i różną skłonność modeli do błędów), ale nadal są to napisane przeze mnie zasady. Zespoły AI nie odkryły więc nowego prawa natury o ludzkim społeczeństwie. Potrafiły jednak z samych zapisów 25 do 100 przebiegów dokładnie odtworzyć ukryty mechanizm świata, którego kodu źródłowego nie widziały, a przy modelu Claude Fable 5.2 zbliżyły się aż do teoretycznej granicy statystycznego szumu.
- Ślepe jury oceniało bez kalkulatora. Jurorzy oceniali tekst i prognozy, nie mogąc sami uruchomić wzoru na danych. To było zamierzone: chciałem zmierzyć czystą różnicę między oceną według przekonującego rozumowania a oceną według uruchomienia kodu. Jury wyposażone w Pythona decydowałoby inaczej.
- Wynik Gemini 4 Carbon High odzwierciedla zachowanie bez sztywnego budżetu myśli. Podczas gdy przy Hydrogenie natywny interfejs posłuchał parametru
thinkingBudget = 2 200, a przy Fable 5.2 zadziałał limit4 200tokenów na rozważania, Carbon w trybieHighsterował długością rozważań tylko poziomem wysiłku. Jego przepełnienie 32-tysięcznego okna w rewizjach nie świadczy więc o tym, że nie umie pisać wzorów (w rundzie zerowej trafił0,0319), ale o tym, jak niebezpieczne jest puszczenie głębokiego myślenia do poprawiania błędów bez twardego hamulca tokenowego.
Mimo to z NOESIS mam cichą radość. Trzy projekty, nad którymi w ostatnich miesiącach pracowałem wieczorami, czyli czeska wioska z ośmioma postaciami, tysiące godzin na północnym superkomputerze i małe laboratorium falsyfikowalnych wzorów, wskoczyły w siebie jak koła zębate jednej zapadki. I wskazały kierunek, w którym chcę iść dalej: od sztucznej inteligencji, która o świecie tylko przekonująco opowiada, do takiej, która swoje pomysły musi uczciwie wypracować na faktach.