Wilki i kruki w Core War: osiem instrukcji wśród faworytów
Jak z AI rozwinęliśmy Wolf Ravena i Lone Wolfa złożonego z ośmiu instrukcji. Trzy rankingi, prawdziwe obrazy areny i słabości ukryte za najlepszą średnią.

Osiem instrukcji. Tyle ma Lone Wolf, jeden z wojowników przygotowanych z pomocą AI do Core War. Mimo to w dużym sprawdzianie uplasował się tuż za Wolf Ravenem liczącym sto instrukcji i przed wcześniejszym faworytem, Kompasem. Dobry pomysł czasem naprawdę mieści się w kilku linijkach.
W moim projekcie Dungeon pracowali agenci w Codexie i Claude Code. Zadanie było konkretne: zaprojektować wojowników, zmierzyć ich wyniki przeciwko stałej grupie przeciwników oraz oddać kod i rezultaty. Kolejne ulepszenia dały nam wilki i kruki, trzy sposoby wyszukiwania i eliminowania rywala.
Eksperyment z 10 października 2026, końcową walidację dodano 11 października. Ilustracja wilka i kruka na początku powstała z AI. Prawdziwe obrazy areny i zmierzone wyniki są poniżej. Interfejs areny jest czeski, wykresy angielskie.
Co się udało
- Wolf Raven i Lone Wolf prowadzą wśród pięciu porównywanych programów przeciwko tym samym 25 przeciwnikom. Każdy rozegrał 50 000 walk.
- Lone Wolf potrzebuje zaledwie ośmiu instrukcji. Długość programu niewiele mówi o jego sile.
- Raven Scout pokonał Wolf Ravena w 71 ze 100 bezpośrednich walk w osobnym teście zgłoszeń. Najlepsza średnia nie gwarantuje zwycięstwa z każdym.
Arena, na której nadpisuje się kod przeciwnika
Wyobraźcie sobie wspólne pole z 8 000 komórek pamięci. Każda może zawierać instrukcję. Dwa programy wykonują polecenia na zmianę i mogą nadpisywać całe pole, włącznie z kodem rywala. Wykonanie DAT kończy aktualny proces. Kto straci wszystkie procesy, przegrywa.
Wojownik może tworzyć kolejne procesy albo kopiować się w inne miejsca. Dlatego pojedyncze trafienie nie musi wystarczyć. Najpierw trzeba znaleźć przeciwnika, a potem ograniczyć jego drogi ucieczki.
Podczas walki model językowy nie podejmuje decyzji. AI pomagała wcześniej projektować i poprawiać programy. Na arenie działa sam Redcode, niewielki język przypominający asembler, bez kolejnych wywołań modelu przy każdym ruchu.
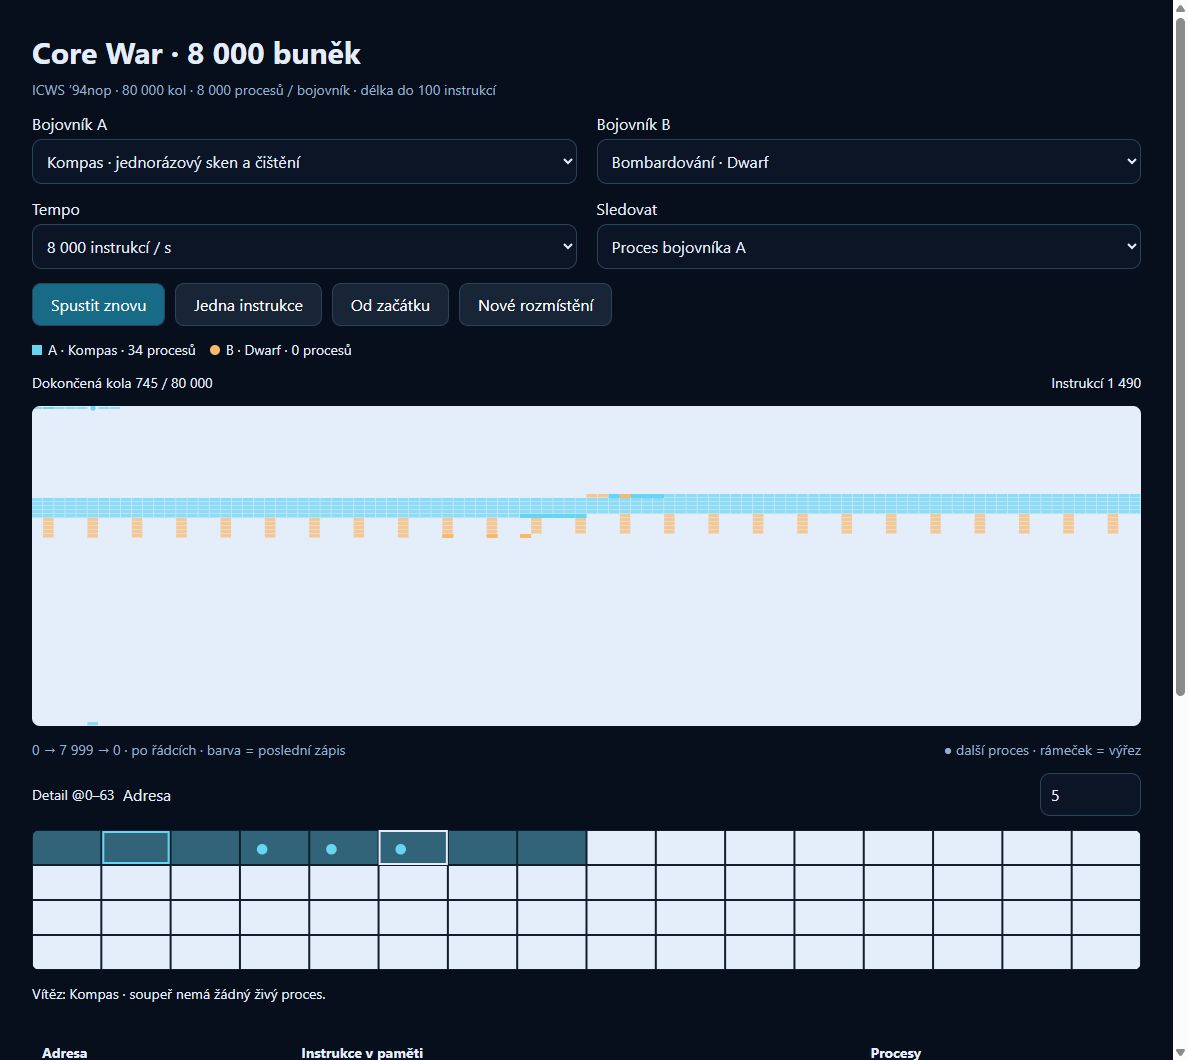
W tym pojedynczym starciu Kompas pokonał Dwarfa. Kolory wskazują program, który ostatnio zapisał daną komórkę. Obraz ilustruje grę; ranking wymaga wielu walk.
Kamień, nożyce, papier z komplikacjami
| Strategia | Działanie | Typowa słabość |
|---|---|---|
| Bombardier | Rozrzuca niszczące instrukcje po pamięci. | Może omijać mały lub przeniesiony cel. |
| Skaner | Szuka śladów, a potem atakuje. | Szukanie kosztuje czas; replikator może uciec. |
| Replikator | Tworzy kopie i rozprasza ryzyko. | Skuteczne czyszczenie pamięci usuwa kopie. |
| Imp | Wciąż kopiuje jedną instrukcję do przodu. | Przetrwanie często daje remis zamiast zwycięstwa. |
To tendencje, a nie gwarantowane wyniki. Liczą się instrukcje, pozycje startowe i zestaw rywali. W naszej pierwotnej grupie szczególnie dobrze wypadały skanery. Właśnie do tego znanego środowiska dostrajaliśmy nowych wojowników.
Pierwszy ranking: pierwotna stawka
Pełny turniej 26 wojowników, każdy z każdym, obejmował 32 500 walk, po 2 500 na wojownika. Pierwsza dziesiątka:
| Miejsce | Wojownik | Punkty / 100 |
|---|---|---|
| 1 | Kompas | 230,00 |
| 2 | Scanny Boy | 229,12 |
| 3 | Žnec | 211,72 |
| 4 | Rave | 207,48 |
| 5 | Aeka | 197,24 |
| 6 | Fénix | 190,24 |
| 7 | Core Explorer Paper | 180,24 |
| 8 | Hydra | 177,04 |
| 9 | Flash Paper 3.7 | 169,04 |
| 10 | Bastion | 161,84 |
Wynik nie jest procentem zwycięstw. Wygrana daje 3 punkty, remis 1, porażka 0. Przeliczamy punkty na 100 walk, więc maksimum wynosi 300. Sto remisów daje 100 punktów, sto wygranych 300.
Poznajcie wilki i kruki
Wolf Raven, 100 instrukcji: szybkie rozpoznanie, przeniesienie części bojowej, szukanie śladów i atak czyszczący. Instrukcje SPL mnożą procesy rywala i go spowalniają, a DAT je kończą. Zapasowy Imp daje dodatkową szansę przetrwania. Wilk i kruk to metafory części jednego programu, nie dwa rozmawiające ze sobą modele.
Wolf Raven dostraja parametry King Cobry autora inversed. Korzystamy z istniejącej konstrukcji, nie przypisujemy sobie jej wynalezienia.
Lone Wolf, osiem instrukcji: jego rodowód prowadzi od Scanny Boya Davida van Dama przez Kompas rozwijany z Codexem do dalszych zmian w Claude Code. Mały cel i kierunek ataku pomagają tutaj przeciwko Impowi i Dwarfowi. Gorzej radzi sobie z niektórymi strategiami łączącymi różne techniki.
Raven Scout, 89 instrukcji: wywodzi się z CLRSRC Stefana Kammanna i Forge-AI, opartego na Eternal Exile autora inversed. Po ograniczonym ataku wraca do poszukiwań. Ma inne korzystne pojedynki niż wilki, ale cała trójka należy do szerokiej rodziny skanerów.
To nie jest kontrolowany benchmark Codexu i Claude Code. Różniły się metody pracy, dostępne materiały i wcześniejsze etapy. Z wyników wojowników nie można wywnioskować ogólnej przewagi jednego modelu AI.
Drugi ranking: ci sami przeciwnicy dla wszystkich
Po zamrożeniu kodu przeprowadzono większą walidację na 1 000 pozycjach startowych i w obu kolejnościach ruchów. Do głównego porównania wybrałem zapisane walki z tymi samymi 25 przeciwnikami dla wszystkich pięciu programów, po 50 000 walk na program.
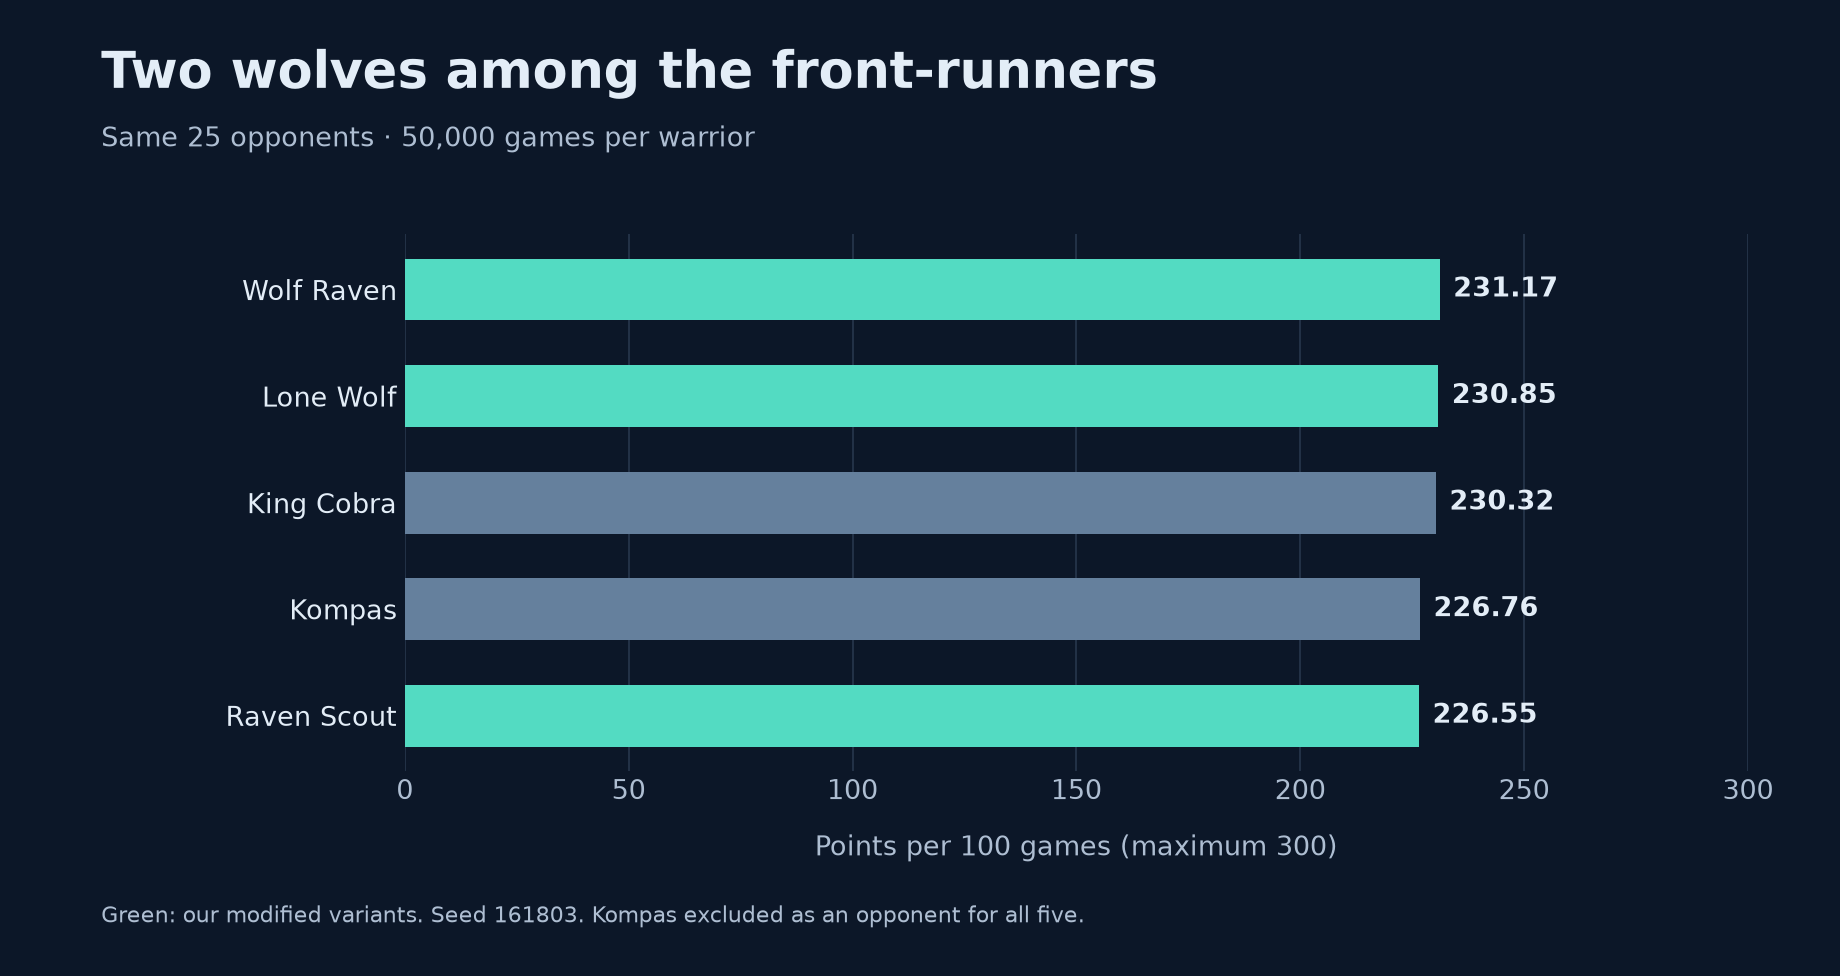
| Miejsce | Wojownik | Punkty / 100 |
|---|---|---|
| 1 | Wolf Raven | 231,17 |
| 2 | Lone Wolf | 230,85 |
| 3 | King Cobra | 230,32 |
| 4 | Kompas | 226,76 |
| 5 | Raven Scout | 226,55 |
Oba wilki wyprzedziły Kompas i oryginalną King Cobrę. To cieszy. Wolf Raven prowadzi jednak nad Lone Wolfem tylko o 0,314 punktu na 100 walk. Tak mała różnica nie dowodzi trwałej dominacji. Raven Scout jest tutaj tuż za Kompasem.
Dlaczego 25 zamiast 26? Kompas sam należy do grupy referencyjnej. Pozostawienie go oznaczałoby, że porównawczy Kompas walczy również z własną kopią. Usunąłem więc tego przeciwnika jednakowo dla wszystkich pięciu programów. Pozostałe wyniki się nie zmieniają. Oryginalne dane dla 26 rywali są dostępne poniżej.
Średnia ukrywa słabości
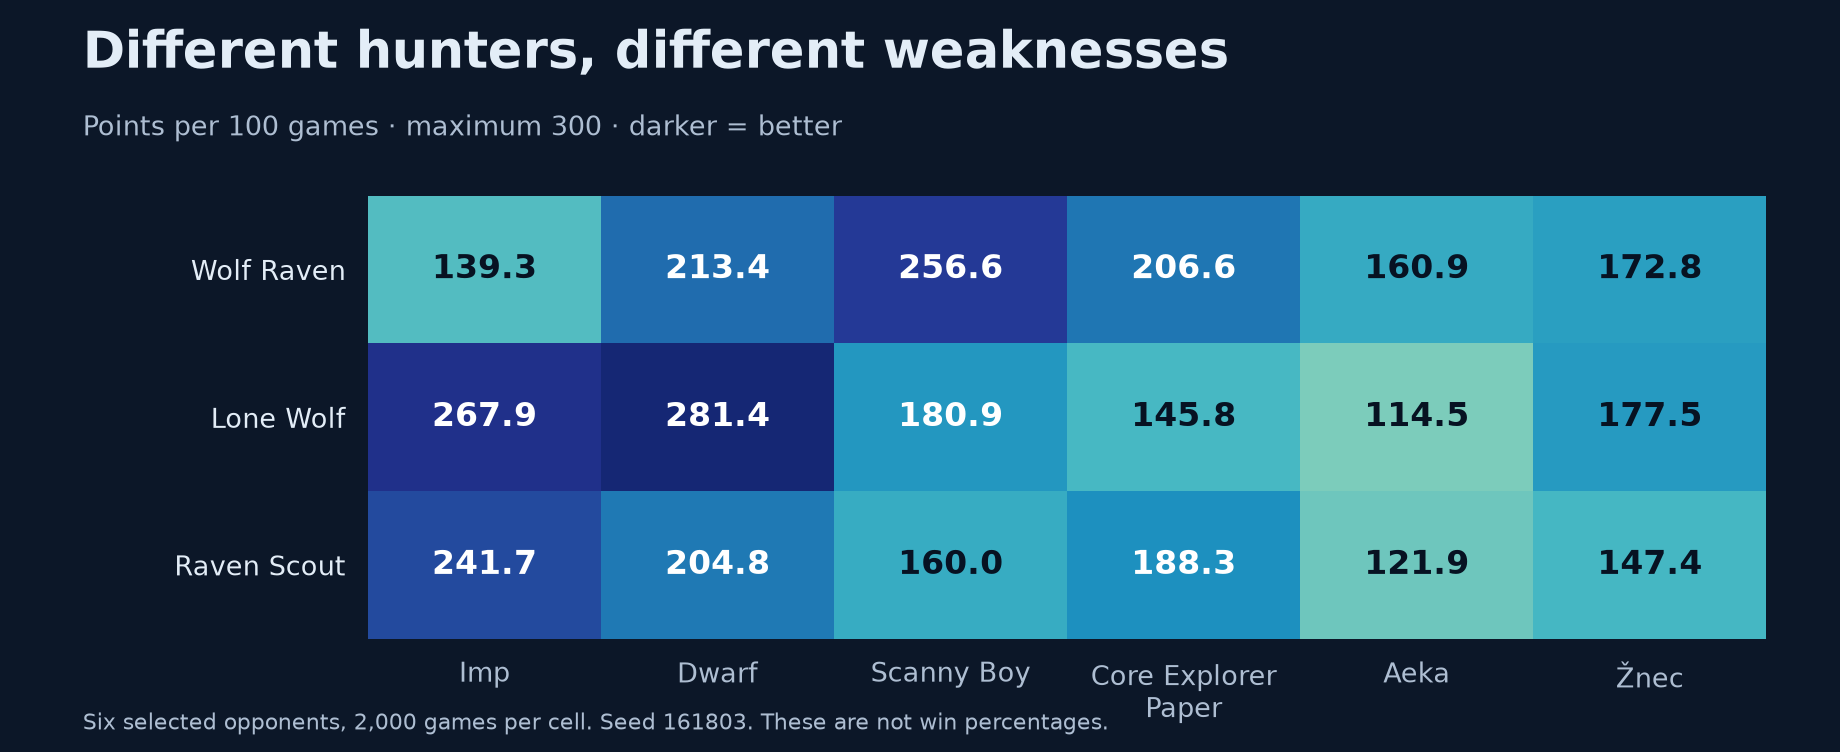
Każde pole obejmuje 2 000 walk i pokazuje punkty na 100 walk, nie procent zwycięstw. Sześciu rywali ilustruje różne słabości; główny ranking uwzględnia wszystkich wspólnych 25.
Wolf Raven ani razu nie przegrał z Impem, ale 1 607 z 2 000 pojedynków zakończyło się remisem. Dobrze przeżywa, lecz Lone Wolf zbiera w tej parze więcej punktów. Ten z kolei traci przeciwko Aece. To cenniejsza wskazówka do dalszych poprawek niż samo miejsce w tabeli.
Trzeci ranking: także przeciwko rodzeństwu
W osobnym teście zgłoszeń każdy nowy wojownik walczył z 26 rywalami referencyjnymi i pozostałymi dwoma nowymi wojownikami, łącznie 2 800 walk:
| Wojownik | Wygrane | Remisy | Porażki | Punkty / 100 |
|---|---|---|---|---|
| Wolf Raven | 1971 | 468 | 361 | 227,89 |
| Raven Scout | 2045 | 186 | 569 | 225,75 |
| Lone Wolf | 1953 | 294 | 553 | 219,75 |
Raven Scout pokonał Wolf Ravena 71:26, z trzema remisami, a Lone Wolfa 74:26. Wolf Raven pokonał Lone Wolfa 83:16, z jednym remisem. Raven Scout potrafi polować na nasze wilki, ale pozostałe pary nie pozwalają mu osiągnąć najlepszej średniej.
Test obejmuje tylko pary z co najmniej jednym nowym wojownikiem. Nie jest pełnym turniejem wszystkich 29 programów i nie wyłania nowego ogólnego mistrza.
Co nie zadziałało
Więcej myśliwych w większej watasze brzmiało obiecująco. We wspólnej pamięci mogą jednak nadpisywać własne kryjówki albo niszczyć siebie nawzajem. Więcej elementów nie oznaczało automatycznie lepszego wyniku.
Pułapki kryły się też w testowaniu. Wariant świetny na małej grupie pozycji startowych mógł stracić przewagę gdzie indziej. Regularny krok skanowania może ponadto myląco zbiegać się z regularnie rozmieszczonymi startami. Liczy się cykl: pomysł, pomiar, analiza słabości, poprawka i nowa walidacja. Przekonujący komentarz AI nie zastępuje walk.
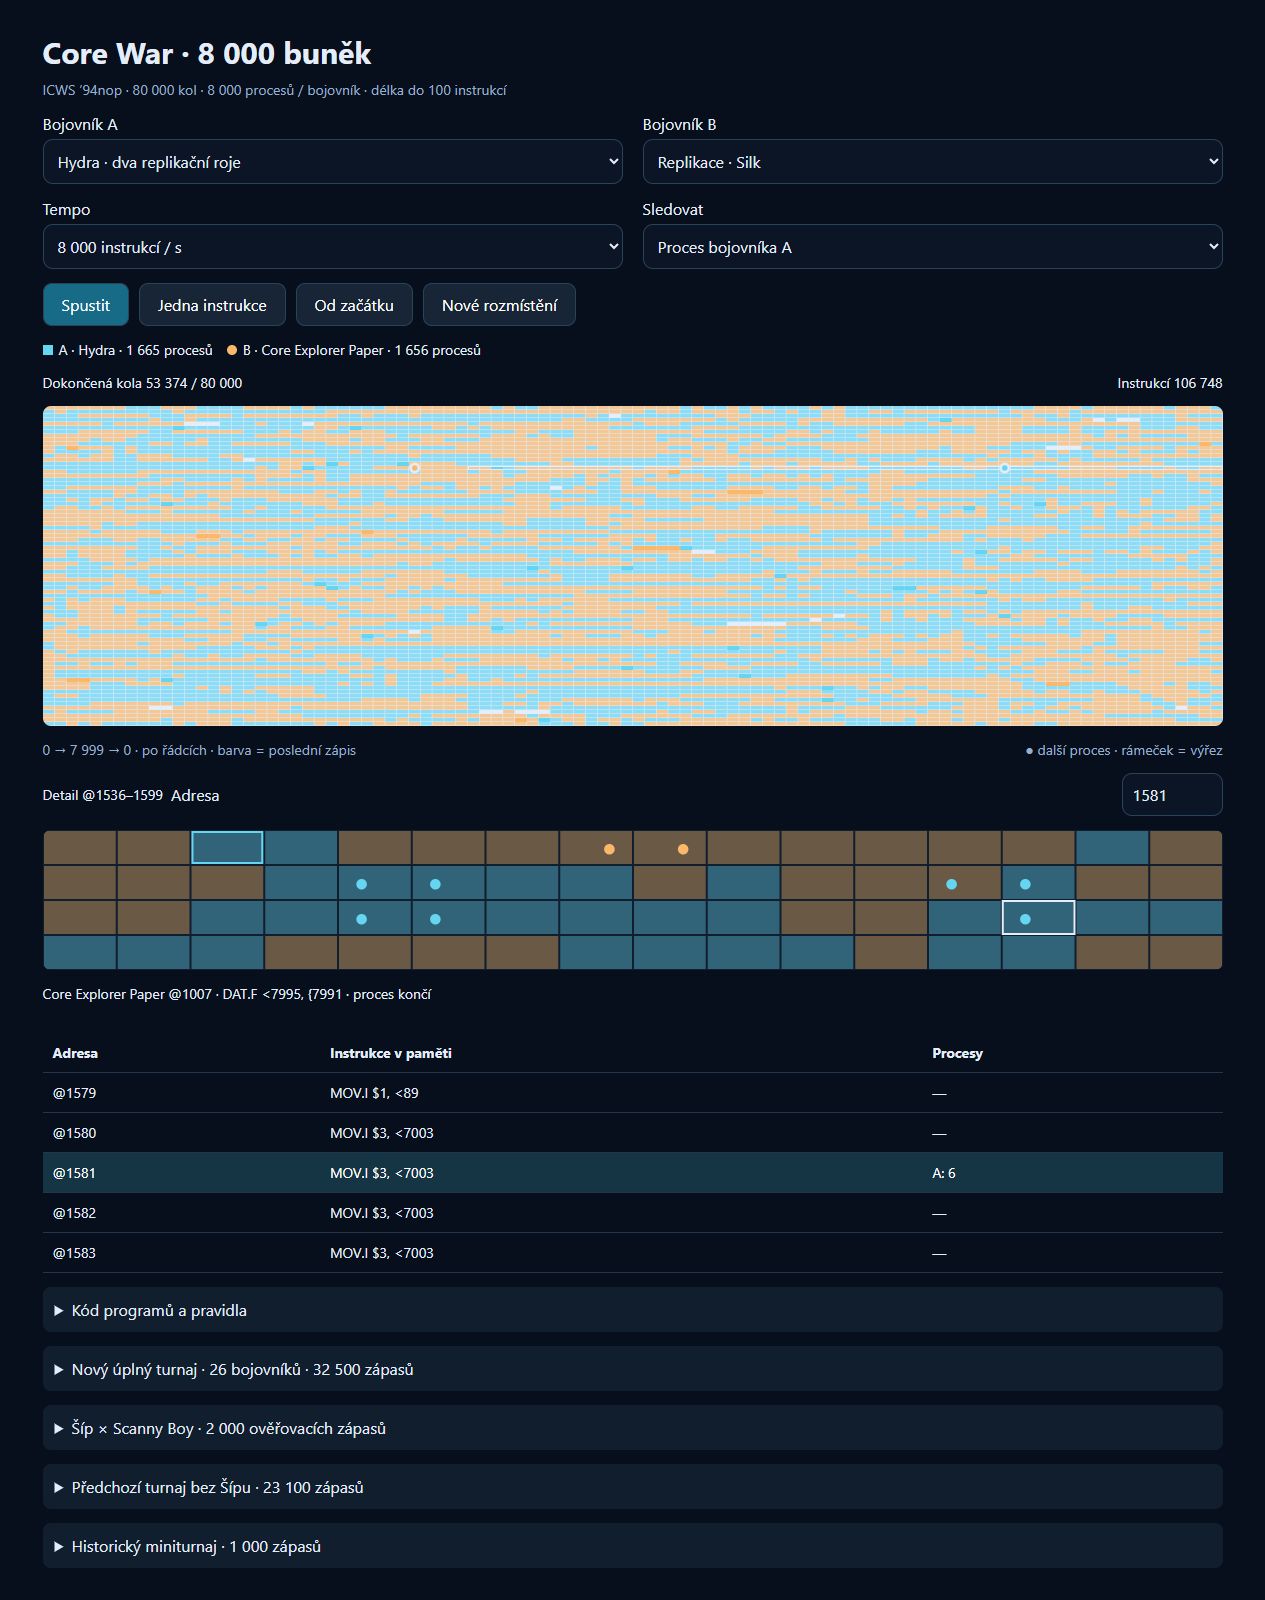
Kolor pokazuje ostatni zapis, nie trwałe posiadanie pola. Tysiące procesów wyjaśniają, dlaczego jeden trafiony cel nie musi rozstrzygać pojedynku.
Związek z badaniami
Digital Red Queen zespołów Sakana AI i MIT również wykorzystuje modele językowe do rozwijania wojowników przeciwko rosnącej historii przeciwników. Nasz mniejszy eksperyment zadaje podobne pytanie: jak środowisko kształtuje skuteczną strategię?
Naszych punktów nie można bezpośrednio porównać z tą publikacją. Inne są grupy rywali, ewolucja i ocena. Test kilku plików z repozytorium nie odtwarza opublikowanego eksperymentu. Szczegóły opisuje praca Digital Red Queen.
Dokąd wysłać watahę dalej
Najpierw do pełnego turnieju z powiększoną stawką. Potem przeciwko silnym rywalom, na których nigdy nie dostrajaliśmy programów. Ciekawi mnie też zestaw uzupełniających się wojowników: specjalista mógłby pokryć słabe pojedynki najlepszego uniwersalnego programu.
Czy AI pozwala nam nie tylko produkować więcej kodu, lecz także rozpoznawać, które pomysły działają i dlaczego? Nasze wilki są obiecującą odpowiedzią dla jednej areny. Teraz trzeba sprawdzić, co przetrwa poza nią.
Wyniki, kod i warunki testu
- Główne porównanie i wszystkie pary referencyjne (JSON)
- Ranking wspólnych 25 rywali (CSV)
- Pierwotny turniej 26 wojowników (JSON)
- Podsumowanie testu zgłoszeń (JSON)
- Szczegółowe wyniki zgłoszeń (JSON)
- Dziennik dużej walidacji (TXT)
- Dane i trzej nasi wojownicy w jednym pakiecie (ZIP)
- Redcode: Wolf Raven, Lone Wolf, Raven Scout.
Metodyka i ograniczenia
Własna implementacja ICWS ’94nop w JavaScript, nie oryginalny program pMARS. Pamięć: 8 000 komórek. Limity: 8 000 procesów na wojownika, 80 000 rund (do 160 000 wykonanych instrukcji w pojedynku dwóch programów), 100 instrukcji na program. Punkty: (3 × wygrane + remisy) / walki × 100.
Pierwotny turniej: seed 6101003, 50 pozycji i obie kolejności. Test zgłoszeń: seed 20261011, także 50 pozycji i obie kolejności. Duża walidacja: przyspieszony silnik, seed 161803, 1 000 pozycji. Dziennik rozwoju podaje 1 900 porównań silnika przyspieszonego i referencyjnego z identycznymi wynikami i liczbą kroków. To kontrola, nie formalny dowód równoważności.
Nowe pozycje ograniczają dopasowanie do startów, ale przeciwnicy pozostają znani. Nie jest to dowód generalizacji na niewidziane strategie. Nie podajemy przedziałów ufności i nie przedstawiamy niewielkich różnic jako statystycznie udowodnionej przewagi. Pakiet zawiera naszych trzech wojowników i wyniki, a nie kompletne wykonywalne środowisko ze wszystkimi przeciwnikami.