Ich habe 300 Zwerge mit der Seele von Pragern erschaffen: Rekord von 264.081 Tok/s und 719,6 Menschen/s, höhere Qualität bremst auf 45 Tausend
Ich habe 300 einzigartige virtuelle Prager in natürlichem Tschechisch erschaffen, mit 45.192 Tok/s (fertig in 17,34 s). Als ich dann die Architektur der Aufrufe änderte und der reinen Obergrenze bei Geschwindigkeit und Preis nachjagte, trieb ich den Schwarm auf 264.081 Token pro Sekunde, erschuf 719,6 neue Prager pro Sekunde (742,0 befragte pro Sekunde) und drückte den Preis auf 0,31 Kč pro tausend Menschen.
Stellen Sie sich vor, Sie haben statt eines einzigen großen KI-Beraters in einer Holzkiste auf dem Tisch 300 winzige digitale Zwerge. Jeder hat seinen eigenen Bleistift, seine eigene Wohnung in einem anderen Prager Viertel, seinen eigenen Gehaltszettel und seinen eigenen Grund, warum er morgens in der Straßenbahn oder im Stau auf der Jižní spojka flucht. Als wir von ihnen wirklich schönes, natürliches Tschechisch und Überlegungen auf dem Niveau großer Modelle vom Typ GPT verlangten, liefen sie mit einer Geschwindigkeit von 45.192 Token pro Sekunde über den Tisch und füllten alle 300 Fragebögen in 17,34 Sekunden ohne einen einzigen Fehler aus. Als wir aber gleich darauf die Architektur der Aufrufe selbst umbauten und der reinen Obergrenze bei Geschwindigkeit und Preis nachjagten, trieben wir den Schwarm bis auf 264.081 Token pro Sekunde, konnten 719,6 neue Prager pro Sekunde erschaffen (und 742,0 pro Sekunde befragen) und drückten den Preis bis auf 0,31 Kč pro tausend Menschen.
Beides schließt sich dabei nicht aus, nur zahlen Sie für die Qualität in einer anderen Münze. Je natürlicheres Tschechisch, je tiefere Überlegung und je genauerer Kontext nahe an großen Flaggschiff-Modellen Sie verlangen, desto spürbarer bremst der reale Tokenfluss. Alle konkreten Namen von Modellen und Anbietern behalten wir in der Küche, unten finden Sie die genauen Zahlen, die Sackgassen und die fünf architektonischen Vorgehensweisen, die darüber entschieden haben.
Genau das haben wir beim Entwurf der Arbeitsteams in Hyperprostor ausprobiert. Wir wollten, dass jedes Dokument, jedes Budget und jede Präsentation vor der Abgabe von mehreren künstlichen Persönlichkeiten in der Rolle des Publikums gelesen wird und diese sagen, wo sie sich verloren haben. Aus Angst um die Rechnung und die Geschwindigkeit haben wir in der ursprünglichen Spezifikation das Publikum aber vorsichtig auf 3 bis 5 Leser und die Parallelität auf 4 Schritte begrenzt.
Dann haben wir unter der Haube von Hyperprostor einen stillen Arbeiter in exakt derselben Preisklasse wie GPT Luna getestet (zehn Cent pro Million Eingabe-Token und fünfzig Cent pro Million Ausgabe-Token, also rund 2,30 Kč und 11,50 Kč), der im unabhängigen Vergleich Artificial Analysis Intelligence Index aber etwa 36 Punkte sammelt gegenüber 27–28 Punkten bei GPT Luna (und im agentischen AutomationBench ungefähr 37,8 % gegenüber 20,2 %). Seinen genauen Namen behalten wir in der Küche. Uns interessierte nur eines: Wie viele solcher Zwerge hält die Schnittstelle gleichzeitig aus, ohne einen einzigen Fehler 429, und fallen aus ihnen nützliche Gedanken oder nur teures Rauschen?
Eine kurze filmische Vorstellung des gesamten Versuchs (Ton einschalten): Alle 300 Zwerge kratzen vor einem Notebook gleichzeitig mit dem Bleistift auf ihrem Fragebogen, bis einer von ihnen laut Luft ablässt: „Auf Vinohrady zahle ich ein Vermögen für eine Kiste.“
300 Fensterchen auf einem einzigen Bildschirm
Eine geskriptete Simulation nach den exakten Millisekunden-Logs aller 300 parallelen Threads (P001 bis P300), nebeneinander in einem Raster von 20 × 15 auf einem einzigen Bildschirm. Mit dem Mauszeiger klappen Sie eine Live-Lupe unter der Wand auf, mit einem Klick öffnen Sie die vollständige Karte samt Reaktion des Pragers.
Damit die Zwerge keine leeren Phrasen schreiben, bekamen sie eine echte Aufgabe in vier Schritten:
- Erschaffung von 300 einzigartigen Pragern (
P001bisP300): so geschichtet, dass es genau 37 % Hochschulabsolventen gab (111von300), das Medianalter bei 39 Jahren lag (18bis84Jahre) und das Nettoeinkommen zwischen8.000 Kčund135.000 Kč(Median 42.000 Kč). Vom Fleischer in der Markthalle in Holešovice, der Kostümbildnerin aus Barrandov, dem Lokführer der Metro C und dem blinden Klavierstimmer bis zur ukrainischen Krankenschwester in Krč, dem Uhrmacher im Ruhestand oder dem Spieleentwickler aus Karlín. - 300 Zwerge füllten gleichzeitig den Fragebogen Prager 2026 aus (fertig in 17 Sekunden): Alle
300Persönlichkeiten starteten in einem einzigen Moment (Promise.all). Der ganze Schwarm war in 17 Sekunden fertig (genau 17,34 s), alle 300 von 300 lieferten beim ersten Versuch gültiges JSON ohne einen einzigen Fehler429, mit einer Geschwindigkeit von über 45.000 Token pro Sekunde (45.192 Tok/s) und für nur 9,47 Kč. - 300 Leser prüften unser Produkt in zwei Runden: Zuerst bewertete jeder der 300 Prager für sich den Entwurf der Arbeitsteams in Hyperprostor mit der Denkbremse
effort = "low"(8,91 s, 35.460 Tok/s, reiner sichtbarer Text 10.387 Tok/s, Preis 4,39 Kč). Danach teilten wir sie auf sechzig Wirtshaustische mit je fünf Personen auf, an denen jeder die Einwände seiner vier Nachbarn sah (7,09 s,33.640 Tok/s). - Belastungsleiter von 1 bis 300 gleichzeitigen Threads: Jeder Aufruf trug eine eindeutige ID, damit man nicht per Cache schummeln konnte, und jede Welle maß die Flüssigkeit der Antworten bis an die Grenze von dreihundert gleichzeitigen Modellen.
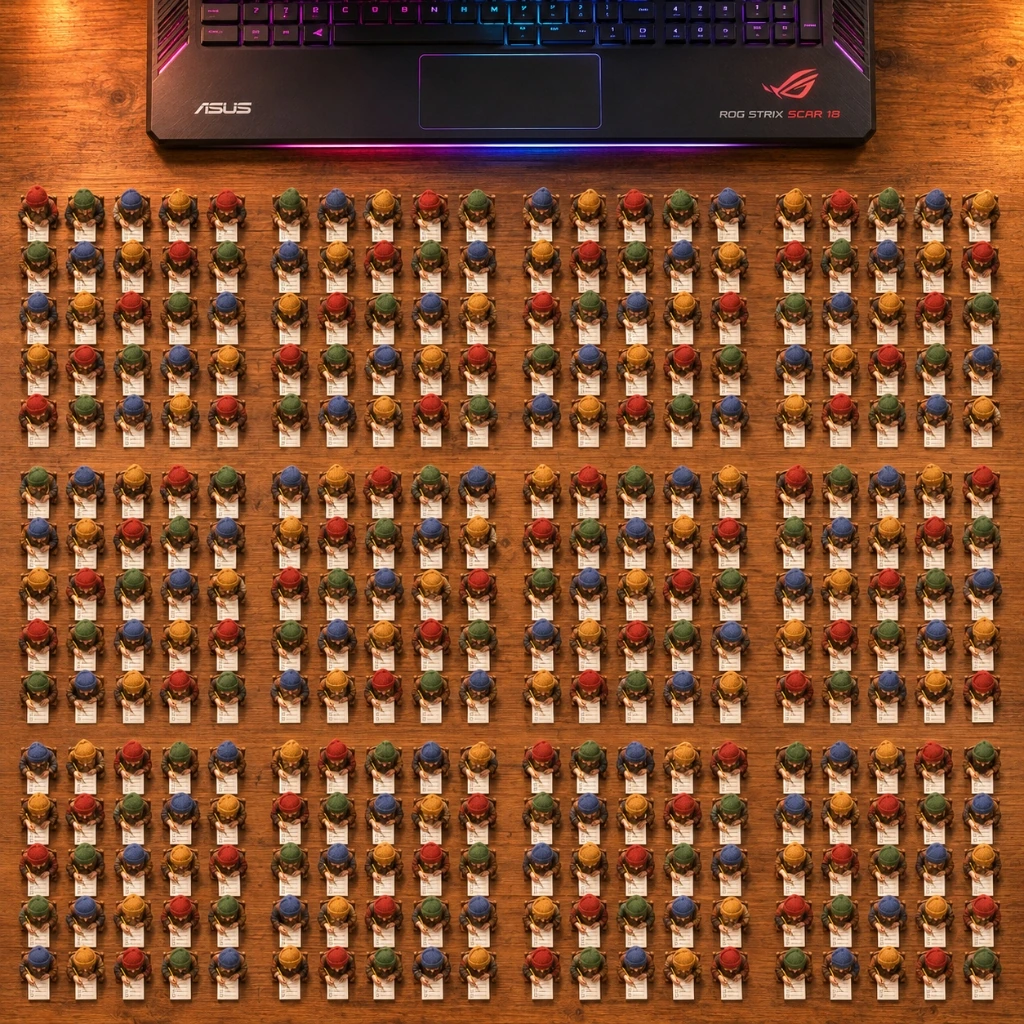
Blick von oben auf alle 300 Zwerge, aufgereiht auf dem Tisch vor dem Notebook (12 Blöcke mit je 5 × 5 Schreibern = genau 300 gleichzeitige Fragebögen in einem einzigen Moment).
Über 45.000 Token pro Sekunde: 300 Prager in 17 Sekunden fertig
Als in alle 300 Threads gleichzeitig lebendige virtuelle Prager mit vollständigen Lebensläufen und einer offenen Frage einstiegen, schoss die Gesamtleistung des Schwarms auf über 45.000 Token pro Sekunde (45.192 Tok/s), und alle dreihundert waren in 17 Sekunden fertig (17,34 s, 783.544 Ausgabe-Token für 9,47 Kč). Auch in der separaten synthetischen Belastungsleiter mit einem kurzen technischen Prompt skalierte die Schnittstelle von einem einzigen Fenster bis C = 300 ohne einen einzigen Fehler 429 im Tempo von 31.876 Tok/s (23,94 s, 9,00 Kč).
| Parallelität | Erfolg | Zeit der ganzen Welle | Median (p50) | 95. Perzentil (p95) | Leistung des Schwarms | Sichtbarer Text | Preis der Welle |
|---|---|---|---|---|---|---|---|
| 1 Fenster | 1 / 1 (100 %) | 6,83 s | 6,83 s | 6,83 s | 468 Tok/s | 33 Tok/s | 0,04 Kč |
| 10 Fenster | 10 / 10 (100 %) | 8,79 s | 5,57 s | 8,65 s | 2.615 Tok/s | 237 Tok/s | 0,27 Kč |
| 50 Fenster | 50 / 50 (100 %) | 16,44 s | 6,58 s | 10,84 s | 7.873 Tok/s | 654 Tok/s | 1,51 Kč |
| 100 Fenster | 100 / 100 (100 %) | 19,39 s | 6,86 s | 11,46 s | 13.519 Tok/s | 1.111 Tok/s | 3,06 Kč |
| 150 Fenster | 150 / 150 (100 %) | 14,91 s | 7,35 s | 10,69 s | 23.915 Tok/s | 2.150 Tok/s | 4,17 Kč |
| 200 Fenster | 200 / 200 (100 %) | 22,18 s | 8,12 s | 12,11 s | 23.031 Tok/s | 1.926 Tok/s | 5,96 Kč |
| 300 Fenster (Leiter) | 299 / 300 (99,7 %) | 23,94 s | 9,18 s | 13,96 s | 31.876 Tok/s | 2.685 Tok/s | 9,00 Kč |
| 300 Prager (Fragebogen) | 300 / 300 (100 %) | 17,34 s | ~8,5 s | ~13,2 s | 45.192 Tok/s | 4.062 Tok/s | 9,47 Kč |
300 Prager (effort="low") | 300 / 300 (100 %) | 8,91 s | ~5,1 s | ~7,6 s | 35.460 Tok/s | 10.387 Tok/s | 4,39 Kč |
Unter der Decke dieser riesigen Geschwindigkeit steckt aber ein wichtiges technisches Detail:
- Jeder Zwerg murmelt neun Zehntel der Zeit vor sich hin: In der Standardwelle der 300 Prager entfielen von den insgesamt 783.544 Token ganze 91,0 % (713.109 Token) auf unsichtbare innere Überlegungen, und nur 4.062 Tok/s machte das eigentliche Ausgabe-JSON aus.
- Warum der einzige Läufer aus der Leiter ausfiel (und warum alle 300 Prager mit Reserve durchkamen): In der ersten Leiter
C = 300(Limit 8.192 Token) verfing sich der Thread#096in Überlegungen bei8.190von8.192Token und lieferte beiHTTP 200ein leeres JSON zurück. Sobald wir die Reserve auf10.240Token anhoben, kamen 300 von 300 Pragern sauber im ersten Anlauf durch. - Die Zauberbremse
effort = "low": Als wir dieselben 300 Zwerge mitreasoning: { effort: "low" }in die Bewertung von Hyperprostor schickten, sank der Anteil der Überlegungen auf 70,7 %, die ganze Welle von dreihundert Agenten war nach 8,91 s fertig, die sichtbare Ausgabe sprang auf 10.387 Token pro Sekunde, und der Preis fiel auf unter die Hälfte (4,39 Kč für 300 Leser).
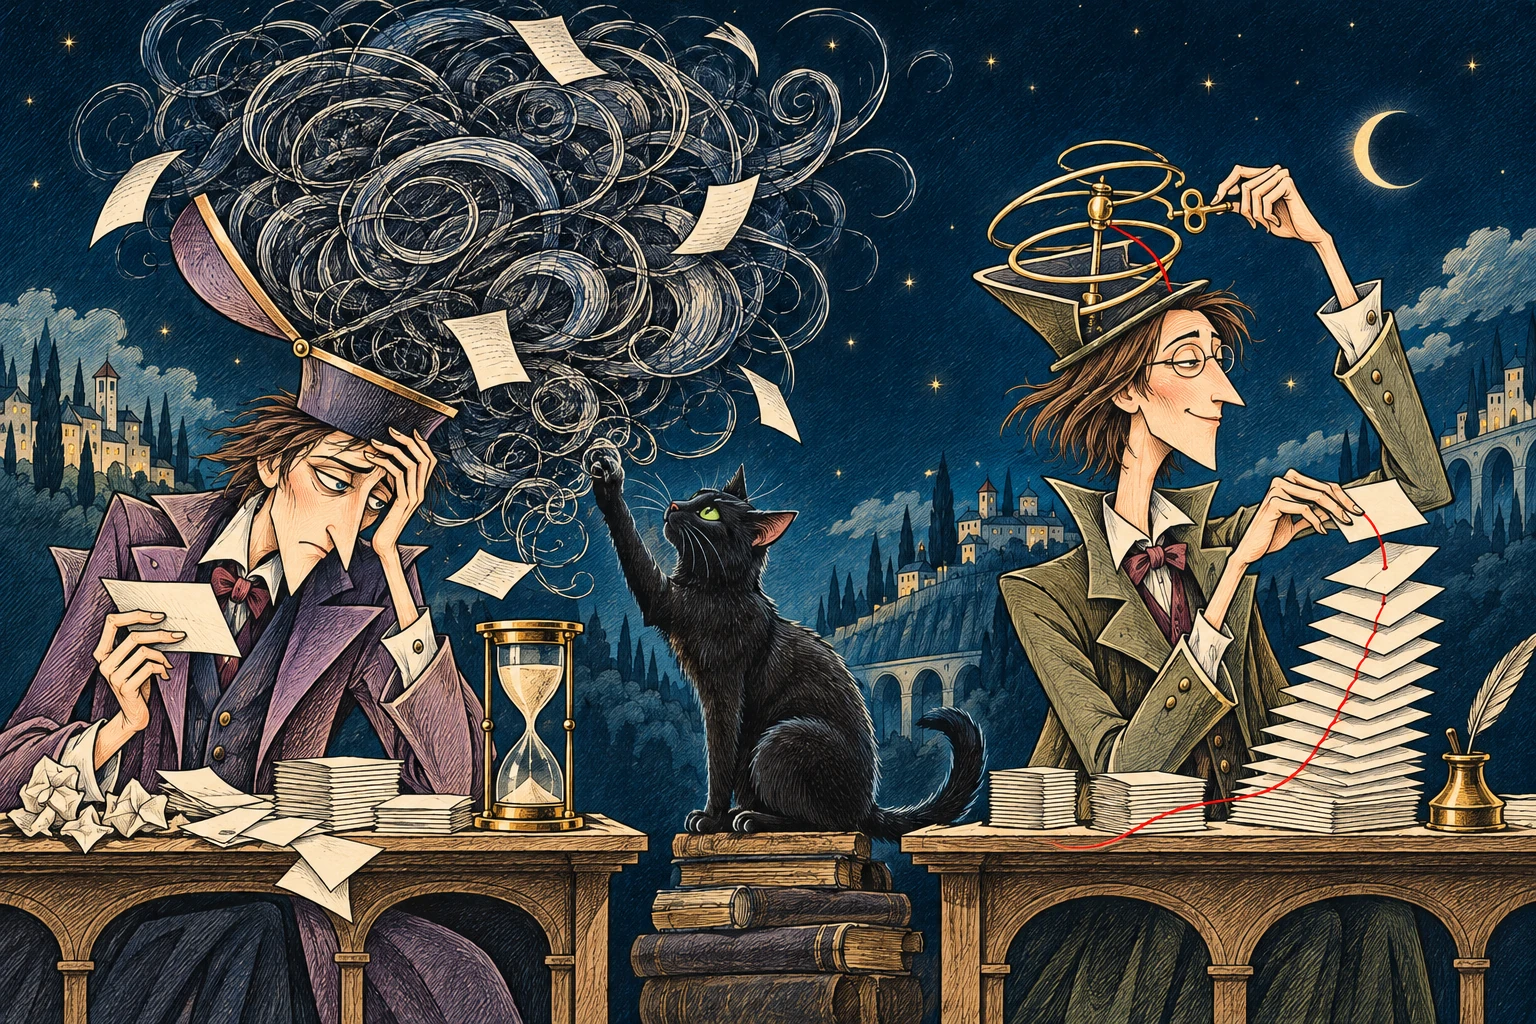
Das innere Murmeln zu zähmen lohnt sich: Der Standardmodus verbrennt über 90 % der Leistung in inneren Schleifen (links), während die einfache Bremse effort="low" die Zeit auf 8,9 Sekunden und die Rechnung auf die Hälfte drückt (rechts).
Haben die Antworten des sparsamen Schwarms Hand und Fuß?
Geschwindigkeit umsonst wäre uns nichts wert, wenn aus den dreihundert Fenstern Unsinn fiele. Als wir aber alle 300 Prager danach sortierten, wie sie sich durch die Stadt bewegen, und nach dem Vorschlag einer Maut von 100 Kč pro Tag für die Einfahrt mit dem Auto in die erweiterte Innenstadt im Austausch für einen gestärkten öffentlichen Nahverkehr fragten, hielt das Ergebnis eine unerwartet scharfe ökonomische Logik:
| Verkehrsmittel des Befragten | Anzahl Prager | Für die Maut | Gegen die Maut | Unentschlossen |
|---|---|---|---|---|
| Nur ÖPNV | 143 | 133 | 4 | 6 |
| Kombination / zu Fuß / Fahrrad | 80 | 68 | 11 | 1 |
| Nur Auto | 77 | 0 | 77 | 0 |
| Stichprobe gesamt | 300 | 201 | 92 | 7 |
Alle siebenundsiebzig ausschließlichen Autofahrer stimmten 0 : 77 dagegen, während die ÖPNV-Fahrgäste 133 : 4 dafür stimmten (und die wenigen Unentschlossenen lieferten den völlig rationalen Zweifel, dass sie dem Magistrat nicht trauen, die eingenommenen Gelder wieder in die Verbindungen zu lenken).
Noch wertvoller war die Prüfung unseres eigenen Entwurfs der Arbeitsteams in Hyperprostor über alle 300 Profile hinweg (Gesamtnote 3,34 → 3,47, Bereitschaft zum Ausprobieren für einmalige 50 Kč 59,0 % → 47,3 %):
- IT und Management (
n = 29): Note 2,83 → 2,83, Bereitschaft zum Ausprobieren für 50 Kč 96,6 % → 96,6 %. - Selbstständige und Kleinunternehmen (
n = 61): Note 3,03 → 3,21, Bereitschaft zum Ausprobieren für 50 Kč 86,9 % → 68,9 %. - Lehrer und Dozenten (
n = 21): Note 3,05 → 3,24, Bereitschaft zum Ausprobieren für 50 Kč 85,7 % → 76,2 %. - Studenten (
n = 18): Note 3,11 → 3,33, Bereitschaft zum Ausprobieren für 50 Kč 77,8 % → 61,1 %. - Öffentliche Verwaltung, Gesundheitswesen und Kultur (
n = 50): Note 3,22 → 3,44, Bereitschaft zum Ausprobieren für 50 Kč 64 % → 46 %. - Arbeiter und Berufe im Betrieb (
n = 99): Note 3,67 → 3,77, Bereitschaft zum Ausprobieren für 50 Kč 31,3 % → 21,2 %. - Senioren (
n = 22): Note 4,09 → 4,09, Bereitschaft zum Ausprobieren für 50 Kč 4,5 % → 4,5 %.
Hören Sie sich acht konkrete Stimmen aus allen dreihundert an:
- Ondřej Marek (
P013, 28 Jahre, IT-Entwickler, Vršovice, 68.000 Kč): „Bei 80 % Limit hört es doch auf zu korrigieren, ich riskiere also etwas Unfertiges, das ich dann sowieso komplett neu schreiben muss. Und bei Arbeitsunterlagen würde ich auch über Vertrauen und Privatsphäre nachdenken – was macht das System damit, wer haftet für Fehler.“ (Note 2 → 2, 50 Kč: JA; unklar: Rollen wie Setzer und Grafiker kommen mir unnötig übertrieben vor, und ein ‚Prüfer aus einer anderen Modellfamilie‘ klingt vor allem nach Marketing. Und mir ist nicht klar, was passiert, wenn 50 Kč für ein ordentliches Dokument einfach nicht reichen – das kommt mir wie der Hauptknackpunkt vor.) - Hana Kučerová (
P021, 36 Jahre, Grundschullehrerin, Prosek, 45.000 Kč): „Selbst wenn es 50 Kč kosten würde, müsste ich trotzdem alles prüfen, ob es sprachlich richtig ist und zu dem passt, was wir unterrichten, und dafür habe ich nach dem Abend mit den Kindern weder Zeit noch Nerven. Und bei Kindern darf ich mir keinen Fehler erlauben.“ (Note 3 → 3, 50 Kč: JA; unklar: Ich verliere mich in diesen Rollennamen – Leiter, Rechercheur, Setzer, Prüfer aus einer anderen Modellfamilie, Probe vor Publikum. Für mich sind das zu viele komplizierte Wörter, wo ich doch nur ein einfaches Dokument ohne Papierkram will.) - Bohuslav Křepela (
P255, 58 Jahre, blinder Klavierstimmer, Vinohrady, 36.000 Kč): „Wie soll ich erkennen, dass das fertige PDF oder die Präsentation stimmt, wenn ich sie nicht sehe? Und dass keine erfundenen Preise oder Fehler beim Stimmen darin sind, das garantiert mir ein Prüfer aus einer anderen Modellfamilie von sich aus auch nicht.“ (Note 3 → 3, 50 Kč: JA; unklar: Ich habe mich in der Pinnwand, dem Live-Ablauf, dem Grafiker und dem Setzer verloren. Als Blinder muss ich Dinge vor allem hören und mit Tastatur oder Stimme bedienen können, nicht auf Bildern herumklicken und beobachten, wie es aussieht.) - Ctirad Malina (
P101, 52 Jahre, Fleischer in der Markthalle von Holešovice, Holešovice, 48.000 Kč): „Wer garantiert mir, dass es sich keine Zahlen zu den Umbaukosten und zur Energie ausdenkt? Ich müsste es sowieso selbst nachrechnen und weiß noch nicht, wohin meine Daten gehen, den Ämtern würde ich das nicht einfach so anvertrauen.“ (Note 3 → 3, 50 Kč: JA; unklar: Diese Rollen – Leiter, Rechercheur, Setzer, Prüfer aus einer anderen Modellfamilie und Probe vor Publikum – das sind für mich böhmische Dörfer. Ich muss nur wissen, was es kostet, wie lange es dauert und ob es stimmt.) - Radim Závodný (
P122, 34 Jahre, Feuerwehrmann aus Holešovice, Holešovice, 52.000 Kč): „Das Hauptproblem ist das Vertrauen. Die KI denkt sich ohne Weiteres einen Blödsinn aus, und ich muss es nach einem 24-Stunden-Dienst trotzdem kontrollieren, sonst lade ich mir Ärger ein. Und dafür am Computer sitzen will ich echt nicht, da schreibe ich es lieber selbst.“ (Note 3 → 3, 50 Kč: JA; unklar: Setzer, Prüfer aus einer anderen Modellfamilie, Probe vor Publikum – das ist für mich Marketing-Geschwätz. Ich verstehe nicht, warum ich sechs verschiedene KIs brauche, wenn ich nur ein Schreiben aufsetzen will.) - Oksana Melnyk (
P227, 39 Jahre, Krankenschwester im Thomayer-Krankenhaus, Krč, 48.000 Kč): „Ich habe Angst, dass es schlechtes Tschechisch schreibt oder Unsinn erfindet und das Amt es nicht anerkennt, und ich muss dem dann glauben, auch wenn ich es nicht verstehe. Im Krankenhaus würde ich dafür nie ein Papier über Patienten anvertrauen.“ (Note 3 → 3, 50 Kč: JA; unklar: Diese Rollen Leiter, Setzer, Prüfer aus einer anderen Modellfamilie und Probe vor Publikum – das sagt mir nichts, es klingt nach etwas für IT-Leute und ist für mich unnötig kompliziert.) - Klára Sedláčková (
P036, 34 Jahre, Inhaberin eines kleinen Onlineshops, Vysočany, 85.000 Kč): „Am meisten fürchte ich, dass es Unsinn über Preise, Mehrwertsteuer, Versanddienstleister oder Fristen im Onlineshop erfindet und ich das dann zu Hause die ganze Nacht überprüfen muss, bevor ich es dem Kunden schicke. Es spart mir nur dann Zeit, wenn es zu den tschechischen Gegebenheiten passt und nicht bloß allgemein schön klingt.“ (Note 2 → 2, 50 Kč: JA; unklar: Der Prüfer aus einer anderen Modellfamilie und diese Probe vor Publikum – das klingt für mich nach einer sehr fachlichen Marketinghülle, ich weiß nicht, was ich mir darunter real vorstellen soll.) - Oldřich Pospíšil (
P171, 81 Jahre, Uhrmacher im Ruhestand, Košíře, 21.000 Kč): „Mein Hauptzweifel ist, dass ich dafür einen Computer haben und das in kleiner Schrift lesen müsste, und meine Augen sind nicht mehr gut. Und 50 Kronen für ein Papier wegzuwerfen, von dem ich nicht weiß, wer es geschrieben hat und ob etwas Wahres drinsteht, das ergibt für mich keinen Sinn, da schreibt mir meine Tochter lieber einen Brief auf Papier.“ (Note 5 → 5, 50 Kč: NEIN; unklar: Ich habe mich gleich bei diesen Rollen verloren – Leiter, Rechercheur, Setzer, Prüfer aus einer anderen Modellfamilie. PowerPoint, Excel, Pinnwand, Probe vor Publikum – das sind für mich Fremdwörter, ich arbeite mit den Händen am Tisch, nicht in einer App.)
In knapp neun Sekunden und für vier Kronen vierzig Heller haben uns 300 digitale Zwerge fünf blinde Flecken der Aufgabenstellung zerlegt, noch bevor wir den Code angefasst haben:
- Die 80-%-Budgetbremse wirkt wie die Drohung eines unfertigen Ergebnisses (IT-Entwickler wie Handwerker erwarten, für ein Halbfabrikat zu zahlen, das sie einen halben Tag lang korrigieren werden).
- Die Namen Setzer und Prüfer aus einer anderen Modellfamilie verwirren über 85 % der Befragten quer durch alle Bildungsgrade.
- Die Pinnwand mit sechs Persönlichkeiten schreckt Nutzer ab, die nach der Schicht müde sind und ein einziges Ergebnis wollen, ohne ein Miniteam zu leiten.
- Asymmetrie der Verantwortung: Den Ärger vor dem Kunden, dem Chef oder dem Amt trägt immer der Mensch mit seiner Unterschrift.
- Der blinde Klavierstimmer (
P255) holte sofort den blinden Fleck der Barrierefreiheit hervor: Wer sich ein PDF oder eine Präsentation nicht mit den Augen ansehen kann, kann weder die visuelle „Pinnwand“ noch das Ergebnis ohne Sprach- und Textvorschau beurteilen.
Wo die Zwerge täuschen: ein forensisches Audit mit stärkerem Auge
Hätten wir mit der Begeisterung über schöne Zitate aufgehört, hätten wir uns selbst betrogen. Deshalb sind wir alle 300 Profile und Antworten per Skript und mit analytischem Blick durchgegangen, um die Stärken des günstigen Schwarms von seinen künstlichen Nahtstellen zu trennen:
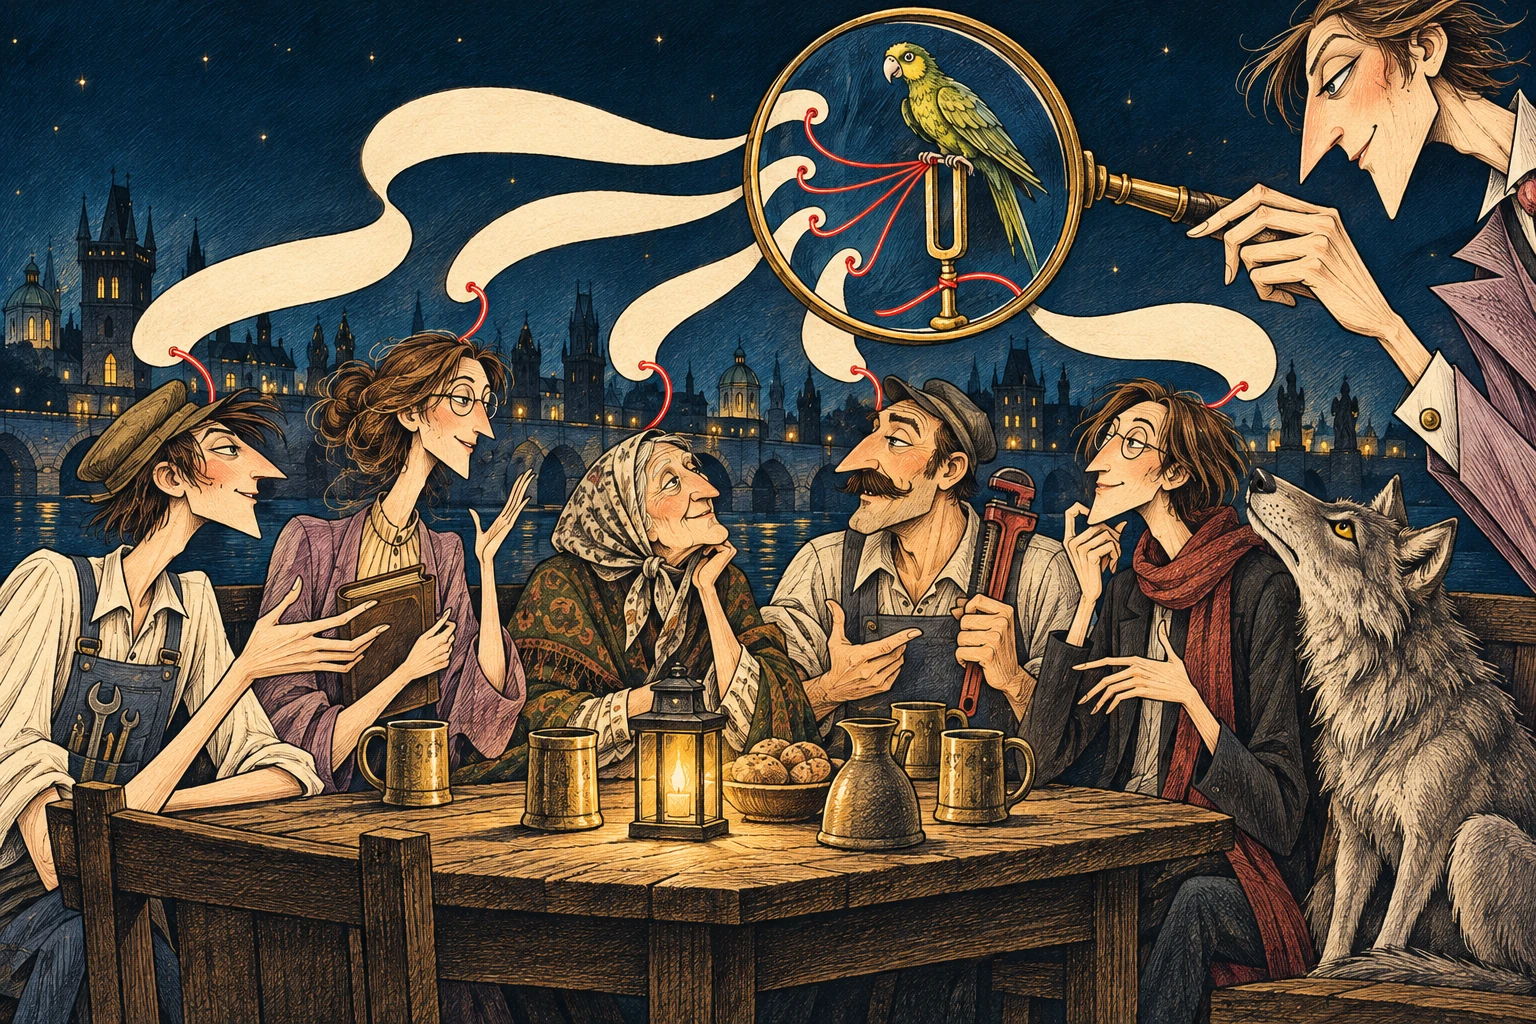
Unter der Lupe sind die verschiedenen Figuren nach außen sehr lebendig, aber der Anfang jedes Satzes trägt den Abdruck der Aufgabenstellung (derselbe Haken unter der Lupe).
Wir haben fünf präzise künstliche Nahtstellen über alle dreihundert hinweg gefunden:
- Schablonenhafter Satzanfang bei 286 von 300 Zwergen: 178 Antworten begannen genau mit „Am meisten nervt mich …“, 95 mit „Am meisten ärgert mich …“ und 13 mit „Am meisten kotzt mich … an“ (nur 14 anders). Das Modell übernahm mechanisch das Wort direkt aus dem Namen des JSON-Schlüssels
coMeVPrazeNejvetsiStve. - Ansteckung durch das Thema der vorherigen Frage (Priming): Ganze 90 von 300 Befragten beklagten sich in der offenen Beschwerde spontan über Airbnb, darunter auch Senioren aus Randsiedlungen, weil sie drei Zeilen weiter oben
regulaceAirbnbAVystavbabewertet hatten. - Anker Null vs. Fünfzig-Kronen-Schein: Nach dem Hinweis „gern auch 0“ gaben 264 von 300 Pragern ein monatliches KI-Budget von 0 Kč an, aber für ein einmaliges fertiges Dokument hätten fünf Minuten später gleich 177 von 300 (59 %) 50 Kč gezahlt. Und über alle 300 Profile hinweg wählten nur 2 Personen die Antwort „nie“ bei der heutigen Nutzung von KI (von 22 Senioren über 65 Jahren nur ein einziger!).
- Einseitige Verschiebung in der Debatte an 60 Tischen: Nachdem sie vier Nachbarn angehört hatten, änderten 260 Prager ihre Note nicht, 40 verschlechterten sie und 0 verbesserten sie, weil ihnen die Debattenaufgabe ausschließlich die Einwände der Tischnachbarn übergab, nicht deren Ideen.
- Schönes Tschechisch verrät sich in Kleinigkeiten: Wir haben 34 Fälle einer nicht Prager Präposition erfasst („v Karlíně“, „v Žižkově“, „v Pankráci“, „v Modřanech“), und auch Ausländer, die schon lange in Prag leben, schrieben in derselben glatten Umgangssprache wie gebürtige Tschechen.
Die Jagd nach der Obergrenze: 264.081 Tok/s, 719,6 erschaffene Prager pro Sekunde und tausend Menschen für 31 Heller
Nach der ersten Welle mit dem dreihundertköpfigen Prager Publikum stellte ich mir die umgekehrte Frage. Was wäre, wenn wir das anspruchsvolle literarische Tschechisch beiseitelassen und herausfinden würden, wo eigentlich die physische Obergrenze der Geschwindigkeit und die untere Grenze des Preises liegen? Das Ergebnis überraschte gleich doppelt: Allein der Wechsel auf eine andere Engine oder ein großes JSON reicht bei Weitem nicht aus, und obendrein gilt ein hartes Gesetz der Qualitätserhaltung.
Als wir nach der hochgradig parallelen schnellen Architektur genauso sorgfältiges Tschechisch und genauso sorgfältiges Überlegen wollten (Denkstufe medium für 100 Prager gleichzeitig), fiel die resultierende Zeit zwar auf 1,74 Sekunden (57,5 Prager/s), aber der Gesamtdurchsatz blieb bei 43.739 Tok/s, also eine Winzigkeit unter unserem ursprünglichen hochwertigen tschechischen Lauf (45.192 Tok/s). Warum? Ganze 71,3 % der Token verschlang das stille innere Denken (sichtbarer Text fiel nur mit 12.534 Tok/s an), und von jeder Sekunde schnitt der kalte Aufbau der HTTPS/TLS-Verbindung im Schnitt 439 ms ab gegenüber 516 ms reiner Berechnung (66.795 Tok/s reine Rechenleistung).
Sobald wir dagegen beim Tschechischen das Denken auf das Minimum zurückfuhren (low, 100×1), sank die Zeit auf 1,00 Sekunden (25.072 Tok/s, davon 21.561 Tok/s sichtbar), aber die Qualität des Tschechischen und die Logik begannen zu bröckeln. Die Mehrheit in der Umfrage zum ÖPNV drehte sich um (17:33 gegenüber 47:1 im Modus medium), und die Zwerge begannen zu deklinieren wie ein kaputter Automat („po dlouhém směnu“, „peníze jsou těsně“). Natürliches Tschechisch und Nuancen, vergleichbar mit großen Modellen vom Typ GPT, fordern eben ihren Tribut in Denk-Token und langsamerer Antwortzeit.
Fünf architektonische Regeln, die die Rekorde freigeschaltet haben
Um uns von der Mauer von 45 Tausend Tok/s sechsmal höher zu bringen, reichte es nicht, auf die Kraft zu drücken. Entschieden hat die Kombination von fünf konkreten Anpassungen der Art des Aufrufs:
- Vorgewärmte Verbindungen (
HTTP Keep-Alive) statt Kaltstart: Eine kurze Charge, die in einer halben Sekunde berechnet ist, verliert fast doppelt so viel Zeit beim Aushandeln eines neuen TLS-Tunnels. Erst als wir vor der scharfen Messung die TCP/TLS-Verbindungen im Voraus geöffnet und aufgewärmt hatten, fiel jedes Hundert Fenster unter eine Sekunde (0,80bis1,36 s). - Eine Charge von 10 Profilen in einem Fenster (
100×10) statt der Extreme300×1und1×100: Der Versuch, alle 100 Prager in ein einziges riesiges JSON zu stopfen, scheiterte. Ein Thread läuft nur mit Ein-Thread-Geschwindigkeit (1.749 bis 2.288 Tok/s): Das kompakte Hundert dauerte3,66 s, das volle JSON scheiterte beim ersten Mal an 28 Positionen (4,74 sund Zerfall der Logik0:49), und der lange Stresstest (64.026Zeichen /24.360Token in11,84 s) brachte die klassische Kontextermüdung, bei der die Länge der Antworten von399auf213Zeichen sank (Verhältnis0,53) und der Zwerg in eine unpersönliche Erzählung in der 3. Person abrutschte. Der goldene Mittelweg war, 10 Persönlichkeiten in eine kompakte JSON-Anfrage zu packen (der tschechische Zwischenschritt25×4ergab100/100in0,93 s, also 108,0 Prager/s für0,53 Kč). - Arbeitsenglisch im Inneren, gutes Tschechisch erst in der Ausgabe: Sobald wir dieselbe Aufgabe mit niedrigem Überlegen (
low) für die rohe Stapelarbeit in kompaktes Englisch umgeschrieben hatten, fielen die Überlegungs-Token auf einen Bruchteil (1,9 % bis 14 %, über 86–98 % der Leistung machte direkt die sichtbare Ausgabe aus), und gleichzeitig blieb die Logik stabil (99,5–100 %Ich-Form, ÖPNV450:46, Maut für Autos0:248). Für den Massenlauf der Zwerge ergibt es also Sinn, Struktur und Haltungen schnell und günstig auf Englisch zu erzeugen und erst die finale Zusammenfassung in schönes Tschechisch zu überführen. - Massives Sharding der Namen bei der Erschaffung von Grund auf (
719,6neue Prager/s): Als hundert vorgewärmte Streams mit je zehn (100×10) ganz neue Einwohner Prags von null erschufen, entstanden 980 gültige Profile von 1.000 in 1,36 Sekunden, also 719,6 neu erschaffene Prager pro Sekunde (0,96 Kčinsgesamt, d. h. 0,98 Kč pro 1.000 Personen). Dieselbe Konfiguration über dem bestehenden Fragebogen erledigte 991 von 1.000 Pragern in 1,34 s, was rekordverdächtige 742,0 befragte Prager pro Sekunde ohne einen einzigen Fehler429ergibt (2,07 Kč, d. h.2,09 Kč / 1.000), und die doppelte Charge200×10schaffte 1.974 von 2.000 Pragern in 2,77 s (712,4/s). Dabei haben wir ein wichtiges Detail gelernt: Ohne getrennte Namenslisten für jeden Thread schöpfen unabhängige Zwerge aus demselben stereotypen Korb, sodass aus980neuen Figuren nur 336 einzigartige Namen entstanden. - Verteilung über mehrere unabhängige Cluster (
264.081 Tok/s) vs. Jagd nach Hellern (0,31 Kč / 1.000): Ein schneller Account stieß bei150langen Streams an seine eigene Spitze von 128.976 Tok/s (5,18 s, Durchschnitt61.707 Tok/s), ein größerer Pool mit220Streams hob die Spitze auf 171.306 Tok/s (7,20 s, Durchschnitt66.909 Tok/s), und erst die Verbindung von 550 vorgewärmten Streams über vier unabhängige Rechencluster schoss die 250-ms-Spitze auf 264.081 Token pro Sekunde (257.001 Tok/s reiner sichtbarer Text, 1.195.658 Ausgabe-Token insgesamt,98,1 %sichtbarer Text,0Fehler429, 71.077 Tok/s in den schnellen 95 % der Anfragen und59.011 Tok/süber volle20,26 sbis zum Auslaufen des langsamsten Clusters). Am entgegengesetzten Pol liegt der Modus minimalen Preises: Mit dem günstigsten Rechenweg (30×10) bekamen wir 259 gültige Fragebögen in10,18 sfür gerade einmal 0,08 Kč, also rekordverdächtige 0,31 Kč pro 1.000 Prager (0,031 Kčpro hundert Menschen) bei100 %Erhalt der ersten Person.
| Versuchsmodus | Zeit | Tokendurchsatz | Leistung (Prager/s) | Preis pro 1.000 Personen | Verhalten und Qualität |
|---|---|---|---|---|---|
Hochwertiger tschechischer Schwarm (300×1, ursprünglicher Lauf) | 17,34 s | 45.192 Tok/s | 17,3/s (300 Personen) | 31,57 Kč (9,47 Kč / 300) | Natürliches Prager Tschechisch, Qualität über GPT Luna |
Schnelle Arch. CZ + medium (100×1) | 1,74 s | 43.739 Tok/s (12.534 sichtb.) | 57,5/s (100 Personen) | 18,80 Kč (1,88 Kč / 100) | Logik 47:1 hält, aber 71,3 % verschluckt das Überlegen |
Schnelle Arch. CZ + low (100×1) | 1,00 s | 25.072 Tok/s (21.561 sichtb.) | 99,9/s (100 Personen) | 10,00 Kč (1,00 Kč / 100) | Schnell, aber Endungen und Logik brechen (17:33) |
Tschechischer Kompromiss per Charge (25×4, low) | 0,93 s | 22.863 Tok/s (11.465 sichtb.) | 108,0/s (100 Personen) | 5,30 Kč (0,53 Kč / 100) | Kurze, prägnante Antworten, ohne Absturz in Fehler |
Erschaffung von null EN (100×10, Keep-Alive) | 1,36 s | 33.457 Tok/s (63.233 Spitze) | 719,6/s (980 von 1.000) | 0,98 Kč (0,96 Kč / 980) | 336 einzigartige Namen ohne Sharding |
Fragebogen-Rekord EN (100×10, Keep-Alive) | 1,34 s | 62.456 Tok/s (94.499 Spitze) | 742,0/s (991 von 1.000) | 2,09 Kč (2,07 Kč / 991) | 99,5 % Ich-Form, ÖPNV 450:46, Maut 0:248 |
Doppelter Fragebogen EN (200×10, Keep-Alive) | 2,77 s | 60.203 Tok/s (139.028 Spitze) | 712,4/s (1.974 von 2.000) | 2,10 Kč (4,14 Kč / 1.974) | 99,7 % Ich-Form, 0 Fehler 429 |
Niedrigster Preis EN (30×10, Keep-Alive) | 10,18 s | 2.521 Tok/s (3.178 Spitze) | 25,4/s (259 von 300) | 0,31 Kč (0,08 Kč / 259) | 100 % Ich-Form, ÖPNV 110:20, 3 Heller / 100 |
Token-Obergrenze 550 Streams über 4 Cluster | 20,26 s (4,90 s Median) | 264.081 Tok/s Spitze (257.001 sichtb.) | 1.195.658 Token | 20,25 Kč gesamt (1,69 Kč / 100k Tok) | 550/550 OK, 0× 429, 98,1 % sichtbarer Text |
Was ein solcher Schwarm kostet und was wir daraus für Hyperprostor mitnehmen
Der scharfe Lauf der dreihundert einzigartigen Prager allein (das Nachgenerieren der zweihundert neuen Figuren, der Massenfragebogen mit 300 Fenstern und beide Runden der Produktbewertung an 60 Tischen) kostete gerade einmal 0,79 USD (etwa 18,09 Kč). Die gesamte erste tschechische Welle zusammen mit allen Testwellen der Leiter und den Illustrationen des Ateliers kostete 3,37 USD (77,47 Kč), die anschließende Serie architektonischer Geschwindigkeits- und Preistests kam mit 2,18 USD (50,08 Kč) hinzu, sodass die gesamte Forschung beider Modi zusammen, einschließlich des Belastungstests mit 550 parallelen Streams, nur 5,55 USD (127,54 Kč) kostete.
Für die Arbeitsteams in Hyperprostor nehmen wir daraus einen einfachen Grundsatz mit zwei Geschwindigkeiten mit. Wo Sie natürliches Tschechisch und eine feine, großen GPT-Modellen nahe Überlegung brauchen, bleiben Sie bei den ruhigeren 45 Tausend Tok/s in knapp zwanzig Sekunden. Und wo Sie innerhalb einer Sekunde Hunderte bis Tausend Perspektiven für eine Umfrage ausspucken, einen Text am Publikum testen oder eine massive Simulation für 31 Heller pro tausend Menschen anwerfen müssen, schalten Sie die vorgewärmten Zehner-Chargen auf Englisch, getrennte Namens-Shards ein und übersetzen erst das saubere Ergebnis in menschliche Sprache.
Jan Tyl