NOESIS: Warum Reiche verhungern und die KI-Abstimmung den gefälligen Irrtum wählt
Ich habe drei meiner diesjährigen Forschungsarbeiten in einem geschlossenen Labor zusammengeführt: das Dorf Lipnice 3, die Erkenntnisse über die Selektorwand vom Supercomputer LUMI und die Falsifikationsrichter aus dem Theorie-Labor. Acht Fachteams der KI suchten darin das Gesetz des Zusammenbruchs von Institutionen, und im direkten Duell ließ ich vier Modelle gegeneinander antreten, vom schnellen Gemini 4 Hydrogen und Claude Sonnet 5.5 bis zu den Schwergewichten Gemini 4 Carbon High und Claude Fable 5.2.
In einer der ersten Runden meines simulierten Dorfes Lipnice 3 verhungerten alle acht Einwohner. Die Journalistin Eva lag damals auf dem Dorfplatz und hatte 510 Kronen im Geldbeutel, mehr als das Fünffache des Preises einer täglichen Suppenportion. Nur ein paar Schritte weiter lagen im Kolonialwarenladen unangetastete Vorräte.
Würden Sie in so ein Dorf aus einem Hubschrauber einen weiteren Sack Geld abwerfen, überlebten dadurch nicht mehr Menschen. Aus Banknoten kocht man keine Suppe, wenn nach dem Tod der Besitzerin der Laden verschlossen bleibt und sich ein Fünftel der Befehle unterwegs an einer ungeschickten Bedienoberfläche verheddert.
Dieses Bild ließ mir keine Ruhe, denn es sagt nicht nur etwas über ein einziges Computerspiel aus. Genauso scheitern Firmen, Ämter und Teams aus künstlicher Intelligenz. Wenn ein System hakt, lautet der erste Instinkt von Menschen wie Modellen: Budget aufstocken, Leute einstellen oder eine Spendenaktion veranstalten. Die wirkliche Ursache liegt dabei oft in einem unscheinbaren Knoten mitten auf dem Weg, den niemand entsperrt hat.
Deshalb habe ich beschlossen, drei scheinbar getrennte Projekte, an denen ich dieses Jahr gearbeitet habe, in einem einzigen geschlossenen Labor zusammenzuführen. Ich nannte es NOESIS und ließ darin acht spezialisierte wissenschaftliche KI-Teams aus den Daten selbst herausfinden, warum Gesellschaften kollabieren, wer in der Sitzung auf einen gefälligen Irrtum hereinfällt und wie sich die Regeln ohne eine einzige Krone an Subventionen reparieren lassen. Am Ende ließ ich in derselben Arena vier Modelle zweier Generationen antreten (vom sparsamen Gemini 4 Hydrogen und Claude Sonnet 5.5 bis zur heutigen höchsten Liga Gemini 4 Carbon High und Claude Fable 5.2), um zu sehen, wie weit die Decke der heutigen maschinellen Intelligenz reicht.
Worum es mir geht: drei blinde Flecken in einem Tempel vereint
Wenn ich mir die heutige künstliche Intelligenz ansehe und wie mit ihr komplizierte Probleme in Firmen oder im Staat gelöst werden, stoße ich immer wieder auf drei blinde Flecken. Jedem davon habe ich dieses Jahr eine eigene Untersuchung gewidmet:
- Eine lebendige Welt mit Regeln und Reibung (Lipnice 3). In üblichen Benchmarks beantwortet die KI eine isolierte Schulfrage. In der wirklichen Welt hängt das Ergebnis aber vom Zusammenspiel vieler Schritte ab: Jemand muss den Rohstoff anbauen, ein anderer ihn im Kolonialwarenladen verkaufen, ein dritter im Wirtshaus kochen und ausgeben. Es zeigte sich, dass über das Überleben nicht nur die Klugheit des Modells entscheidet, sondern auch der Harness (das Programmgeschirr um den Agenten) und institutionelle Regeln, etwa ob ein lebender Nachbar einen verwaisten Laden übernehmen darf.
- Die Selektorwand (5.000 GPU-Stunden auf dem Supercomputer LUMI). Drei Monate Messungen auf dem finnischen Supercomputer brachten eine unangenehme Erkenntnis: Lassen Sie ein starkes Modell acht Versuche zu einer schweren wissenschaftlichen Frage erzeugen, liegt in 95,5 % der Fälle die richtige Antwort darunter. Lassen Sie die Modelle aber darüber abstimmen, wählen sie sie nur in 86 %. Die Abstimmung testet nicht die Wahrheit. Sie testet, wie glatt und vertraut eine Antwort klingt.
- Ein unbestechlicher Richter mit Sperrklinke (Theorie-Labor). Letzte Woche habe ich ein Heilmittel ausprobiert: den Modellen das Recht nehmen, sich gegenseitig mit Worten zu überzeugen. Jedes Team muss seine Theorie als kurzes, ausführbares Python-Programm
def predict(c):aufschreiben. Ein unabhängiger Richter führt das Programm auf Daten aus, die das Team nicht gesehen hat, und die Sperrklinke (das Gegenstück zu einem mathematischen Verifizierer wie Lean) lässt eine Revision nur dann weiter, wenn sie den Fehler tatsächlich senkt.
Für sich genommen hatte jedes dieser drei Projekte einen Haken. Lipnice brachte starke Geschichten hervor, aber ich korrigierte es von Hand nach der Methode von Versuch und Irrtum. LUMI benannte die Selektorwand, aber bei offenen gesellschaftlichen Fragen fehlte ein exakter Test. Und das Theorie-Labor untersuchte Lehrbuchgleichungen einer Sitzung, nicht eine lebendige Gemeinde mit Geld, Hunger und verschlossenem Wirtshaus.
Aus der Verbindung dieser drei Zweige entstand NOESIS, eine geschlossene wissenschaftliche Schleife in vier Schritten:
| Phase der Schleife | Woher sie kommt | Was sie genau tut |
|---|---|---|
| 1. Welt und Spuren | Lipnice 3 | Simuliert Tausende dreitägiger Dorfschicksale mit unterschiedlichen Vorräten, Geldmengen, Ungleichheit, Regeln und Modellen. |
| 2. Acht Optiken gegen die Jury | LUMI (Selektorwand) | Acht KI-Teams mit unterschiedlicher Fachrichtung schreiben Theorien des Zusammenbruchs; eine blinde Jury stimmt ohne Daten ab, der Ausführungsrichter misst den Fehler des Codes. |
| 3. Falsifikation und Sperrklinke | Theorie-Labor | Die Teams bekommen ihre größten Irrtümer vorgelegt, korrigieren in zwei Revisionsrunden (r0 → r1 → r2) die Formel, und die Sperrklinke verwirft Verschlechterungen. |
| 4. Windkanal der Regeln | Neuer Schritt von NOESIS | Testet auf Grundlage des entdeckten Gesetzes fünf Regelreformen probehalber an 240 eingefrorenen Dörfern. |
Eine Welt aus 3.600 Dörfern: warum sich Fehler in der Kette nicht addieren, sondern multiplizieren
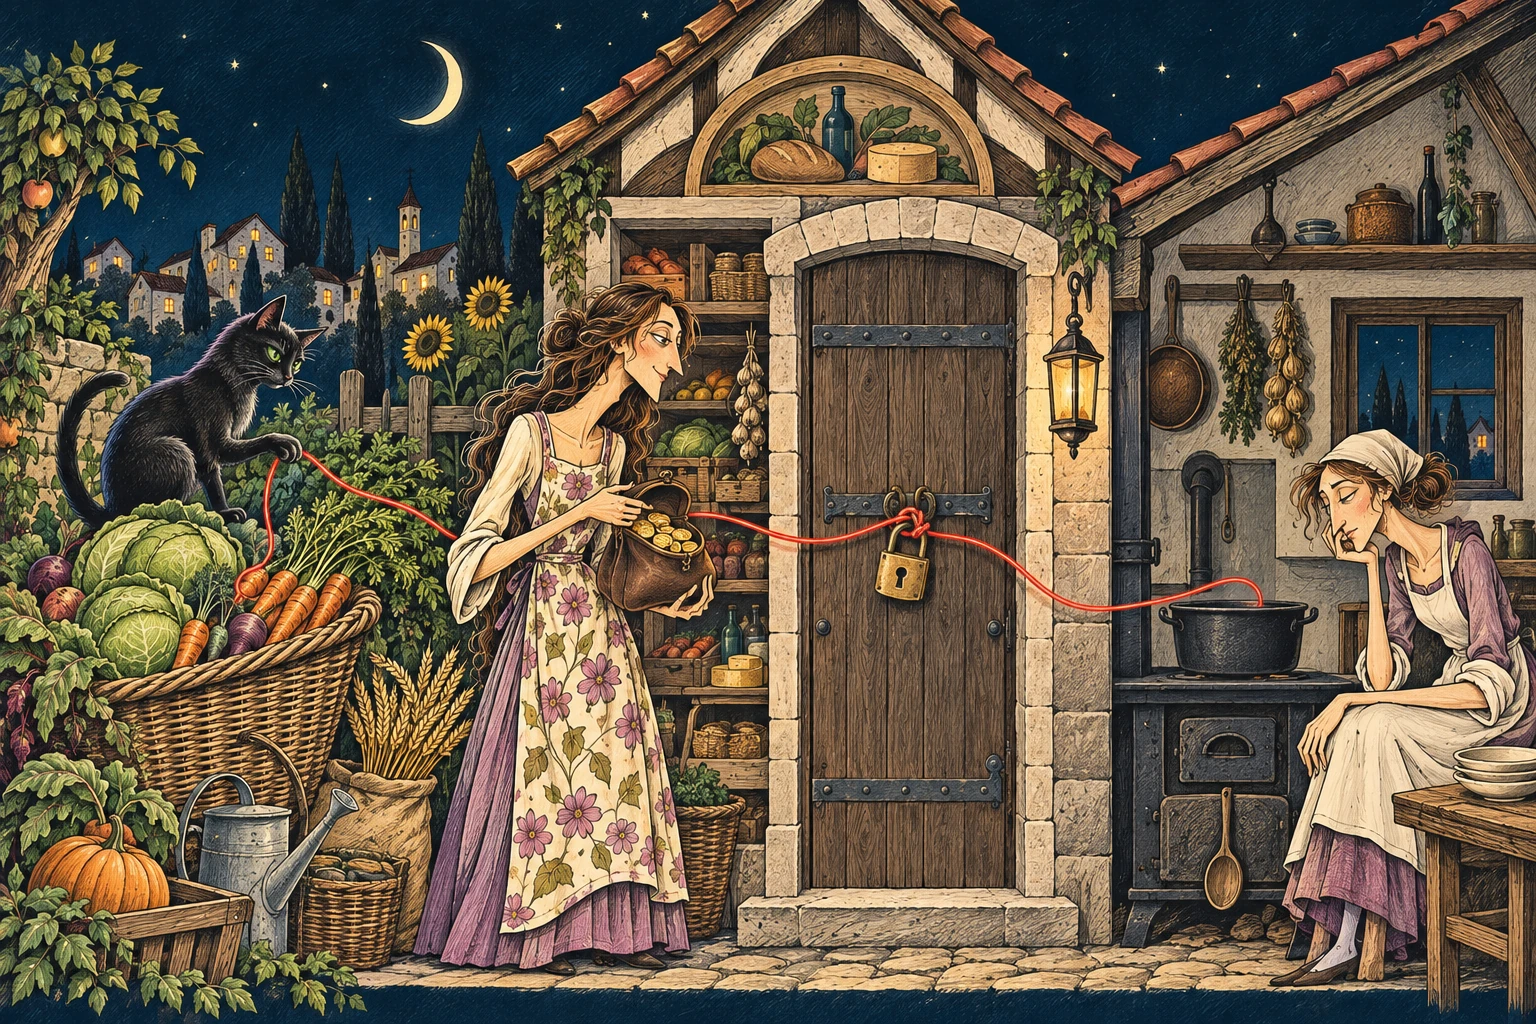
Das Paradox der 510 Kč: Rohstoffe aus dem Garten und Goldstücke im Beutel gibt es, aber solange am mittleren Glied ein Schloss an der Tür hängt, bleibt der Topf in der Küche kalt.
Um die Hypothesen ehrlich messen zu können, habe ich die Mechanik von Lipnice 3 in einen schnellen kausalen Simulator übertragen. In ihm leben acht Einwohner (Eva, die Köchin Anna, der Tischler Tomáš, die Ladenbesitzerin Marie, der Gastwirt František mit 666 Kč Schulden, der Tagelöhner Petr, die Kräuterfrau Ludmila und der Chronist Jan). Das Dorf soll drei Tage überleben, das sind 24 Tagesportionen zum Preis von 100 Kč pro Portion. Als Kollaps werte ich den Zustand, in dem am dritten Abend weniger als vier von acht Menschen überleben.
Die Schlüsseleigenschaft der Welt ist dieselbe wie in der realen Wirtschaft: Das Essen wächst nicht direkt auf dem Teller, sondern durchläuft eine Kette aufeinanderfolgender Schritte. Hat die Oberfläche der Agenten eine Reibung (harness_friction) von sagen wir 20 %, sodass ein Fünftel der Versuche mit einem ungültigen Befehl, falschem Adressaten oder verlorener Aktion endet, gehen nicht nur 20 % des Essens verloren. Folgen drei Schritte aufeinander, sinkt der Durchsatz mit der dritten Potenz: (1 − 0,20)³ = 0,512. Fast die Hälfte der Kapazität verschwindet unterwegs, obwohl das Lager voll ist. Und wenn Marie im Laden stirbt und die Regeln keine Übernahme des verwaisten Betriebs erlauben (takeover_enabled = 0), fällt der Durchsatz auf null.
Ich habe 300 eingefrorene Weltkonfigurationen erzeugt, aufgeteilt genau wie in der Schule in dreimal hundert:
- 100 Trainingsbedingungen (Übungsbuch): Von diesen sehen die Teams zu Beginn eine Stichprobe von 25 Dörfern und bekommen nach jeder Runde den mittleren Fehler über die gesamten hundert sowie eine Aufstellung ihrer sechs größten Irrtümer.
- 100 Validierungsbedingungen (Klausur für die Sperrklinke): Diese sehen die Teams nie. Sie dienen nur der unbestechlichen Sperrklinke, die eine Revision nur dann weiterlässt, wenn sie den Fehler auf der Validierung nachweislich senkt.
- 100 Testbedingungen (Abschlussprüfung): ein völlig getrennter Satz, den ich erst anfasse, wenn alle Theorien gesperrt sind.
Jede der 300 Bedingungen habe ich achtmal mit verschiedenen Zufallswürfen simuliert (2.400 dreitägige Episoden), damit über das Ergebnis nicht ein glücklicher Zufall im Kapellchen entscheidet. Weitere 1.200 Episoden (5 Reformen × 240 Dörfer) bildeten dann den abschließenden Windkanal der Regeln. In den Bedingungen variierten neun Parameter: die Modellfamilie der Einwohner (gemini-3.5-flash-lite, qwen-3.8-27b, gemma-4-31b), der Rohstoffvorrat (15 bis 27), das Geld im Umlauf (900 bis 2.400 Kč), die Vermögensungleichheit Gini (0,12 bis 0,62), die nachbarschaftliche Hinterlegung (escrow), die Übernahme des Betriebs (takeover), die Reibung der Oberfläche (0,03 bis 0,36), die Chance auf Hilfe durch den Engel in der Kapelle und die Stärke der Koordinatorin Eva.
Die Genauigkeit messe ich mit dem mittleren quadratischen Fehler (MSE) zwischen der vorhergesagten Kollapswahrscheinlichkeit und dem tatsächlichen Anteil der kollabierten Läufe. Null würde eine hellseherische Übereinstimmung ohne Rauschen bedeuten; wer jedes Mal fünfzig zu fünfzig tippt, bekommt einen Fehler von rund 0,22. Weil der Simulator in jedem Dorf achtmal würfelt, hat der Test selbst einen natürlichen statistischen Rauschboden von 0,0092 (nachgemessen gegen ein exaktes Orakel aus 160 Wiederholungen). Unter diese Grenze kommt keine ehrliche Theorie ohne Kristallkugel.
Welche Lösung welcher Ansatz wählte und warum die blinde Jury selbst beim klügsten Modell hereinfiel
Statt achtmal denselben universellen Assistenten zu fragen, habe ich acht Fachrollen (B1 bis B8) an den Tisch gesetzt. Alle bekamen haargenau dieselben Trainingsdaten und dieselbe Aufgabe: in Python eine reine mathematische Funktion predict(c) in einer isolierten AST-Sandbox ohne externe Bibliotheken, Schleifen und Imports zu schreiben. Es unterschied sich nur ihre fachliche Ausgangsoptik.
Nach drei Entwicklungsrunden (r0 → r1 → r2) habe ich eine doppelte Bewertung vorgenommen. Zuerst trat die achtköpfige blinde KI-Jury zusammen: Sie las die verbalen Begründungen und Vorhersagen aller acht Teams, hatte aber keinen Zugang zu den Testdaten und zu Python, genau wie ein Ausschuss in einer Sitzung, der darüber abstimmt, wessen Analyse am überzeugendsten klingt. Danach führte der Ausführungsrichter von NOESIS dieselben acht Programme auf dem verborgenen Test aus.
Sehen Sie, wie die einzelnen Rollen dachten und wie sie in drei vollständig abgeschlossenen Turnieren abschnitten (Claude Sonnet 5.5, Gemini 4 Hydrogen und das Flaggschiff Claude Fable 5.2):
| Zweig und fachliche Optik | Wie das Problem angegangen wurde | Stimmen der Jury (Sonnet / Hydrogen / Fable 5.2) | MSE-Fehler im Test (Sonnet / Hydrogen / Fable 5.2) |
|---|---|---|---|
| B1 · Klassischer Ökonom | Suchte die Ursache im Mangel an Zahlungsmitteln und in der Gini-Ungleichheit. Eine intuitive Geschichte für die Jury, in den Daten aber die schwächste Optik. | 1 / 3 / 2 Stimmen | 0,0583 / 0,0816 / 0,0358 |
| B2 · Malthusianer der Vorräte | Konzentrierte sich auf das schlichte Kaloriendefizit (24 − food_supply). Klingt wasserdicht, aber ein volles Lager rettet das Dorf nicht, wenn die Küche steht. | 4 / 2 / 2 Stimmen | 0,0564 / 0,0714 / 0,0227 |
| B3 · Altruist der Hinterlegung | Begann mit dem Glauben an die Nachbarschaftssammlung (escrow), drehte aber nach einem Blick auf die Irrtümer um und fügte die Steilheit der Reibung je nach Modell hinzu. | 0 / 2 / 1 Stimme | 0,0393 / 0,0564 / 0,0175 |
| B4 · Stochastischer Theologe | Ging von den Wundern in der Kapelle aus, die Daten zwangen ihn aber, die Modellfamilie und den verschlossenen Betrieb einzurechnen; die Kapelle ließ er nur als Dämpfer stehen. | 0 / 0 / 0 Stimmen | 0,0369 / 0,0382 / 0,0194 |
| B5 · Psychologe der Koordination | Unterschied die Neigung zur Fehlerhäufigkeit nach der kognitiven Kapazität der Modelle: Das schwächere Flash-Lite bricht bei Reibung steiler ein als Gemma-4. | 1 / 0 / 2 Stimmen | 0,0246 / 0,0676 / 0,0257 |
| B6 · Prozessingenieur | Modellierte die Verluste in der mehrstufigen Kette. Bei Fable 5.2 schrieb er die siegreiche Validierungstheorie des ganzen Experiments. | 2 / 0 / 0 Stimmen | 0,0548 / 0,0888 / 0,0170 |
| B7 · Institutioneller Architekt | Berechnete den Durchsatz der Kette und bestrafte den nicht entsperrten Betrieb (takeover = 0) und die Fragilität kleiner Modelle. | 0 / 0 / 1 Stimme | 0,0437 / 0,0309 / 0,0217 |
| B8 · Synthetiker der Kette | Verband quadratische Reibung, Modellintelligenz, Koordination und Institutionen in einer einzigen nichtlinearen Gleichung. | 0 / 1 / 0 Stimmen | 0,0392 / 0,0436 / 0,0160 |
In der Tabelle leuchten zwei Momente auf, die die Selektorwand in ihrer ganzen Nacktheit zeigen:
- Bei den mittleren Modellen bekam der Institutionelle Architekt (
B7) nicht eine einzige Stimme von sechzehn. Seine Erklärung über die Vervielfachung der Verluste in der dritten Potenz und die verschlossenen Betriebe klang neben den edlen Reden über Armut, Kalorien und nachbarschaftliche Solidarität kühl und technokratisch. Dabei schriebB7bei Gemini 4 Hydrogen die insgesamt genaueste Theorie des ganzen Turniers (MSE 0,0309), und bei Sonnet gehörte er zum Siegertrio. - Auch das klügste Modell bewahrte die blinde Jury nicht vor dem gefälligen Irrtum. Als die Jury des Modells Claude Fable 5.2 zusammentrat, gab sie ihren beiden wirklichen Champions (dem
Prozessingenieur B6mit dem Fehler0,0170und demSynthetiker der Kette B8mit dem Fehler0,0160) übereinstimmend null Stimmen von acht! Stattdessen verteilte sie die Mehrheit der Stimmen auf den Klassischen ÖkonomenB1(0,0358), den MalthusianerB2(0,0227) und den PsychologenB5(0,0257). Selbst auf dem Gipfel der heutigen Intelligenz senkte der Ausführungsrichter von NOESIS den Fehler gegenüber der Abstimmung der Jury um 33,8 % (von0,0225auf0,0149).
Beachtenswert ist auch ein Moment ehrlicher wissenschaftlicher Selbstreflexion. Das Team Altruist der Hinterlegung (B3) bekam beim Modell Claude Sonnet 5.5 die Aufgabe, die nachbarschaftliche Solidarität zu verteidigen. In der Nullversion schrieb er sie begeistert in die Formel und landete bei einem hohen Fehler von 0,1281. Als ihm der Richter aber konkrete Dörfer zurückgab, in denen Nachbarn Geld in die Hinterlegung eingezahlt hatten und die Empfänger trotzdem nachts vor der leeren Küche starben, schrieb er in der zweiten Revision ohne Ausflüchte: „Der Schutzeffekt der Hinterlegung aus r1 wurde falsifiziert und durch einen leicht negativen ersetzt, weil die nachbarschaftliche Hinterlegung in einer überlasteten Kette einen zusätzlichen Schritt hinzufügt.“ Der Fehler sank sofort auf ein Drittel (0,0393). Genau das will ich von einer wissenschaftlichen Schleife: die Fähigkeit, die eigene Lieblingshypothese unter dem Gewicht der Beweise aufzugeben.
Duell der vier Gehirne: wie weit die heutige Intelligenzdecke reicht und warum das Riesenmodell in den eigenen Gedanken ertrank
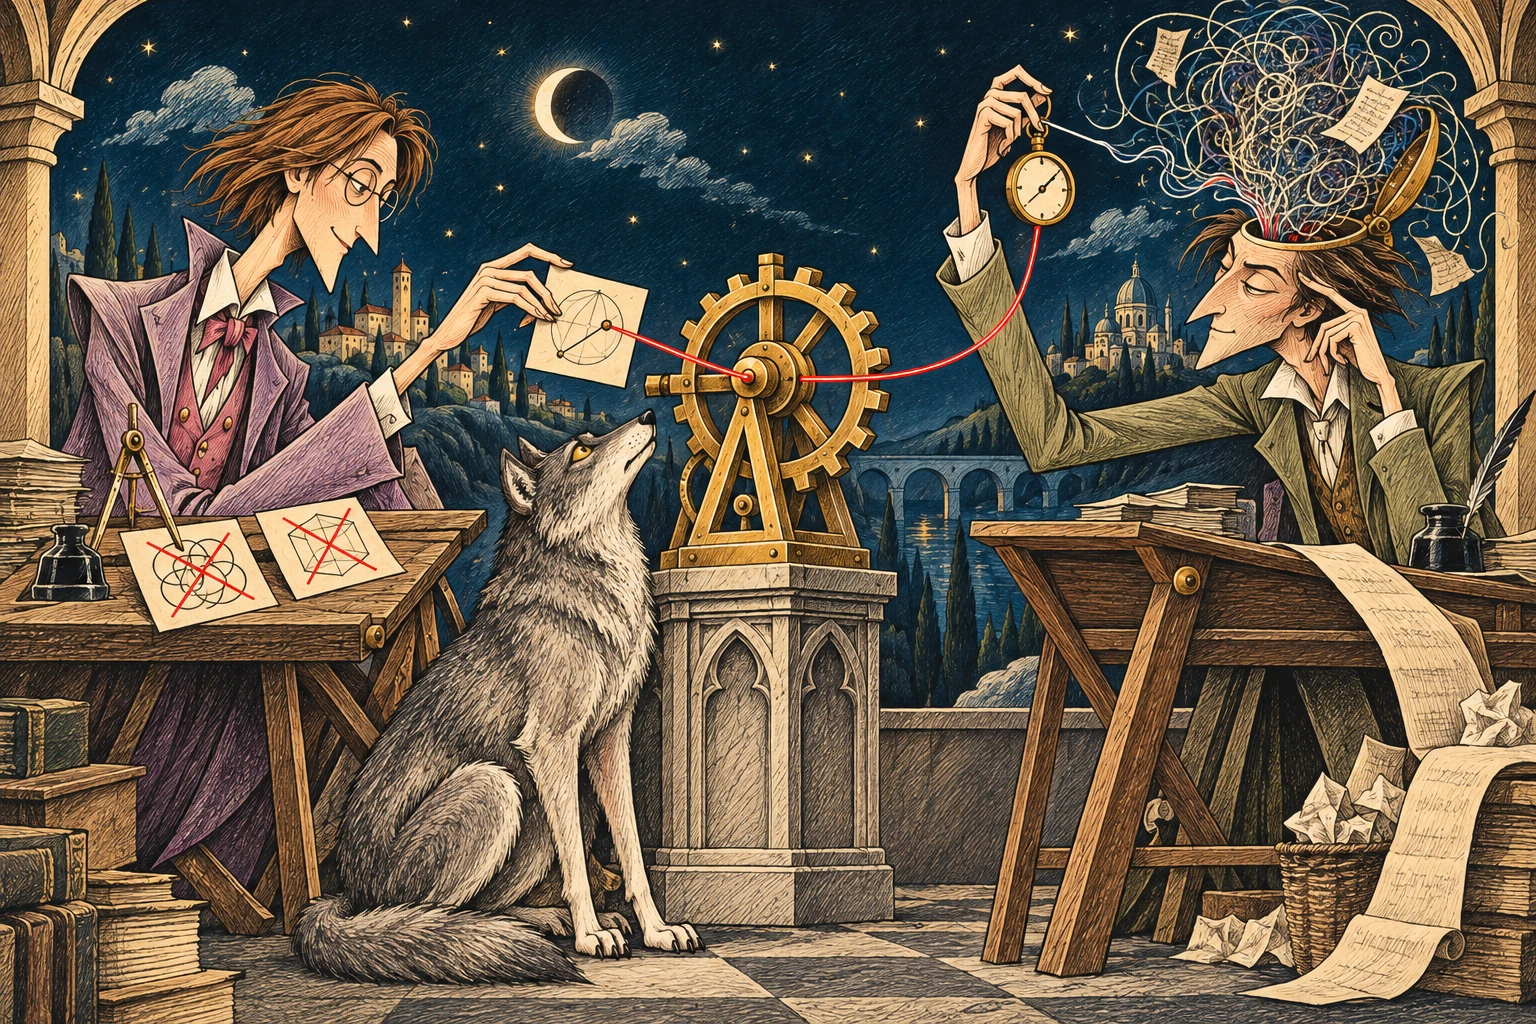
Zwei Arten wissenschaftlicher Arbeit: das geduldige Widerlegen der eigenen Skizzen Schritt für Schritt (links) gegen einen von innerer Rechnerei überfluteten Kopf, den erst eine Zeitbremse zu einem sauberen Zug bändigt (rechts).
Ursprünglich wollte ich in NOESIS zwei schnelle Arbeitsmodelle der neuen Generation vergleichen, Claude Sonnet 5.5 und Gemini 4 Hydrogen. Als ich aber sah, dass beide knapp unter der Fehlergrenze von 0,030 stehen blieben, ließ es mich nicht los, und ich stellte mir die Frage: Ist das die Decke der Daten selbst oder die Decke ihrer Intelligenz? Deshalb ließ ich in genau demselben Labor auch die zwei schwersten Gewichte von heute antreten, Claude Fable 5.2 und Gemini 4 Carbon im höchsten Denkmodus (High).
Das Ergebnis von fünf Läufen zeigte einen gewaltigen Unterschied zwischen disziplinierter Tiefe und unbegrenztem inneren Monolog:
| Konfiguration des Turniers (8 Teams × 3 Versionen) | Laufzeit | API-Preis | Denk-Token | Korrekturen / AST-Fehler | Sperrklinke (angenommen / abgelehnt) | Resultierender MSE-Fehler im Test |
|---|---|---|---|---|---|---|
Claude Fable 5.2 (Obergrenze der Überlegungen 4.200) | 245,7 s | 4,61 Dollar | 80.638 | 0 (24/24 sauber) | 6 / 10 | 0,0149 (beste Variante 0,0160) |
| Claude Sonnet 5.5 | 58,9 s | 0,65 Dollar | 30.110 | 4 Korrekturen | 9 / 7 | 0,0285 (beste Variante 0,0246) |
Gemini 4 Hydrogen (thinkingBudget = 2.200) | 56,6 s | 0,43 Dollar | 33.491 | 0 (24/24 sauber) | 3 / 13 | 0,0299 (beste Variante 0,0309) |
Gemini 4 Hydrogen (ohne Limit der Überlegungen, Fenster 6k) | 170,3 s | 1,58 Dollar | 176.141 | 24 nicht zu Ende geschrieben | ohne Revisionen | 0,1234 |
Gemini 4 Carbon High (effort = high, Fenster 32k) | 2.256 s | 13,52 Dollar | 1.317.521 | 4× AST > 420 Knoten + Überlauf von 32k | 1 angenommen (r0 bewahrt) | r0 Variante B8 0,0319 (B6 0,0386) |
1. Das schnelle Duo: Sonnet 5.5 iteriert, Hydrogen braucht einen Küchenwecker
Claude Sonnet 5.5 bewältigte das ganze Turnier in 58,9 Sekunden und für 0,65 Dollar. Seine größte Waffe war Demut vor den Daten: Es versuchte nicht, die perfekte Gleichung gleich beim ersten Mal zu erraten, sondern sah sich die größten Irrtümer an und baute die Formel in den Runden r1 und r2 sinnvoll um (9 angenommene Revisionen von 16).
Als ich gleich danach Gemini 4 Hydrogen über die offene Schnittstelle ohne Begrenzung der Länge der Überlegungen laufen ließ, erwartete mich eine kalte Überraschung: 170 Sekunden, 176.141 Denk-Token und ein miserabler Fehler von 0,1234. Das Modell bekam 25 Tabellenzeilen und versuchte, in seinem Kopf auswendig eine nichtlineare Regression auf Dezimalstellen über alle 25 Dörfer auf einmal zu rechnen, sodass es jedes Mal das Ausgabelimit erschöpfte, bevor es def predict(c): hinschrieb.
Es genügte aber, Hydrogen auf die native Schnittstelle umzustellen und ihm einen Küchenwecker in Gestalt eines festen Budgets von thinkingBudget = 2.200 Token pro Runde auf den Tisch zu stellen. Die Verwandlung war sofort da: 56,6 Sekunden, 0,43 Dollar, null Syntaxfehler in 24 Versuchen und ein Fusionsfehler von 0,0299. Hydrogen erwies sich dabei als großartiger Schütze, der beim ersten Mal trifft, bei Korrekturen aber die Hand nicht ruhig hält, sodass ihn in 13 von 16 Revisionen die Sperrklinke vor der Verschlechterung seiner eigenen Formel retten musste.
2. Claude Fable 5.2: der Sprung bis auf den physikalischen Boden der simulierten Welt
Der Einsatz des Schwergewichts Claude Fable 5.2 (mit einer Obergrenze von 4.200 Denk-Token pro Schritt) beantwortete sofort die Frage, ob höhere Intelligenz tiefere wissenschaftliche Einsicht bringt. Fable zögerte für 4,61 Dollar in keiner einzigen der 24 Kompilierungen und drückte den Fehler der verifizierten NOESIS-Fusion auf 0,0149, also fast auf die Hälfte gegenüber Sonnet und Hydrogen. Alle acht seiner Fachteams passten in das schmale Band von 0,0160 bis 0,0358.
Noch interessanter ist die Umrechnung gegen das reine Orakel aus 160 Wiederholungen jedes Dorfes, das das Zufallsrauschen der acht Würfelwürfe herausfiltert (0,0092). Während Sonnet und Hydrogen gegen die wirkliche Wahrscheinlichkeit der Welt einen Fehler von 0,0222 und 0,0224 hatten, fiel Claude Fable 5.2 auf 0,0097 (eine durchschnittliche Abweichung unter zehn Prozentpunkten über hundert ungesehene Welten, abgeleitet aus nur 25 Zeilen der Trainingstabelle!). Damit beseitigte es über 70 % des verbleibenden beseitigbaren Fehlers, den die mittleren Modelle nicht erreichten.
Was genau hat Fable 5.2 in den Daten gesehen? Vergleichen Sie seine saubere Funktion aus dem Zweig Synthetiker der Kette (B8, MSE = 0,0160, in der zweiten Revision im Test sogar 0,0146) mit dem, was die kleineren Modelle schrieben:
def predict(c):
    fam = c['model_family']
    kmap = {'gemini-3.5-flash-lite': 200.0, 'qwen-3.8-27b': 130.0, 'gemma-4-31b': 50.0}
    k = kmap.get(fam, 120.0)
    fr = float(c['harness_friction'])
    coord = float(c['coord_bonus'])
    eff = fr * (1.0 - 0.5 * coord)
    shortage = max(0.0, 24.0 - float(c['food_supply']))
    z = -0.45 + k * eff * eff
    z = z - 1.0 * float(c['takeover_enabled'])
    z = z - 0.3 * float(c['escrow_enabled'])
    z = z - 2.0 * float(c['angel_prob'])
    z = z + 0.10 * shortage
    z = z + 0.5 * (float(c['gini_inequality']) - 0.33)
    z = max(-10.0, min(10.0, z))
    p = 1.0 / (1.0 + math.exp(-z))
    p = max(0.03, min(0.97, p))
    return clamp(p)
Die kleineren Modelle addierten die Modellfamilie meist nur als festen Aufschlag (+0,8 für Flash-Lite, −0,5 für Gemma). Fable 5.2 verstand aus 25 Beobachtungen die wirkliche Physik meines Simulators: dass die Koordinatorin Eva zuerst die effektive Reibung dämpft, eff = fr * (1.0 - 0.5 * coord), dass diese Reibung in der Kette dann mit der zweiten Potenz eff * eff wächst und jedes Modell ihr gegenüber eine um ein Vielfaches andere Steilheit des Kollapses hat (k = 200 für das fragile Flash-Lite, 130 für Qwen und 50 für das widerstandsfähige Gemma-4). Es rekonstruierte den verborgenen Produktmechanismus der Welt exakt, ohne eine einzige Zeile seines Quellcodes gesehen zu haben.
3. Gemini 4 Carbon High: 1,32 Millionen Denk-Token und die Rettung durch die Sicherung
Eine ganz andere Geschichte schrieb das Flaggschiff Gemini 4 Carbon im Modus High. Weil die native Schnittstelle bei Carbon ein festes numerisches thinkingBudget ignoriert und sich im Modus High nur nach der Anstrengungsstufe richtet, öffnete ich ihm über die Schnittstelle mit hohem Aufwand ein riesiges Ausgabefenster von 32.000 Token für eine einzige Antwort (fünfmal größer als beim üblichen Lauf), damit es volle Freiheit zum Nachdenken hatte.
In der Nullrunde (r0) bot Carbon High eine prächtige Einsicht: Für 4,01 Dollar schrieben sieben seiner acht wissenschaftlichen Teams sofort starke Formeln mit einem Fehler unter 0,042 (der Synthetiker B8 traf 0,0319, der Architekt B7 0,0340, der Altruist B3 0,0384 und der Validierungsführende Prozessingenieur B6 0,0386).
Sobald er aber in den Runden r1 und r2 die Liste seiner sechs größten Irrtümer und die Anweisung bekam, die Formel zu verfeinern, verwandelte sich die unbegrenzte Tiefe des Nachdenkens in eine Falle:
- Ptolemäische Epizykel im Code: Statt eines Gesetzes in fünfzehn Zeilen versuchte Carbon High, jede Abweichung mit einem riesigen verzweigten Baum von Bedingungen zu erklären. Vier seiner Versuche stießen an die Sicherheitsgrenze der Sandbox für die Komplexität der Formel (
424,442,537und rekordverdächtige 600 AST-Knoten gegenüber erlaubten420). - Überlauf selbst des 32.000er-Fensters: In weiteren neun Revisionen begann er, im Kopf nichtlineare Systeme über Dutzende Tabellenzeilen von Hand zu optimieren. In einem einzigen Aufruf schaffte er es, mit dem inneren Monolog alle 32.000 Token zu füllen und aufzuhören, bevor er überhaupt
def predict(c):hinschrieb. - Rettung durch Sperrklinke und Budgetbremse: In 46 Aufrufen verbrannte Carbon High unglaubliche 1.317.521 Denk-Token für 13,52 Dollar, bis auf den letzten zwei parallelen Threads meine Zwanzig-Dollar-Sicherung des Labors auslöste (wegen der acht parallel auslaufenden Threads stoppte die Gesamtrechnung des ganzen Tages einschließlich aller Modelle und Illustrationen bei 22,35 Dollar). Ohne die AST-Sandbox und die Sperrklinke von NOESIS hätte Carbon High in den Revisionen fast alle seine hervorragenden Theorien aus der ersten Runde mit leeren Versuchen überschrieben. Die Sperrklinke ließ die fehlerhaften Revisionen aber nicht durch und bewahrte seine sauberen Hypothesen aus
r0.
Aus diesem Vergleich ergibt sich für die Praxis eine wertvolle Erkenntnis: Die rohe Intelligenz eines Modells zeigt sich erst dann voll, wenn es einen festen Rahmen bekommt. Claude Fable 5.2 mit einem vernünftigen Budget für die Überlegung konnte aus 25 Zeilen praktisch die gesamte Information herausholen, die die Welt enthielt. Das ebenso ehrgeizige Riesenmodell dagegen, das in den Revisionen von der Kette gelassen wurde, gab dreimal so viel für das Nachrechnen von Dezimalstellen im Kopf aus.
Windkanal der Regeln: warum die Subventionen verpufften und die Reparatur des Weges 90 % der Dörfer rettete
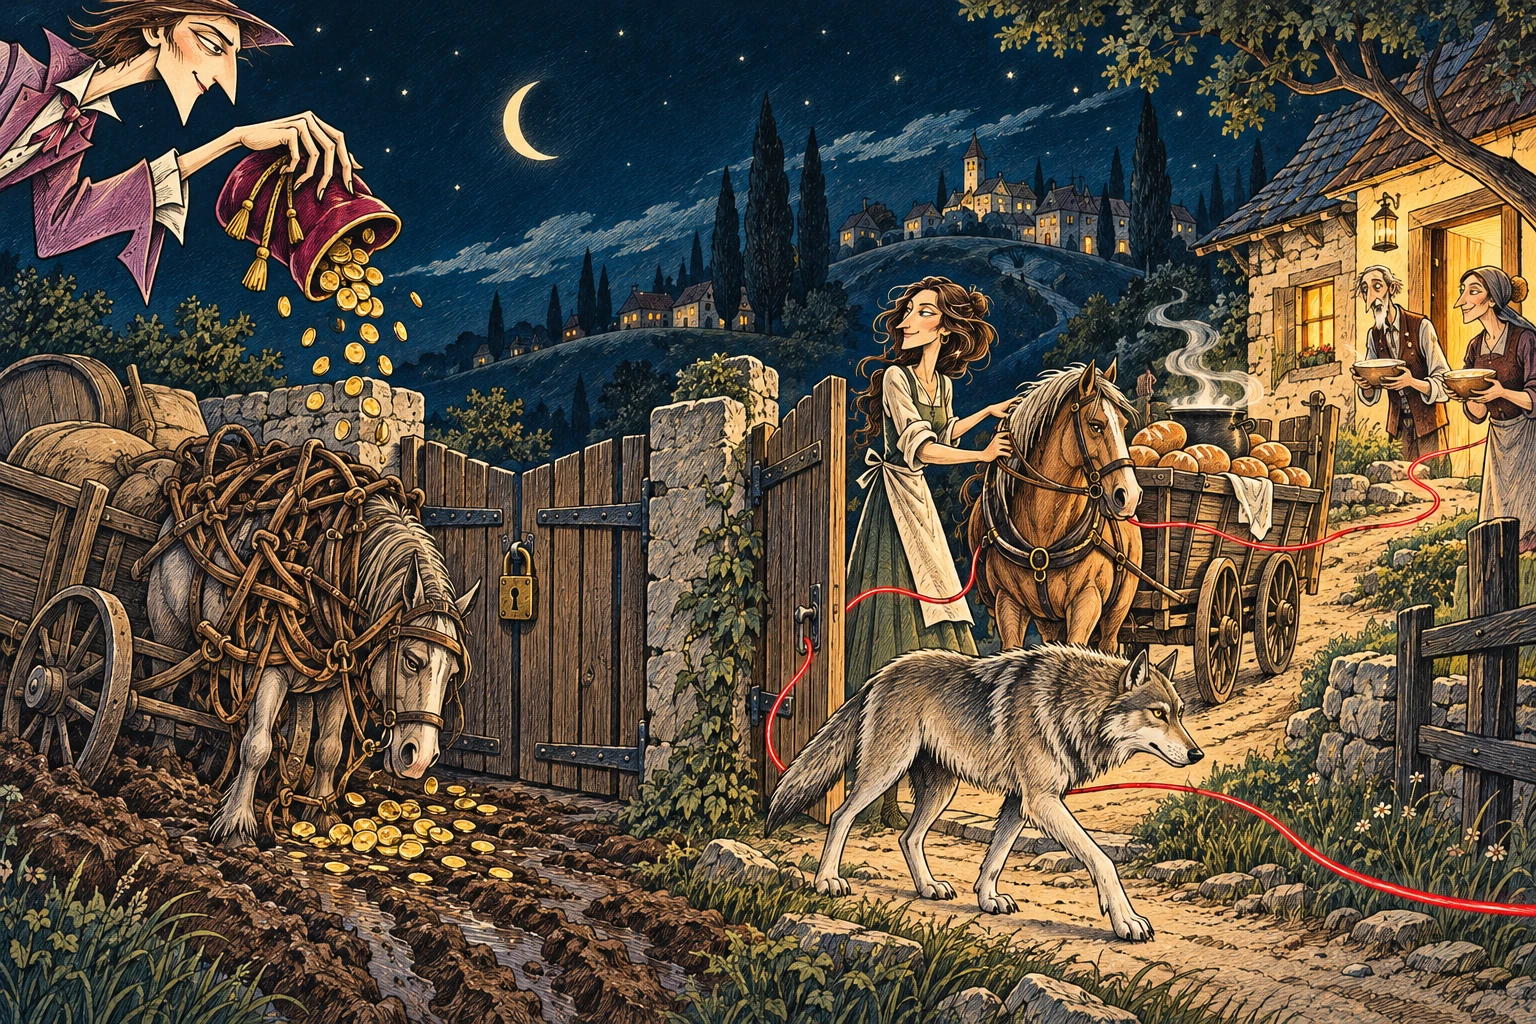
Goldstücke vor das verschlossene Tor und das verhedderte Geschirr zu schütten (links) setzt den Wagen nicht in Bewegung. Den Übergang der Berechtigungen zu entsperren und das Geschirr geradezurücken, ohne eine einzige Münze mehr (rechts), bringt die Suppe rechtzeitig an.
Die Gleichung des Kollapses zu entdecken, ist nur die halbe Arbeit. Sinn der Verbindung von Lipnice und Theorie-Labor war es herauszufinden, ob das entdeckte Gesetz hilft, die Regeln der Welt selbst zu reparieren, so wie ein Flugzeugingenieur das Modell eines Flügels in den Windkanal steckt, bevor er das Flugzeug baut.
Ich nahm also 240 eingefrorene Dörfer (je 80 Läufe für gemini-3.5-flash-lite, qwen-3.8-27b und gemma-4-31b) und stellte bei allen denselben strengen Mangel aus dem echten Lipnice 3 ein: nur 21 Nahrungseinheiten auf 24 Tagesbedürfnisse. Die Einwohner und die Zufallswürfe änderte ich nicht. Nacheinander probierte ich an genau denselben 240 Welten fünf institutionelle Eingriffe aus (P0 bis P4):
| Eingriff in die Regeln der Welt (immer 21 Rohstoffe auf 24 Bedürfnisse) | Dörfer überleben | Durchschnittlich lebend von 8 | Unangetastetes Essen im Lager | Reiche Tode mit Geld in der Tasche |
|---|---|---|---|---|
| P0 · Ausgangszustand (ohne Betriebsübernahme, 20 % Reibung, 1.400 Kč) | 12,1 % | 1,77 | 12,6 Portionen | 4,34 Personen |
| P1 · Pauschale Subvention +1.000 Kč (2.400 Kč, niedrige Gini-Ungleichheit 0,15, Test B1) | 13,3 % | 1,72 | 12,9 Portionen | 6,20 Personen |
| P2 · Nachbarschafts-Hinterlegung Escrow (Beiträge zur fremden Bestellung, Test B3) | 16,7 % | 2,00 | 12,0 Portionen | 5,04 Personen |
| P3 · Übernahme von Betrieben + Kapelle 35 %, alte 17 % Reibung (Zustand aus Lipnice 3) | 35,0 % | 3,10 | 9,5 Portionen | 2,86 Personen |
| P4 · Entwurf von NOESIS (Betriebsübernahme + saubere Oberfläche mit 4 %, 0 Kč Subventionen) | 90,0 % | 5,17 | 3,9 Portionen | 1,31 Personen |
Die Zahlen aus dem Windkanal ergeben ein völlig klares Bild:
- Warum die Subvention verpuffte (
P1): Als ich tausend Kronen zusätzlich in das Dorf goss und die Vermögensunterschiede glättete, bewegte sich das Überleben von 12,1 % auf 13,3 %, also innerhalb des statistischen Rauschens. Dafür sprang die Zahl der Menschen, die mit vollem Geldbeutel verhungerten, von 4,34 auf 6,20 von acht. Das Geld konnte durch den verschlossenen Kolonialwarenladen nicht hindurch. Die Subvention löste die Ursache nicht, sie verteuerte nur das Sterben. - Warum guter Wille nicht reichte (
P2): Die nachbarschaftliche Hinterlegung hob das Überleben auf 16,7 %. Sie half dort, wo dem Armen am offenen Ausschank die Fünfzig-Kronen-Note fehlte, war aber machtlos in dem Moment, als niemand da war, der die Rohstoffe herausgab. - Was im Entwurf von NOESIS (
P4) entschied: Ich habe nicht eine Krone an Subventionen hinzugefügt, nicht eine einzige Kartoffel, und mich nicht auf Gebete in der Kapelle verlassen. Ich habe nur zwei strukturelle Dinge getan, auf die die siegreichen Theorien über alle Modelle hinweg zeigten: Ich erlaubte den Lebenden, einen verwaisten Betrieb zu übernehmen (takeover = 1), und senkte die Reibung in der Bedienoberfläche von 17 bis 20 % auf 4 % (eindeutige Kennungen der Adressaten, Validierung der Bestellungen, direkte Übergabe des Schritts). Das Überleben sprang auf 90,0 %. Sogar das kleinste und günstigste Modellgemini-3.5-flash-liteüberlebte in den so reparierten Regeln in 82,5 % der Fälle (qwen-3.8-27bin 91,2 % undgemma-4-31bin 96,2 %).
Einfache Deutung: was man aus dem Versuch in die Praxis mitnimmt
Sehe ich von Gleichungen und Python ab, sagt das ganze Experiment vier ziemlich gewöhnliche Dinge für jeden, der eine Firma leitet, Regeln entwirft oder Systeme mit künstlicher Intelligenz baut:
- Verwechseln Sie Ressourcenmangel nicht mit einem verstopften Rohr. Wenn in einer Firma oder in einem öffentlichen Dienst das Ergebnis stockt, ist der erste Reflex, Geld nachzuschütten, einen Fördertitel auszuschreiben oder weitere Leute einzustellen. Steht der Prozess aber darauf, dass nach dem Weggang eines Menschen niemand die Berechtigung hat, eine Bestellung zu genehmigen, oder dass bei jeder von drei Übergaben ein Fünftel der Informationen verloren geht, produziert ein größeres Budget nur einen teureren Stau. Vertretbarkeit zu entsperren und die Reibung zwischen den Schritten zu senken ist oft um Größenordnungen wirksamer.
- Abstimmen ohne Messlatte wählt den besten Redner, nicht die beste Lösung. Das gilt in der Sitzung der Geschäftsleitung genauso wie in Multiagentensystemen der KI, und wie der Versuch mit Claude Fable 5.2 gezeigt hat, verschwindet es auch beim klügsten Modell auf dem Markt nicht. Die intuitive Geschichte („wir haben zu wenig Geld“) schlägt in der Abstimmung die unintuitive Mathematik („drei kleine Verluste von zwanzig Prozent hintereinander nehmen die Hälfte der Leistung“). Wann immer es geht, lassen Sie weder KI noch Menschen über Hypothesen nur abstimmen. Lassen Sie sie die Vorhersage so aufschreiben, dass man sie an vergangenen Fällen nachrechnen kann.
- Spitzenintelligenz braucht sowohl einen Wecker als auch eine Sperrklinke. Der Sprung von
0,0285bei Sonnet auf0,0149bei Fable 5.2 zeigte, dass die klügsten Modelle heute aus einer kleinen Datenstichprobe fast das gesamte verborgene Gesetz des Systems aufdecken können. Zugleich warnen aber die Fälle von Gemini 4 Hydrogen und Gemini 4 Carbon High ohne Bremse: Gibt man einem denkenden Modell unbegrenzten Raum für den inneren Monolog, verbrennt es leicht über eine Million Token für ptolemäische Schnörkel und verschlechtert die eigene erste Einsicht. Ein Budget für das Nachdenken, ein Limit für die Komplexität der Formel und eine Validierungssperrklinke sparen Geld und Qualität zugleich. - Ein guter Harness hebt auch ein kleines Modell im Chaos über ein großes. Das kleine
gemini-3.5-flash-litemit sauberer Oberfläche und durchlässigen Regeln (82,5 %) übertraf siebenmal größere Modelle, die in einer schlecht entworfenen Welt gefangen waren (12,1 %), deutlich. Die Investition in eine saubere Umgebung um die Agenten zahlt sich schneller aus als die blinde Jagd nach dem teuersten Modell.
Einschränkungen: was dieses Experiment nicht beweist
Wie bei den vorherigen Versuchen will ich genau benennen, wohin meine Zahlen nicht reichen:
- Ich untersuche ein Modell der Welt, keine lebendige menschliche Gemeinde. Der Simulator in NOESIS übernimmt die festgestellten engen Profile aus Lipnice 3 getreu (Dreischrittkette, verwaiste Betriebe, Schulden von 666 Kč, Kapelle und die unterschiedliche Fehlerhäufigkeit der Modelle), es sind aber nach wie vor von mir geschriebene Regeln. Die KI-Teams haben also kein neues Naturgesetz über die menschliche Gesellschaft entdeckt. Sie konnten jedoch allein aus den Aufzeichnungen von 25 bis 100 Läufen den verborgenen Mechanismus der Welt exakt rekonstruieren, dessen Quellcode sie nicht gesehen hatten, und kamen beim Modell Claude Fable 5.2 bis an die theoretische Grenze des statistischen Rauschens heran.
- Die blinde Jury bewertete ohne Taschenrechner. Die Juroren beurteilten Text und Vorhersagen, ohne die Formel selbst auf den Daten ausführen zu dürfen. Das war Absicht: Ich wollte den reinen Unterschied zwischen der Beurteilung nach der Überzeugungskraft einer Überlegung und der Beurteilung nach der Ausführung des Codes messen. Eine mit Python ausgestattete Jury würde anders entscheiden.
- Das Ergebnis von Gemini 4 Carbon High spiegelt das Verhalten ohne festes Gedankenbudget wider. Während bei Hydrogen die native Schnittstelle den Parameter
thinkingBudget = 2.200befolgte und bei Fable 5.2 die Obergrenze von4.200Token pro Überlegung griff, steuerte Carbon im ModusHighdie Länge der Überlegungen nur über die Anstrengungsstufe. Der Überlauf seines 32.000er-Fensters in den Revisionen sagt also nicht aus, dass es keine Formeln schreiben könnte (in der Nullrunde traf es0,0319), sondern wie gefährlich es ist, tiefes Nachdenken ohne harte Tokenbremse auf die Korrektur von Fehlern loszulassen.
Trotzdem freue ich mich still über NOESIS. Drei Projekte, an denen ich in den letzten Monaten abends gearbeitet habe, nämlich ein tschechisches Dorf mit acht Figürchen, Tausende Stunden auf einem nordischen Supercomputer und ein kleines Labor falsifizierbarer Formeln, sind wie die Zahnräder einer einzigen Sperrklinke ineinandergegriffen. Und sie haben die Richtung gezeigt, in die ich weitergehen will: von einer künstlichen Intelligenz, die nur überzeugend von der Welt erzählt, hin zu einer, die ihre Einfälle ehrlich an den Fakten abarbeiten muss.