Wölfe und Raben in Core War: acht Instruktionen unter den Favoriten
Wie wir mit KI Wolf Raven und den nur acht Instruktionen langen Lone Wolf entwickelten. Drei Ranglisten, echte Arenabilder und Schwächen hinter dem besten Durchschnitt.

Acht Instruktionen. So klein ist Lone Wolf, einer unserer mit KI entwickelten Core-War-Kämpfer. In der großen Überprüfung landete er knapp hinter dem 100 Instruktionen langen Wolf Raven und vor unserem bisherigen Favoriten Kompas. Manchmal passt eine gute Idee tatsächlich in wenige Zeilen.
In meinem Projekt Dungeon arbeiteten Agenten in Codex und Claude Code an einer konkreten Aufgabe: Kämpfer entwerfen, gegen ein festes Teilnehmerfeld testen und Code samt Ergebnissen abgeben. Daraus entstanden unsere Wölfe und Raben, drei Ansätze, einen Gegner aufzuspüren und auszuschalten.
Experiment vom 10. Oktober 2026, abschließende Validierung am 11. Oktober ergänzt. Das Titelbild mit Wolf und Rabe ist eine KI-generierte Illustration. Echte Arenabilder und Messergebnisse folgen unten. Die Oberfläche ist tschechisch, die Diagramme sind englisch.
Was gelungen ist
- Wolf Raven und Lone Wolf führen unter fünf verglichenen Programmen gegen dieselben 25 Gegner. Jedes Programm absolvierte 50.000 Spiele.
- Lone Wolf benötigt nur acht Instruktionen. Die Länge eines Programms sagt wenig über seine Spielstärke aus.
- Raven Scout schlug Wolf Raven in 71 von 100 direkten Duellen eines separaten Abgabetests. Der beste Durchschnitt bedeutet keinen Sieg gegen jeden Gegner.
Eine Arena, in der man gegnerischen Code überschreibt
Stellen Sie sich ein gemeinsames Spielfeld mit 8.000 Speicherzellen vor. Jede kann eine Instruktion enthalten. Zwei Programme führen abwechselnd Befehle aus und dürfen den gesamten Speicher überschreiben, auch den gegnerischen Code. Wer DAT ausführt, verliert den betreffenden Prozess. Wer alle Prozesse verliert, verliert das Spiel.
Ein Kämpfer kann zusätzliche Prozesse erzeugen oder sich an andere Stellen kopieren. Ein einzelner Treffer reicht deshalb oft nicht. Man muss den Gegner finden und seine Fluchtmöglichkeiten begrenzen.
Während des Duells trifft kein Sprachmodell Entscheidungen. Die KI half vorher beim Entwurf und bei Überarbeitungen. In der Arena läuft ausschließlich der resultierende Redcode, eine kleine assemblersprachliche Programmiersprache.
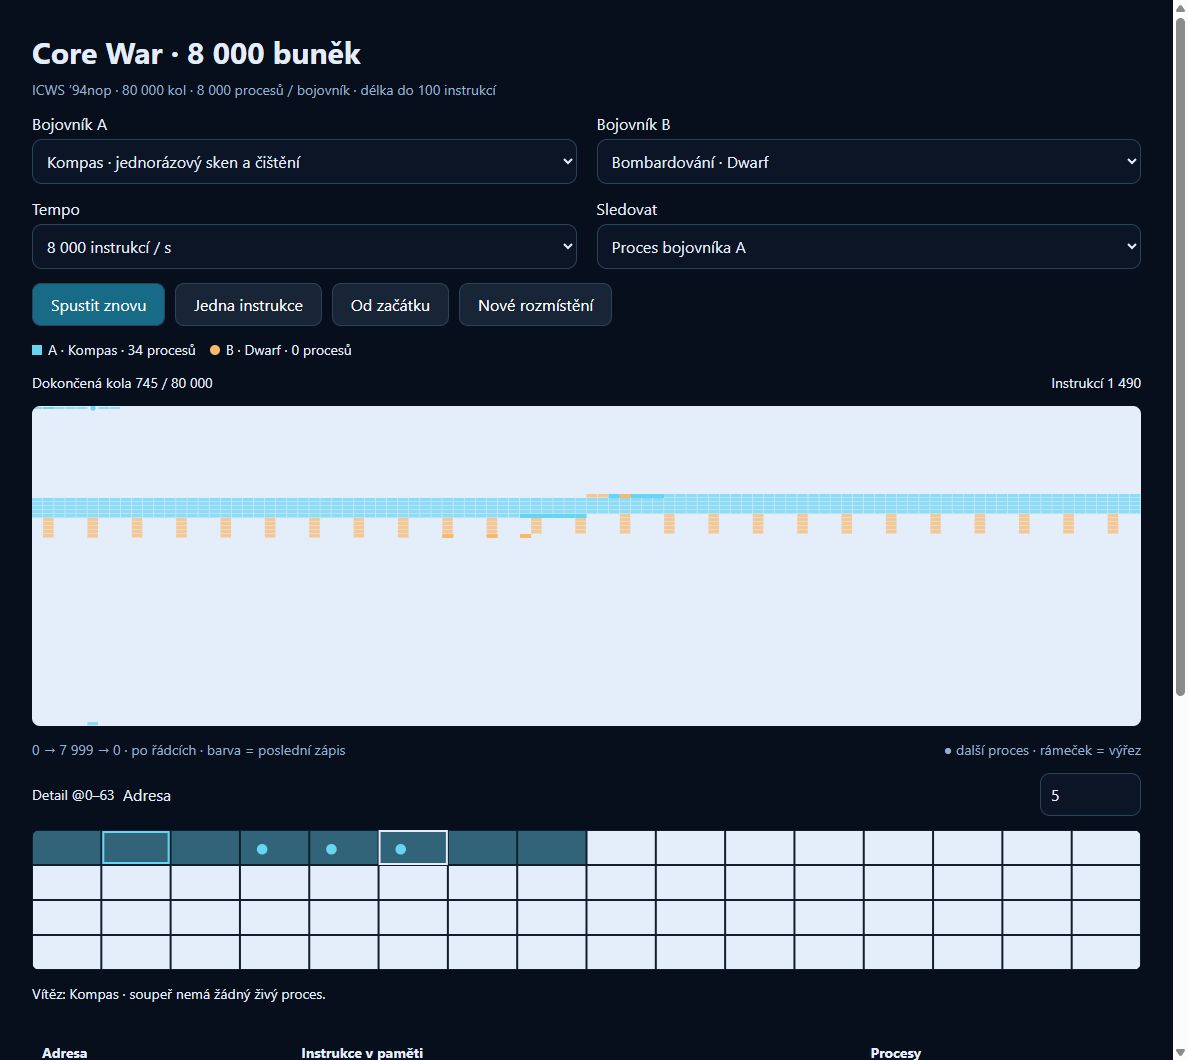
In diesem einzelnen Duell gewann Kompas gegen Dwarf. Die Farben zeigen, welches Programm zuletzt in eine Zelle geschrieben hat. Das Bild erklärt die Spielmechanik; eine Rangliste braucht viele Partien.
Stein, Schere, Papier mit zusätzlichen Tücken
| Strategie | Vorgehen | Typische Schwäche |
|---|---|---|
| Bomber | Verteilt zerstörerische Instruktionen im Speicher. | Kann kleine oder verlagerte Ziele verfehlen. |
| Scanner | Sucht Spuren und greift gezielt an. | Die Suche kostet Zeit; Replikatoren können entkommen. |
| Replikator | Erstellt Kopien und verteilt das Risiko. | Wirksame Löschroutinen können die Kopien beseitigen. |
| Imp | Kopiert fortlaufend eine Instruktion nach vorne. | Überleben führt häufig zum Unentschieden statt zum Sieg. |
Das sind Tendenzen, keine garantierten Ergebnisse. Instruktionen, Startpositionen und Gegner entscheiden. Im ursprünglichen Teilnehmerfeld waren Scanner besonders erfolgreich. An diesem bekannten Umfeld haben wir die neuen Kämpfer optimiert.
Rangliste eins: das ursprüngliche Feld
Im vollständigen Rundenturnier mit 26 Kämpfern spielte jeder gegen jeden. Das ergab 32.500 Partien, 2.500 pro Kämpfer. Die besten zehn:
| Rang | Kämpfer | Punkte / 100 |
|---|---|---|
| 1 | Kompas | 230,00 |
| 2 | Scanny Boy | 229,12 |
| 3 | Žnec | 211,72 |
| 4 | Rave | 207,48 |
| 5 | Aeka | 197,24 |
| 6 | Fénix | 190,24 |
| 7 | Core Explorer Paper | 180,24 |
| 8 | Hydra | 177,04 |
| 9 | Flash Paper 3.7 | 169,04 |
| 10 | Bastion | 161,84 |
Die Punktzahl ist keine Siegquote. Ein Sieg zählt 3 Punkte, ein Unentschieden 1, eine Niederlage 0. Angegeben sind Punkte pro 100 Spiele, maximal 300. Hundert Unentschieden bringen 100 Punkte, hundert Siege 300.
Unsere Wölfe und Raben
Wolf Raven, 100 Instruktionen: schnelle erste Suche, Verlagerung des Kampfcodes, Spurensuche und anschließender Angriff. SPL vervielfacht die gegnerischen Prozesse und bremst sie aus, DAT beendet sie. Ein zusätzlicher Imp bietet eine Überlebenschance. Wolf und Rabe sind Bilder für Teile eines Programms, keine zwei miteinander sprechenden KI-Agenten.
Wolf Raven verändert Parameter von King Cobra des Autors inversed. Wir bauen auf einem bestehenden Entwurf auf und beanspruchen nicht dessen Erfindung.
Lone Wolf, acht Instruktionen: Die Entwicklungslinie führt von Scanny Boy von David van Dam über den mit Codex entwickelten Kompas zu weiteren Änderungen in Claude Code. Seine geringe Angriffsfläche und die Angriffsrichtung helfen hier gegen Imp und Dwarf. Gegen manche kombinierten Strategien verliert er dagegen an Boden.
Raven Scout, 89 Instruktionen: Grundlage ist CLRSRC von Stefan Kammann und Forge-AI, das wiederum auf Eternal Exile von inversed aufbaut. Nach einem begrenzten Angriff sucht er weiter. Seine günstigen Paarungen unterscheiden sich von denen der Wölfe. Alle drei gehören jedoch zur weiteren Familie der Scanner.
Dies ist kein kontrollierter Vergleich von Codex und Claude Code. Vorgehen, Vorarbeiten und verfügbare Unterlagen unterschieden sich. Die Ergebnisse belegen keine allgemeine Überlegenheit eines KI-Modells.
Rangliste zwei: dieselben Gegner für alle
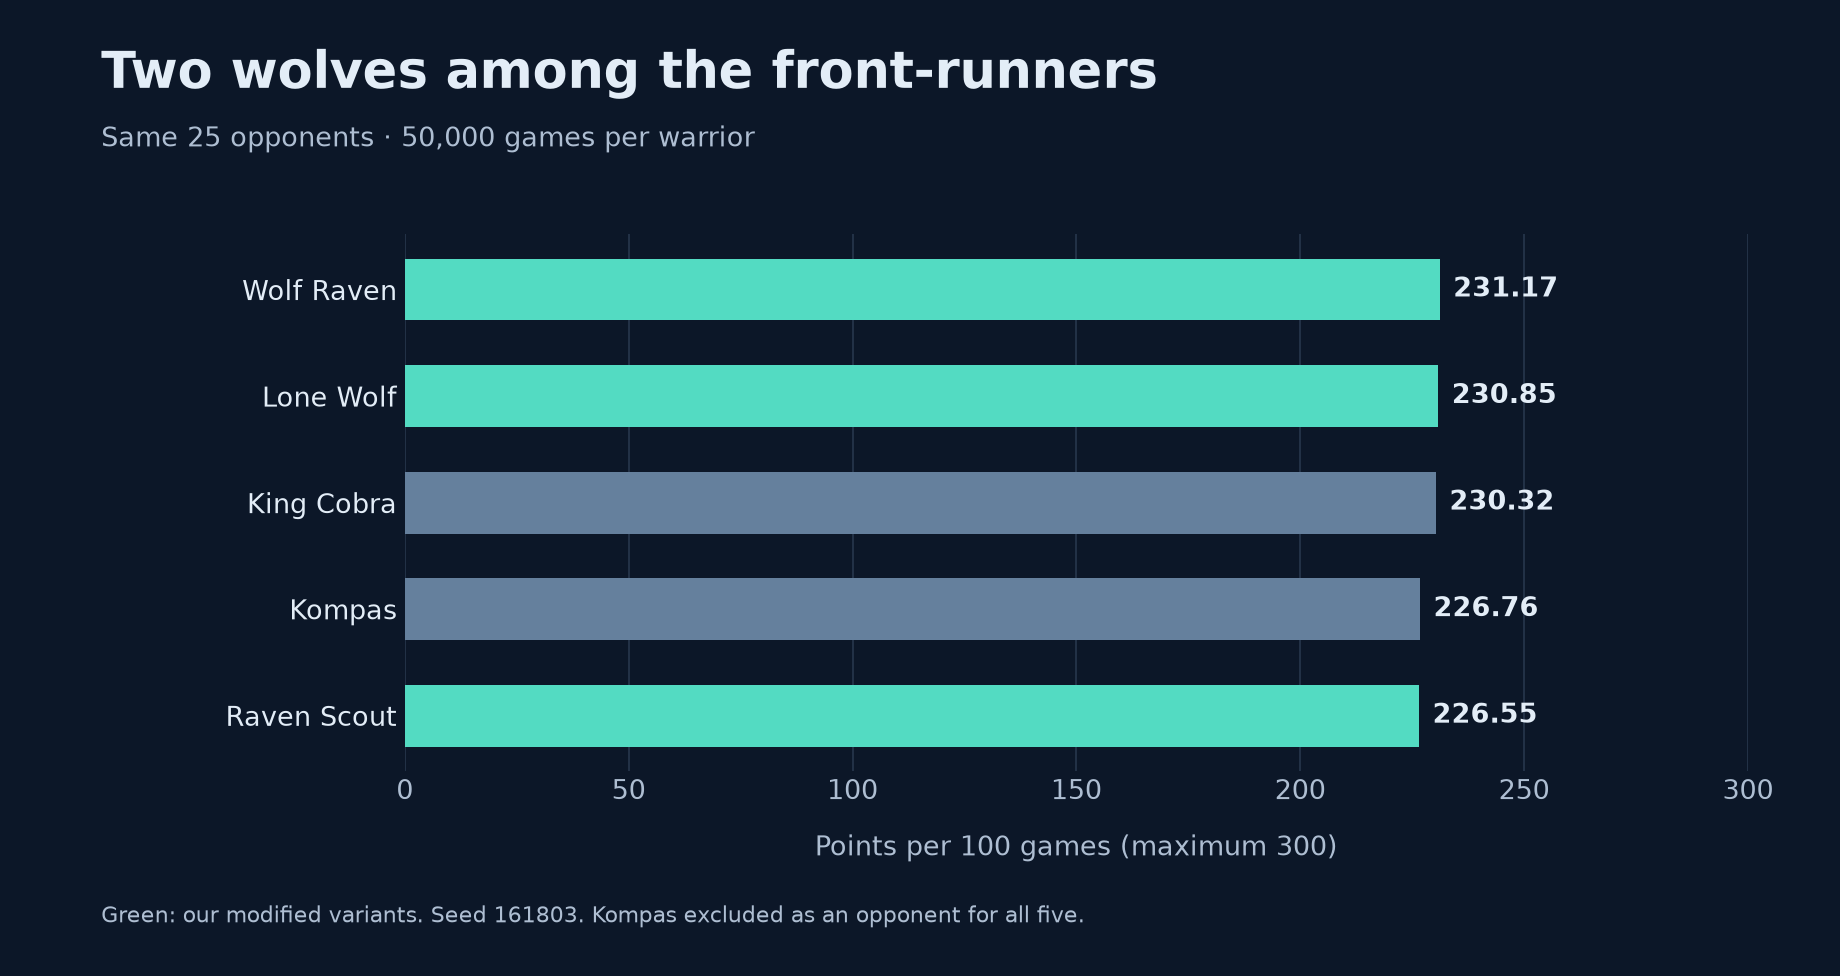
Nach dem Einfrieren des Codes folgte eine größere Überprüfung mit 1.000 Startpositionen und beiden Zugreihenfolgen. Für den Hauptvergleich habe ich die gespeicherten Spiele gegen dieselben 25 Gegner für alle fünf Programme ausgewertet, also jeweils 50.000 Spiele.
| Rang | Kämpfer | Punkte / 100 |
|---|---|---|
| 1 | Wolf Raven | 231,17 |
| 2 | Lone Wolf | 230,85 |
| 3 | King Cobra | 230,32 |
| 4 | Kompas | 226,76 |
| 5 | Raven Scout | 226,55 |
Beide Wölfe liegen vor Kompas und der ursprünglichen King Cobra. Darüber freue ich mich. Wolf Raven führt vor Lone Wolf allerdings nur um 0,314 Punkte pro 100 Spiele. Das ist kein überzeugender Nachweis einer dauerhaften Überlegenheit. Raven Scout liegt hier knapp hinter Kompas.
Warum 25 statt 26 Gegner? Kompas gehört selbst zum Referenzfeld. Unser Vergleichs-Kompas hätte sonst auch gegen seine eigene Kopie gespielt. Deshalb habe ich diesen Gegner bei allen fünf Programmen gleichermaßen herausgenommen. Die übrigen Spielergebnisse bleiben unverändert. Die ursprünglichen Daten für 26 Gegner stehen unten zum Download.
Der Durchschnitt verbirgt Schwächen
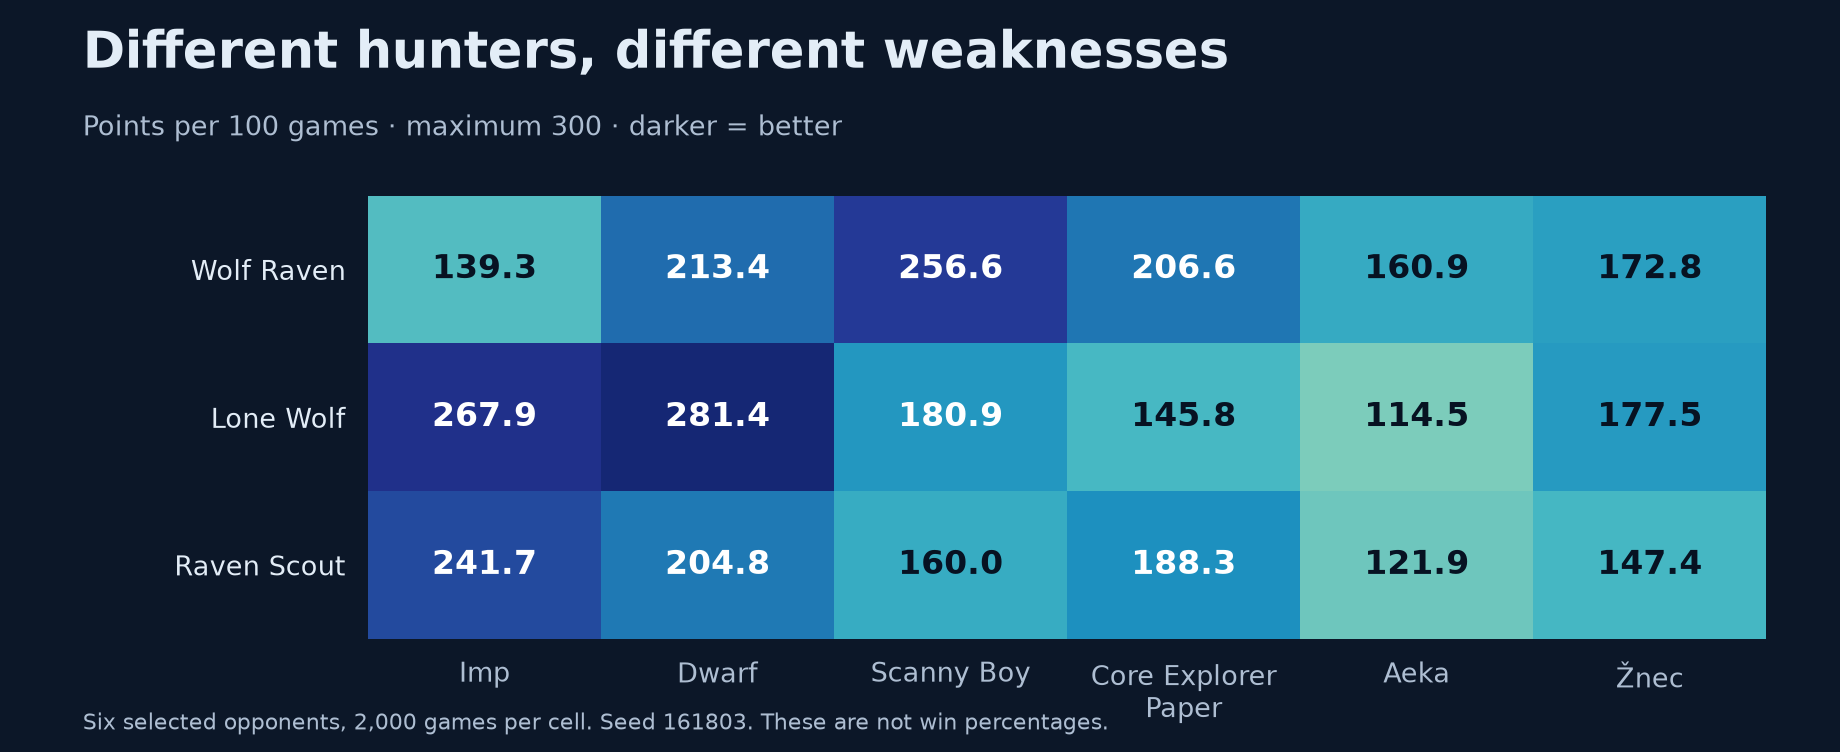
Jedes Feld umfasst 2.000 Spiele und zeigt Punkte pro 100 Spiele, keine Siegquote. Die sechs Gegner illustrieren unterschiedliche Schwächen; die Hauptrangliste verwendet alle 25 gemeinsamen Gegner.
Wolf Raven verlor kein einziges Spiel gegen Imp. Allerdings endeten 1.607 von 2.000 Duellen unentschieden. Er überlebt gut, verdient hier aber weniger Punkte als Lone Wolf. Der wiederum hat Probleme mit Aeka. Solche Informationen helfen beim nächsten Entwurf mehr als ein einzelner Tabellenplatz.
Rangliste drei: auch gegen die Geschwister
In einem separaten Abgabetest trat jeder Neuling gegen die 26 Referenzkämpfer und die anderen zwei Neulinge an, jeweils 2.800 Spiele:
| Kämpfer | Siege | Remis | Niederlagen | Punkte / 100 |
|---|---|---|---|---|
| Wolf Raven | 1971 | 468 | 361 | 227,89 |
| Raven Scout | 2045 | 186 | 569 | 225,75 |
| Lone Wolf | 1953 | 294 | 553 | 219,75 |
Raven Scout schlug Wolf Raven 71:26 bei drei Unentschieden und Lone Wolf 74:26. Wolf Raven schlug Lone Wolf 83:16 bei einem Unentschieden. Raven Scout kann unsere Wölfe jagen, erreicht gegen das übrige Feld aber nicht den besten Durchschnitt.
Dieser Test enthält nur Paarungen mit mindestens einem Neuling. Er ist kein vollständiges Turnier aller 29 Kämpfer und bestimmt daher keinen neuen Gesamtsieger.
Was nicht funktionierte
Mehr Jäger zu einem größeren Rudel zu verbinden klang gut. Im gemeinsamen Speicher können sie jedoch ihre eigenen Verstecke überschreiben oder einander zerstören. Mehr Komponenten brachten nicht automatisch bessere Ergebnisse.
Auch die Tests enthielten Fallen. Ein Entwurf, der auf wenigen Startpositionen glänzte, konnte seinen Vorsprung anderswo verlieren. Regelmäßige Suchschritte können zudem irreführend mit regelmäßig angeordneten Startpositionen zusammenfallen. Entscheidend ist die Schleife aus Idee, Messung, Schwächenanalyse, Überarbeitung und erneuter Prüfung. Eine überzeugende KI-Erklärung ersetzt keine Partien.
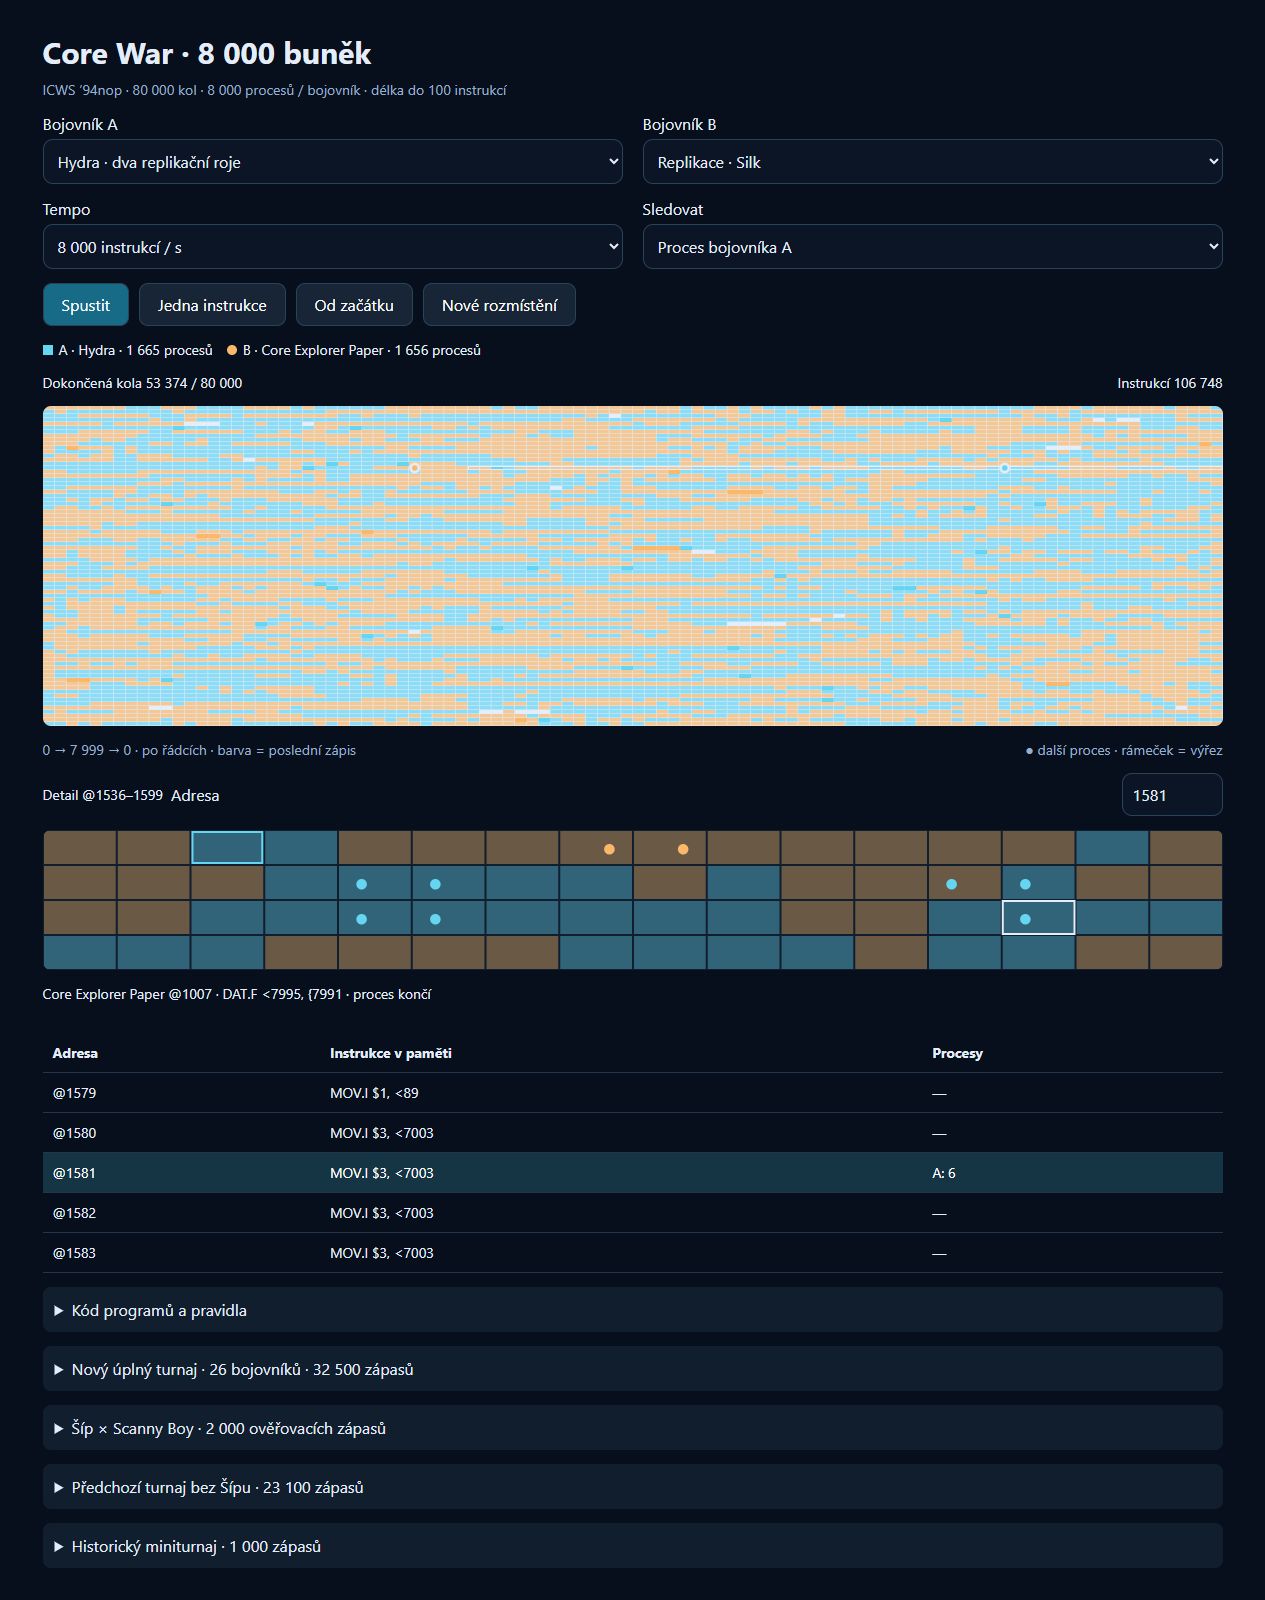
Die Farben zeigen den letzten Schreibzugriff, keinen dauerhaften Besitz. Tausende Prozesse erklären, warum ein einzelner Treffer nicht unbedingt entscheidet.
Die Verbindung zur Forschung
Digital Red Queen von Sakana AI und MIT lässt ebenfalls Sprachmodelle Core-War-Kämpfer gegen eine wachsende Historie von Gegnern entwickeln. Unser kleinerer Versuch stellt eine verwandte Frage: Wie prägt die Umgebung eine erfolgreiche Strategie?
Unsere Punktzahlen sind nicht direkt mit dieser Studie vergleichbar. Teilnehmerfelder, Evolution und Bewertung unterscheiden sich. Einige Dateien aus einem Repository zu testen wäre keine Replikation des veröffentlichten Experiments. Details stehen in der Digital-Red-Queen-Arbeit.
Wohin das Rudel als Nächstes soll
Zuerst in ein vollständiges Turnier mit erweitertem Feld. Danach gegen starke Gegner, an denen wir nie optimiert haben. Interessant finde ich auch eine Auswahl sich ergänzender Kämpfer: Ein Spezialist könnte die Schwächen des besten Allrounders abdecken.
Hilft KI uns nicht nur, mehr Code zu produzieren, sondern zu erkennen, welche Ideen funktionieren und warum? Unsere Wölfe geben eine vielversprechende Antwort für eine bestimmte Arena. Nun müssen wir herausfinden, was darüber hinaus Bestand hat.
Ergebnisse, Code und Testbedingungen
- Hauptvergleich und sämtliche Referenzpaarungen (JSON)
- Rangliste gegen dieselben 25 Gegner (CSV)
- Ursprüngliches Turnier mit 26 Kämpfern (JSON)
- Zusammenfassung des Abgabetests (JSON)
- Einzelergebnisse des Abgabetests (JSON)
- Protokoll der großen Validierung (TXT)
- Daten und unsere drei Kämpfer als Paket (ZIP)
- Redcode: Wolf Raven, Lone Wolf, Raven Scout.
Methodik und Grenzen
Eigene JavaScript-Implementierung von ICWS ’94nop, nicht das ursprüngliche pMARS-Binärprogramm. Speicher: 8.000 Zellen. Grenzen: 8.000 Prozesse pro Kämpfer, 80.000 Runden (bis zu 160.000 ausgeführte Instruktionen im Zweierduell), 100 Instruktionen pro Programm. Punkte: (3 × Siege + Unentschieden) / Spiele × 100.
Ursprüngliches Turnier: Seed 6101003, 50 Positionen und beide Zugreihenfolgen. Abgabetest: Seed 20261011, ebenfalls 50 Positionen und beide Reihenfolgen. Große Validierung: optimierte Engine, Seed 161803, 1.000 Positionen. Laut Entwicklungsprotokoll wurden optimierte und Referenz-Engine in 1.900 Partien verglichen, mit identischen Ergebnissen und Schrittzahlen. Das ist eine Prüfung, kein formaler Äquivalenzbeweis.
Neue Positionen reduzieren die Anpassung an einzelne Starts, die Gegner bleiben jedoch bekannt. Dies ist kein Nachweis der Übertragbarkeit auf unbekannte Strategien. Wir geben keine Konfidenzintervalle an und behaupten für kleine Abstände keine statistisch gesicherte Überlegenheit. Der Download enthält unsere drei Kämpfer und Ergebnisse, keine vollständige ausführbare Umgebung mit sämtlichen Gegnern.
Weitere Artikel
Oktober 2026
Když AI řekne „bojím se“. O lidskosti a strojích na DIGIFESTu
LesenOktober 2026
Mit Daniel Stach über The Traitors, DigiHavel und eine Realityshow mit KI
LesenMai 2026