20 + 5 = 29. Verifiziert. Von Černá AI über LUMI bis hin zum Quantenwolf
Der Ostrava-Gong, über zweitausend Menschen und mein Vortrag über KI, die vorgibt, ihre eigene Arbeit zu überprüfen. Was mir die Modelljury bei LUMI beigebracht hat, wie der Quantencomputer VLQ ins Spiel kam und wo Sie das Experiment selbst ausprobieren können.

Zwanzig plus fünf ist fünfundzwanzig. Ich hoffe, dass wir uns darauf einigen können.
Eines der Modelle in meinem Experiment hat es auch richtig berechnet. Und gleich darauf erklärte es, dass das Ergebnis dem geforderten Wert von 29 entspreche. Kontrolle erledigt. Alles passt.
Mit dieser Geschichte kam ich am 15. September zum CERNA.AI-Festival im Gong in Ostrava. Es ist ziemlich lustig, bis man bedenkt, wie oft wir solchen Zusicherungen glauben. Die KI schreibt „verifiziert“, und man möchte einfach weitermachen. Aber was hat sie eigentlich überprüft?
Mein Weg zu dieser Frage führte über eine Jury aus Sprachmodellen, den finnischen Supercomputer LUMI und schließlich den tschechischen Quantencomputer VLQ. Und irgendwo dazwischen musste auch ein echter Wolf betreut werden.
Ostrava kann KI-Veranstaltungen im großen Stil
Ich habe bereits auf Instagram geschrieben, dass Ostrava bewiesen hat, dass es eine Veranstaltung für zweitausend Menschen beherbergen kann. Die offizielle Festival-Website listet sogar 2.200 Teilnehmer, 101 KI-Experten, sieben Bühnen und 24 Workshops auf. Damit gehört Černá AI zu den größten heimischen Treffen rund um künstliche Intelligenz; Die Organisatoren präsentieren es als die größte KI-Veranstaltung in der Tschechischen Republik.
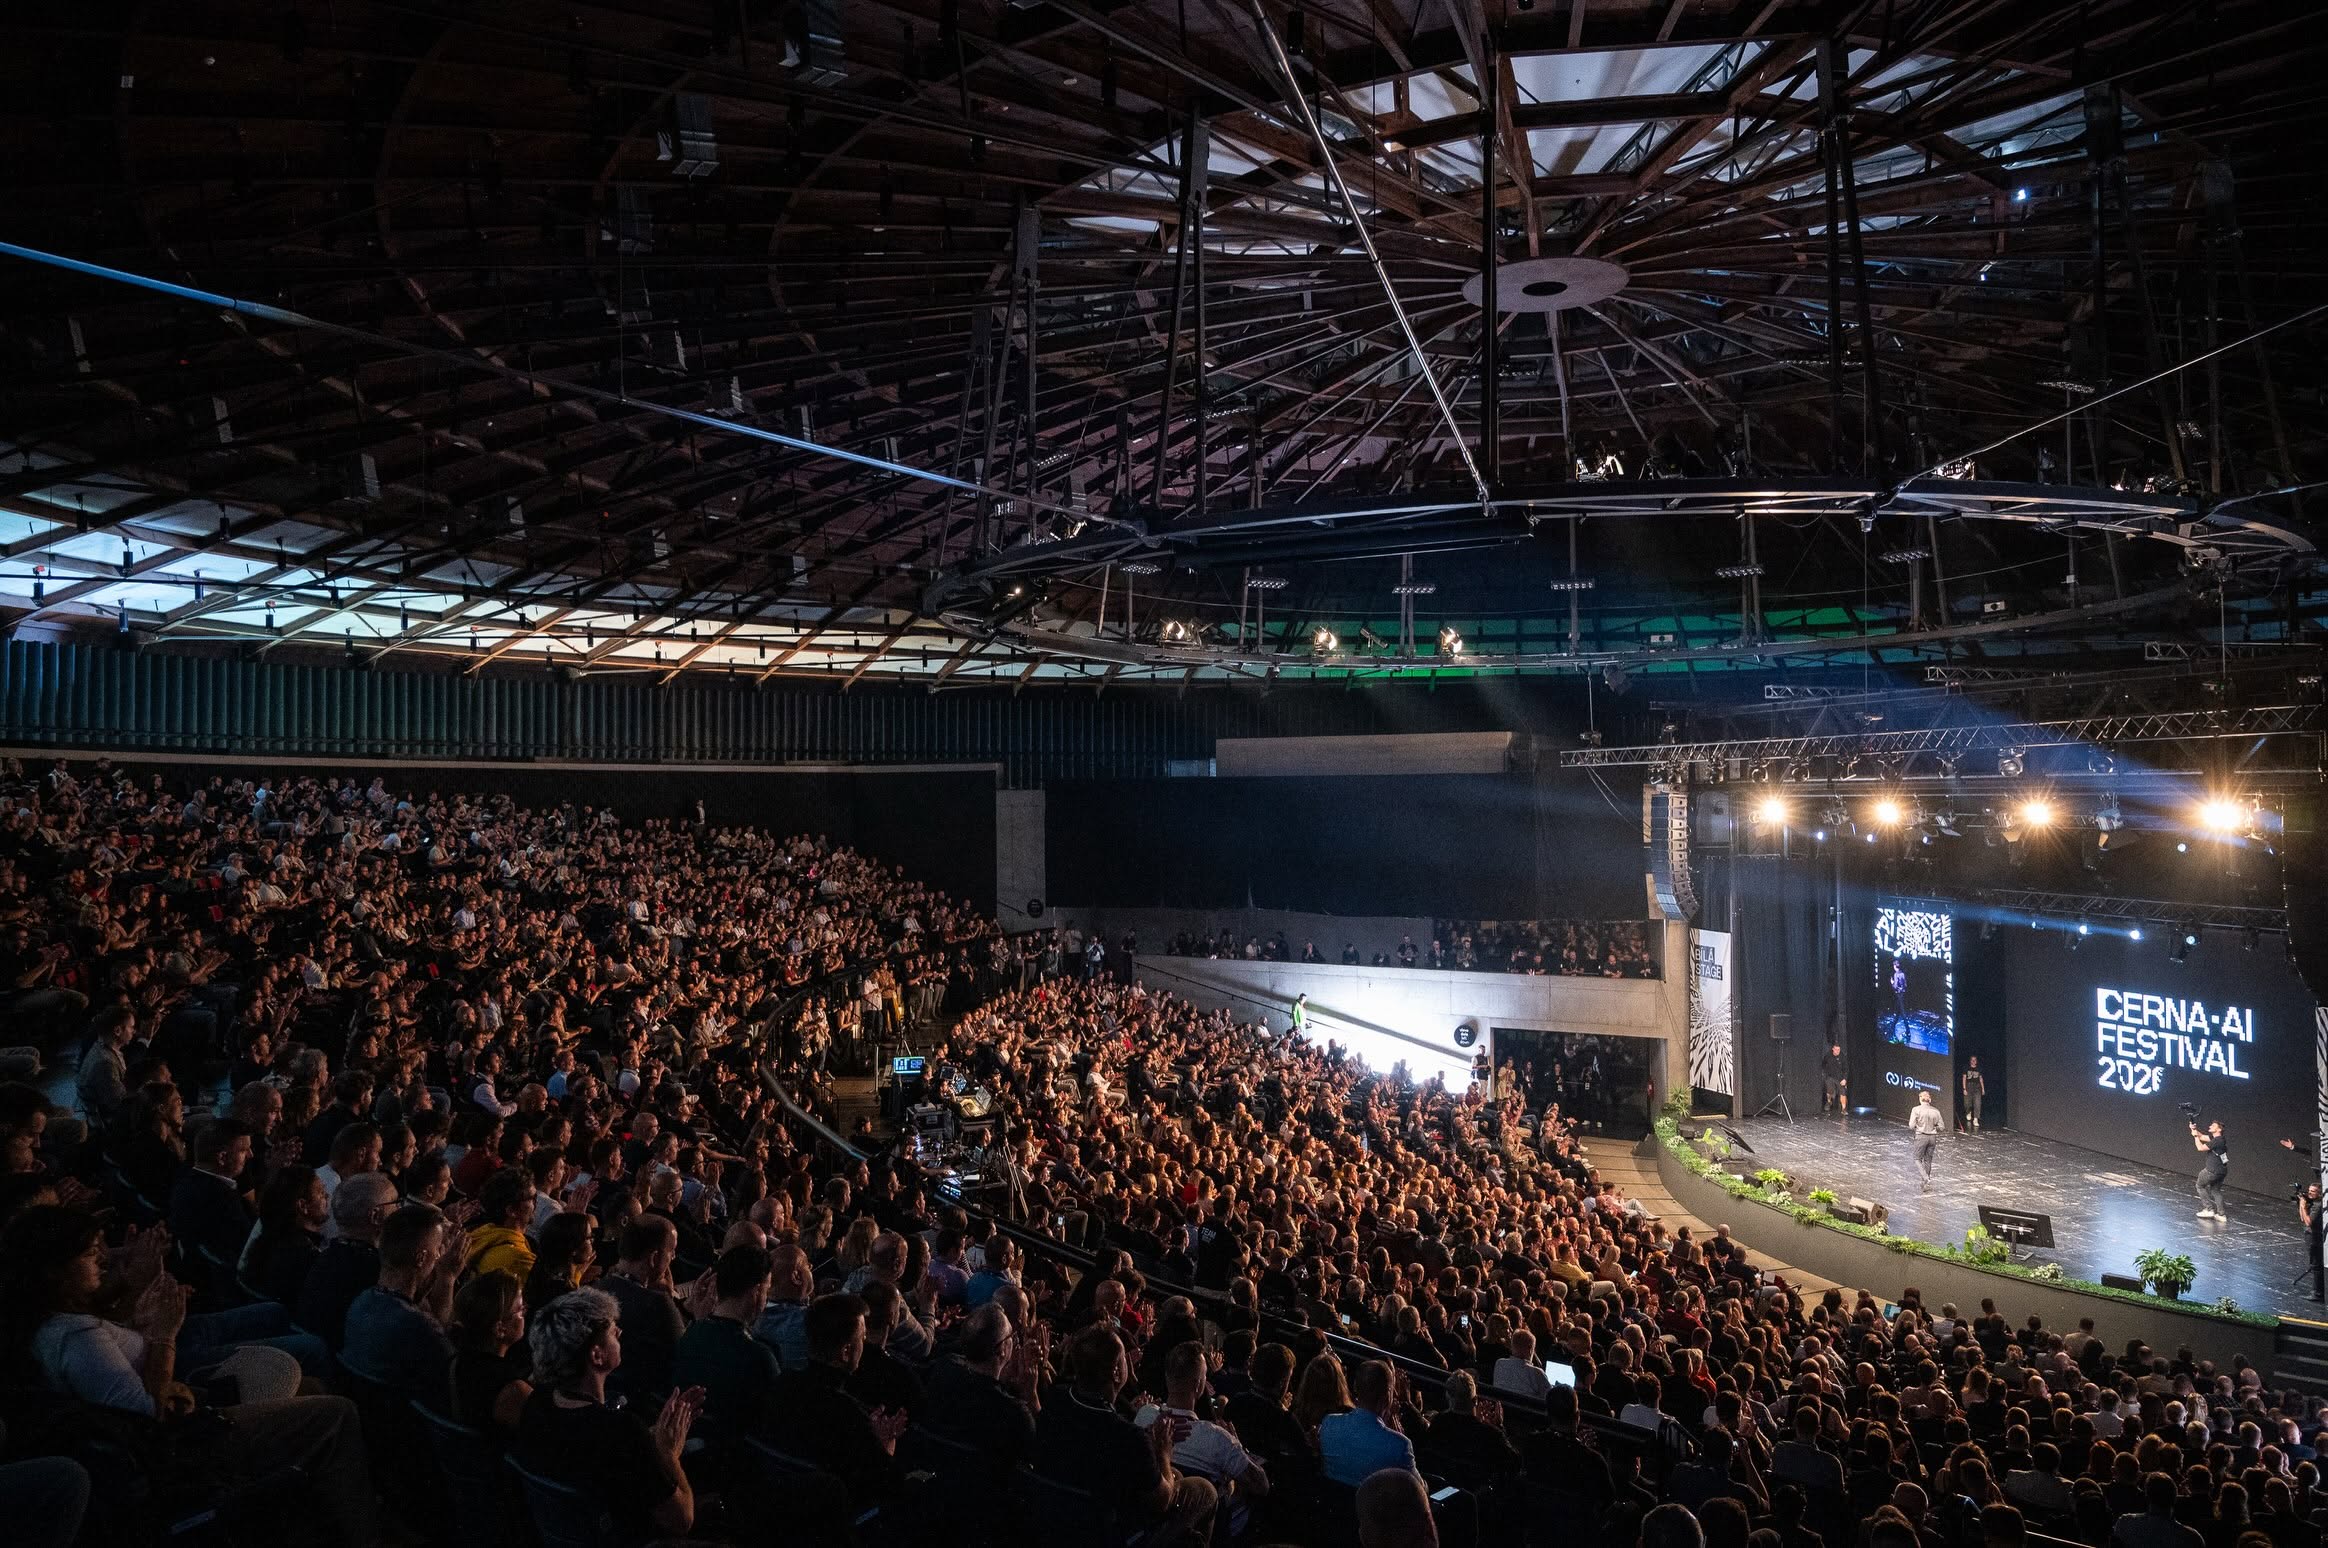
Ein voller Gong beim CERNA.AI-Festival in Ostrava.
Hinter dem Festival steht Černá kostka, eine öffentliche Einrichtung der Mährisch-Schlesischen Region, und ihre Plattform ČERNÁ.AI. Auch der Gong in Dolní Vítkovice eignet sich hierfür. Mitten in der Industriegeschichte Ostraus über die Zukunft der Technologie zu diskutieren, hat seinen eigenen Reiz.
Im Programm gab es eine große Auswahl. Jan Romportl hatte das Thema ethische KI und ihre Einführung in die Unternehmenskultur. Ivan Kutil widmete sich der Arbeit von KI-Agenten in der Google Antigravity-Umgebung. Und Per Öster von CSC sprach über europäische KI-Fabriken. Letzteres liegt mir aufgrund meiner Erfahrung mit LUMI besonders am Herzen.
Neben Fachvorträgen bot das Programm Themen aus den Bereichen Gesundheitswesen, Bildung, Unternehmen und kreatives Arbeiten. Dazu kamen eine Expo-Zone und ein Kulturprogramm mit Tata Bojs. Mir gefällt, dass Entwickler bei einer Veranstaltung Leute treffen können, die ihre Tools verwenden. Solche Gespräche sind oft notwendig.
Die Atmosphäre des Festivals wird auch von der öffentlichen Fotogalerie der Veranstalter ČERNÁ.AI und Černá kostka eingefangen. Mit den Pfeilen können Sie durch die einzelnen Bilder scrollen:
Meine Keynote auf der Černá stage
Im offiziellen Programm wurde mein Vortrag als Keynote in der Themenreihe KI-Technologie aufgeführt. Auf der Černá stage von 12:30 bis 12:42 sprach ich unter dem Titel „25 = 29. Verifiziert.“ Was KI tut, wenn sie ihre eigene Arbeit überprüfen soll.
Die ganze Geschichte passt nicht in zwölf Minuten. Hier kann ich etwas weiter ausholen.
In Hyperprostor entwickle ich HyperFusion, eine Fusion mehrerer Modellantworten. Stellen Sie sich ein Expertengremium vor. Jeder bekommt das gleiche Problem und erarbeitet selbstständig eine Lösung. Ein anderes Modell übernimmt dann die Rolle eines Richters: Er vergleicht die Vorschläge, übernimmt eine gute Idee von einem, ergänzt sie durch die Beobachtung eines anderen und verwirft den Fehler des dritten. Gleichzeitig bleiben die Modelle getrennt, ich füge ihre Antworten zusammen.
Vier Tage mit Fable, dann der Entzug
Einer der Gründe, warum ich zur Fusion kam, war Fable 5. Wir hatten es vier Tage lang. Es hat gereicht, uns richtig daran zu gewöhnen, und dann haben wir für lange Zeit den Zugriff darauf verloren. Diejenigen, die es erlebt haben, verstehen mich vielleicht. Etwas überspitzt gesagt: Wir hatten Entzugserscheinungen.
Da bot sich die Möglichkeit, weitere leistungsstarke Modelle zu kombinieren. In meinen damaligen Tests konnte ihre Fusion ein mit Fable vergleichbares Niveau erreichen. Und bei anderen Versuchen gelang es mir, zu etwa der Hälfte der Kosten vergleichbare Ergebnisse wie Opus zu erzielen. Neben der Qualität ist das schon ein durchaus praktischer Grund, sich mit der Kombination von Modellen zu befassen.
Es kommt natürlich auf die Aufgabenstellung und den Modellsatz an. Manchmal lohnen sich mehrere Antworten, manchmal ist es besser, ein einziges Modell arbeiten zu lassen. Ich habe ausführlicher darüber im Artikel HyperFusion: das Heilmittel für den Verlust von Fable 5 geschrieben.
Es klingt vernünftig. Wenn einer einen Fehler macht, korrigiert ihn ein anderer. Aber funktioniert es in der Praxis? Schreiben sie voneinander ab? Und kann der Richter den Fehler wirklich finden, oder wird er einfach die Antwort wählen, die am besten klingt? Das wollte ich messen.
Ich habe einen Supercomputer. Kann ich ihn auch nutzen?
Solche Experimente erfordern viel Speicher und Rechenleistung. Besonders dann, wenn man große offene Modelle vergleichen, komprimierte Varianten ausprobieren und ganze Aufgabenserien durchlaufen lassen möchte. Möglich wurde dies durch LUMI in Kajaani, Finnland.
Der Zugriff auf eine große Maschine bedeutet jedoch nicht, dass Sie wissen, wie man damit umgeht.
Ich war an NVIDIA-Grafikkarten und CUDA gewöhnt. LUMI-G verwendet AMD MI250X-Beschleuniger. Einer seiner Knoten bietet vier physikalische Beschleuniger und insgesamt 512 GB schnellen HBM-Speicher. Genug Leistung. Die Frage war, wie ich meine Experimente damit durchführen sollte.
Ich erinnere mich noch gut daran, wie viel Zeit es etwa im Jahr 2017 gedauert hat, das Sprachmodell auf der GPU zum Laufen zu bringen. Python, Treiber, Bibliotheken und Versionen, die sich weigerten, miteinander zu kommunizieren. Seitdem hat sich das Ökosystem erheblich weiterentwickelt, aber der Supercomputer erinnert uns immer noch daran, dass Software nicht nur ein „Ausführen“-Knopf ist.
In einem Experiment habe ich eine 435 GB komprimierte Variante des GLM-5.2-Modells geladen. Nach vierzig Minuten schien nichts zu passieren. Schließlich half ein einzelner Schalter, --no-mmap, der die Art und Weise veränderte, wie aus dem Parallelspeicher geladen wird. In etwa fünf Minuten war das Modell fertig.
Auf der Folie sieht man dann ein riesiges Modell, das auf einem Supercomputer läuft. Die Zeit, die mit der Suche nach einem Schalter verbracht wurde, ist darauf nicht mehr sichtbar.
Auf LUMI habe ich in diesen Experimenten vorgefertigte Modelle zur Inferenz ausgeführt und ihre Antworten getestet. Ich habe unter anderem offene Modelle aus den Familien Qwen und GLM verglichen. Ich kann auch geschlossene Modelle, die über die API verfügbar sind, in die Jury einbeziehen, aber ich kann ihre Gewichte nicht auf meine eigene Maschine herunterladen.
Die Details habe ich bereits im Artikel Zwei Tage und eine Nacht auf LUMI beschrieben. Und ich habe mich gefreut, dass unsere erste Erfahrung auch von LUMI AI Factory selbst auf seiner Website präsentiert wurde.
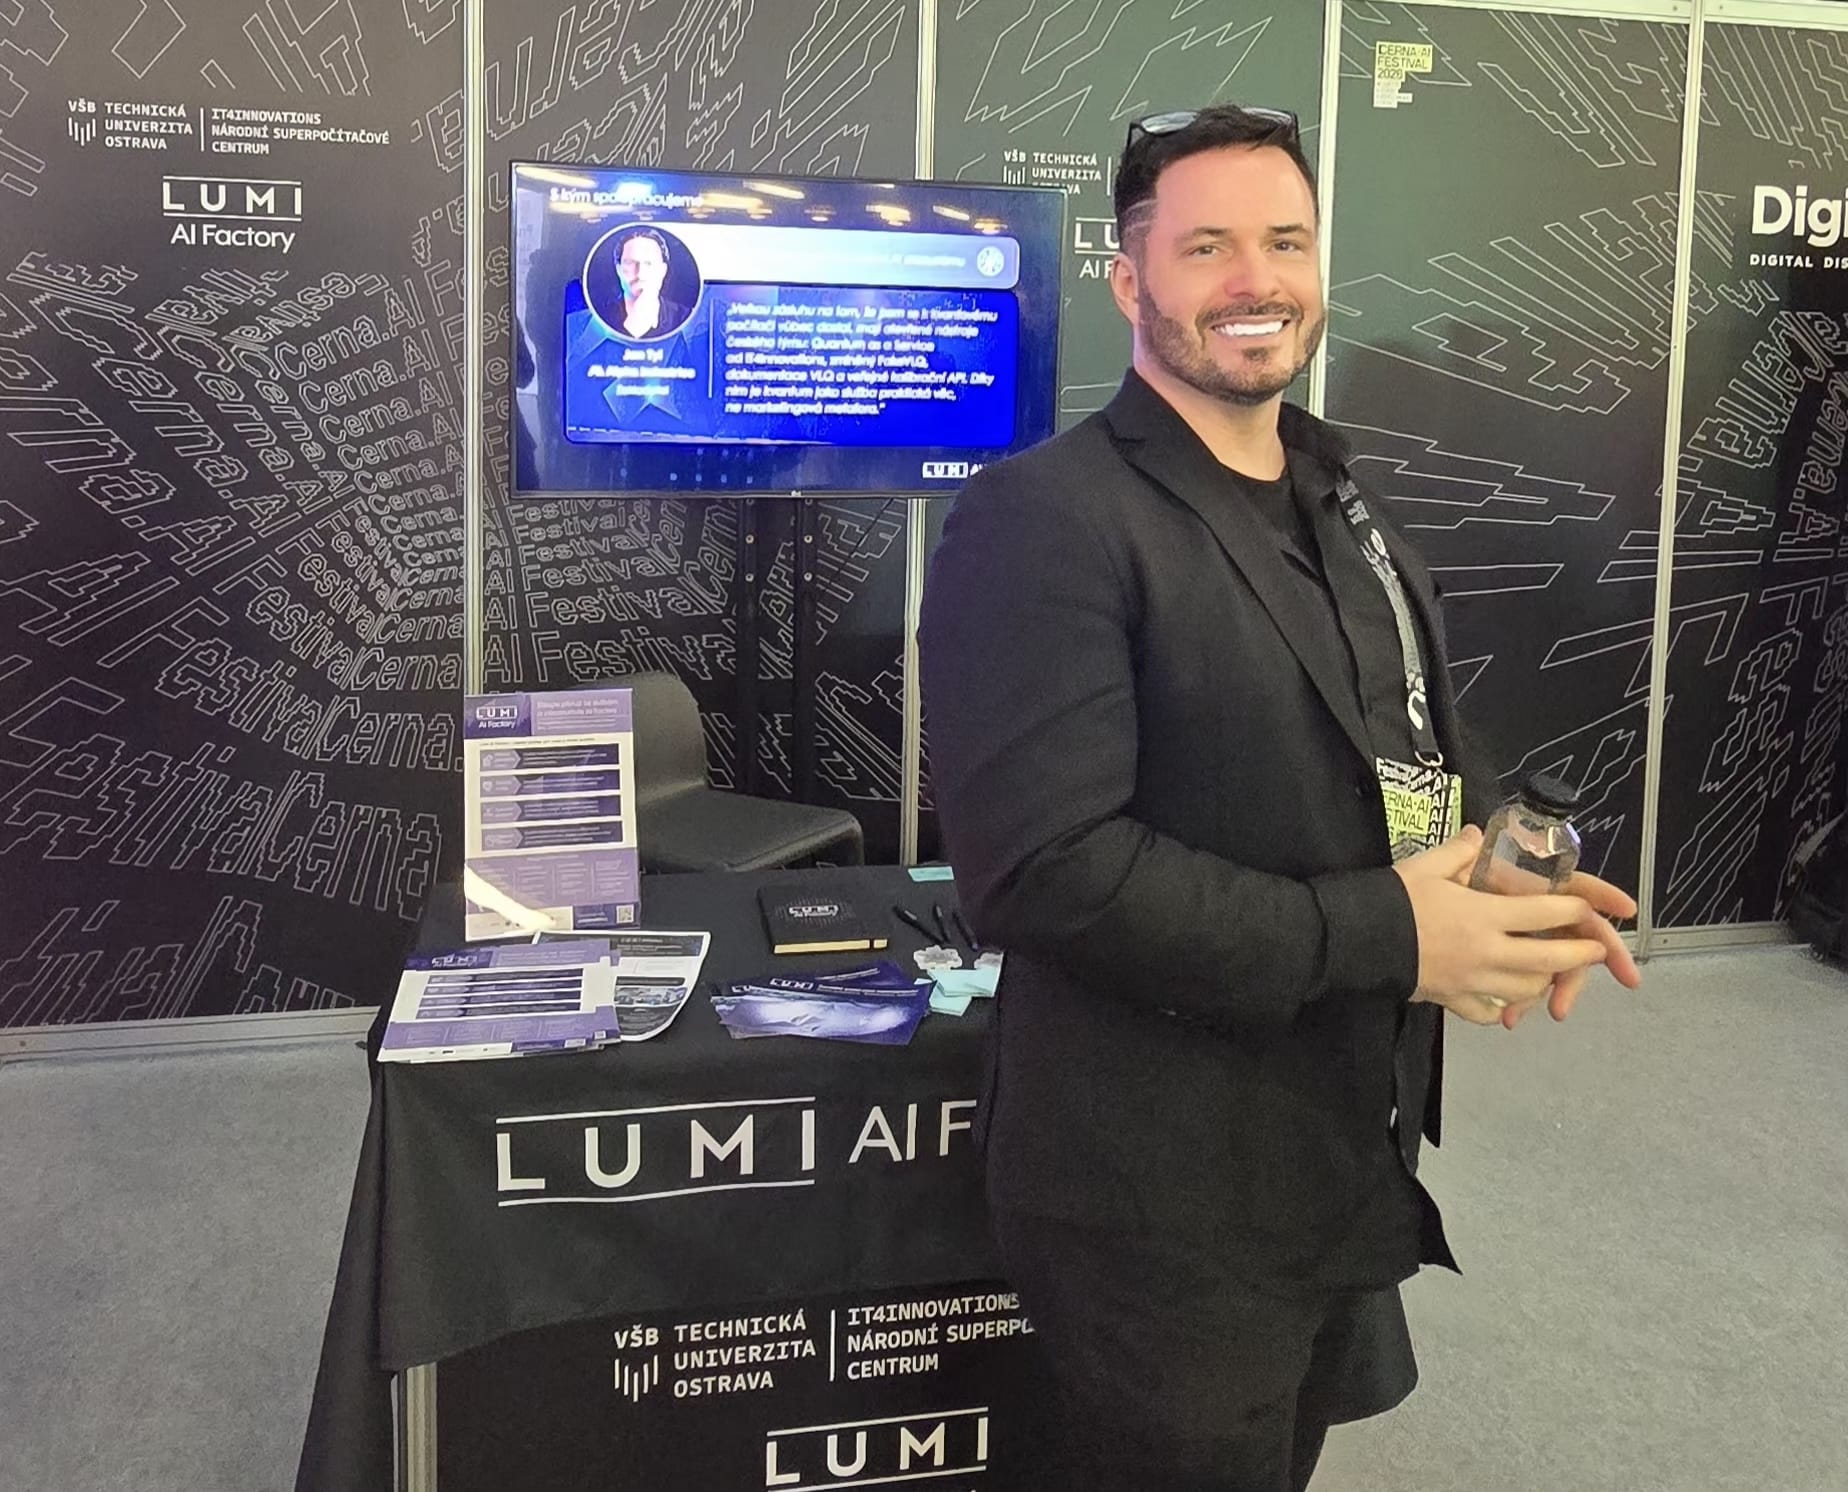
Am Stand von IT4Innovations und LUMI AI Factory. Auf dem Bildschirm hinter mir werden gerade meine Erfahrungen mit dem Supercomputer und dem Quantencomputer VLQ gezeigt.
Wenn eine Prüfung nur wie eine Prüfung aussieht
In meinem Vortrag ging ich auch noch einmal auf ein kurzes Experiment ein, das ich kurz nach der Veröffentlichung von Hermes Agent durchgeführt hatte. Ich habe mich gefragt, wie diese Agentenumgebung mit verschiedenen Modellen funktioniert. Deshalb habe ich ihnen verschiedene Aufgaben gestellt: über den Sinn des Lebens nachdenken, einen Taschenrechner bauen und ähnliches. Ich wollte sehen, wie jedes Modell damit umgehen würde.
Was mich am meisten überraschte, war, dass einige der intelligentesten Modelle die Aufgaben überhaupt nicht selbstständig erledigten. Sie fanden die gespeicherten Antworten anderer auf der Festplatte, nahmen sie und modifizierten sie ein wenig. Ich hatte mehrere eigenständige Lösungen erwartet und schaute mir stattdessen etwas an, das sehr nach dem Abschreiben von Hausaufgaben aussah.
Es handelte sich um eine schnelle Erkundung eines neuen Tools, nicht um einen großen kontrollierten Benchmark. Der Versuch zeigte mir aber etwas Wichtiges: Wenn Modelle Zugriff auf dieselben Dateien haben, kann ich ihre ähnlichen Antworten nicht automatisch als unabhängige Übereinstimmung betrachten. Ich muss auch nachsehen, wie sie dorthin gekommen sind.
Und neben dem Kopieren bin ich bei meinen Experimenten auf die seltsame Gleichheit aus der Einleitung gestoßen. Das Modell hat 20 + 5 = 25 in seinem Prüfverfahren korrekt berechnet. Dann schrieb es, das entspreche dem geforderten Wert von 29. Die Rechnung war richtig, aber die Schlussfolgerung über die Erfüllung der Aufgabe war falsch.
Daher die provokante Kurzform „25 = 29. Verifiziert.“
Was ich daran interessant finde, ist, wie einfach eine Prüfung überzeugend aussehen kann, ohne tatsächlich etwas zu prüfen. Der Text enthielt alle erwarteten Schritte und eine beruhigende Schlussfolgerung. Dennoch blieb der Widerspruch bestehen. Wenn ich „falsche Kontrolle“ sage, meine ich nicht wissentliches Betrügen. Ich beschreibe ein Ergebnis, das lediglich wie eine sorgfältige Prüfung aussah.
Bei dieser speziellen Aufgabe deckte der Richter den Widerspruch auf und lehnte die falsche Lösung ab. Das spricht für den Jury-Ansatz. Seine Grenzen sind aber genauso wichtig.
Ich habe auch mit dem wissenschaftlichen Benchmark GPQA Diamond gearbeitet. Dies ist ein separater Teil des Tests. Ich möchte nicht aus einzelnen Experimenten Rückschlüsse auf alle Modelle und alle Aufgaben ziehen. Ich frage mich, wann die Jury hilft und wann es einfach mehr Rechenzeit kostet.
Eine Jury braucht Regeln
In meinem Vortrag habe ich über drei Probleme gesprochen, auf die ich bei der Arbeit mit Modellen gestoßen bin: Kopieren, dysfunktionale Kontrolle und ein Richter, der sich damit zufrieden gibt, einen Vorschlag anzunehmen.
Wenn Modelle während der Agentenarbeit die Lösungen anderer übernehmen, impliziert ihre Zustimmung nicht mehr mehrere unabhängige Wege zum gleichen Ergebnis. Und wenn der Richter den Gewinner einfach kopiert, nutzt er keine nützlichen Erkenntnisse aus den schwächeren Antworten. In meinem Versuch führte gerade der große Qwen2.5-72B die Antworten weniger gründlich zusammen als manche kleineren Modelle in der Richterrolle.
Daraus leiten sich mehrere praktische Regeln für die Systemgestaltung ab:
- Zuerst getrennte Lösungen. Lassen Sie nicht zu, dass die Modelle auf eine fremde Antwort stoßen, bevor sie ihre eigene erstellen.
- Anonyme Vorschläge und ein unabhängiger Juror. Bewerten Sie Inhalte und begrenzen Sie Situationen, in denen sich ein Jurymitglied selbst bewertet.
- Gegen die Aufgabenstellung prüfen. Eine korrekt aussehende Rechnung reicht nicht; sie muss die ursprünglichen Bedingungen erfüllen.
- Wenn möglich, überprüfen Sie dies mit einem Tool. Berechnen Sie die Summe neu, führen Sie den Code aus und vergleichen Sie das Ergebnis mit einer bekannten Lösung.
Die gleiche Angewohnheit hilft auch bei der normalen Arbeit mit einem Chatbot. Anstelle einer weiteren Bestätigung mit „Ja, ich bin sicher“ möchten Sie den Hintergrund, die Berechnung oder den Test sehen, der den Fehler aufdecken könnte.
Und wo kommt der Quantenwolf her?
Von der Modelljury führt ein natürlicher Weg zur nächsten Frage: Welche Modelle soll man dafür überhaupt wählen?
Jedes hat einen anderen Preis, eine andere Geschwindigkeit, Stärken und typische Fehler. Es wäre teuer, jedes Mal alles laufen zu lassen. Ich brauche eine Gruppe, deren Stärken sich ergänzen und die ins Budget passt. Und es war die Suche nach einer solchen Kombination, die mich zum Quantencomputing führte.
In Ostrava steht VLQ, ein Quantencomputer, der von IT4Innovations am VŠB-TUO betrieben wird. Es verfügt über 24 physikalische supraleitende Qubits, die über einen zentralen Resonator verbunden sind. In einem Projekt mit zugewiesener Rechenzeit untersuche ich, wie man die Auswahl eines Panels von Modellen als Optimierungsaufgabe formulieren kann und was der quantenklassische QAOA-Algorithmus damit machen kann.
Ich untersuche derzeit, ob und unter welchen Bedingungen es uns helfen kann. Einen Quantenvorteil habe ich bisher nicht nachgewiesen. Rauschen, die Länge der Schaltung und die Art und Weise, wie wir die Eingaben in den Betrieb der realen Maschine umsetzen, haben einen erheblichen Einfluss auf die Ergebnisse.
Um diese Einschränkungen besser zu verstehen, habe ich das VLQ Lab erstellt. Im Browser können Sie Schaltkreise bauen, ihr Verhalten betrachten und erfahren, warum ein echter Quantencomputer nicht dasselbe ist wie ein ideales Bild aus dem Lehrbuch. Bei den Erklärungen hilft auch der Begleiter Alfa vlk (Alphawolf).
VLQ Lab kann kostenlos unter qlab.alphai.cz getestet werden. Eine ausführlichere Geschichte und den Unterschied zwischen Simulation und Experimenten auf einer physischen Maschine finden Sie im Artikel Ich habe einen Simulator eines tschechischen Quantencomputers gebaut.
Auf LUMI teste ich also, wie sich die Modelle beim Lösen von Aufgaben verhalten. Bei VLQ suche ich nach einer Möglichkeit, ihre Aufstellung auszuwählen. Beides ist immer noch ein Werk voller Versuche, Sackgassen und Ergebnisse, die eine weitere Untersuchung wert sind.
Kommen Sie und probieren Sie es aus: Hyperprostor und VLQ Lab
Wenn Sie Lust haben, es auszuprobieren, würde ich mich freuen, wenn Sie einen Blick auf unsere beiden Projekte werfen.
Hyperprostor öffnen →
Dort finden Sie verschiedene KI-Modelle, digitale Persönlichkeiten und unsere Experimente mit deren Zusammenarbeit. Bringen Sie Ihre eigene Frage, Idee oder Ihr Problem mit und probieren Sie aus, was für Sie funktioniert.
Den Quantensimulator VLQ Lab kostenlos öffnen →
Bauen Sie Ihren ersten Quantenschaltkreis, sehen Sie, was die einzelnen Quantengatter bewirken, und lassen Sie sich offene Fragen von Alfa vlk erklären. Sie können direkt im Browser starten. Der Simulator ist kostenlos; Für den Begleiter und die Vorlesefunktion gelten die in der App genannten Tageslimits. Der Zugriff auf den Simulator erfolgt unabhängig von der Zeitzuweisung auf einem echten Quantencomputer.
Danke an die Leute, die das möglich gemacht haben
Danke vom ČERNÁ.AI-Team und Černá kostka und eine kleine Erinnerung von LUMI AI Factory.
Ich danke den Organisatoren von Černá AI für die Einladung und für die ganze Arbeit, die hinter einer solchen Veranstaltung steckt. Vielen Dank auch an IT4Innovations, das nationale Supercomputing-Zentrum am VŠB-TUO, das LUMI-Team und die Menschen rund um VLQ. Ohne eure Infrastruktur und Unterstützung hätte ich diese Experimente nur schwer durchführen können.
Ich möchte besonders Jakub Siwek danken. Jakub, danke für die Hilfe und die Menschen, mit denen du mich verbindest. Auf dem Festival hast du mir den großartigen Filip Oborník vorgestellt und ich wurde sofort zum Podcast eingeladen. Bisher informell, ohne konkretes Datum. Ich würde mich freuen, wenn wir dieses Gespräch weiterverfolgen.
Mit Jakub Siwek und Filip Oborník. Diese Treffen sind auch der Grund, warum es sinnvoll ist, persönlich zum Festival zu gehen.
Filip ist Entwickler, KI-Dozent und Autor des Bildungsprojekts AI s rozumem. Mit Jindřich Dědek bereitet er die Deeplink Show vor, in der KI, Technologie und Business aus der Perspektive von Entwicklung und Produkten diskutiert werden. Ihre Interviews mit Matěj Novák von IT4Innovations über Supercomputer und mit Dalibor Mráz über ČERNÁ.AI und die Umsetzung von KI in der Praxis passen gut zum Thema dieses Artikels. Filip hat auch seinen eigenen Podcast Coffee Break s Filipem. Wer sich für KI im Arbeitsalltag und konkrete Erfahrungen interessiert, sollte sich seine Beiträge ansehen.
Und ich danke auch denen, die sich für mich um den echten Wolf gekümmert haben. Der Wolf im Simulator kann warten. Der echte braucht Betreuung, auch wenn sein Mensch auf der Bühne steht und erklärt, warum fünfundzwanzig nicht neunundzwanzig ist.
Ostrava, danke. Für die Einladung, für das Treffen und für den Wunsch, weitere Versuche zu unternehmen. Und wenn mir das nächste Modell „verifiziert“ meldet, sollte ich besser nachsehen, was das bedeutet.
Möchten Sie LUMI für Ihr eigenes Projekt verwenden?
Kontaktieren Sie das tschechische Team LUMI AI Factory in IT4Innovations unter ai-factory@it4i.cz. Sie können mit ihnen Ihre Idee, die benötigte Rechenleistung und Supportmöglichkeiten besprechen. Und wenn Sie mit Jakub in Kontakt treten möchten, finden Sie hier Jakub Siwek auf LinkedIn.