Stvořil jsem 300 trpaslíků s duší Pražanů: rekord 264 081 tok/s a 719,6 lidí/s, vyšší kvalita zpomalí na 45 tisíc
Stvořil jsem 300 unikátních virtuálních Pražanů v přirozené češtině rychlostí 45 192 tok/s (hotovo za 17,34 s). Když jsem pak změnil architekturu volání a honil čistý strop rychlosti a ceny, vytáhl jsem roj na 264 081 tokenů za sekundu, stvořil 719,6 nových Pražanů za sekundu (742,0 dotázaných za sekundu) a stlačil cenu na 0,31 Kč za tisíc lidí.
Představte si, že místo jediného velkého AI poradce máte v dřevěné krabici na stole 300 malinkatých digitálních trpaslíků. Každý má vlastní tužku, vlastní byt v jiné pražské čtvrti, vlastní výplatní pásku a vlastní důvod, proč ráno nadává v tramvaji nebo v koloně na Jižní spojce. Když jsme po nich chtěli opravdu pěknou, přirozenou češtinu a uvažování na úrovni velkých modelů typu GPT, rozeběhli se po stole rychlostí 45 192 tokenů za sekundu a všech 300 dotazníků vyplnili za 17,34 sekundy bez jediné chyby. Když jsme ale vzápětí přestavěli samotnou architekturu volání a honili čistý strop rychlosti a ceny, vytáhli jsme roj až na 264 081 tokenů za sekundu, dokázali stvořit 719,6 nových Pražanů za sekundu (a dotázat jich 742,0 za sekundu) a stlačili cenu až na 0,31 Kč za tisíc lidí.
Obojí se přitom nevylučuje, jen za kvalitu platíte jinou mincí. Čím přirozenější češtinu, hlubší rozvahu a přesnější kontext blízký velkým vlajkovým modelům vyžadujete, tím znatelněji reálný tok tokenů zpomaluje. Veškeré konkrétní názvy modelů i poskytovatelů si necháme v kuchyni, níže najdete přesná čísla, slepé uličky i pět architektonických postupů, které o nich rozhodly.
Přesně tohle jsme si vyzkoušeli při navrhování Pracovních týmů v Hyperprostoru. Chtěli jsme, aby každý dokument, rozpočet nebo prezentaci před odevzdáním přečetlo několik umělých osobností v roli publika a řeklo, kde se ztratily. Ze strachu o účet a rychlost jsme ale v původní specifikaci opatrně omezili publikum na 3 až 5 čtenářů a souběh na 4 kroky.
Pak jsme pod kapotou Hyperprostoru otestovali tichého dříče v úplně stejné cenové hladině jako GPT Luna (deset centů za milion vstupních a padesát centů za milion výstupních tokenů, tedy zhruba 2,30 Kč a 11,50 Kč), který ale v nezávislém srovnání Artificial Analysis Intelligence Index sbírá kolem 36 bodů oproti 27–28 bodům u GPT Luna (a v agentním AutomationBench zhruba 37,8 % proti 20,2 %). Jeho přesné jméno si necháme v kuchyni. Zajímala nás jediná věc: kolik takových trpaslíků rozhraní udrží v jednom okamžiku bez jediné chyby 429 a jestli z nich padají užitečné myšlenky, nebo jen drahý šum?
Krátká filmová představa celého pokusu (zapněte si zvuk): všech 300 trpaslíků před notebookem škrábe tužkou dotazník najednou, až si jeden z nich nahlas uleví: „Na Vinohradech platím majlant za krabici.“
300 okének na jediné obrazovce
Naskriptovaná simulace podle přesných milisekundových logů všech 300 paralelních vláken (P001 až P300) vedle sebe v mřížce 20 × 15 na jediné obrazovce. Přejetím myši rozbalíte živou lupu pod stěnou a kliknutím otevřete kompletní kartu i reakci Pražana.
Aby trpaslíci nepsali prázdné fráze, dostali skutečný čtyřkrokový úkol:
- Vytvoření 300 unikátních Pražanů (
P001ažP300): stratifikovaných tak, aby vysokoškoláků bylo přesně 37 % (111z300), medián věku vyšel na 39 let (18až84let) a čistý příjem od8 000 Kčdo135 000 Kč(medián 42 000 Kč). Od řezníka v Holešovické tržnici, kostymérky z Barrandova, strojvedoucího metra C a nevidomého ladiče klavírů po ukrajinskou zdravotní sestru v Krči, hodináře v důchodu nebo herního vývojáře z Karlína. - 300 trpaslíků najednou vyplnilo Dotazník Pražana 2026 (hotovo za 17 sekund): všech
300osobností vyrazilo v jediném okamžiku (Promise.all). Celé hejno mělo hotovo za 17 sekund (přesně 17,34 s), všech 300 ze 300 vrátilo platný JSON na první pokus bez jediné chyby429, rychlostí přes 45 000 tokenů za sekundu (45 192 tok/s) a za pouhých 9,47 Kč. - 300 čtenářů udělalo zkoušku našeho produktu ve dvou kolech: nejprve každý ze 300 Pražanů samostatně zhodnotil návrh Pracovních týmů v Hyperprostoru s brzdou přemýšlení
effort = "low"(8,91 s, 35 460 tok/s, čistý viditelný text 10 387 tok/s, cena 4,39 Kč). Poté jsme je rozdělili k šedesáti pětičlenným hospodským stolům, kde každý viděl námitky svých čtyř sousedů (7,09 s,33 640 tok/s). - Zátěžový žebřík od 1 do 300 souběžných vláken: každé volání neslo unikátní ID, aby se nedalo podvádět z cache, a každá vlna měřila plynulost odpovědí až na hranu tří stovek souběžných modelů.
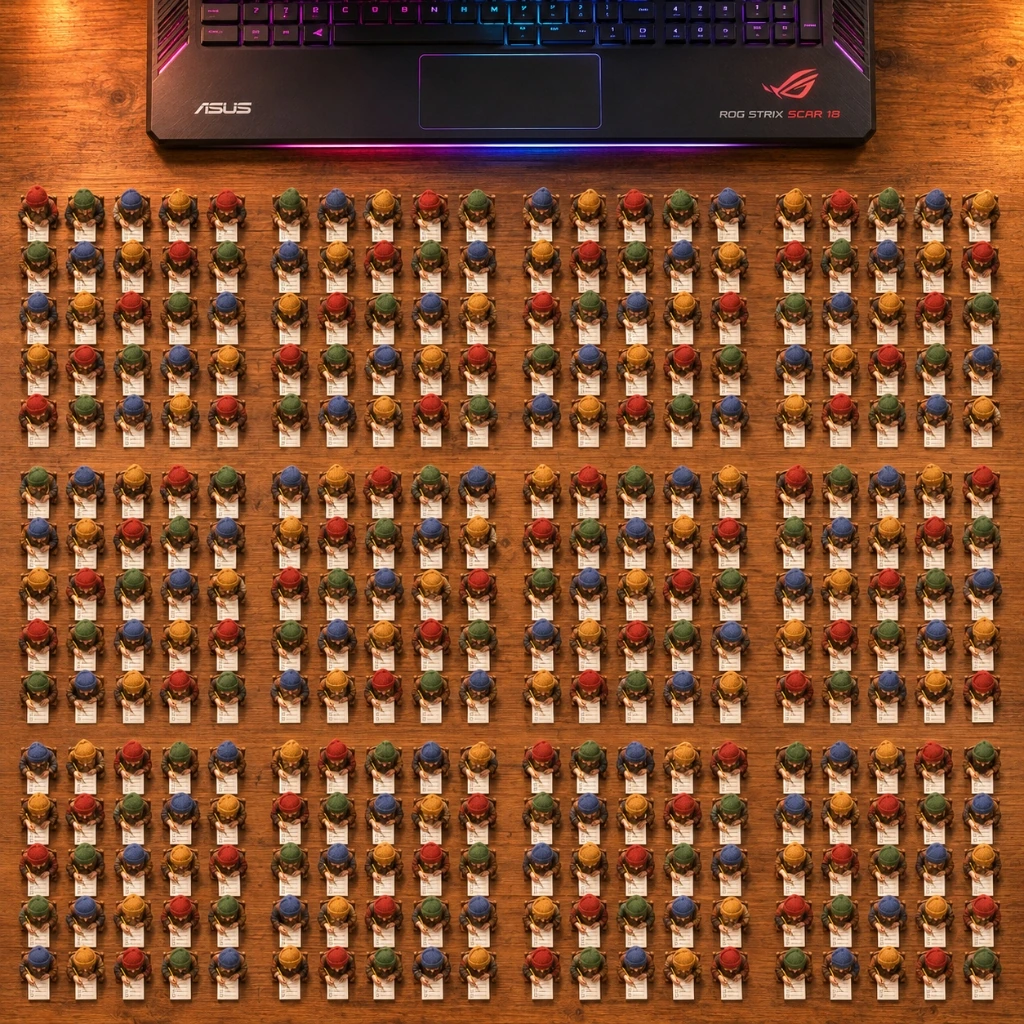
Pohled shora na všech 300 trpaslíků seřazených na stole před notebookem (12 bloků po 5 × 5 písařích = přesně 300 souběžných dotazníků v jediném okamžiku).
Přes 45 000 tokenů za sekundu: 300 Pražanů hotovo za 17 sekund
Když do všech 300 vláken najednou nastoupili živí virtuální Pražané s plnými životopisy a otevřenou otázkou, vyletěl celkový výkon hejna přes 45 000 tokenů za sekundu (45 192 tok/s) a celá třístovka měla hotovo za 17 sekund (17,34 s, 783 544 výstupních tokenů za 9,47 Kč). I v samostatném syntetickém zátěžovém žebříku s krátkým technickým promptem škálovalo rozhraní od jednoho okna až po C = 300 bez jediné chyby 429 tempem 31 876 tok/s (23,94 s, 9,00 Kč).
| Souběh | Úspěch | Čas celé vlny | Medián (p50) | 95. percentil (p95) | Výkon hejna | Viditelný text | Cena vlny |
|---|---|---|---|---|---|---|---|
| 1 okno | 1 / 1 (100 %) | 6,83 s | 6,83 s | 6,83 s | 468 tok/s | 33 tok/s | 0,04 Kč |
| 10 oken | 10 / 10 (100 %) | 8,79 s | 5,57 s | 8,65 s | 2 615 tok/s | 237 tok/s | 0,27 Kč |
| 50 oken | 50 / 50 (100 %) | 16,44 s | 6,58 s | 10,84 s | 7 873 tok/s | 654 tok/s | 1,51 Kč |
| 100 oken | 100 / 100 (100 %) | 19,39 s | 6,86 s | 11,46 s | 13 519 tok/s | 1 111 tok/s | 3,06 Kč |
| 150 oken | 150 / 150 (100 %) | 14,91 s | 7,35 s | 10,69 s | 23 915 tok/s | 2 150 tok/s | 4,17 Kč |
| 200 oken | 200 / 200 (100 %) | 22,18 s | 8,12 s | 12,11 s | 23 031 tok/s | 1 926 tok/s | 5,96 Kč |
| 300 oken (žebřík) | 299 / 300 (99,7 %) | 23,94 s | 9,18 s | 13,96 s | 31 876 tok/s | 2 685 tok/s | 9,00 Kč |
| 300 Pražanů (Dotazník) | 300 / 300 (100 %) | 17,34 s | ~8,5 s | ~13,2 s | 45 192 tok/s | 4 062 tok/s | 9,47 Kč |
300 Pražanů (effort="low") | 300 / 300 (100 %) | 8,91 s | ~5,1 s | ~7,6 s | 35 460 tok/s | 10 387 tok/s | 4,39 Kč |
Pod pokličkou obří rychlosti je ale důležitý inženýrský detail:
- Každý trpaslík si devět desetin času mumlá pro sebe: Ve výchozí vlně 300 Pražanů připadlo z celkových 783 544 tokenů celých 91,0 % (713 109 tokenů) na neviditelné vnitřní úvahy, a jen 4 062 tok/s tvořil samotný výstupní JSON.
- Proč odpadl jediný běžec z žebříku (a proč s rezervou přežilo všech 300 Pražanů): V prvním žebříku
C = 300(limit 8 192 tokenů) se vlákno#096zacyklilo v úvahách na8 190z8 192tokenů a vrátilo prázdný JSON přiHTTP 200. Jakmile jsme rezervu zvedli na10 240tokenů, prošlo 300 z 300 Pražanů čistě napoprvé. - Kouzelná brzda
effort = "low": Když jsme stejných 300 trpaslíků pustili do hodnocení Hyperprostoru sreasoning: { effort: "low" }, podíl úvah spadl na 70,7 %, celá vlna tří stovek agentů skončila za 8,91 s, viditelný výstup vyskočil na 10 387 tokenů za sekundu a cena klesla pod polovinu (4,39 Kč za 300 čtenářů).
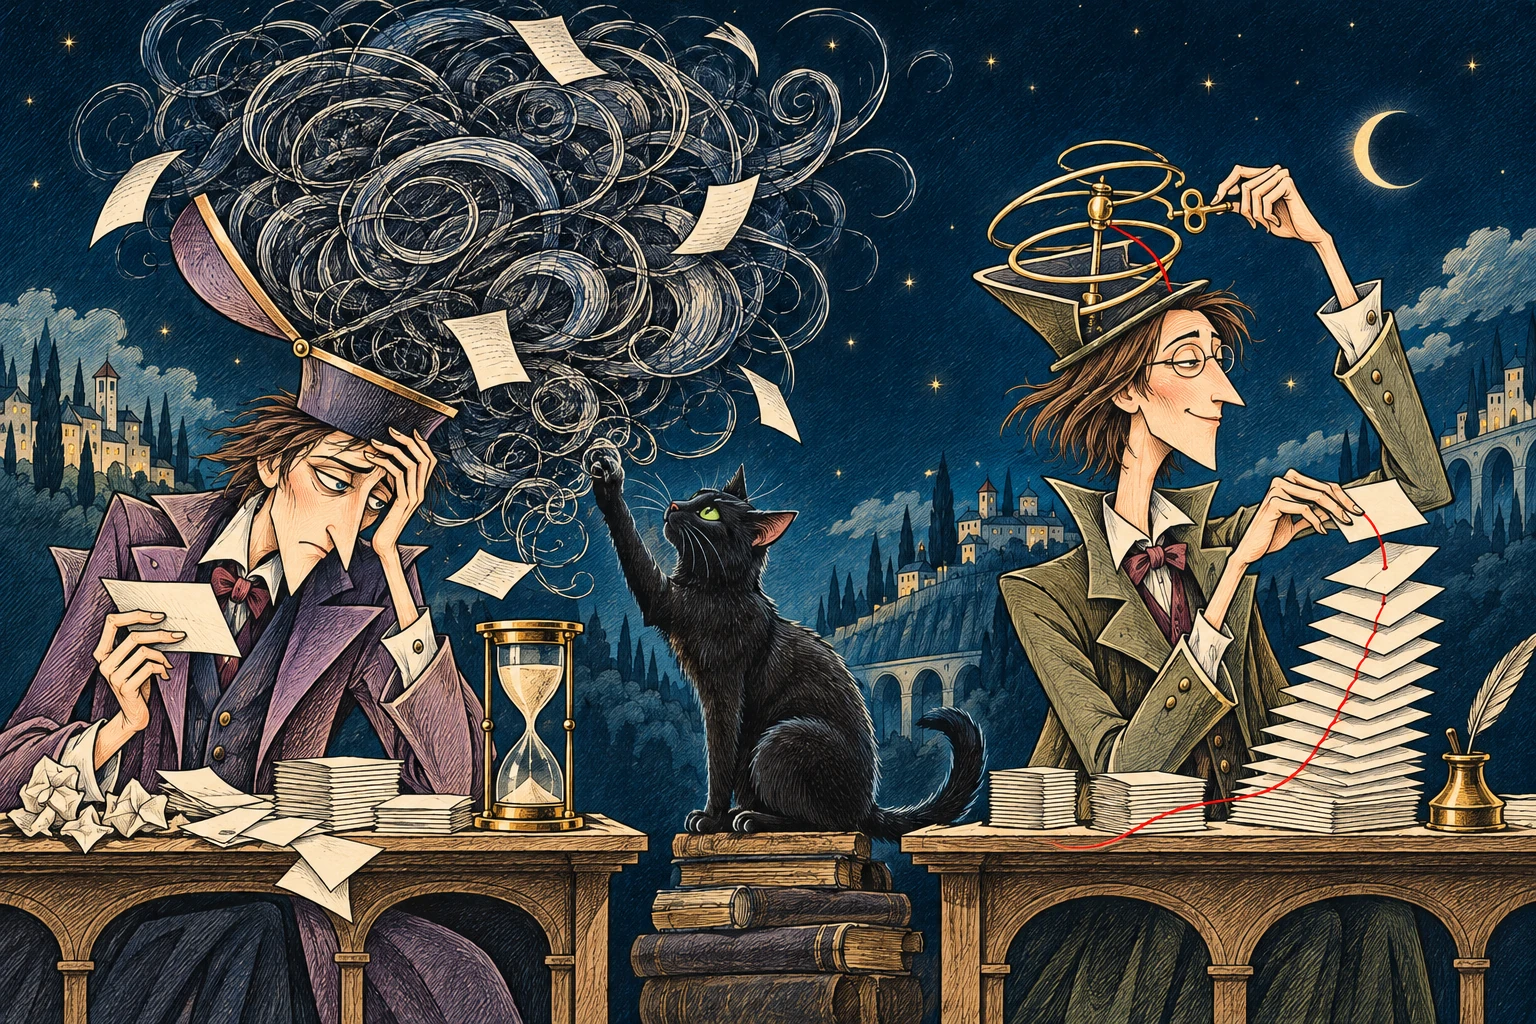
Zkrotit vnitřní mumlání se vyplatí: výchozí režim spálí přes 90 % výkonu na vnitřní smyčky (vlevo), zatímco jednoduchá brzda effort="low" srazí čas na 8,9 sekundy a účet na polovic (vpravo).
Mají odpovědi úsporného roje hlavu a patu?
Rychlost zadarmo by nám byla k ničemu, kdyby z tří stovek oken padaly nesmysly. Když jsme ale seřadili všech 300 Pražanů podle toho, jak cestují po městě, a zeptali se na návrh mýtného 100 Kč denně za vjezd autem do širšího centra výměnou za posílenou MHD, výsledek držel nečekaně ostrou ekonomickou logiku:
| Doprava respondenta | Počet Pražanů | Pro mýtné | Proti mýtnému | Nejistý |
|---|---|---|---|---|
| Jezdí jen MHD | 143 | 133 | 4 | 6 |
| Kombinace / pěšky / kolo | 80 | 68 | 11 | 1 |
| Jezdí jen autem | 77 | 0 | 77 | 0 |
| Celkem vzorek | 300 | 201 | 92 | 7 |
Všech sedmdesát sedm výlučných řidičů hlasovalo 0 : 77 proti, zatímco cestující v MHD hlasovali 133 : 4 pro (a těch několik nejistých dodalo naprosto racionální pochybnost, že magistrátu nevěří nasměrování vybraných peněz zpět do spojů).
Ještě cennější byla zkouška našeho vlastního návrhu Pracovních týmů v Hyperprostoru napříč všemi 300 profily (celková známka 3,34 → 3,47, ochota vyzkoušet za jednorázových 50 Kč 59,0 % → 47,3 %):
- IT a management (
n = 29): známka 2,83 → 2,83, ochota vyzkoušet za 50 Kč 96,6 % → 96,6 %. - OSVČ a malé firmy (
n = 61): známka 3,03 → 3,21, ochota vyzkoušet za 50 Kč 86,9 % → 68,9 %. - Učitelé a lektoři (
n = 21): známka 3,05 → 3,24, ochota vyzkoušet za 50 Kč 85,7 % → 76,2 %. - Studenti (
n = 18): známka 3,11 → 3,33, ochota vyzkoušet za 50 Kč 77,8 % → 61,1 %. - Veřejná správa, zdravotnictví a kultura (
n = 50): známka 3,22 → 3,44, ochota vyzkoušet za 50 Kč 64 % → 46 %. - Dělnické a provozní profese (
n = 99): známka 3,67 → 3,77, ochota vyzkoušet za 50 Kč 31,3 % → 21,2 %. - Senioři (
n = 22): známka 4,09 → 4,09, ochota vyzkoušet za 50 Kč 4,5 % → 4,5 %.
Podívejte se na osm konkrétních hlasů z celých tří stovek:
- Ondřej Marek (
P013, 28 let, IT vývojář, Vršovice, 68 000 Kč): „Při 80 % limitu to přece jen přestane opravovat, takže riskuju nedodělek, který pak budu muset stejně celý přepisovat. A u pracovních podkladů bych řešil i důvěru a soukromí - co s tím systémem udělá, kdo za chyby zodpovídá.“ (Známka 2 → 2, 50 Kč: ANO; nejasné: Role jako Sazeč a Grafik mi přijdou zbytečně přestřelené a 'kontrolor z jiné rodiny modelů' zní hlavně jako marketing. A není mi jasné, co se stane, když 50 Kč na pořádný dokument prostě nestačí - to mi přijde jako hlavní háček.) - Hana Kučerová (
P021, 36 let, učitelka ZŠ, Prosek, 45 000 Kč): „I kdyby to stálo 50 Kč, stejně to budu muset celá zkontrolovat, jestli je to správně česky a podle toho, co učíme, a na to po večeru s dětmi nemám čas ani nervy. A u dětí si chybu dovolit nemůžu.“ (Známka 3 → 3, 50 Kč: ANO; nejasné: Ztrácím se v těch názvech rolí - Vedoucí, Výzkumník, Sazeč, Kontrolor z jiné rodiny modelů, zkouška před publikem. Pro mě je to moc složitých slov na to, že chci jen jednoduchý dokument bez papírování.) - Bohuslav Křepela (
P255, 58 let, nevidomý ladič klavírů, Vinohrady, 36 000 Kč): „Jak mám poznat, že je hotové PDF nebo prezentace správně, když ji nevidím? A že tam nejsou vymyšlené ceny nebo chyby u ladění, to mi žádný kontrolor z jiné rodiny modelů sám o sobě nezaručí.“ (Známka 3 → 3, 50 Kč: ANO; nejasné: Ztratil jsem se v nástěnce, živém průběhu, grafikovi a sazeči. Jako nevidomý potřebuju věci hlavně slyšet a ovládat klávesnicí nebo hlasem, ne si klikat po obrázcích a sledovat, jak to vypadá.) - Ctirad Malina (
P101, 52 let, řezník v Holešovické tržnici, Holešovice, 48 000 Kč): „Kdo mi zaručí, že si to nevymyslí čísla o nákladech na rekonstrukci a na energie? Stejně to budu muset přepočítat sám a ještě nevím, kam jdou moje data, úřadům bych to jen tak nesvěřil.“ (Známka 3 → 3, 50 Kč: ANO; nejasné: Ty role - Vedoucí, Výzkumník, Sazeč, Kontrolor z jiné rodiny modelů a zkouška před publikem - to je pro mě španělská vesnice. Já potřebuju vědět jen kolik to stojí, jak dlouho to trvá a jestli to sedí.) - Radim Závodný (
P122, 34 let, hasič z Holešovic, Holešovice, 52 000 Kč): „Hlavní problém je důvěra. AI si klidně vymyslí blbost a já to stejně budu muset po 24hodinové službě kontrolovat, jinak si koledu na průšvih. A na počítači u toho sedět fakt nechci, radši si to napíšu sám.“ (Známka 3 → 3, 50 Kč: ANO; nejasné: Sazeč, Kontrolor z jiné rodiny modelů, zkouška před publikem – to jsou pro mě kecy z marketingu. Nerozumím, proč potřebuju šest různých AI, když chci jen napsat jeden papír.) - Oksana Melnyk (
P227, 39 let, zdravotní sestra v Thomayerově nemocnici, Krč, 48 000 Kč): „Bojím se, že to napíše špatně česky nebo vymyslí nesmysl a úřad to neuzná, a já tomu pak musím věřit, i když tomu nerozumím. V nemocnici bych na to nikdy nesvěřila žádný papír o pacientech.“ (Známka 3 → 3, 50 Kč: ANO; nejasné: Ty role Vedoucí, Sazeč, Kontrolor z jiné rodiny modelů a zkouška před publikem – to mi nic neříká, zní to jako pro ajťáky a je to pro mě zbytečně složité.) - Klára Sedláčková (
P036, 34 let, majitelka malého e-shopu, Vysočany, 85 000 Kč): „Nejvíc se bojím, že to vymyslí nesmysly o cenách, DPH, dopravcích nebo lhůtách u e-shopu a já to pak doma stejně budu muset celou noc překontrolovávat, než to pošlu klientovi. Ušetří mi to čas, jen když to bude sedět na české reálie, ne jen obecně hezky znít.“ (Známka 2 → 2, 50 Kč: ANO; nejasné: Kontrolor z jiné rodiny modelů a ta zkouška před publikem - to mi zní jako hodně odborný marketingový obal, nevím, co si pod tím reálně představit.) - Oldřich Pospíšil (
P171, 81 let, hodinář v důchodu, Košíře, 21 000 Kč): „Hlavní pochybnost je, že bych na to musel mít počítač a číst to na malých písmenkách, a na oči už moc nevidím. A 50 korun vyhodit za papír, který nevím, kdo ho psal a jestli je v něm pravda, to mi nedává smysl, to mi dcera napíše dopis na papír.“ (Známka 5 → 5, 50 Kč: NE; nejasné: Ztratil jsem se hned u těch rolí - Vedoucí, Výzkumník, Sazeč, Kontrolor z jiné rodiny modelů. PowerPoint, Excel, nástěnka, zkouška před publikem - to jsou pro mě cizí slova, já pracuju rukama u stolu, ne v aplikaci.)
Za necelých devět sekund a čtyři koruny čtyřicet haléřů nám 300 digitálních trpaslíků rozbilo pět slepých míst zadání ještě dřív, než jsme sáhli na kód:
- 80% brzda rozpočtu působí jako hrozba nedodělku (IT vývojáři i řemeslníci čekají, že zaplatí za polotovar, který budou půl dne opravovat).
- Názvy Sazeč a Kontrolor z jiné rodiny modelů matou přes 85 % respondentů napříč vzděláním.
- Nástěnka šesti osobností odrazuje unavené uživatele po směně, kteří chtějí jediný výsledek bez řízení minitýmu.
- Asymetrie odpovědnosti: průšvih před zákazníkem, šéfem nebo úřadem vždy odnese člověk svým podpisem.
- Nevidomý ladič klavírů (
P255) okamžitě vytáhl slepou skvrnu přístupnosti: kdo si PDF nebo prezentaci nemůže prohlédnout očima, nedokáže posoudit vizuální „nástěnku“ ani výsledek bez hlasového a textového náhledu.
Kde trpaslíci klamou: forenzní audit silnějším okem
Kdybychom skončili nadšením z hezkých citací, podvedli bychom sami sebe. Prošli jsme proto všech 300 profilů i odpovědí skriptem a analytickým pohledem, abychom oddělili silné stránky levného roje od jeho umělých švů:
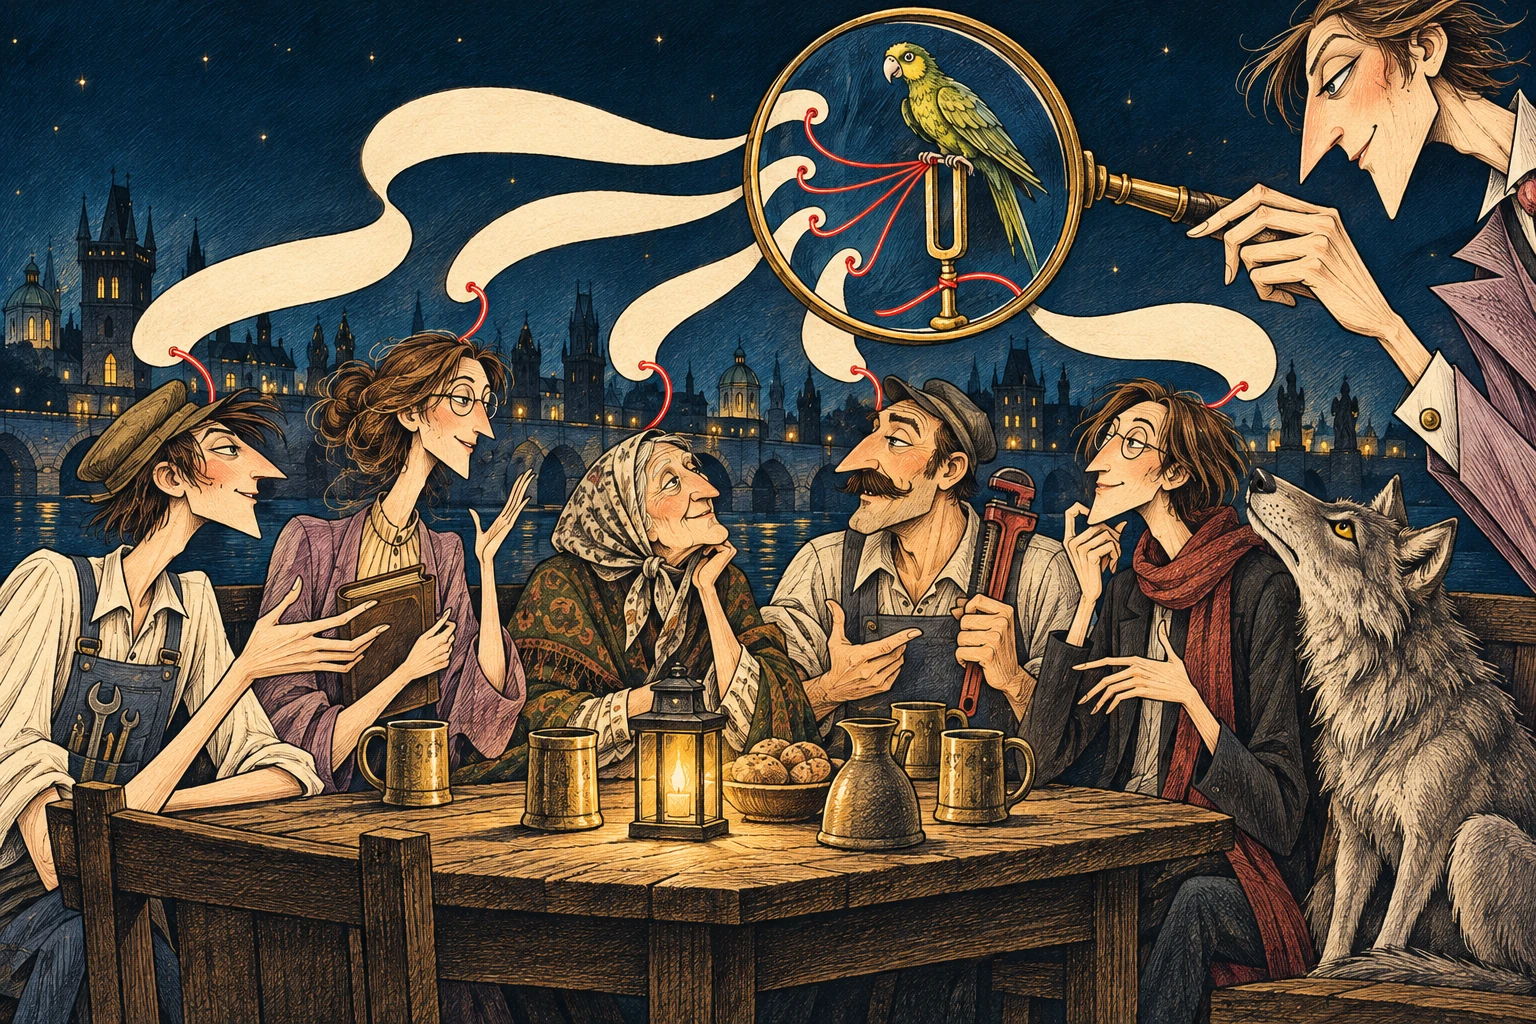
Pod lupou jsou rozdílné postavy navenek velmi živé, ale začátek každé věty nese otisk zadání (stejný háček pod lupou).
Našli jsme pět přesných umělých švů napříč celými třemi stovkami:
- Šablonový start věty u 286 ze 300 trpaslíků: 178 odpovědí začínalo přesně „Nejvíc mě štve…“, 95 „Nejvíc mě pálí…“ a 13 „Nejvíc mě sere…“ (jen 14 jinak). Model mechanicky převzal slovo přímo z názvu JSON klíče
coMeVPrazeNejvetsiStve. - Nákaza tématem z předchozí položky (priming): Celých 90 ze 300 respondentů si v otevřené stížnosti spontánně postesklo na Airbnb, včetně seniorů z okrajových sídlišť, protože o tři řádky výš hodnotili
regulaceAirbnbAVystavba. - Kotva nuly vs. padesátikoruna: Po nápovědě „klidně 0“ uvedlo 264 ze 300 Pražanů měsíční rozpočet na AI 0 Kč, ale za jednorázový hotový dokument by jich o pět minut později zaplatilo 50 Kč hned 177 ze 300 (59 %). A napříč všemi 300 profily zvolili jen 2 lidé odpověď „nikdy“ u dnešního používání AI (z 22 seniorů nad 65 let jen jediný!).
- Jednosměrný posun v debatě u 60 stolů: Po vyslechnutí čtyř sousedů 260 Pražanů známku nezměnilo, 40 ji zhoršilo a 0 zlepšilo, protože zadání debaty jim předalo výhradně námitky spolustolovníků, nikoli nápady.
- Pěkná čeština se drobně prozrazuje: Zachytili jsme 34 případů nepražské předložky („v Karlíně“, „v Žižkově“, „v Pankráci“, „v Modřanech“) a i cizinci dlouhodobě žijící v Praze psali stejně hladkou hovorovou dikcí jako rodilí Češi.
Honba za stropem: 264 081 tok/s, 719,6 stvořených Pražanů za sekundu a tisíc lidí za 31 haléřů
Po první vlně s třísetčlenným pražským publikem jsem si položil opačnou otázku. Co kdybychom nechali stranou složitou literární češtinu a zjistili, kde vlastně leží fyzický strop rychlosti a spodní hranice ceny? Výsledek překvapil hned dvakrát: samotné přepnutí na jiný engine nebo velký JSON zdaleka nestačí, a navíc platí tvrdý zákon zachování kvality.
Když jsme po vysoce paralelní rychlé architektuře chtěli stejně pečlivou češtinu a uvažování (medium úroveň přemýšlení pro 100 Pražanů najednou), výsledný čas sice spadl na 1,74 sekundy (57,5 Pražanů/s), jenže celkový průtok zůstal na 43 739 tok/s, tedy ještě o chlup níž než náš původní kvalitní český běh (45 192 tok/s). Proč? Hned 71,3 % tokenů spolykalo tiché vnitřní přemýšlení (viditelného textu padalo jen 12 534 tok/s) a z každé vteřiny ukrojilo v průměru 439 ms studené navázání HTTPS/TLS spojení oproti 516 ms samotného výpočtu (66 795 tok/s čistého výpočetního výkonu).
Jakmile jsme naopak u češtiny stáhli přemýšlení na minimum (low, 100×1), čas klesl na 1,00 sekundu (25 072 tok/s, z toho 21 561 tok/s viditelných), ale kvalita češtiny i logika se začaly drolit. Většina v anketě o MHD se obrátila naruby (17:33 oproti 47:1 v režimu medium) a trpaslíci začali skloňovat jako rozbitý automat („po dlouhém směnu“, „peníze jsou těsně“). Přirozená čeština a nuance srovnatelné s velkými modely typu GPT si zkrátka berou daň v úvahových tokenech a pomalejší odezvě.
Pět architektonických pravidel, která odemkla rekordy
Abychom se ze zdi 45 tisíc tok/s dostali šestkrát výš, nestačilo tlačit na sílu. Rozhodla kombinace pěti konkrétních úprav způsobu volání:
- Předehřátá spojení (
HTTP Keep-Alive) místo studeného startu: Krátká dávka vypočítaná za půl sekundy ztratí téměř dvojnásobek času při vyjednávání nového TLS tunelu. Teprve když jsme před ostrým měřením otevřeli a zahřáli TCP/TLS spojení předem, začala každá stovka oken padat pod jednu sekundu (0,80až1,36 s). - Dávka 10 profilů v jednom okně (
100×10) místo extrémů300×1a1×100: Pokus nacpat všech 100 Pražanů do jediného obřího JSONu selhal. Jedno vlákno jede jen jednovláknovou rychlostí (1 749 až 2 288 tok/s): kompaktní stovka trvala3,66 s, plný JSON napoprvé selhal u 28 položek (4,74 sa rozpad logiky0:49) a dlouhý stres-test (64 026znaků /24 360tokenů za11,84 s) přinesl klasickou únavu kontextu, kdy délka odpovědí klesla ze399na213znaků (poměr0,53) a trpaslík sklouzl do neosobního vyprávění ve 3. osobě. Zlatým středem bylo zabalit 10 osobností do jednoho kompaktního JSON dotazu (český mezikrok25×4dal100/100za0,93 s, tedy 108,0 Pražanů/s za0,53 Kč). - Pracovní angličtina uvnitř, kvalitní čeština až na výstupu: Jakmile jsme stejný úkol s nízkým uvažováním (
low) přepsali pro surovou dávkovou práci do kompaktní angličtiny, úvahové tokeny spadly na zlomek (1,9 % až 14 %, přes 86–98 % výkonu tvořil rovnou viditelný výstup) a současně zůstala pevná logika (99,5–100 %ich-forma, MHD450:46, mýto pro auta0:248). Pro hromadný běh trpaslíků tak dává smysl generovat strukturu a postoje rychle a levně v angličtině a do pěkné češtiny převádět až finální souhrn. - Hromadné šardování jmen při tvorbě z nuly (
719,6nových Pražanů/s): Když stovka předehřátých proudů po deseti (100×10) tvořila zcela nové obyvatele Prahy od nuly, vytvořila 980 platných profilů z 1 000 za 1,36 sekundy, tedy 719,6 nově stvořených Pražanů za sekundu (0,96 Kčcelkem, tj. 0,98 Kč za 1 000 osob). Stejná konfigurace nad existujícím dotazníkem odbavila 991 z 1 000 Pražanů za 1,34 s, což dělá rekordních 742,0 dotázaných Pražanů za sekundu bez jediné chyby429(2,07 Kč, tj.2,09 Kč / 1 000), a dvojitá dávka200×10zvládla 1 974 z 2 000 Pražanů za 2,77 s (712,4/s). Naučili jsme se přitom důležitý detail: bez přidělení oddělených jmenných seznamů každému vláknu čerpají nezávislí trpaslíci ze stejného stereotypního koše, takže z980nových postav vzniklo jen 336 unikátních jmen. - Rozprostření přes více nezávislých klastrů (
264 081 tok/s) vs. hon za haléři (0,31 Kč / 1 000): Jeden rychlý účet narazil při150dlouhých proudech na vlastní špičku 128 976 tok/s (5,18 s, průměr61 707 tok/s), větší pool s220proudy vytáhl špičku na 171 306 tok/s (7,20 s, průměr66 909 tok/s), a teprve spojení 550 předehřátých proudů napříč čtyřmi nezávislými výpočetními klastry vystřelilo 250ms špičku na 264 081 tokenů za sekundu (257 001 tok/s čistého viditelného textu, 1 195 658 výstupních tokenů celkem,98,1 %viditelný text,0chyb429, 71 077 tok/s v rychlých 95 % dotazů a59 011 tok/sza plných20,26 sdo dojezdu nejpomalejšího klastru). Na opačném pólu leží režim minimální ceny: s nejlevnější výpočetní cestou (30×10) jsme dostali 259 platných dotazníků za10,18 sza pouhých 0,08 Kč, tedy rekordních 0,31 Kč za 1 000 Pražanů (0,031 Kčza stovku lidí) při100 %udržení první osoby.
| Režim experimentu | Čas | Průtok tokenů | Výkon (Pražanů/s) | Cena za 1 000 osob | Chování a kvalita |
|---|---|---|---|---|---|
Kvalitní český roj (300×1, původní běh) | 17,34 s | 45 192 tok/s | 17,3/s (300 osob) | 31,57 Kč (9,47 Kč / 300) | Přirozená pražská čeština, kvalita nad GPT Luna |
Rychlá arch. CZ + medium (100×1) | 1,74 s | 43 739 tok/s (12 534 vidit.) | 57,5/s (100 osob) | 18,80 Kč (1,88 Kč / 100) | Logika 47:1 drží, ale 71,3 % spolkne přemýšlení |
Rychlá arch. CZ + low (100×1) | 1,00 s | 25 072 tok/s (21 561 vidit.) | 99,9/s (100 osob) | 10,00 Kč (1,00 Kč / 100) | Rychlé, ale lámou se koncovky i logika (17:33) |
Český kompromis dávkou (25×4, low) | 0,93 s | 22 863 tok/s (11 465 vidit.) | 108,0/s (100 osob) | 5,30 Kč (0,53 Kč / 100) | Krátké úderné odpovědi, bez pádu do chyb |
Stvoření od nuly EN (100×10, Keep-Alive) | 1,36 s | 33 457 tok/s (63 233 špička) | 719,6/s (980 z 1 000) | 0,98 Kč (0,96 Kč / 980) | 336 unikátních jmen bez šardování |
Dotazníkový rekord EN (100×10, Keep-Alive) | 1,34 s | 62 456 tok/s (94 499 špička) | 742,0/s (991 z 1 000) | 2,09 Kč (2,07 Kč / 991) | 99,5 % ich-forma, MHD 450:46, mýto 0:248 |
Dvojitý dotazník EN (200×10, Keep-Alive) | 2,77 s | 60 203 tok/s (139 028 špička) | 712,4/s (1 974 z 2 000) | 2,10 Kč (4,14 Kč / 1 974) | 99,7 % ich-forma, 0 chyb 429 |
Nejnižší cena EN (30×10, Keep-Alive) | 10,18 s | 2 521 tok/s (3 178 špička) | 25,4/s (259 z 300) | 0,31 Kč (0,08 Kč / 259) | 100 % ich-forma, MHD 110:20, 3 haléře / 100 |
Strop tokenů 550 proudů přes 4 klastry | 20,26 s (4,90 s medián) | 264 081 tok/s špička (257 001 vidit.) | 1 195 658 tokenů | 20,25 Kč celkem (1,69 Kč / 100k tok) | 550/550 OK, 0× 429, 98,1 % viditelného textu |
Kolik stojí takový roj a co z něj bereme do Hyperprostoru
Samotný ostrý běh tří stovek unikátních Pražanů (dovygenerování dvoustovky nových postav, hromadný dotazník 300 oken i obě kola hodnocení produktu u 60 stolů) vyšel na pouhých 0,79 USD (zhruba 18,09 Kč). Celá první česká vlna dohromady včetně všech testovacích vln žebříku a ilustrací Ateliéru vyšla na 3,37 USD (77,47 Kč), navazující série architektonických rychlostních a cenových testů přidala 2,18 USD (50,08 Kč), takže úplně celý výzkum obou režimů dohromady včetně zátěžové zkoušky 550 paralelních proudů stál pouhých 5,55 USD (127,54 Kč).
Do Pracovních týmů v Hyperprostoru si z toho bereme jednoduchou dvourychlostní zásadu. Kde potřebujete přirozenou češtinu a jemnou rozvahu blízkou velkým modelům GPT, zůstanete u klidnějších 45 tisíc tok/s za necelých dvacet sekund. A tam, kde potřebujete během vteřiny vychrlit stovky až tisíc perspektiv na průzkum, otestovat text publikem nebo roztočit masivní simulaci za 31 haléřů na tisíc lidí, zapnete předehřáté desetičlenné dávky v angličtině, oddělené jmenné šardy a teprve čistý výsledek přeložíte do lidské řeči.
Jan Tyl