Laboratoř teorií: kdy je skupina chytřejší než její nejchytřejší člen
Čtyři týmy AI vymýšlely, testovaly a opravovaly teorie kolektivní inteligence a nezávislý simulovaný svět je soudil. Tři vlny experimentu ukázaly, že skupina teorií předpovídá lépe než nejlepší z nich a že iterace funguje jen s přesným soudcem.
Proč jsme postavili Laboratoř teorií
Postavili jsme malou výzkumnou laboratoř, ve které čtyři týmy umělé inteligence samy vymýšlejí, testují a opravují vědecké teorie. Během jednoho dne proběhly tři vlny experimentu: 36 teorií, 41 volání modelu Claude Opus a zhruba šest hodin výpočtu za 63 dolarů. Výsledkem je laboratoř, jejíž společná odpověď předpovídá lépe než klasické strojové učení a obvykle i lépe než nejlepší z jejích vlastních teorií.
Inspirací bylo oznámení startupu Physical Superintelligence (PSI) z listopadu 2026. Jeho výzkumný systém s neveřejným modelem od Anthropicu podle autorů dokázal matematickou domněnku z roku 2008. Důkaz zkontroloval Lean, program, který ověří každý logický krok. V době oznámení šlo o čerstvý preprint, nezávislé posouzení teprve probíhalo.
Nás na tom zaujala hlavně metoda. AI v ní nikoho nepřesvědčovala řečí. Navrhovala, a nezávislý, neúplatný soudce rozhodoval, co platí. Princip „generátor hypotéz + nezávislý soudce + opakované zlepšování“ je obecný.
Položili jsme si proto otázku: funguje stejná smyčka i mimo matematiku? Tedy tam, kde žádný Lean neexistuje, například v psychologii nebo ve filozofii?
V článku najdete:
- jakou otázku jsme zkoumali a co o ní věda už ví,
- jak laboratoř funguje, krok za krokem a na příkladech,
- tři vlny experimentu, včetně chyb, které jsme cestou udělali,
- nezávislou kritiku, kterou jsme dostali, a co jsme s ní udělali,
- k čemu jsme dospěli a co to znamená pro týmy lidí i AI agentů.
Článek je dlouhý, čtení zabere asi půl hodiny. Kdo spěchá, může rovnou skočit na kapitolu K čemu jsme dospěli.
Interaktivní report: všech 36 teorií v plném znění, grafy, statistiky a každé rozhodnutí západky najdete v interaktivním reportu.
Otázka: kdy je skupina chytřejší než její nejlepší člen
Zkoumali jsme jedinou otázku: za jakých podmínek je skupina inteligentnější než její nejinteligentnější člen? Neptáme se, jestli je skupina lepší než průměrný člen. To bývá snadné. Ptáme se, jestli dokáže porazit toho nejlepšího, kdo v ní sedí.
Představte si poradu pěti lékařů, z nichž jeden je špičkový specialista. Když skupina jen zprůměruje názory, slabší hlasy specialistu „rozmělní“. Aby ho skupina porazila, musí přidat něco, co on sám nemá: jinou informaci, jiný úhel pohledu nebo opravu jeho chyby.
Kdy skupiny vyhrávají a kdy prohrávají, ukazují čtyři běžné situace:
- Skupina vyhraje: sto lidí tipuje počet bonbonů ve sklenici. Průměr tipů bývá blíž pravdě než skoro každý jednotlivec, protože přestřelení na jednu stranu vyruší podstřelení na druhou.
- Skupina vyhraje: auto nejde nastartovat a porucha má tři příčiny. Elektrikář najde vadný kabel, mechanik ucpaný filtr a programátor chybu v řídicí jednotce. Nikdo z nich by auto neopravil sám, spolu ano.
- Skupina prohraje: porota odpovídá na záludnou otázku, na kterou většina lidí intuitivně odpoví špatně. Hlasování chybu nezruší, ale potvrdí.
- Skupina prohraje: na poradě rozhoduje nejhlasitější a nejsebevědomější člověk, ne ten nejschopnější. Skupina je pak jen tak chytrá, jak dobře její status odpovídá skutečné kompetenci.
Otázka má dnes velmi praktický rozměr, a to u lidí i u umělé inteligence:
- Firmy a týmy řeší, kdy svolat poradu, kdy nechat rozhodnout experta a kdy prostě hlasovat.
- Vývojáři AI dnes běžně skládají víc agentů dohromady: jeden píše, druhý kontroluje, třetí hlasuje. Kdy z toho vznikne něco chytřejšího než nejlepší agent a kdy jen drahý šum?
- Věda se tu potkává ze tří stran: filozofie se ptá, co je kolektivní poznání, psychologie zkoumá, jak skupiny rozhodují, a informatika staví systémy z mnoha modelů.
V našem experimentu má „porazit nejlepšího člena“ přesný význam. Nejlepší člen je ten se skutečně nejvyšší kompetencí a řeší stejné úlohy jako skupina, jen sám. Skupina sama nemusí vědět, kdo to je. Vyhrává, když je lepší aspoň o jeden procentní bod úspěšnosti, u odhadů o 1 % menší chyby.
Co o kolektivní inteligenci už víme
Věda zná šest mechanismů, které rozhodují, jestli skupina svého nejlepšího člena porazí. Všechny jsme později vložili do simulovaného světa a týmy AI je měly znovu objevit, aniž by svět viděly zevnitř.
1. Moudrost davu a korelované chyby
V roce 1906 tipovalo na dobytčím trhu v anglickém Plymouthu skoro 800 lidí váhu vola. Prostřední tip se od skutečné váhy lišil o necelé 1 %. Průměr funguje, protože nezávislé chyby se vzájemně ruší.
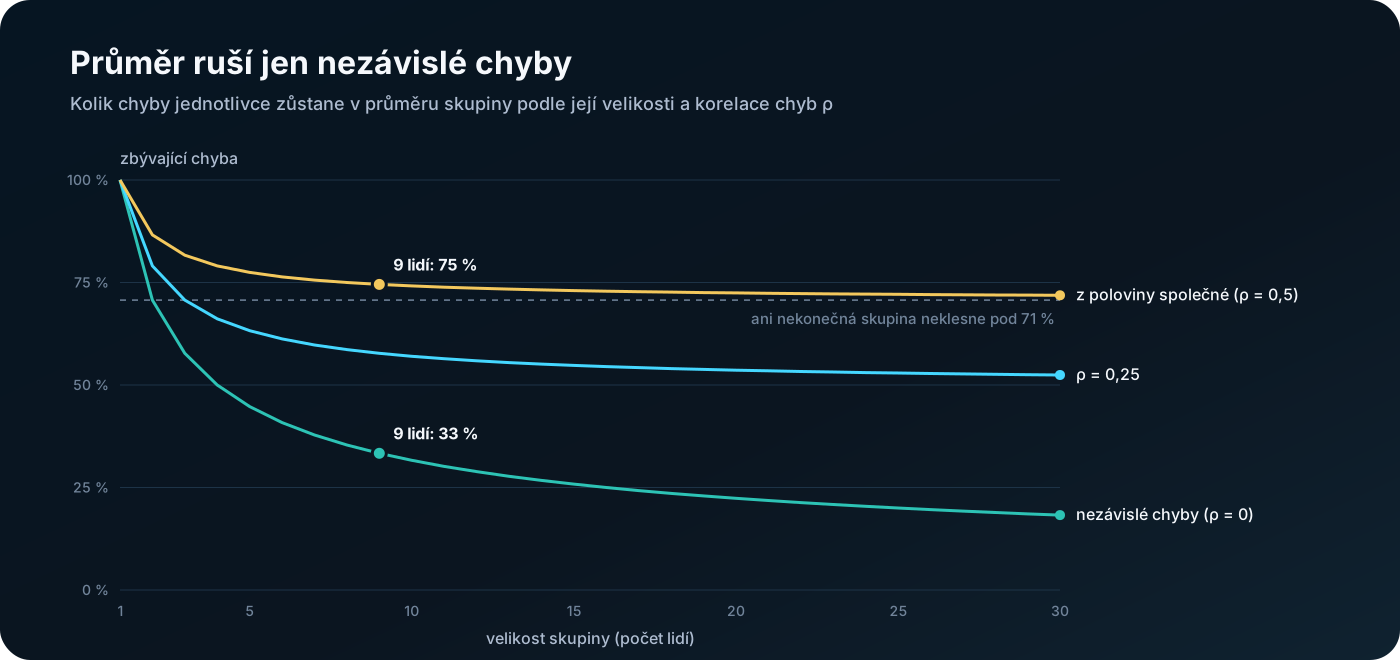
Háček je ve slově nezávislé. Když všichni četli stejný zavádějící článek, chybují stejným směrem a průměr chybu nezruší. Matematicky: chyba průměru se zmenší na √(ρ + (1 − ρ) / n) původní chyby, kde n je velikost skupiny a ρ korelace chyb.
- Devět lidí s nezávislými chybami (ρ = 0) zmenší chybu na třetinu.
- Devět lidí, jejichž chyby jsou z poloviny společné (ρ = 0,5), ji zmenší jen na zhruba 75 %.
- A když je jeden člen mnohem přesnější než ostatní, průměr jeho přesnost naopak „rozmělní“.
2. Condorcetova věta a její obrácení
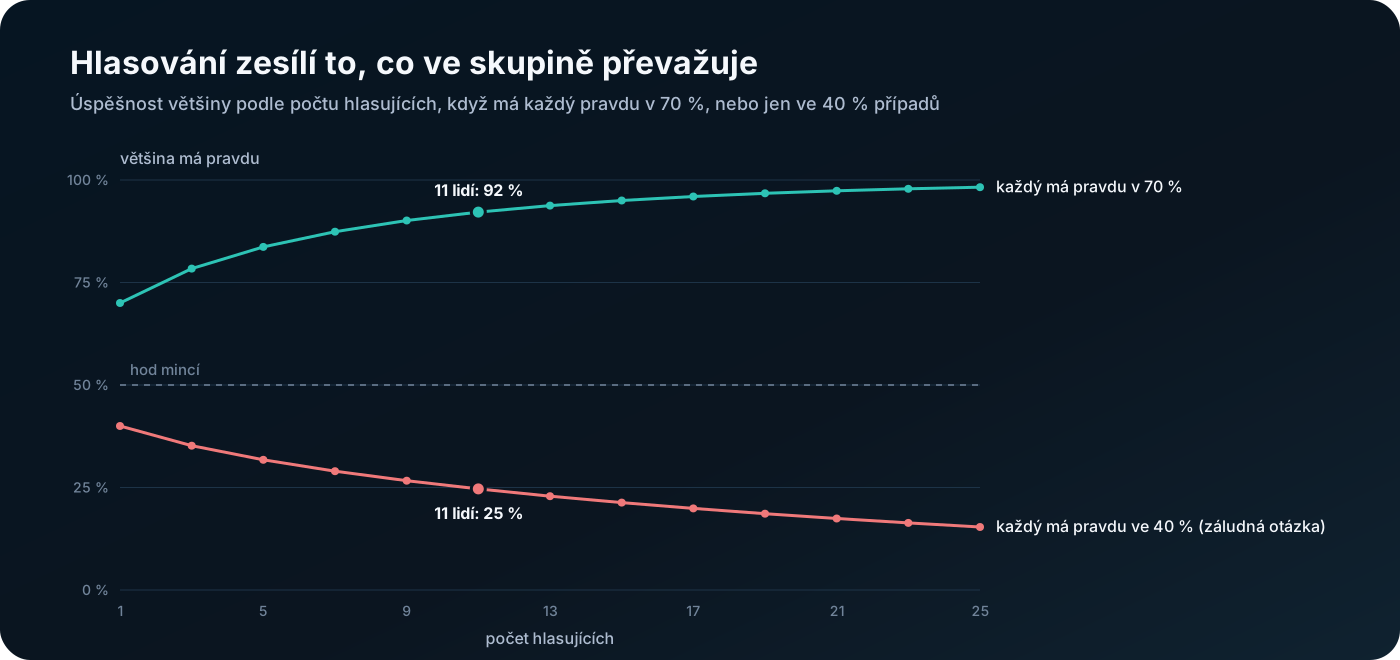
Markýz de Condorcet v roce 1785 ukázal, že většina může být chytřejší než jednotlivci. Pokud má každý porotce pravdu s pravděpodobností větší než 50 % a rozhoduje nezávisle, většina má pravdu častěji než kdokoli z nich. Jedenáct porotců, z nichž každý má pravdu v 70 % případů, rozhodne většinou správně zhruba ve 92 % případů.
Věta ale platí i obráceně. Vezměte záludnou otázku: Pálka a míček stojí dohromady 110 Kč, pálka je o 100 Kč dražší než míček. Kolik stojí míček? Většina lidí intuitivně odpoví 10 Kč, správně je 5 Kč. Když má každý pravdu jen ve 40 % případů, většina jedenácti lidí rozhodne správně jen zhruba ve 25 %. Hlasování chybu nezruší, ale zesílí.
3. Demonstrovatelnost: pravda vítězí
Psycholog Patrick Laughlin rozlišil úlohy podle toho, jestli jde správnou odpověď předvést. U matematické úlohy nebo hádanky stačí, aby řešení našel jeden člověk. Jakmile ho vysloví, ostatní hned poznají, že je správné, a „pravda vítězí“.
U jiných úloh to nejde. Které logo je lepší, který uchazeč bude dobrým kolegou, jaké víno je nejlepší? Tam správná odpověď nepřesvědčí sama o sobě a rozhoduje většina nebo status.
4. Skryté profily: znalosti, které nikdo nevysloví
Garold Stasser a William Titus v roce 1985 zjistili, že skupiny se v diskusi věnují hlavně informacím, které už zná každý. Unikátní informace, kterou má jen jeden člověk, často vůbec nezazní.
Příklad: výběrová komise vybírá mezi kandidáty A a B. Každý člen zná jinou slabinu kandidáta A, takže každému zvlášť vychází A jako nejlepší. Kdyby si své znalosti dali dohromady, jasně by vyhrál B. Diskuse se ale točí kolem sdílených předností kandidáta A. Komplementární znalosti jsou tak nejsilnějším zdrojem výhody skupiny a zároveň nejkřehčím.
5. Status a viditelnost kompetence
Skupiny poslouchají ty, kdo působí kompetentně: sebevědomě, seniorně, hlasitě. Když tento dojem odpovídá skutečné kompetenci, vůdce nebo vážená diskuse fungují skvěle. Když ne, skupina následuje sebevědomého, který se mýlí. Příklad: nejzkušenější inženýr v týmu je tichý, rozhoduje nový, sebejistý manažer.
6. Procesní ztráty a velikost skupiny
Ivan Steiner v roce 1972 shrnul výkon skupiny jako potenciál minus procesní ztráty. Ztráty vznikají z koordinace, z omezeného času, z konformity nebo z toho, že se někdo „veze“. Větší skupina má větší potenciál, ale i větší ztráty. Na hodinové poradě třiceti lidí rozhodnutí ve skutečnosti utváří jen několik nejaktivnějších.
Žádný z těchto mechanismů sám otázku neřeší. Výsledek záleží na jejich souhře, a to je přesně úloha pro teorii: spojit je tak, aby předpověděla i situace, které nikdo předtím neviděl.
Hlavní myšlenka: AI navrhuje, nezávislý soudce rozhoduje
Naše hlavní myšlenka je jednoduchá: model nesmí soudit sám sebe. Teorie navrhuje umělá inteligence, ale o tom, jestli platí, rozhoduje nezávislý soudce, kterého nejde přesvědčit výmluvností.
Proč nestačí, aby se několik chatbotů dohodlo? Jazykové modely jsou přesvědčivé a debata několika z nich směřuje k tomu, co zní nejlépe, ne k tomu, co je pravda. Hlasování modelů navíc naráží na Condorcetův problém z předchozí kapitoly. Když mají všechny modely stejné slepé místo, hlasování ho jen potvrdí. Otázka, kterou zkoumáme, se tak týká i naší vlastní metody.
V matematice je soudcem Lean. V psychologii žádný Lean neexistuje a experimenty s lidmi jsou pomalé a drahé. Postavili jsme proto simulovaný svět: program, který simuluje skupiny lidí při řešení úloh a v experimentu hraje roli přírody. Týmy AI jeho kód nikdy nevidí, stejně jako vědec nevidí zákony přírody. Znají jen popis pokusu a jeho výsledky.
| PSI (matematika) | Laboratoř teorií (kolektivní inteligence) | |
|---|---|---|
| Kdo navrhuje | neveřejný model od Anthropicu | čtyři týmy Claude Opus 5.5, každý s jinou odbornou optikou |
| Kdo soudí | Lean, kontrola důkazů | simulovaný svět a sandbox, který spouští kód teorie |
| Co se ověřuje | každý logický krok důkazu | předpovědi teorie pro situace, které tým nikdy neviděl |
| Kdy se změna přijme | jen když je krok platný | od druhé vlny jen když revize zlepší skryté hodnocení |
Je fér říct, co tím testujeme a co ne. Simulátor obsahuje mechanismy, které jsme do něj vložili podle učebnic. Netestujeme tedy, jestli teorie platí o skutečných lidech. Testujeme, jestli AI dokáže objevit skrytá pravidla systému, do kterého nevidí, vyjádřit je jako teorii a zobecnit je na situace, které nikdy neviděla.
Právě to je jedna z klíčových schopností vědce. A test je čistý, protože my známe správnou odpověď a můžeme přesně změřit, co AI našla a co minula.
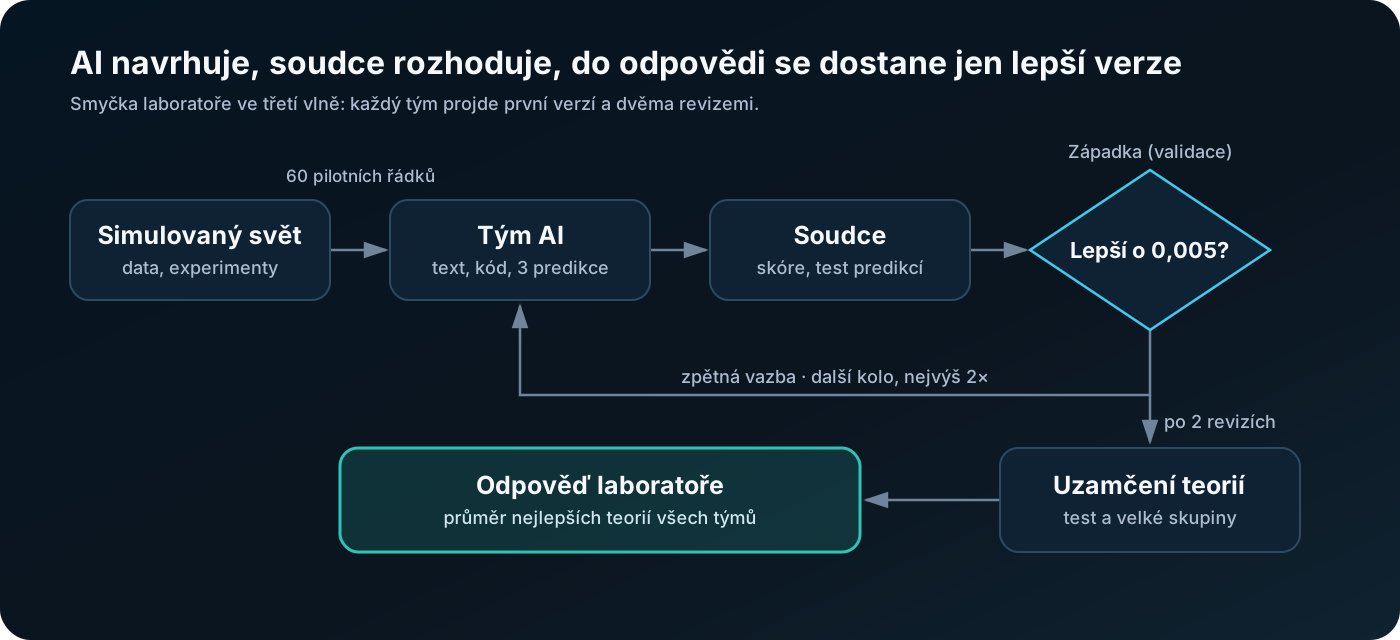
Každý tým projde smyčkou třikrát: první verze a dvě revize. Od druhé vlny o přijetí revize rozhoduje západka, ve třetí vlně soudce navíc testuje predikce na nových experimentech.
Simulovaný svět: kde skupiny řeší úlohy
Simulovaný svět je program, ve kterém skupiny virtuálních lidí řeší tisíce úloh a my měříme, jestli skupina porazila svého nejlepšího člena. Každý pokus, kterému říkáme podmínka, je kombinace typu úlohy, rozhodovacího procesu a šesti číselných parametrů.
Tři typy úloh
| Úloha | Co členové dělají | Příklad ze života | Jak se hodnotí |
|---|---|---|---|
| Odhad | každý odhaduje neznámé číslo | váha vola, náklady projektu, počet zákazníků příští rok | velikost chyby |
| Volba | otázka se dvěma možnostmi, jedna je správná | „Je hlavním městem Austrálie Sydney, nebo Canberra?“ | úspěšnost |
| Hlavolam | k řešení je potřeba několik různých kousků znalostí | porucha auta se třemi příčinami, diagnóza vzácné nemoci | vyřešeno, nebo ne |
Hlavolam jednotlivec vyřeší jen tehdy, když zná všechny potřebné kousky. Skupina ho může vyřešit i tehdy, když každý zná jen něco, pokud se znalosti v diskusi skutečně sejdou.
Tři způsoby rozhodování
- Nezávisle: členové spolu nemluví a odpovědi se spojí mechanicky. U odhadu průměrem, u volby hlasováním, u hlavolamu skupina odevzdá řešení nejrespektovanějšího z těch, kdo si myslí, že ho vyřešili. Jako online anketa.
- Diskuse: volná debata s omezeným časem, která končí konsenzem. Jako porada.
- Vůdce: nejrespektovanější člen se poradí s několika dalšími a rozhodne sám. Jako šéf, který si vyslechne tým.
Šest číselných parametrů
| Parametr | Rozsah | Co znamená | Příklad |
|---|---|---|---|
| Velikost skupiny | 3–12, v závěrečném testu 16–60 | počet členů | tým, oddělení, celá firma |
| Průměrná kompetence | 0–1 | jak schopní jsou členové v průměru | studenti, nebo profesionálové |
| Nerovnost kompetence | 0–1 | jak moc nejlepší člen vyčnívá | sehraný tým, nebo jedna hvězda a pomocníci |
| Korelace chyb | 0–1 | jak podobně se členové mýlí | všichni studovali na stejné škole a čtou stejné zprávy |
| Viditelnost kompetence | 0–1 | jak dobře skupina pozná, kdo je schopný | tým, kde se ví, kdo je expert, nebo kde rozhoduje sebevědomí |
| Demonstrovatelnost | 0–1 | jak snadno ostatní poznají správnou odpověď | matematický důkaz, nebo hodnocení vína |
Co se měří
V každé podmínce skupina vyřeší 2000 úloh. Její nejlepší člen řeší stejné úlohy sám. Spočítáme, o kolik byla skupina lepší nebo horší, a jestli zvítězila aspoň o jeden procentní bod.
Ve třetí vlně řeší každou podmínku deset různých skupin se stejnými parametry. Měříme pak podíl skupin, které svého nejlepšího člena porazily. Proč to bylo nutné, vysvětlíme u druhé vlny.
Co je uvnitř a týmy to nevidí
V simulátoru jsou zabudovaná konkrétní pravidla, která měly týmy AI objevit. Například:
- Úspěšnost u volby je 0,3 + 0,65 × kompetence. Nejslabší členové se tedy mýlí častěji, než kdyby si házeli mincí, a naletí na „návnadu“.
- Hlavolam vyžaduje 5 kousků znalostí. Vyslovenou znalost skupina přijme s pravděpodobností 0,5 + 0,5 × demonstrovatelnost.
- V diskusi reálně mluví jen 6 nejrespektovanějších členů a vůdce se radí nejvýš s pěti lidmi. Při odhadu dává vůdce vlastnímu názoru 70% váhu.
- Kdo hlavolam nevyřešil, mylně věří opaku s pravděpodobností 0,5 × (1 − demonstrovatelnost). Takoví „falešní řešitelé“ mohou přebít skutečného.
Simulátor jsme nejprve ověřili deseti kontrolními testy, například že reprodukuje Condorcetovu větu, moudrost davu nebo škodlivost korelovaných chyb. Teprve pak jsme ho pustili k týmům.
Týmy AI vědců, teorie jako kód a soudce
Čtyři instance modelu Claude Opus 5.5 pracovaly jako samostatné výzkumné týmy, každá s jinou odbornou optikou. Různé optiky jsme zvolili ze stejného důvodu, kvůli kterému fungují různorodé skupiny lidí: různé pohledy dělají různé chyby.
| Tým | Optika | Otázka, kterou si klade |
|---|---|---|
| Statistik | moudrost davu, Condorcet, korelované chyby | Kolik chyb se průměrováním zruší? |
| Diverzita | komplementární znalosti, skryté profily | Co vědí ostatní, co nejlepší neví? |
| Sociální psycholog | Steiner, Laughlin, status, konformita | Co se cestou ztratí v procesu? |
| Minimalista | Occamova břitva | Jaký nejmenší počet principů stačí? |
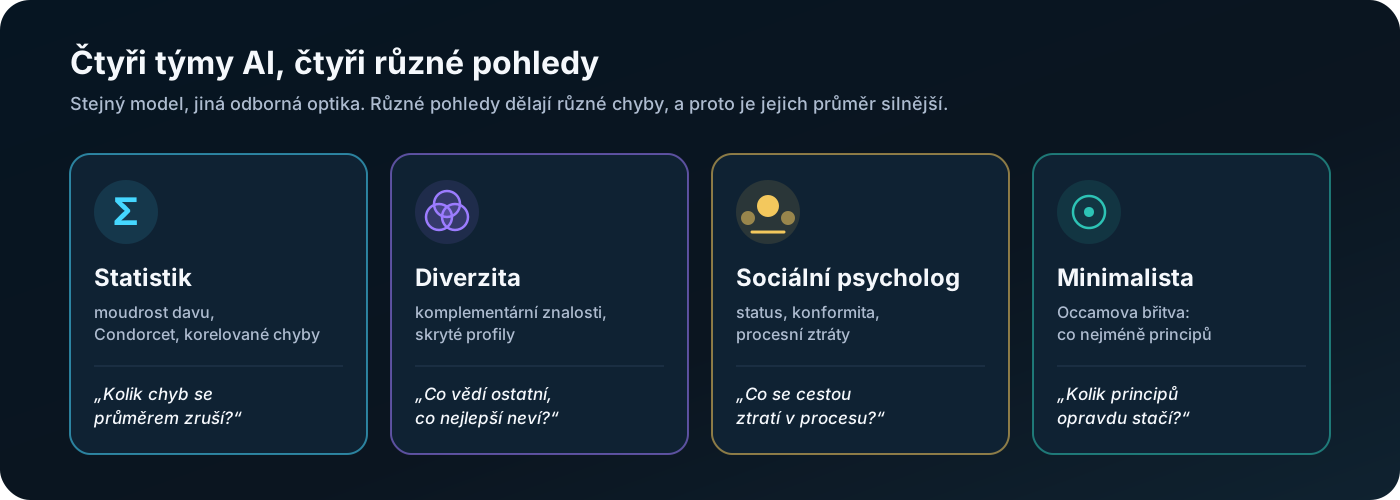
Týmy běží bez nástrojů a bez přístupu k souborům, takže do simulátoru fyzicky nemohou nahlédnout. Na začátku dostanou jen popis pokusu, svou optiku a 60 pilotních řádků dat. Každý řádek je jedna podmínka s parametry a výsledkem.
Jak vypadá teorie
Každá teorie má čtyři části:
- Název, například „Skládání dílků proti sdílené slepotě“.
- Tvrzení: 4 až 8 vět o tom, jaké mechanismy rozhodují.
- Tři falzifikovatelné predikce: odvážná tvrzení, která může experiment vyvrátit.
- Funkce
predict(c): krátký program v Pythonu, který pro libovolnou podmínku vrátí pravděpodobnost, že skupina porazí svého nejlepšího člena.
Proč kód? Slova bývají vágní: „skupiny obvykle vyhrávají, když jsou různorodé“ se nedá změřit. Kód dá číslo pro každou situaci, a to už jde ověřit. Je to náš ekvivalent formálního důkazu.
Ukázka skutečného řádku z teorie sociálního psychologa z první vlny:
k_del = min(n - 1.0, 6.0) # limited airtime: only ~6 other voices really heard
Komentář říká: „omezený čas, ve skutečnosti je slyšet jen asi 6 dalších hlasů“. Tým to odvodil z jediného slova v popisu pokusu, že diskuse má „omezený čas“. Simulátor má skutečně nastavených 6 mluvčích.
Soudce a Brier skóre
Soudce spustí kód teorie v izolovaném procesu, kde je k dispozici jen matematická knihovna, žádné soubory ani síť. Pro každou podmínku porovná předpověď se skutečností a spočítá Brier skóre.
Brier skóre znáte z předpovědi počasí. Meteorolog řekne „80 % šance na déšť“:
- když prší, je jeho chyba (1 − 0,8)² = 0,04,
- když neprší, je jeho chyba (0 − 0,8)² = 0,64,
- Brier skóre je průměr těchto chyb za všechny dny.
Nula znamená dokonalou předpověď. Kdo řekne pokaždé „50 %“, dostane 0,25, tedy úroveň házení mincí. Čím nižší skóre, tím lépe.
Tým pak dostane zpětnou vazbu z tréninkových dat: celkové skóre, rozpad podle devíti kombinací úlohy a procesu a 30 největších omylů. Pak teorii přepracuje. Každý tým měl dvě kola revizí, takže z každého týmu vznikly tři verze teorie: r0, r1 a r2.
Učebnice, písemka a zkoušky
Data jsme rozdělili na čtyři části po 300 podmínkách, podobně jako ve škole:
| Sada | Školní obdoba | Co z ní tým vidí |
|---|---|---|
| Trénink | cvičebnice s výsledky | všechno: výsledky i zpětnou vazbu |
| Validace | písemka, kterou opraví učitel | od druhé vlny jen „přijato“, nebo „zamítnuto“ |
| Test | závěrečná zkouška ze stejné látky | nic |
| Velké skupiny | zkouška z vyššího ročníku: skupiny 16–60 členů, v tréninku jen 3–12 | nic |
Právě sada velkých skupin je nejtvrdší zkouškou. Teorie, která jen napasovala čísla na trénink, tam selhává. Teorie, která zachytila skutečný mechanismus, ho dokáže přenést i do neznámého rozsahu.
Srovnání se strojovým učením
Abychom věděli, jestli jsou teorie vůbec dobré, porovnali jsme je s modely strojového učení bez jakékoli teorie. Říkáme jim baseliny: gradient boosting (soubor rozhodovacích stromů), logistická regrese a průměr z tréninku. Baseliny se učí ze všech 300 tréninkových řádků, týmy začínají s 60. Kdyby teorie neporazila prosté napasování křivky na data, nebyla by to dobrá teorie.
První vlna: teorie porazily strojové učení, revize ale škodily
V první vlně teorie, které viděly jen 60 řádků dat, předpovídaly lépe než strojové učení na 300 řádcích. Každá další revize je ale spíš zhoršila. Běh trval 148 minut, s pozdějším doplněním 181 minut, a stál 18,21 dolaru.
Nastavení bylo nejjednodušší možné. Každý tým napsal první verzi a dvě revize a každá revize se automaticky stala základem další. Každou podmínku řešila jedna skupina a najednou běžela čtyři volání modelu.
Výsledky prvních verzí
Brier skóre, nižší je lepší:
| Model | Test (3–12 členů) | Velké skupiny (16–60) |
|---|---|---|
| Průměr čtyř prvních teorií | 0,078 | 0,098 |
| Diverzita r0 | 0,083 | 0,108 |
| Minimalista r0 | 0,085 | 0,129 |
| Statistik r0 | 0,091 | 0,114 |
| Gradient boosting, 300 řádků | 0,112 | 0,137 |
| Sociální psycholog r0 | 0,119 | 0,131 |
| Logistická regrese | 0,122 | 0,285 |
Tři týmy ze čtyř porazily gradient boosting na testu, diverzita a minimalista statisticky významně. Logistická regrese se mimo rozsah tréninku zhroutila: na velkých skupinách dopadla hůř než prostý průměr z tréninku (0,247). Přímka napasovaná na skupiny o 3 až 12 členech pro skupinu o 50 členech nedává smysl.
Co týmy objevily
Nejvíc nás překvapilo, jak přesně týmy odhadly skrytá pravidla simulátoru. Statistik z 60 řádků zrekonstruoval přesný tvar rozložení kompetencí ve skupině:
s = [min(0.99, max(0.0, m + 0.3 * sp * _ppf((i + 0.625) / (n + 0.25)))) for i in range(n)]
tau = 0.5 + 0.5 * dem  # chance a voiced piece is accepted
Simulátor používá průměr + 0,3 × nerovnost × kvantil normálního rozdělení, tedy stejný tvar i stejnou konstantu 0,3. Přijetí vyslovené znalosti 0,5 + 0,5 × demonstrovatelnost odpovídá simulátoru přesně.
Další příklady:
- Sociální psycholog odhadl, že v diskusi je slyšet asi 6 hlasů. Skutečnost: 6.
- Minimalista ve druhé revizi zavedl „základní znalost 30 %“ u volby. Simulátor má úspěšnost 0,3 + 0,65 × kompetence.
- Tři týmy odhadly, že vůdce dává vlastnímu názoru 65–67 % váhy. Skutečnost: 70 %.
- Diverzita přišla na to, že diskuse u odhadů vybírá „nejlepší odhad pro daný problém, ne nejlepšího člověka“. Přesně tak simulátor funguje, když jde správnou odpověď rozpoznat.
Naopak nikdo neodhadl počet kousků znalostí u hlavolamu (skutečnost 5, odhady 2 až 4) ani počet poradců vůdce. Kapacitní limity se z dat o malých skupinách poznají nejhůř.
Smyčka umí vyvracet
Minimalista v první revizi zavedl „strop schopností“: když jsou všichni velmi schopní, nejlepší nemá kam utéct. Ve druhé revizi napsal: „Strop data vyvrátila: při průměrné kompetenci 0,81 průměrování prohrálo o 17 %.“ A nahradil ho správným vztahem: chyba klesá s kompetencí lineárně, takže mezi zkušenými je nejlepší relativně ještě přesnější.
Revize ale uměly i ztrácet. Statistik i sociální psycholog měli v první revizi správně, že „falešných řešitelů“ ubývá s demonstrovatelností. Ve druhé revizi tuto správnou závislost oba zrušili.
Revize škodily
První revize zhoršila výsledek na testu u všech čtyř týmů, u tří z nich významně:
| Tým | Test r0 → r1 |
|---|---|
| Minimalista | 0,085 → 0,128 |
| Diverzita | 0,083 → 0,116 |
| Sociální psycholog | 0,119 → 0,149 |
| Statistik | 0,091 → 0,102 |
Teorie přitom rostly: minimalista z 873 na 1 406 uzlů syntaktického stromu, tedy o 60 %. Zpětná vazba „tady je 30 největších omylů“ sváděla k záplatám na jednotlivé případy místo lepších mechanismů. Laboratoř navíc přijala každou revizi, i horší, protože nic jako Lean ji nezastavilo.
Kde teorie selhaly
Na velkých skupinách teorie nadhodnotily hlavolamy řešené diskusí. Předpovídaly 89–93 % výher, skutečnost byla 79 %. Uvažovaly logicky, že víc členů přinese víc znalostí. V simulátoru ale mluví jen 6 nejrespektovanějších, takže většina znalostí velké skupiny nikdy nezazní.
Skupina teorií je chytřejší než nejlepší teorie
Když jsme zprůměrovali předpovědi čtyř prvních teorií, dostali jsme výsledek lepší než nejlepší jednotlivá teorie: 0,078 proti 0,083 na testu a 0,098 proti 0,108 na velkých skupinách. Průměr všech 12 verzí dosáhl na velkých skupinách dokonce 0,092. Laboratoř tak na vlastních teoriích předvedla přesně ten jev, který zkoumá: různé optiky dělají různé chyby a průměr je ruší.
Technické potíže
- Zaseknutá volání: 4 ze 13 volání se nevrátila. Časový limit na Windows ukončil jen spouštěcí skript, skutečný proces běžel dál a laboratoř na něj čekala.
- Chyba sandboxu: statistikovu revizi soudce odmítl, protože kód použil standardní funkci
reversed, kterou jsme zapomněli povolit. Byla to naše chyba. Po opravě ta samá odpověď prošla a nemuseli jsme za ni platit znovu. - Doplnění: dva týmy kvůli zaseknutí nedokončily revize. Doplnili jsme je o dvě hodiny později: 3 volání, 33 minut, 5,83 dolaru, tentokrát bez jediného zaseknutí.
Z první vlny jsme si odnesli tři ponaučení. Revize potřebují soudce, který horší verzi nepustí. Odpovědí laboratoře má být skupina teorií, ne jedna teorie. A čtyři současná volání modelu jsou příliš mnoho.
Druhá vlna: západka a průměr teorií
Ve druhé vlně se skupina teorií poprvé statisticky významně ukázala chytřejší než její nejlepší člen. Nová „západka“, která měla horší revize zastavit, ale rozhodovala spíš náhodně. Běh na nových datech trval 96 minut a stál 24,67 dolaru. Z 13 volání se nezaseklo ani jedno.
Co jsme změnili
- Západka: přibyla validace, 300 podmínek, které týmy nevidí. Revize projde, jen když na nich zlepší Brier skóre aspoň o 0,005. Jinak tým pokračuje ze své nejlepší verze a dozví se jen to, že revize neprošla. Je to naše obdoba Leanu, který přijme jen platný krok.
- Odpověď laboratoře: už to není jedna teorie, ale průměr předpovědí nejlepších přijatých verzí všech týmů.
- Provoz: nejvýš dvě volání najednou, každý tým jede svá kola samostatně a časový limit ukončí celý strom procesů.
Výsledky
| Model | Test | Velké skupiny |
|---|---|---|
| Odpověď laboratoře (průměr nejlepších teorií) | 0,075 | 0,085 |
| Průměr prvních verzí | 0,080 | 0,094 |
| Nejlepší jednotlivá teorie podle validace (statistik r1) | 0,093 | 0,131 |
| Gradient boosting | 0,131 | 0,139 |
Odpověď laboratoře porazila gradient boosting o 0,056 na testu a o 0,054 na velkých skupinách. Nejlepší jednotlivou teorii porazila o 0,018 a o 0,047. Oba rozdíly jsou statisticky významné na obou sadách: 95% intervaly spolehlivosti z bootstrapu nezasahují nulu.
Skupina teorií byla tedy chytřejší než její nejlepší člen, a to tentokrát prokazatelně. Důvod je stejný jako u lidí: každý tým se mýlí jinde a průměr chyby ruší.
Západka rozhodovala podle šumu
Západka spolehlivě zastavila katastrofy. Všechny tři jasně horší revize zamítla (diverzita r1 a r2, minimalista r1). U jemnějších rozdílů se ale mýlila:
- Přijala statistika r1, protože se na validaci zlepšil o 0,016. Na testu i na velkých skupinách byl ale horší než předchozí verze (0,082 → 0,093 a 0,114 → 0,131).
- Zamítla statistika r2, protože se na validaci zlepšil jen o 0,001. Přitom to byla na testu nejlepší teorie celého běhu (0,070) a lepší byla i na velkých skupinách.
Z osmi rozhodnutí byla tři správná, dvě chybná a tři smíšená. To není o moc lépe než házení mincí.
Proč: šum ve štítcích
Hledali jsme příčinu a našli ji v samotném měření. Vzali jsme 60 podmínek a každou nasimulovali s 20 různými skupinami. Parametry byly stejné, lišilo se jen náhodné pořadí statusu, tedy kdo je vůdce a kdo mluví.
U 15 z 60 podmínek některé skupiny vyhrály a jiné prohrály. Podíl výher se pohyboval od 5 do 95 %. Na větším vzorku 300 podmínek to bylo 18 až 20 %. Zhruba u pětiny podmínek je tedy výsledek jedné skupiny skoro hod mincí.
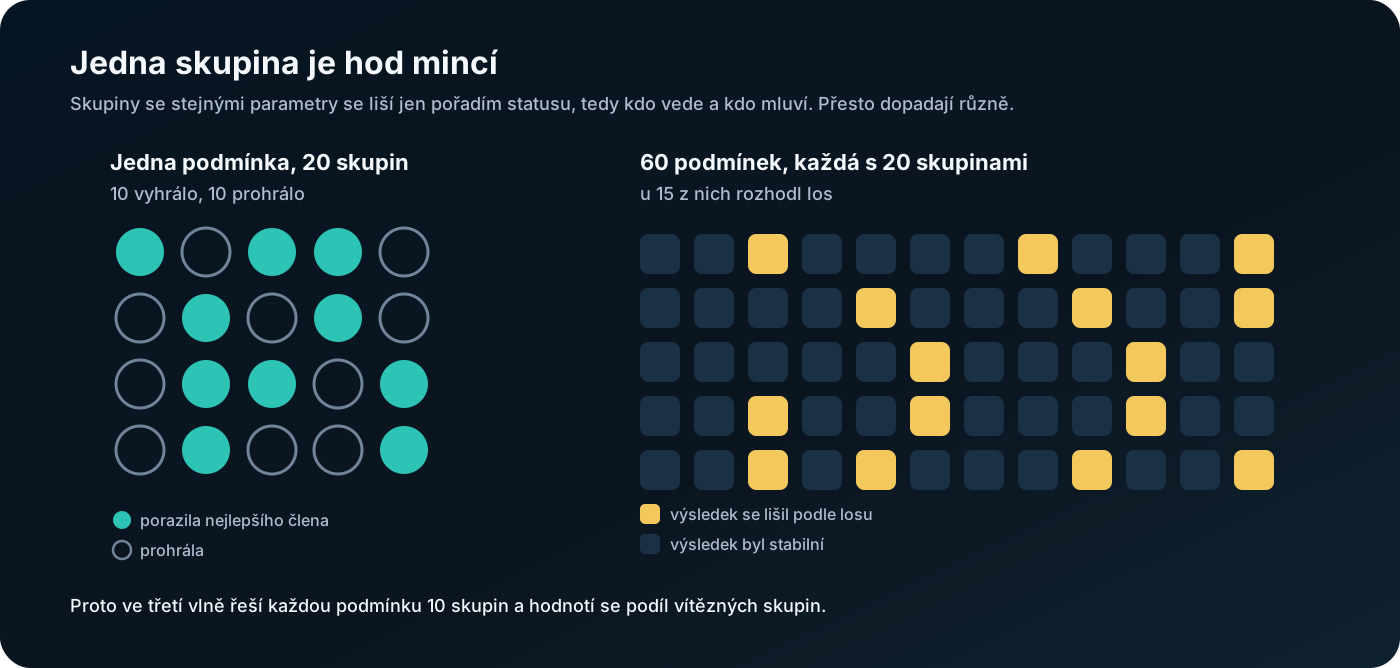
Představte si učitele, který hodnotí každého žáka podle jediné otázky v písemce. I výborný žák občas dostane pětku a slabý jedničku. Takový šum tvořil nesnížitelnou chybu Brier skóre 0,025 až 0,032, tedy víc než většina rozdílů mezi teoriemi. Západka s prahem 0,005 pak přijímala a zamítala podle náhody.
Ponaučení: soudce musí být nejen nezávislý, ale i přesný. Lean se u matematického důkazu nemýlí. Náš soudce se kvůli šumu mýlil často, a revize proto nemohly spolehlivě zlepšovat.
Jedna technická drobnost: jedna odpověď přišla useknutá, protože rozhraní modelu vrátilo jen poslední blok textu. Soudce ji odmítl kvůli formátu a druhý pokus prošel.
Nezávislá kritika: šest návrhů a co jsme s nimi udělali
Po druhé vlně jsme nechali experiment nezávisle posoudit a kritiku jsme přijali celou. Posudek prošel simulátor, řízení týmů i uložené výsledky, znovu spustil testy a přepočítal teorie. Každé tvrzení, které šlo ověřit, jsme ověřili sami. Všechna platila.
1. Skryté testy mohly prosakovat
Soudce spouštěl kód teorie i na skrytých datech. Když kód spadl, text chyby šel zpět týmu. Teorie, která by při chybě vypsala celou podmínku, by tak prozradila parametry skrytých zkoušek, například že v nich jsou skupiny o 40 členech.
V prvních dvou vlnách se to nestalo, cesta ale existovala. Oprava: skryté sady se hodnotí až po uzamčení všech teorií. Z validace se tým dozví jen „přijato“ nebo „zamítnuto“ a chyby na skrytých datech se nikam nehlásí.
2. Jedna skupina je hlučný štítek
2000 úloh neznamená 2000 nezávislých skupin. Respekt, vůdce a mluvčí se losují jednou pro celou podmínku. Posudek našel 14 z 60 podmínek, které při jiném losování daly opačný výsledek. My jsme naměřili 15 z 60.
Právě tento bod vysvětlil, proč se západka ve druhé vlně mýlila. Oprava: každou podmínku řeší deset skupin a hodnotí se podíl těch, které vyhrály. Ukládá se i průměrný zisk a jeho rozptyl.
3. Slovní tvrzení nikdo nekontroloval
Soudce hodnotil jen funkci predict(c). Slovní predikce mohly být nepravdivé a nikdo by to nepoznal. Příklad: diverzita ve druhé vlně tvrdila, že „hlavolam s diskusí nikdy nemá zisk nižší než −0,01“. Tréninková data přitom obsahovala čtyři protipříklady, nejhorší se ziskem −0,199.
Oprava: každá predikce je teď strojově čitelná. Říká, pro jakou oblast parametrů platí, jakou veličinu měří a jaký práh musí splnit. Soudce v té oblasti nasimuluje 40 nových podmínek a tvrzení potvrdí, nebo vyvrátí. Teprve tak dostává slovo „falzifikovatelná“ praktický význam.
4. Staré výsledky se míchaly s novými pravidly
Doplněný report první vlny označoval všechny verze jako „přijaté“, i když první vlna žádnou západku neměla. Například statistik se na dodatečně dopočtené validaci zhoršil z 0,073 na 0,085, a přesto stál v tabulce jako přijatý. Posudek také upozornil, že opakované rozhodování podle stejné validace ji postupně „opotřebovává“. Proto je potřeba závěrečný test, který k rozhodování nikdy neslouží.
Oprava: starý report jsme opravili. Každý běh teď ukládá konfiguraci, přesné označení modelu, všechny prompty, kopii kódu a skutečná rozhodnutí západky. Test a velké skupiny k rozhodování neslouží nikdy.
5. Co z laboratoře skutečně pomáhá?
Posudek navrhl porovnat se stejným rozpočtem čtyři různé optiky, čtyři neutrální agenty a jednoho agenta. Také upozornil, že srovnání se strojovým učením není férové. Agent dostává popis mechanismů i číselný zisk, kdežto klasifikátory se učí jen výsledek ano/ne.
Oprava: přidali jsme silnější baseliny, logistickou regresi s interakcemi úloha × proces a gradient boosting učený na zisku. Srovnání perspektiv s neutrálními agenty zatím zbývá.
6. Ať týmy navrhují rozlišující experimenty
Nejzajímavější návrh: po prvních teoriích vybrat podmínky, ve kterých se jejich předpovědi nejvíc rozcházejí, nasimulovat je a výsledky vrátit týmům. Tak pracuje skutečná věda: hledá experiment, který rozhodne mezi soupeřícími teoriemi.
Zárodek toho má už třetí vlna: predikce jsou vlastně experimenty, které si tým sám navrhne. Vlastní výběr rozlišujících podmínek zbývá.
K tomu posudek doporučil ukládat stav po každém kole, aby přerušený běh nešel nazmar. I to jsme zapracovali.
Třetí vlna: přesnější soudce a testované predikce
Ve třetí vlně revize poprvé skutečně zlepšovaly a odpověď laboratoře byla daleko nejpřesnější ze všech běhů. Běh na nových datech trval 81 minut a stál 20,55 dolaru. Všech 12 volání prošlo napoprvé.
Co jsme změnili
- Deset skupin na podmínku: šum ve validaci klesl z 0,032 na 0,002, tedy zhruba patnáctkrát.
- Uzamčení teorií: test a velké skupiny se vyhodnocují, až když všechny týmy skončí.
- Testované predikce: každá teorie má tři predikce ve formátu JSON a soudce je ověří na nových experimentech.
- Záznam běhu: konfigurace, prompty, kopie kódu a pokračování po přerušení.
- Silnější baseliny a skládání celé odpovědi ze všech bloků textu.
Jak vypadá testovaná predikce
Skutečná predikce statistika z jeho první revize:
{"claim": "Prostý průměr odhadů porazí nejlepšího člena i při vysoké kompetenci a velké nerovnosti, pokud je korelace chyb velmi nízká a skupina velká.",
 "where": {"task": ["estimate"], "process": ["independent"], "skill_mean": [0.75, 1.0],
           "skill_spread": [0.4, 0.9], "correlation": [0.0, 0.1], "n": [9, 12]},
 "stat": "p_beats", "op": ">=", "value": 0.6}
Lidsky: u odhadů s průměrováním, velmi schopnými a nerovnými členy, téměř nezávislými chybami a 9 až 12 členy porazí nejlepšího člena aspoň 60 % skupin. Je to odvážné, protože intuice říká, že mezi experty průměr nejlepšího jen „rozmělní“. Soudce nasimuloval 40 nových podmínek v té oblasti a nejlepšího porazilo 100 % skupin. Predikce platí.
Aby týmy nemohly pomocí predikcí nahlédnout do závěrečné zkoušky, směly testovat jen skupiny o 3 až 12 členech.
Výsledky
Brier skóre proti podílu vítězných skupin. Čísla nejsou přímo srovnatelná s prvními dvěma vlnami, protože cíl obsahuje méně šumu.
| Model | Test | Velké skupiny |
|---|---|---|
| Odpověď laboratoře | 0,032 | 0,037 |
| Nejlepší jednotlivá teorie podle validace (minimalista r1) | 0,041 | 0,070 |
| Průměr prvních verzí | 0,064 | 0,057 |
| Logistická regrese s interakcemi | 0,086 | 0,175 |
| Gradient boosting | 0,106 | 0,090 |
Odpověď laboratoře porazila nejlepší baseline podle validace, logistickou regresi, o 0,054 na testu a o 0,138 na velkých skupinách. Gradient boosting dopadl na velkých skupinách lépe (0,090), i proti němu je ale náskok laboratoře 0,053. Nejlepší jednotlivou teorii porazila o 0,010 na testu, ale jen bodově, ne statisticky významně, a o 0,033 na velkých skupinách, tam významně. Logistická regrese, nejlepší baseline na validaci, se mimo rozsah tréninku znovu zhroutila.
Revize konečně pomáhají
Brier skóre na testu po jednotlivých verzích:
| Tým | r0 | r1 | r2 | Finální |
|---|---|---|---|---|
| Diverzita | 0,144 | 0,041 | 0,041 | r2 |
| Minimalista | 0,072 | 0,041 | 0,079, zamítnuto | r1 |
| Statistik | 0,086 | 0,052 | 0,131, zamítnuto | r1 |
| Sociální psycholog | 0,075 | 0,076, zamítnuto | 0,109, zamítnuto | r0 |
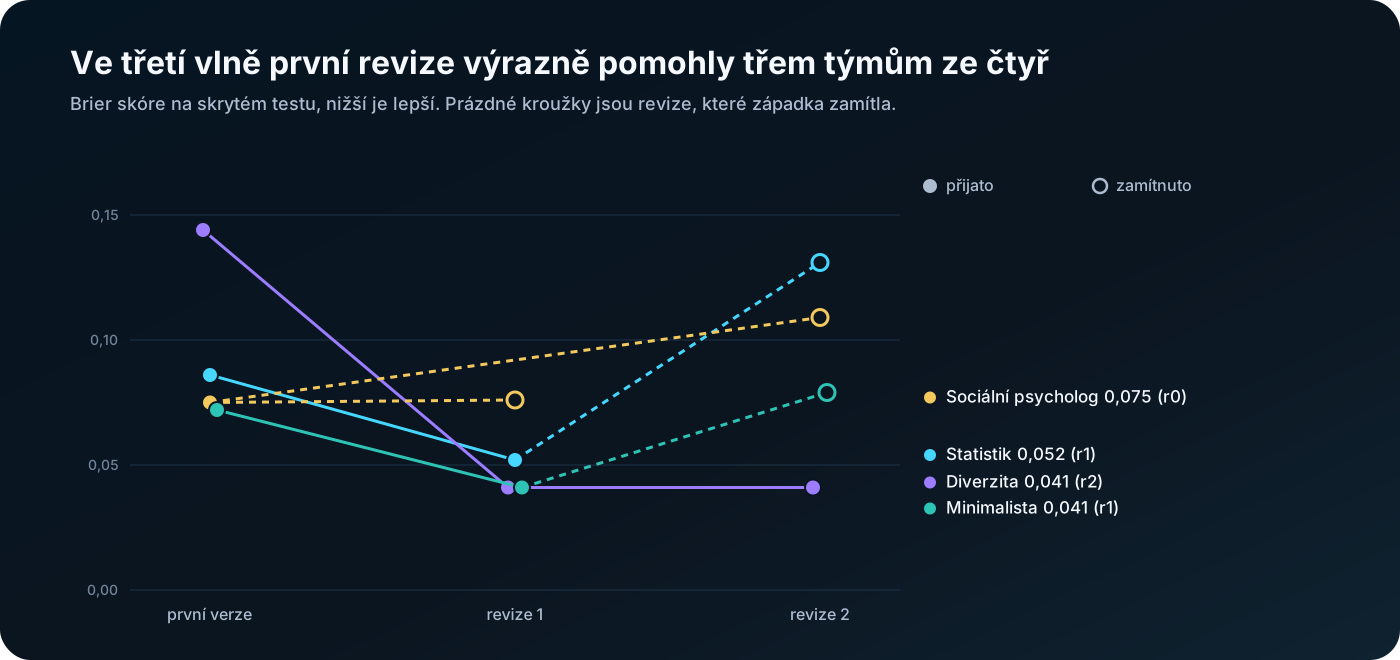
Tři týmy ze čtyř se v první revizi výrazně zlepšily. Statistik se na velkých skupinách zlepšil z 0,106 na 0,046, tedy víc než o polovinu. Diverzita začínala hůř než baseliny a po revizi patřila mezi nejlepší.
Druhá revize většinou nepomohla: západka zamítla tři ze čtyř. Statistikova r2 by na testu zhoršila skóre z 0,052 na 0,131. Bez západky by se do odpovědi laboratoře dostala.
Západka rozhodla správně v 7 z 8 případů, ve druhé vlně jen ve 3 z 8. Jediným smíšeným rozhodnutím bylo zamítnutí minimalistovy r2, která byla na testu horší, ale na velkých skupinách o kousek lepší. Odpověď laboratoře je díky revizím významně lepší než průměr prvních verzí: o 0,033 na testu a o 0,020 na velkých skupinách.
Predikce, které prošly, a ty, které ne
Z 36 predikcí prošlo testem na nových experimentech 33. Ukázky:
- Platí: „Diskuse u hlavolamu sdružuje kousky znalostí i při téměř nulové demonstrovatelnosti. Skupiny s nízkou korelací a slabými až středními členy převýší nejlepšího člena nejméně o 0,2.“ (minimalista r1). Pozorovaný zisk: 0,33.
- Platí, a předpovídá prohru: „Vůdce u volby se řídí většinou poradců. Při silné korelaci, nerovných dovednostech a nízké demonstrovatelnosti skupina prohrává s nejlepším aspoň o 2 procentní body.“ (minimalista r1). Pozorováno: −8 bodů.
- Neplatí, těsně: „Mechanické hlasování kopíruje typického člena, při znatelné nerovnosti nejlepšího neporazí skoro žádná skupina (nejvýš 10 %).“ (diverzita r0). Pozorováno: 16 %.
- Neplatí, dramaticky: statistikova r2 tvrdila, že u hlavolamů s velmi schopnými a nerovnými členy vyhraje nejvýš 20 % skupin. Pozorováno: 97 %.
Vyvrácené predikce patřily verzím, které byly slabší i podle čísel. Dvě patřily revizím, které západka zamítla. Třetí patřila první verzi diverzity, kterou tým v další revizi opravil. Selhání predikce tak vypovídá o kvalitě celé teorie.
Jedna výhrada: 92% úspěšnost může znamenat i to, že týmy formulovaly opatrné predikce. Jejich odvahu laboratoř zatím neumí změřit.
K čemu jsme dospěli
Nejdůležitější výsledek: skupina teorií byla ve všech třech vlnách chytřejší než nejlepší jednotlivá teorie vybraná podle validace, tedy bez nahlížení do testu. Laboratoř tak na vlastní práci předvedla přesně ten jev, který zkoumá. Celkem jsme došli k sedmi závěrům.
1. Skupina teorií porazí nejlepší teorii
Průměr předpovědí všech týmů byl ve všech třech vlnách lepší než nejlepší jednotlivá teorie vybraná podle validace. Zpětně, s pohledem do testu, se dá najít verze, která byla v některé sadě lepší, například zamítnutá statistikova r2 ve druhé vlně. Tu by ale předem nikdo nevybral. Statisticky významně ve druhé vlně na obou skrytých sadách a ve třetí vlně na velkých skupinách.
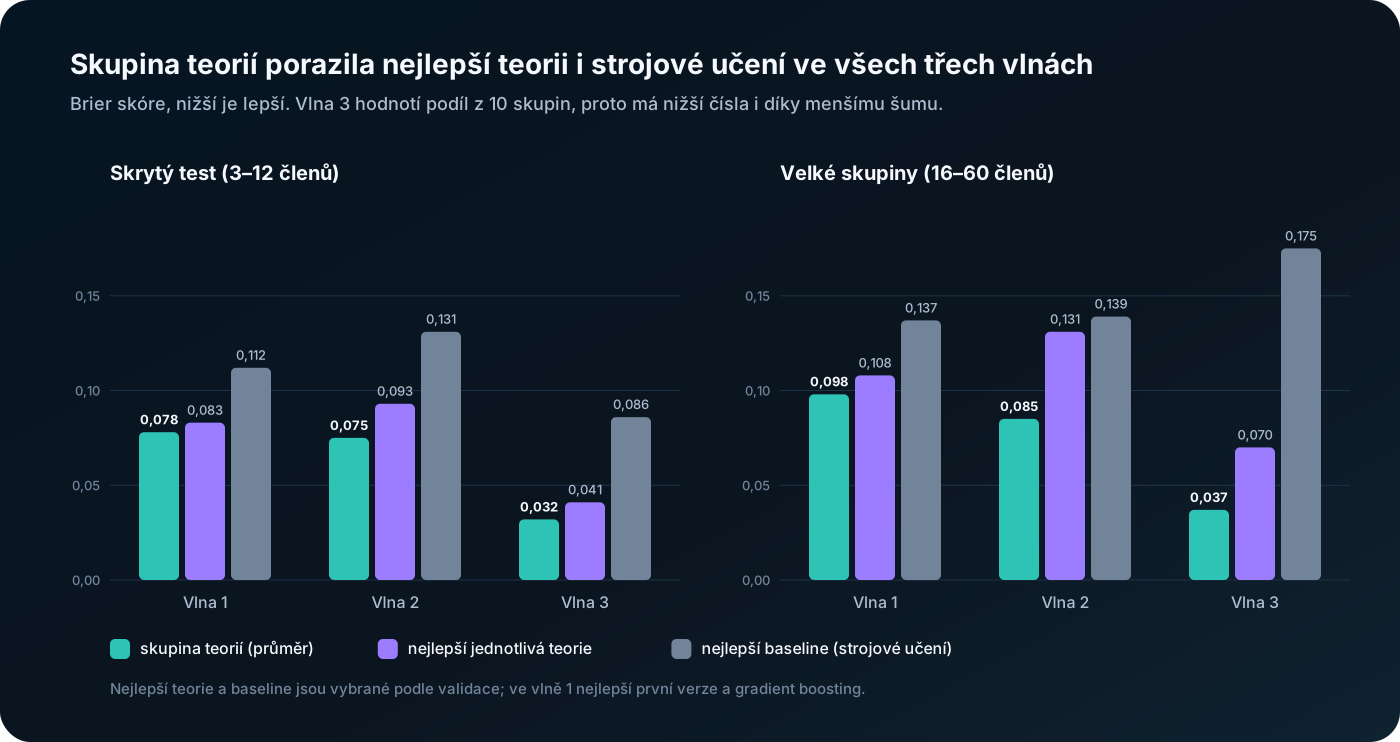
Důvod známe z kapitoly o moudrosti davu. Statistik, diverzita, sociální psycholog a minimalista se mýlili na různých místech, a průměr jejich chyby rušil. Kdyby všechny týmy dostaly stejné zadání, jejich chyby by byly víc korelované a výhoda by se zmenšila. Tuto hypotézu chceme otestovat příště.
2. Teorie zobecňují, napasované křivky ne
Odpověď laboratoře porazila nejlepší baseline ve všech třech vlnách. Největší náskok měla na velkých skupinách, které nikdo neviděl: ve třetí vlně 0,037 proti 0,175 u nejlepší baseline podle validace a proti 0,090 u gradient boostingu.
Mechanismus jako „chyba průměru se zmenší na √(ρ + (1 − ρ) / n)“ platí pro skupinu o 50 lidech stejně jako o 5. Přímka napasovaná na skupiny o 3 až 12 členech mimo svůj rozsah nedává smysl. Proto potřebujeme teorie, ne jen data.
3. Iterace funguje jen s přesným soudcem
V prvních dvou vlnách revize škodily. Ve třetí vlně, s patnáctkrát méně šumu a s testovanými predikcemi, zlepšovaly a západka rozhodovala správně v 7 z 8 případů.
To je možná nejobecnější ponaučení celého experimentu. Úzkým hrdlem smyčky „navrhni, ověř, oprav“ není model, ale kvalita zpětné vazby. Model, který dostává hlučné hodnocení, se učí z náhody.
4. Západka je nutná i s dobrým soudcem
I ve třetí vlně byla druhá revize většinou horší než první. Model po zpětné vazbě raději přestaví celou teorii, než by ji opatrně zpřesnil. Bez západky by se dobré revize ztratily pod špatnými.
5. AI umí objevit skryté mechanismy, kapacitní limity jsou nejtěžší
Týmy našly většinu pravidel simulátoru, některá včetně přesných konstant: 0,3 × nerovnost, 0,5 + 0,5 × demonstrovatelnost, 6 mluvčích, strop úspěšnosti 0,95. Nejhůř odhadovaly limity, které se projeví až u velkých skupin: počet kousků znalostí a počet poradců vůdce. Z dat o malých skupinách se poznat skoro nedají.
6. Falzifikovatelné predikce mají cenu
Tři vyvrácené predikce patřily slabším verzím teorií. Predikce dávají soudci druhý, nezávislý kanál: nehodnotí jen čísla, ale i to, jestli teorie říká pravdu o konkrétních situacích. A nutí ji říct něco, co může neplatit.
7. Infrastruktura je polovina výzkumu
Zaseknutá volání, useknuté odpovědi, chyba sandboxu a možný únik dat ze skrytých testů: každá z těchto drobností mohla zkreslit výsledek. Bez záznamu konfigurace a možnosti pokračovat po přerušení by výsledky nešlo zopakovat ani ověřit.
Odpověď simulovaného světa na naši otázku
Na 4 500 podmínkách jsme změřili, jak jednotlivé faktory ovlivňují šanci skupiny porazit nejlepšího člena:
| Faktor | Nízká hodnota (0–0,25) | Vysoká hodnota (0,75–1) |
|---|---|---|
| Korelace chyb | 81 % | 36 % |
| Nerovnost kompetence | 80 % | 47 % |
| Demonstrovatelnost | 47 % | 73 % |
| Viditelnost kompetence | 53 % | 68 % |
Skupina tedy porazí svého nejlepšího člena, když:
- chyby a mezery ve znalostech členů nejsou korelované,
- kompetence nejsou příliš nerovné,
- jde rozpoznat správnou odpověď nebo je vidět, kdo je kompetentní,
- úloha vyžaduje skládat různé znalosti.
U hlavolamů skupina vyhrává v 68–94 % podmínek. U prostého hlasování o otázce se dvěma možnostmi jen v 10–21 %. Průměrná kompetence a velikost skupiny mají celkově jen malý vliv, v jednotlivých situacích ale velký: větší skupina pomáhá hlasování, diskusi naopak škodí.
Pozor: tato pravidla jsme do simulátoru vložili my, podle učebnic. Je to odpověď našeho modelu světa, ne nový objev o lidech.
Co to znamená pro AI agenty a pro lidské týmy
Stejná pravidla, která rozhodují, kdy skupina lidí porazí svého nejlepšího člena, rozhodují i o tom, kdy skupina AI agentů porazí nejlepšího agenta. Následující doporučení vycházejí z našeho experimentu a odpovídají i odborné literatuře.
Pro systémy s více AI agenty
- Různorodost místo klonů. Dejte agentům různé optiky, role nebo i různé modely. Klony se mýlí stejně, a hlasování ani průměr jim pak nepomůže. Naše čtyři optiky vytvořily skupinu, která porazila nejlepší teorii.
- Nezávislé návrhy, pak průměr. U číselných a pravděpodobnostních výstupů nechte agenty pracovat nezávisle a jejich odpovědi zprůměrujte. Společná debata vede ke stádnosti: agenti se přikloní k tomu nejpřesvědčivějšímu.
- Externí soudce. Testy, simulace, formální kontrola nebo měřitelná metrika. Nenechávejte modely, aby hodnotily samy sebe.
- Nejdřív přesné hodnocení, pak víc iterací. Hlučný hodnotitel dělá z iterací loterii. Do kvality ověření se vyplatí investovat dřív než do dalších kol.
- Západka. Změnu přijměte, jen když zlepší výsledek na datech, která agent neviděl, a to o rozumný kus. Vždy si držte nejlepší verzi.
- Ověřitelná tvrzení. Chtějte po agentech konkrétní tvrzení, která jde automaticky zkontrolovat, a kontrolujte je.
- Provoz. Omezte počet současných volání, zaznamenávejte konfiguraci a prompty a pište běhy tak, aby šly po přerušení dokončit.
Pro lidské týmy
- Když jde správnou odpověď předvést, třeba u výpočtu, kódu nebo testovatelné diagnózy, diskutujte. Stačí jeden člověk se správným řešením, pokud ho ostatní dokážou ověřit.
- U odhadů a úsudků, kde odpověď předvést nejde, sbírejte názory nezávisle před diskusí. Jinak se všichni ukotví u prvního čísla nebo u nejhlasitějšího. Na tomto principu stojí třeba plánovací poker v agilních týmech nebo metoda Delphi.
- Když víte, kdo je expert, nechte rozhodnout jeho po konzultaci s ostatními. Když to nevíte, je průměr nezávislých názorů bezpečnější než vůdce vybraný podle sebevědomí.
- Různé zkušenosti snižují korelované chyby. Tým lidí ze stejné školy, kteří čtou stejné zprávy, sdílí i stejná slepá místa.
- Na velké poradě většina znalostí nezazní. Sbírejte unikátní informace písemně předem a ptejte se každého, co ví jen on.
- Hlasování o záludných otázkách chybu zesílí. Kde může většina naletět na zavádějící intuici, nerozhodujte prostou většinou.
Omezení: co experiment neprokazuje
Experiment ukazuje, že AI dokáže objevovat a zpřesňovat teorie skrytého systému. Neukazuje nic nového o skutečných lidech a má několik slabin, o kterých je fér vědět.
- Svět je náš model. Pravidla simulátoru jsme vzali z učebnic. Týmy mohly objevit jen to, co jsme do něj vložili.
- Každá vlna je jeden běh na jiných datech. Rozdíly mezi vlnami mohou zčásti plynout z dat a ze štěstí týmů. Potřebujeme víc opakování.
- Třetí vlna změnila několik věcí najednou. Přesnější cíl, testované predikce ve zpětné vazbě a ochrana skrytých dat přišly současně. Zatím nevíme, která změna zlepšení revizí způsobila.
- Týmy mají náskok ve znalostech. Model zná Condorceta i Laughlina, baseliny ne. Srovnání ukazuje hodnotu předchozích znalostí a mechanismů, ne obecnou převahu jazykových modelů nad strojovým učením.
- Predikce mohou být opatrné. 92% úspěšnost je dobrá zpráva jen tehdy, když predikce něco riskují. To zatím neměříme.
- Malé vzorky. Každá sada má 300 podmínek, takže rozdíly kolem 0,01 Brier skóre jsou často v šumu. Proto u klíčových srovnání uvádíme 95% intervaly spolehlivosti z bootstrapu.
- Jeden model. Všechny týmy běžely na Claude Opus 5.5. Jiné modely, nebo jejich směs, se mohou chovat jinak.
Co dál
Nejbližším krokem je zjistit, co přesně ve třetí vlně zlepšení způsobilo. Pak chceme laboratoř pustit na svět, který jsme sami nenaprogramovali.
- Ablace třetí vlny. Stejnou laboratoř pustíme dvakrát: jednou bez testovaných predikcí ve zpětné vazbě a jednou s jedinou skupinou na podmínku. Ukáže se, jestli revize zlepšil přesnější soudce, nebo predikce. Odhadem 2 × 20 dolarů.
- Perspektivy proti neutrálním agentům. Čtyři různé optiky, čtyři neutrální agenti a jeden agent se stejným rozpočtem. Pokud máme pravdu, že síla průměru teorií pramení z různých chyb, neutrální agenti budou mít chyby víc korelované a jejich průměr bude slabší.
- Rozlišující experimenty. Po prvních teoriích laboratoř najde podmínky, kde se jejich předpovědi nejvíc rozcházejí, nasimuluje je a výsledky vrátí týmům. Část rozpočtu připadne na náhodný výběr jako kontrolu.
- Odvaha predikcí. Změříme, jak velkou část prostoru predikce zakazuje, a odvážné predikce, které platí, budeme odměňovat víc než opatrné.
- Víc opakování. Několik běhů každé verze na různých datech, aby se dalo oddělit štěstí od schopnosti.
- Skutečné skupiny. Simulované členy nahradíme skupinami AI agentů, které řeší skutečné úlohy: odhady, logické hádanky, faktické otázky. Svět pak nebude náš model a teorie mohou objevit něco, co do něj nikdo nevložil. Později by šlo zapojit i skupiny lidí, s informovaným souhlasem a etickým dohledem.
- Filozofie. Stejná smyčka jde použít i na filozofické argumenty. Formální logika ověří, jestli závěr z premis opravdu plyne. Pravdivost premis ovšem žádný soudce neověří, a právě o ní se ve filozofii obvykle vede spor. AI by tu mohla aspoň systematicky odhalovat skryté předpoklady, ze kterých jednotlivé závěry vyplývají.
Experiment v číslech
| Položka | Hodnota |
|---|---|
| Vlny experimentu | 3, k tomu doplnění první vlny |
| Týmy AI | 4, model Claude Opus 5.5 (claude-opus-5-5) |
| Verze teorií | 36: 4 týmy × 3 verze × 3 vlny |
| Volání modelu | 41, z toho 4 zaseknutá, všechna v první vlně |
| Celková doba běhu | 358 minut, tedy zhruba 6 hodin |
| Cena podle ceníku | 63,43 USD: 18,21 + 24,67 + 20,55 |
| Podmínek v jedné vlně | 900 až 1 200 |
| Úloh pro každou skupinu | 2 000 |
| Skupin na podmínku ve třetí vlně | 10 |
| Testovaných predikcí | 36, z toho 33 platilo |
| Nejlepší výsledek | Brier 0,032 na testu a 0,037 na velkých skupinách (třetí vlna) |
Všechna data, teorie a grafy najdete v interaktivním reportu.
Slovníček pojmů
- Baseline: srovnávací model strojového učení bez teorie, například gradient boosting.
- Brier skóre: průměrná čtvercová chyba předpovězené pravděpodobnosti. 0 je dokonalá předpověď, 0,25 házení mincí.
- Bootstrap a 95% interval spolehlivosti: opakované převzorkování dat. Když interval rozdílu nezahrnuje nulu, je rozdíl statisticky významný.
- Demonstrovatelnost: jak snadno ostatní poznají, že je vyslovená odpověď správná.
- Extrapolace: předpověď mimo rozsah dat, ze kterých se model učil.
- Falzifikovatelná predikce: tvrzení, které může experiment vyvrátit.
- Korelace chyb: jak moc se členové skupiny mýlí stejně.
- Lean: program pro formální ověřování matematických důkazů.
- p_beats: podíl skupin, které porazily svého nejlepšího člena.
- Sandbox: izolované prostředí, kde kód teorie běží bez přístupu k souborům a síti.
- Validace: data, podle kterých se rozhoduje o přijetí revize. Tým je nikdy nevidí.
- Západka: pravidlo, které přijme změnu jen tehdy, když prokazatelně zlepší výsledek.