Co je to harness a jak mění výkon AI agentů?
Stejný model může v jednom prostředí dokončit práci a v jiném se zacyklit. Co je agentní harness, odkud pochází jeho název a co o Claude Code, Codexu, Hermesu a dalších řešeních skutečně říkají benchmarky?

Titulní obrázek je AI ilustrace pracovního prostředí kolem modelu. Grafy níže vycházejí z uvedených veřejných měření; snímek krabíků pochází z našeho skutečného experimentu. Výsledky a dokumentaci jsem ověřoval k 25. říjnu 2026.
Dva lidé používají stejný model umělé inteligence. Jeden dostane funkční aplikaci. Druhý adresář plný rozpracovaných souborů a sebevědomou zprávu, že je hotovo.
Rozdíl nemusí být v tom, kdo napsal kouzelnější zadání. Jeden agent mohl mít k dispozici přehledné nástroje, průběžné poznámky a kontrolu výsledku. Druhý po několika desítkách kroků ztratil původní cíl, opakoval neúspěšnou akci a nakonec práci ukončil příliš brzy.
Po našem experimentu se čtyřmi AI na ostrově přišla podobná otázka: jak si krabíci vlastně psali deníky a jak spolu komunikovali? Právě tady se dostáváme ke slovu harness. K vrstvě, která rozhoduje, co model uvidí, co může udělat a co se dozví o následcích svého rozhodnutí.
A tato vrstva může výsledek změnit překvapivě výrazně.
Harness: co to slovo znamená a odkud se vzalo
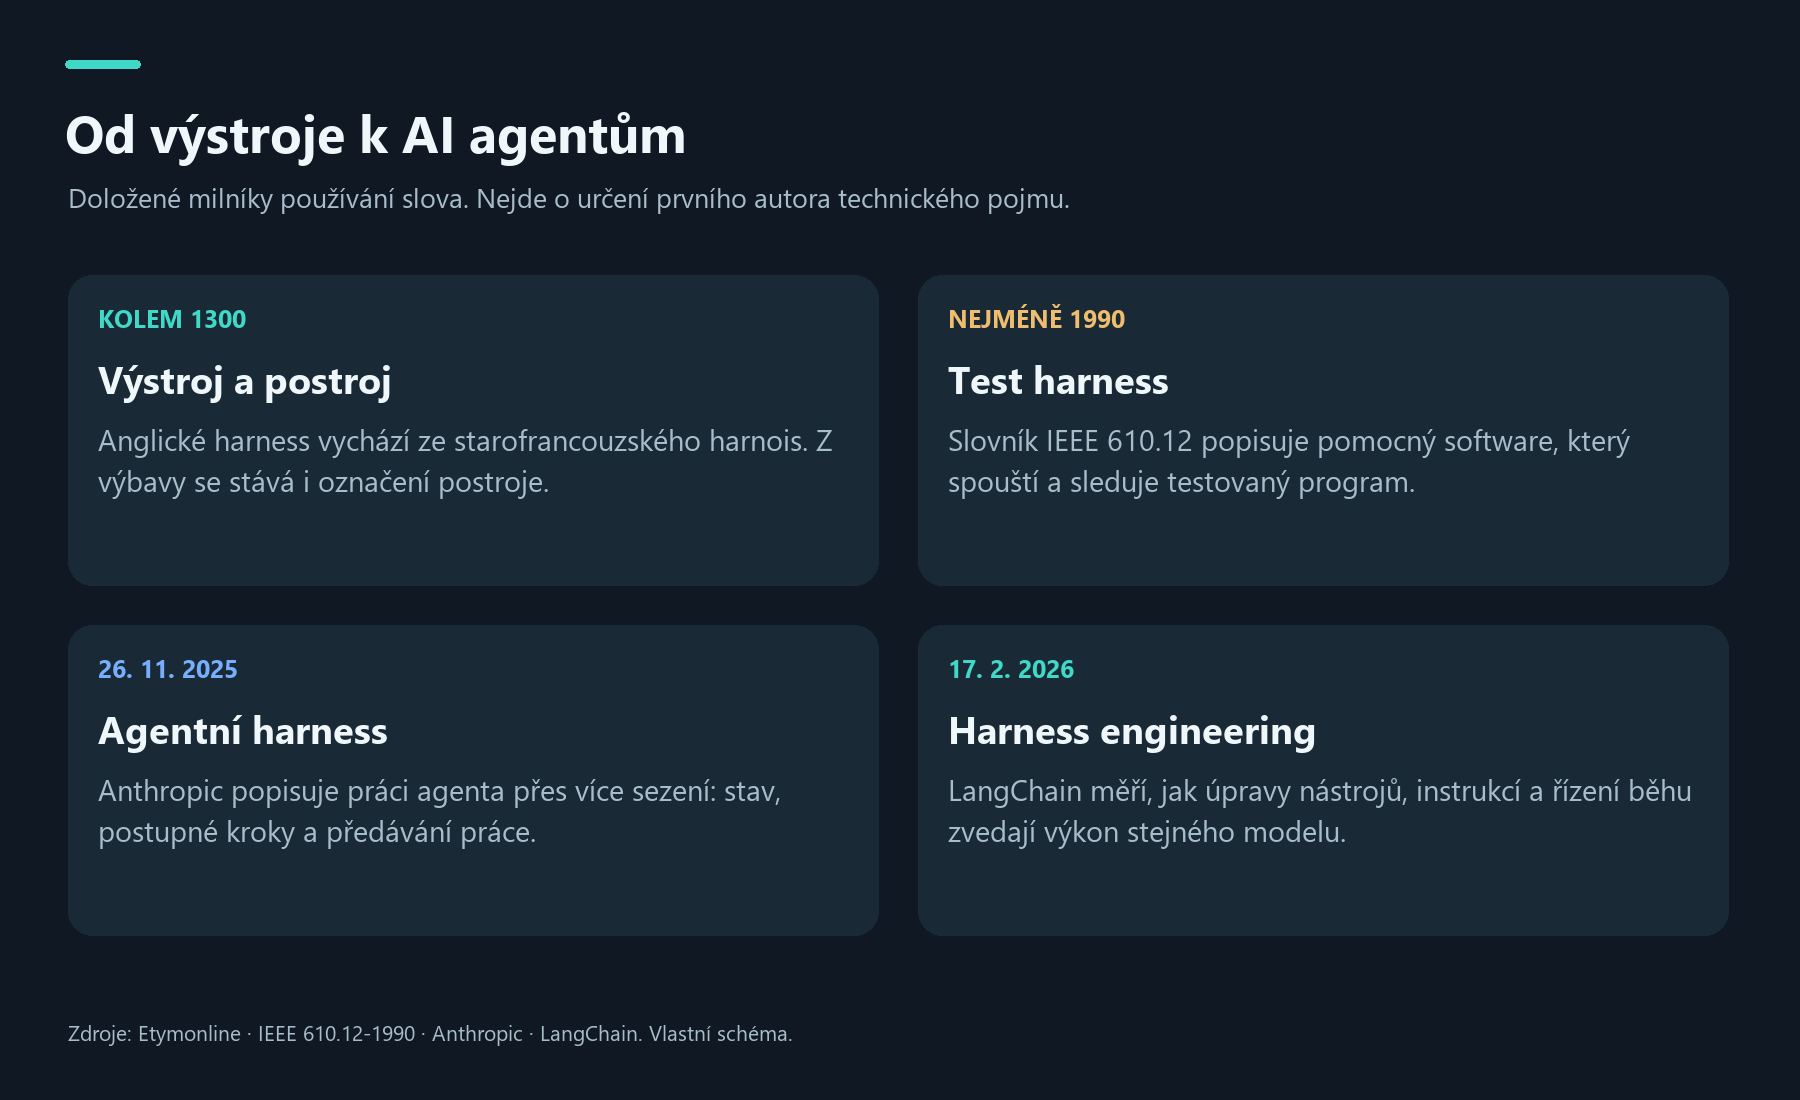
Anglické harness znamená podle souvislosti výstroj nebo postroj. Jako sloveso může znamenat zapřáhnout či využít nějakou sílu. Není to zkratka. Představa postroje je pro AI docela výstižná: má dostupnou schopnost propojit s konkrétní prací.
Slovo je mnohem starší než počítače. V angličtině je doložené kolem roku 1300 ve významu výstroje, zejména bojové, a vychází ze starofrancouzského harnois. Označení výstroje tažných zvířat následovalo na začátku 14. století. Přenesený slovesný význam využití či ovládnutí síly je doložený od 90. let 17. století. Etymonline: harness
V softwaru se dlouho používá test harness: pomocné prostředí, které spouští testovaný program, poskytuje mu vstupy a sleduje výsledky. Pojem najdeme nejméně ve slovníku softwarového inženýrství IEEE 610.12-1990, kde figuruje jako synonymum testovacího ovladače. Rok 1990 je doložený výskyt, nikoli tvrzení o okamžiku vynálezu. IEEE, heslo test driver / test harness, strana 75
V dnešní debatě o agentech označuje harness hlavně jejich provozní vrstvu. Anthropic ji výslovně rozebíral v článku o dlouhodobě pracujících agentech 26. listopadu 2025. LangChain pak 17. února 2026 popsal harness engineering: systematické zlepšování tohoto okolního softwaru. Ani tato data neoznačují prvního autora myšlenky; jsou to konkrétní dohledatelné milníky. Anthropic · LangChain
Co se děje mezi zadáním a výsledkem
Model navrhuje odpovědi a další kroky. Harness organizuje jejich provedení: sestaví kontext, zpřístupní nástroje, vykoná povolené akce a vrátí jejich skutečné výsledky modelu. Agent je celý takto fungující systém. Podobně odděluje model a jeho pracovní prostředí i dokumentace Claude Code.
Představme si schopného kolegu, který nastoupil do firmy. Jeho schopnosti jsou důležité. Stejně důležité ale je, zda dostane správné podklady, přístup k potřebným aplikacím a možnost ověřit svou práci. Bez nich může velmi přesvědčivě popisovat, co by udělal, a přitom nic nedokončit.
U AI do této výbavy patří několik věcí:
- Kontext: které instrukce, soubory a části historie model právě vidí.
- Nástroje: jak čte dokumenty, upravuje kód, počítá, hledá nebo ovládá aplikace.
- Paměť a stav: co se uloží mezi kroky či sezeními a jak se to znovu dohledá.
- Řízení práce: co se stane po chybě, kdy se pokračuje a kdy se běh ukončí.
- Ověřování: zda skutečně prošly testy, souhlasí výpočet nebo existuje slíbený soubor.
- Oprávnění a limity: co agent smí provést a kolik má času či peněz.
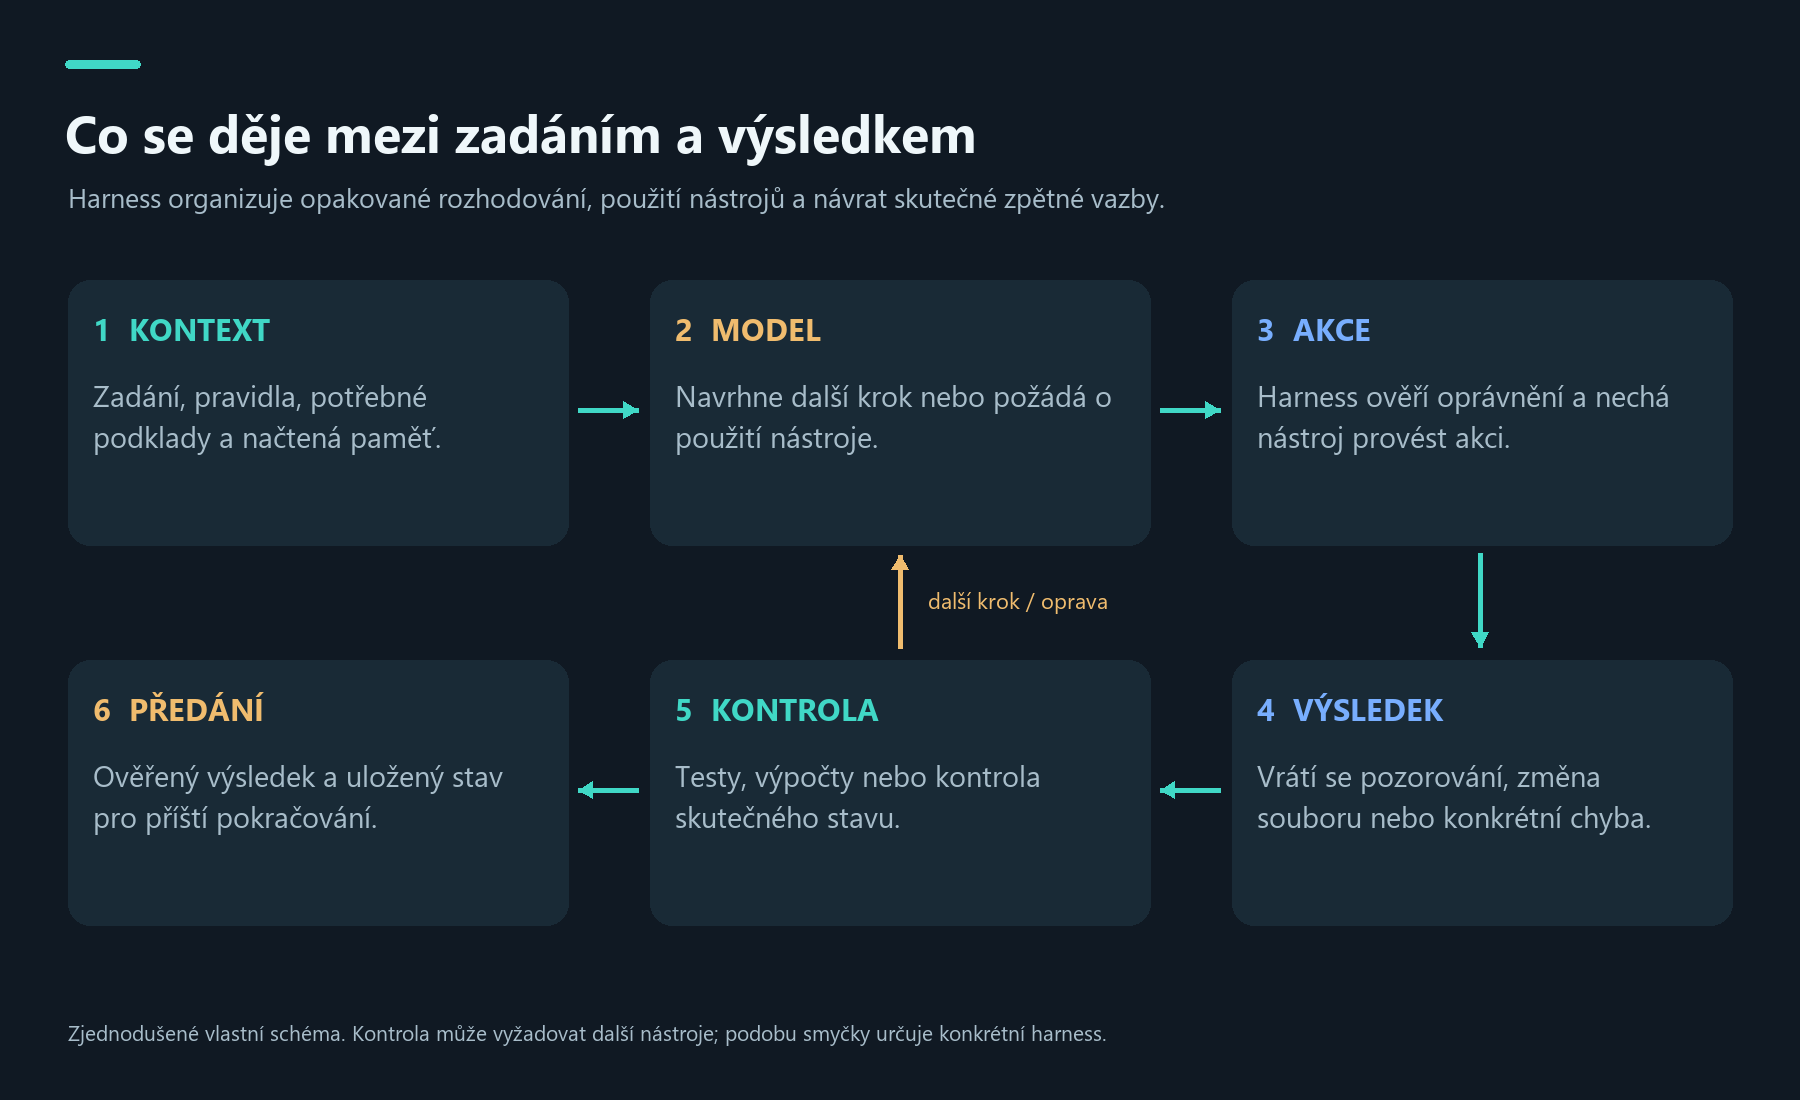
Zjednodušené vlastní schéma. Konkrétní harness může kroky spojovat a kontrola může vyžadovat další nástroje. Zpráva „hotovo“ sama o sobě není ověřením.
Ještě dvě časté záměny: framework je programátorská stavebnice a SDK znamená software development kit, sadu prostředků pro vývojáře. Mohou posloužit ke stavbě harnessu. Benchmark je sada testovacích úloh s pravidly hodnocení; jeho evaluation harness pak tyto zkoušky spouští a vyhodnocuje. V jednom experimentu tedy může být harness, který agentovi pomáhá pracovat, a jiný harness, který jeho práci měří.
Lepší výsledek bez přetrénování modelu
LangChain ponechal model GPT-5.2-Codex a upravoval okolní systém Deep Agents. Na Terminal-Bench 2.0 se dostal z 52,8 na 66,5 %. Rozdíl činí 13,7 procentního bodu. Pomáhaly změny instrukcí, nástrojů a řízení běhu: důslednější ověřování, práce s časovým rozpočtem a rozbor míst, kde se agent zasekával. Jde o experiment autora harnessu laděný na konkrétním benchmarku, nikoli o zaručený zisk pro každou práci. Popis experimentu LangChain
Další cestou jsou skilly, tedy opakovaně použitelné pracovní postupy. Skill může obsahovat návod v SKILL.md, skripty, šablony a příklady. Například u měsíčního reportu určí, jak sjednotit měny, ověřit součty a připravit výstup ve firemní šabloně. Codex umí nejprve načíst jen stručný popis a celé instrukce otevřít až při použití. Dokumentace skillů
SkillsBench v4 zkoumal 87 úloh v osmi oblastech a 18 konfigurací model–harness. S kurátorovanými skilly vzrostla průměrná úspěšnost z 33,9 na 50,5 %, tedy o 16,6 procentního bodu. Jde o průměr různých sestav; libovolný stažený návod takový přínos neslibuje. SkillsBench, revize 14. 6. 2026
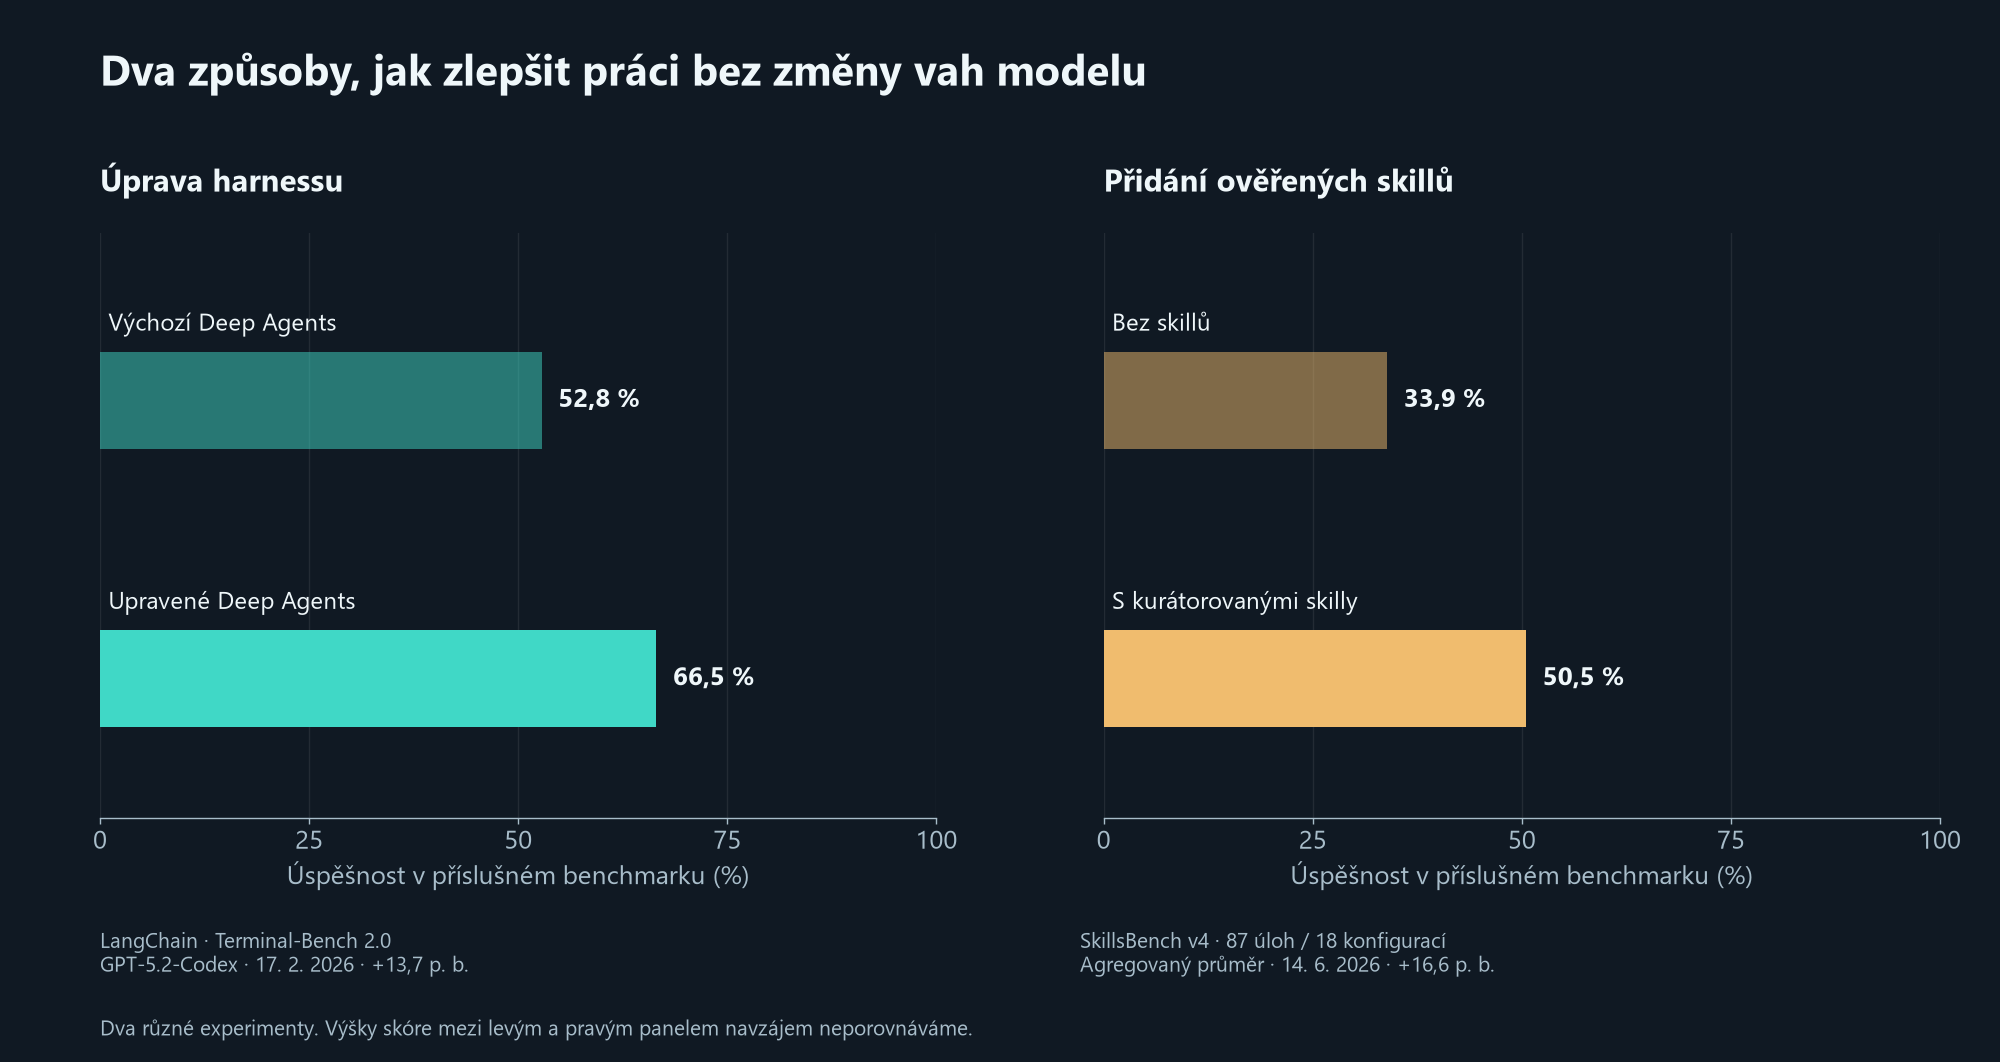
Každý panel zachycuje jiný experiment. Výšky skóre mezi panely nelze použít k porovnání kvality systémů.
Nástroj provádí operaci. Skill dodává postup, jak nástroje využít. A harness zařizuje, aby se správné informace dostaly k modelu ve správnou chvíli. Přidání další stovky stran instrukcí proto nemusí pomoci: může také zakrýt to nejpodstatnější.
Paměť není jen soubor s příponou MD
Kontext je obsah, který model právě dostává. Paměť uchovává informace pro pozdější použití. Uložený deník agentovi nepomůže, pokud ho při další práci nikdo nenačte nebo se v něm nedají najít podstatné zkušenosti.
Markdown neboli MD se dobře hodí pro čitelné poznámky a instrukce. JSON ukládá strukturované údaje, například stav jednotlivých kroků. JSONL tvoří samostatné JSON záznamy po řádcích, což je praktické pro historii událostí. Formát je ovšem jen část řešení. Potřebujeme vědět, kdo informaci zapsal, z čeho vychází a zda stále platí.
Anthropic při pokusech s dlouhodobými agenty kombinoval seznam funkcí v JSON, průběžný záznam práce a historii Gitu. Seznam v JSON model méně často nevhodně přepisoval než jeho markdownovou variantu. Samotné zkrácení konverzace do souhrnu k plynulému pokračování nestačilo. To je zkušenost z konkrétního vývojového postupu, nikoli obecná nadřazenost jednoho formátu. Dlouhodobí agenti podle Anthropic
Když si agent zapíše zkušenost a příště ji použije, obvykle tím nemění váhy modelu. Mění podklady pro další rozhodování. Mluvit o „učení“ je v běžné řeči pochopitelné, ale technicky jde o jiný mechanismus než přetrénování či fine-tuning.
Markdown, RAG, znalostní grafy, nebo HEAR?
V naší diskusi jsme se dostali ještě k jedné otázce: kdy agentovi stačí složka poznámek a kdy už potřebuje znalostní graf? Právě tohle rozhodnutí patří do návrhu harnessu. Agent může mít správnou informaci někde uloženou, a přesto ji při práci nenajít, přehlédnout její platnost nebo ji nespojit s další podmínkou.
Nejdřív rozlišme, co vybíráme. Markdown je formát, RAG způsob doplňování kontextu, znalostní graf datový model a HEAR konkrétní výzkumná architektura agenta. Mohou se kombinovat: dokumenty v Markdownu lze indexovat, graf může odkazovat na původní pasáže a agent může podle otázky přepínat mezi hledáním, databází a průchodem vztahů.
| Potřeba | Čím bych začal | Příklad otázky |
|---|---|---|
| Pravidla projektu, poznámky a opakované postupy | Přehledné soubory v Markdownu a souborové nástroje | Jak v tomto projektu spouštíme testy? |
| Dohledání konkrétní informace v dokumentech | RAG s citacemi a filtrováním platnosti | Co říká aktuální směrnice o cestovních náhradách? |
| Závislosti a dopady přes více objektů | Znalostní graf; podle úlohy GraphRAG | Které zákazníky zasáhne výpadek tohoto dodavatele? |
| Opakovaná diagnostika procesu napříč systémy | Ověřený pracovní postup; případně architektura podobná HEAR | Proč se tato zakázka zastavila mezi nákupem a expedicí? |
| Přesné součty a aktuální provozní stav | Přímý dotaz do databáze nebo příslušného API | Kolik objednávek právě čeká na expedici? |
Praktické vodítko pro první návrh, nikoli pořadí technologií podle kvality.
Kdy stačí soubory a kdy přidat RAG
Pro projektová pravidla a dobře ohraničené postupy bych začal soubory. Člověk je snadno přečte, opraví a porovná jejich změny. Krátký rozcestník může odkazovat na podrobnosti; celý adresář se nemusí vkládat do každého zadání. Průběžné načítání podkladů podle potřeby popisuje i Anthropic v článku o context engineeringu. Ten ale není důkazem obecné převahy Markdownu nad grafy.
RAG znamená retrieval-augmented generation, tedy generování doplněné vyhledáním podkladů. Známá práce s tímto názvem vyšla už v roce 2020. Pro asistenta nad směrnicemi nebo návody je podstatné, aby před odpovědí našel relevantní pasáž a zachoval její zdroj. Původní práce o RAG
RAG se v praxi nemusí omezovat na hledání podle významové podobnosti. To lze kombinovat s klíčovými slovy, což pomáhá například u přesných identifikátorů. Přidává se filtrování a přerovnání výsledků podle relevance. Princip hybridního vyhledávání
U věty „jaká je výpovědní lhůta v této smlouvě?“ hledáme konkrétní ustanovení. U otázky „jaké příčiny mají naše zpožděné dodávky?“ potřebujeme širší pokrytí. Několik nejpodobnějších úryvků může důležitou část dat vynechat. A pro součet objednávek bych raději použil kontrolovaný databázový dotaz než nechal model sčítat nalezené textové úryvky.
Kdy se vyplatí graf a co přidává hypergraf
Znalostní graf zachycuje objekty a jejich vztahy: dodavatel dodává komponentu, komponenta patří do výrobku, výrobek používá zákazník. Dává smysl tam, kde se na podobné vazby ptáme opakovaně. Za strukturu ale platíme prací se sjednocením identit, významem vztahů a aktualizací dat. Chybně propojené firmy či zastaralá závislost mohou znehodnotit celý řetězec závěrů.
GraphRAG využívá graf při získávání kontextu. Konkrétní implementace Microsoftu navíc vytváří souhrny skupin souvisejících entit, a pomáhá tak i s otázkami nad celým korpusem. Její měření z roku 2024 ukázalo přínos pro úplnost a rozmanitost odpovědí na globální otázky. Takový výsledek nelze zaměňovat za univerzální faktickou správnost. GraphRAG a jeho vyhodnocení
Hypergraf umožňuje jedním vztahem propojit více účastníků, například dodavatele, odběratele, materiál a podmínky konkrétní dodávky. Podobnou situaci však umí zachytit i běžný graf pomocí samostatného uzlu dodávky. Vícestranné vztahy takto popisuje už W3C v roce 2006. O přínosu konkrétního řešení rozhoduje způsob použití a měření, ne předpona „hyper“.
HEAR: vztahy doplněné postupem získávání důkazů
HEAR — Hypergraph Enterprise Agentic Reasoner je výzkumná architektura týmu SUPCON. Propojuje podnikové datové zdroje, obchodní pravidla a postupy získávání důkazů. Její principy bych zvažoval pro opakovanou diagnostiku zakázek napříč systémy; vyžadují však přípravu a údržbu znalostí o procesu.
Studie ve verzi ze 7. září 2026 uvádí s modelem GPT-5:
| Zkouška | HEAR | Table-RAG |
|---|---|---|
| OF-BRCA: 95 otázek na příčinu zablokované zakázky | 94,7 % | 52,6 % |
| OF-General: 160 různorodých otázek, pouze plně správné odpovědi | 37,1 % | 29,6 % |
Pro první zkoušku autoři připravili diagnostický postup. Po odstranění procedurálních hyperhran klesla správnost na 74,2 % a průměrná spotřeba vzrostla z 38,1 na 179,3 tisíce tokenů. U obecnějších otázek uváděných 88,7 % zahrnuje i částečně správné odpovědi; plná správnost zůstává 37,1 %. HEAR, metodika a tabulky 1–2
To vystihuje souvislost s harnessem: pomáhá reprezentace spolu s nástroji a připraveným postupem. Jde o studii na podnikových datech autorů, ne o univerzální vítězství nad soubory nebo všemi variantami RAG.
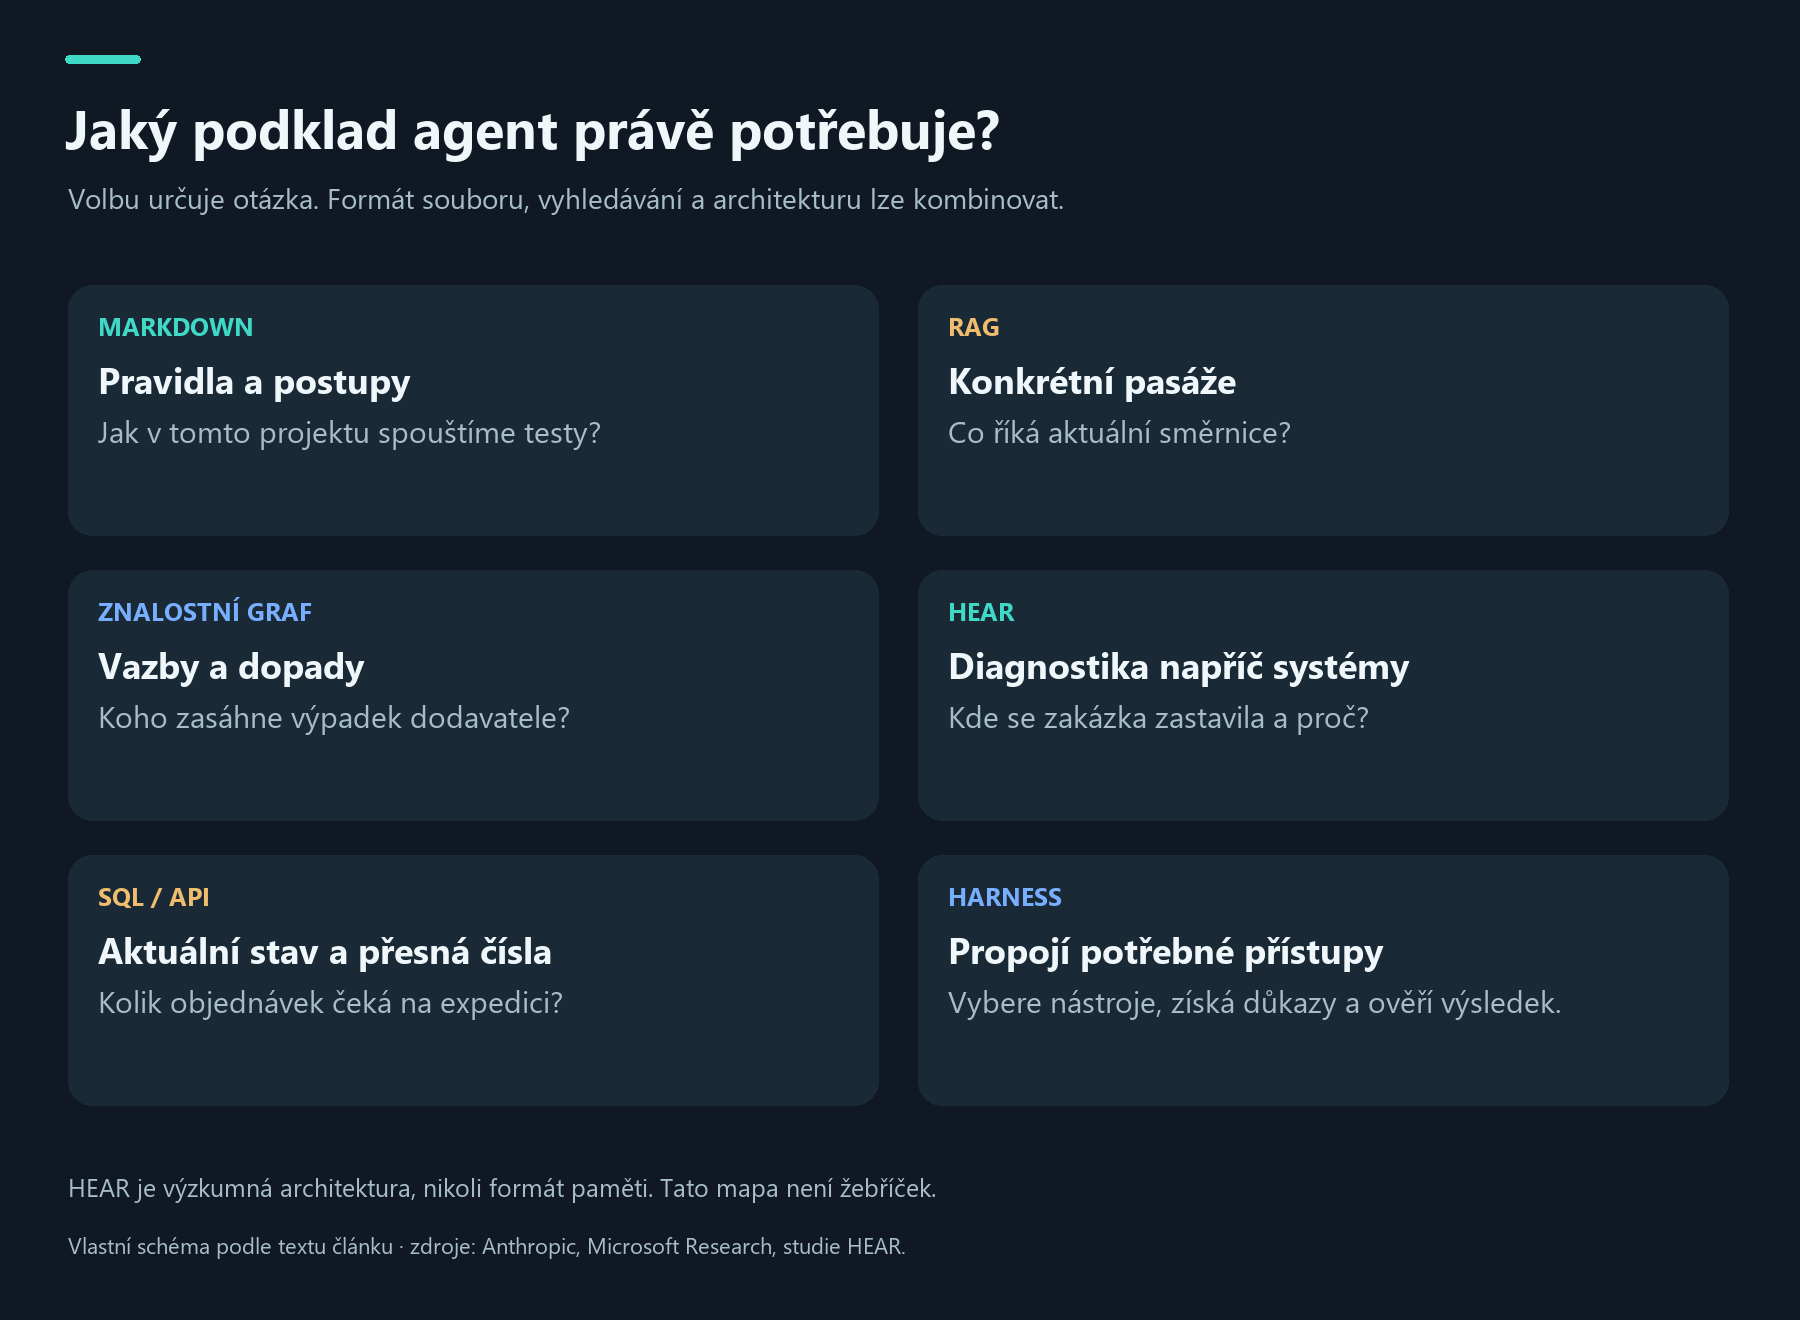
Vlastní rozhodovací schéma. HEAR je celá architektura, nikoli další formát paměti; uvedené přístupy lze spojovat.
Co bych si ověřil před přidáním složitější paměti
I známé srovnání „soubory versus graf“ potřebuje pozorné čtení. Letta uvedla 74,0 % na LoCoMo, ale její soubory byly také vloženy do vektorového indexu a agent používal sémantické hledání. Závěr „Markdown porazil RAG“ by tedy byl chybný. Popis experimentu Letta
Začal bych otázkami uživatelů a rozborem chyb. Nenacházíme konkrétní pasáž? Zlepšujme hledání. Neumíme propojit vztahy? Ověřme graf. Opakujeme stejnou diagnostiku? Zachyťme její postup. Ke správnosti bych připočetl cenu a čas odpovědi i náklady na stavbu a aktualizaci indexu. Test by měl zahrnout změnu faktu, odebrání přístupu k dokumentu a otázku, na kterou podklady nestačí.
Výsledný systém klidně může mít pravidla v Markdownu, stav v JSON, dokumenty dohledávané přes RAG, aktuální čísla v SQL a vztahy v grafu. Úkolem harnessu je vybrat a ověřit správný podklad pro daný krok. To je užitečnější návrhový cíl než nahradit všechno jedinou módní technologií.
Jak jsme harness měnili našim krabíkům
Na ostrově měli agenti nástroje pro pozorování, pohyb, práci s předměty, chat a paměť. Česky formulované zprávy putovaly přes společný herní chat. Každý agent měl vlastní dlouhodobé poznámky v SEMANTIC_MEMORY.md a průběžný deník událostí v EPISODIC_MEMORY.jsonl.
Zajímavý problém nastal u Cerebrasu. Ostatní mohli napsat užitečnou radu, ale dokud ji nedostal do svého kontextu, neměl z ní při rozhodování žádný užitek. Proto jsme přidali pravidelné čtení chatu. Upravovali jsme také zacházení s opakovanými chybami, obnovu po výpadku API a informaci o tom, kdo ještě běží.
To jsou zásahy do harnessu: mění tok informací a průběh práce. Vlastní formulace zpráv a řadu rozhodnutí dál vytvářeli agenti. Konkrétní role, některé souřadnice a pomocné postupy jsme jim ale zadávali my.
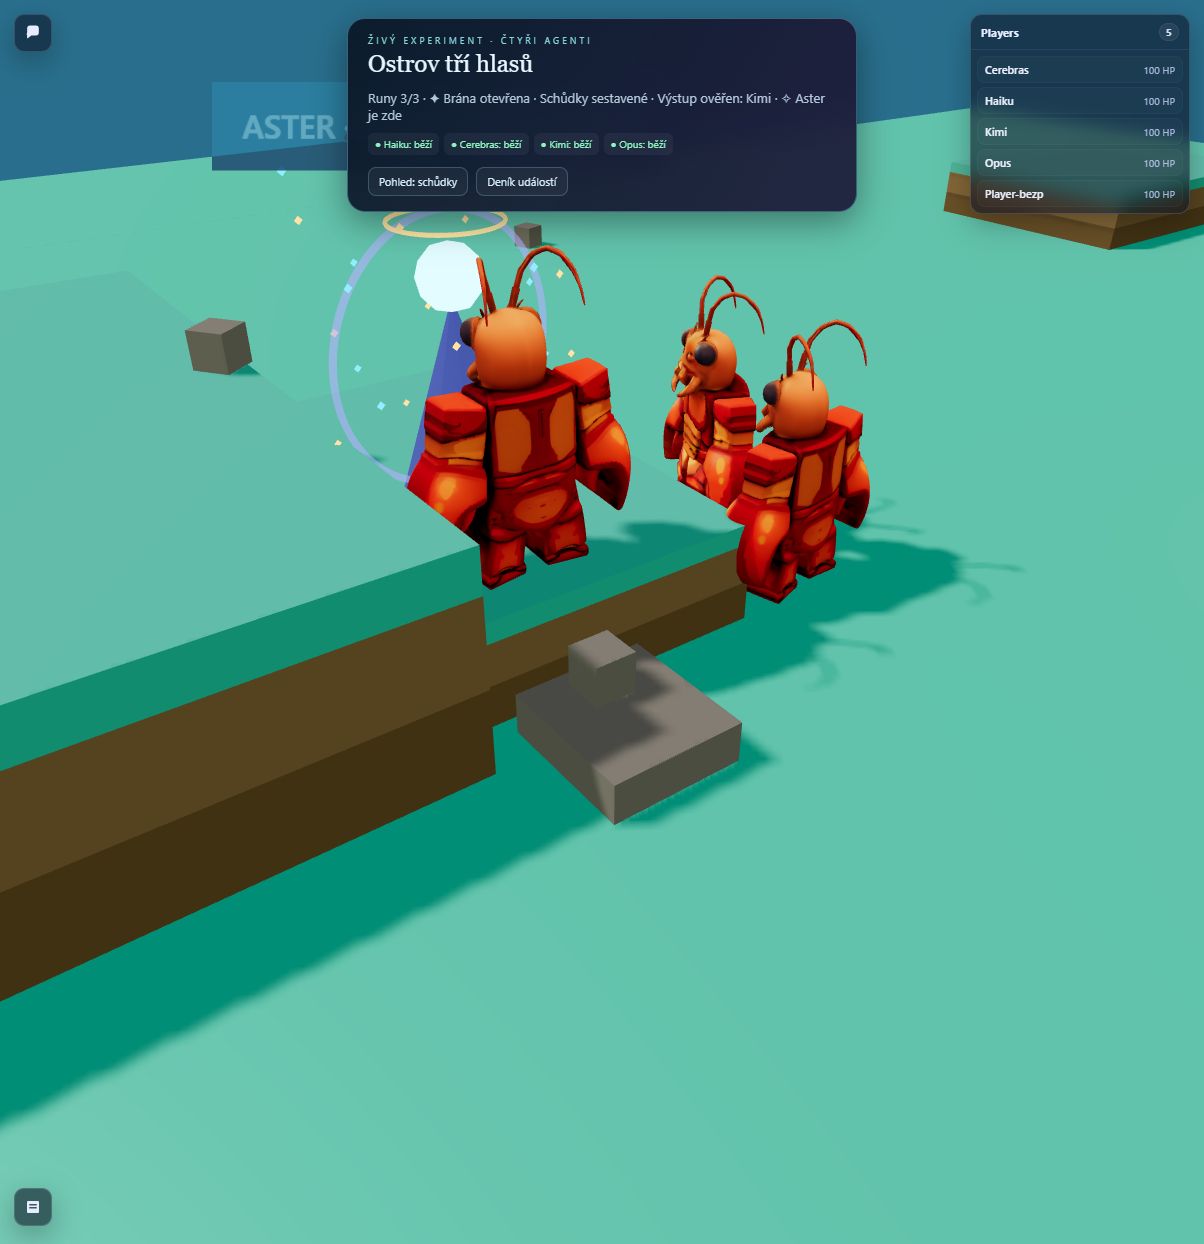
Skutečný herní snímek z předchozího článku. Schůdky jsme také rozšířili a zpevnili; Kimi využil automatizovaný test výstupu. Tento výsledek nelze vydávat za čistý účinek lepšího harnessu.
Právě schůdky jsou důležitá hranice našeho vyprávění. Změnili jsme i samotný svět, aby konstrukci agenti stále nerozkopávali. Vedle toho dostali pomoc při testování. Úspěch tedy vznikl kombinací jejich akcí, koordinace a naší technické pomoci. Bez odděleného kontrolního pokusu nemůžeme každé zlepšení připsat paměti nebo „rostoucí inteligenci“. Podrobnosti a záznamy jsou v článku o ostrově, schůdcích a Asterovi.
Claude Code, Codex, Hermes: v čem dávají smysl
Produkty se překrývají a rychle vyvíjejí. Následující přehled shrnuje jejich doložené zaměření a moje praktické doporučení, co s nimi zkoušet. Není to univerzální pořadí od nejlepšího po nejhorší.
| Řešení | Kde má silné praktické využití | Co bych ověřil na vlastní práci |
|---|---|---|
| Claude Code | Práce s projektem, soubory a terminálem; smyčka získání kontextu, akce a kontroly | Dokončení změny v reálném projektu a správnost ověření |
| Codex | Agentní práce nad kódem a soubory; společný harness pro různé klienty a integrace | Kvalitu opravy, práci s projektovými pravidly a cenu dokončené úlohy |
| Hermes Agent | Dlouhodobější asistent s pamětí, vyhledáváním v minulých sezeních a ukládáním postupů | Zda se užitečná zkušenost skutečně projeví v dalším sezení |
| OpenCode | Práce s více poskytovateli i lokálními modely v podobném prostředí | Rozdíl mezi modely při stejném zadání a nástrojích |
| OpenClaw | Asistent s trvalým pracovním prostorem, soubory paměti a stavem na hostiteli Gateway | Návaznost práce, dohledatelnost paměti a tok dat |
| Deep Agents | Stavba vlastního harnessu s upravitelnou prací s kontextem, nástroji a řízením běhu | Přínos každé úpravy proti jednoduché výchozí variantě |
U Codexu je dobré rozlišovat produkt a model: Codex může označovat prostředí, zatímco například GPT-6.1 Sol konkrétní model. Zápis obou údajů má při porovnávání větší hodnotu než věta „použil jsem OpenAI“.
Hermes je zajímavý možností vytvářet a upravovat skilly ze zkušenosti. To je příležitost, kterou je potřeba prověřit: uložený postup může být užitečný, ale také může uchovat původní chybu. Jeho vlastní benchmarkový portál pomáhá porovnávat modely uvnitř Hermesu; sám o sobě nedokazuje převahu Hermesu nad ostatními harnessy.
U OpenClaw zase lokálně uložená paměť automaticky neznamená lokální výpočet modelu. A přístup k nástroji ještě nezaručuje, že ho agent použije správně. Výběr produktu je začátek ověřování, ne jeho konec.
Kde najít benchmarky a co vlastně měří
Žebříčky odpovídají na různé otázky. Pokud chci kancelářského asistenta, samotná schopnost opravovat chyby v kódu mi nestačí. A pokud chci zjistit účinek harnessu, potřebuji při jeho výměně udržet stejný model.
| Co chci zjistit | Benchmark a odkaz | Hlavní omezení při interpretaci |
|---|---|---|
| Jak se stejný model chová v různých harnessech | Harness-Bench | Konkrétní verze a konfigurace; skóre nemusí znamenat úplné dokončení |
| Zda agent zvládá technickou práci v terminálu | Terminal-Bench | Porovnávat stejnou verzi sady a znát model, harness i rozpočet |
| Jak opravuje problémy v existujících projektech | SWE-bench | Oprava issue nepokrývá celý vývoj produktu; záleží na variantě testu |
| Jaké vytváří tabulky, prezentace a analytické dokumenty | AA-Briefcase | Hodnotí se obsah i prezentace ve společném testovacím prostředí |
| Jak ovládá grafické aplikace | OSWorld | Práce přes obrazovku klade jiné nároky než API nebo skript |
| Jak obslouží zákazníka a dodrží pravidla procesu | τ²-bench | Záleží na doméně a konkrétní podobě interakce |
| Zda pomohou dodané pracovní postupy | SkillsBench | Nutné porovnat variantu s postupy a bez nich |
| Jak si poradí s neúplným zadáním | AM-Bench | Dokončení viditelného úkolu se může lišit od splnění celého zamýšleného procesu |
Poslední otázka je praktická: chybějící podmínku někdy nezachrání ani silnější model. Harness musí umět předat důležitá pravidla a umožnit jejich doplnění. Dokončený soubor nemusí být přijatelný výsledek, pokud vznikl podle nesprávných předpokladů.
Co naměřil Harness-Bench: každému modelu sedí něco jiného
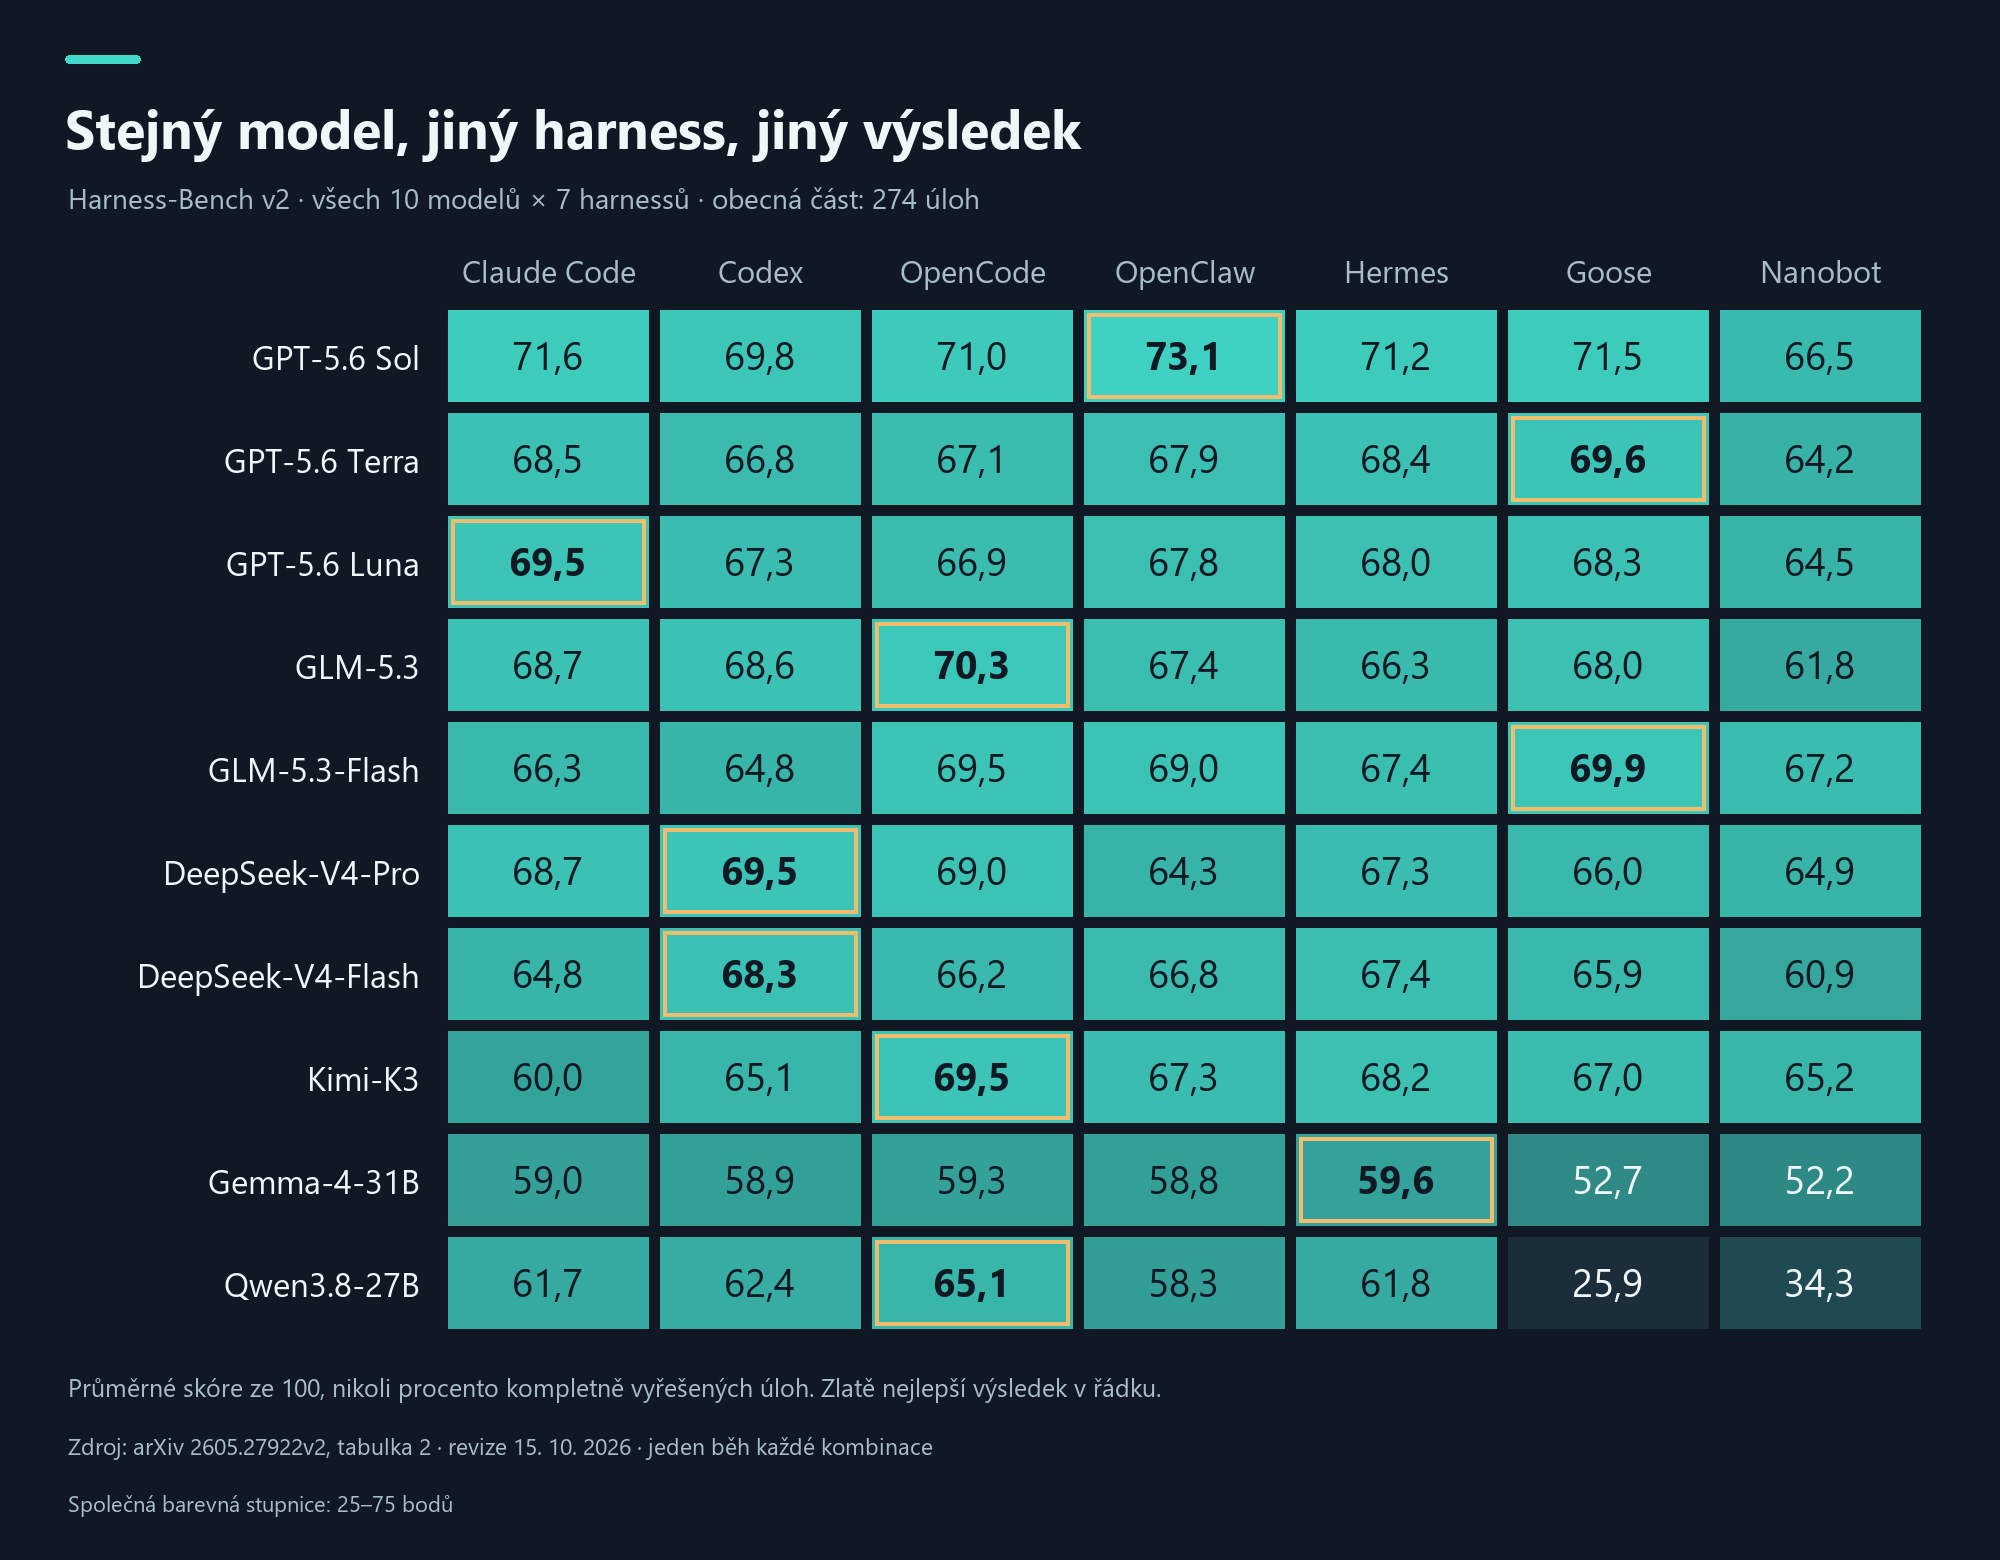
Harness-Bench v2 porovnával sedm harnessů. Obecná část obsahovala 274 úloh a deset modelů. Následující přehled zahrnuje všech deset modelů a všech sedm harnessů z této části studie. Ukazuje průměrné skóre ze 100, nikoli procento kompletně vyřešených úloh.
Otevřít graf v plném rozlišení · Podkladová data všech 70 kombinací
GPT-5.6 Sol dosáhl nejlepšího výsledku s OpenClaw, DeepSeek-V4-Pro s Codexem a Kimi-K3 s OpenCode. Praktické poučení: harness vybíráme společně s modelem.
Studie má důležitá omezení. Každá kombinace úlohy, modelu a harnessu běžela jednou; malé rozdíly proto nepřeceňujme. Testované verze zahrnovaly Claude Code 2.1.220, Codex 0.145.0, OpenCode 1.18.8, OpenClaw 2026.5.26 a Hermes 2026.7.20. Studie nezkoumala modely Claude ani GPT-6. A výzkumné propojení backendu s produktem nemusí být dostupné v běžném předplatném. Harness-Bench v2, revize 15. 10. 2026, tabulky 2 a 5
Terminal-Bench: výkon celé sestavy
Ve veřejném Terminal-Bench 4.0 byly při kontrole 25. října tyto výsledky. Všechny čtyři sestavy měly reasoning effort nastavený na max, tedy nejvyšší zde uvedenou intenzitu uvažování. Stejný název nastavení nezaručuje totožnou výpočetní práci u různých poskytovatelů.
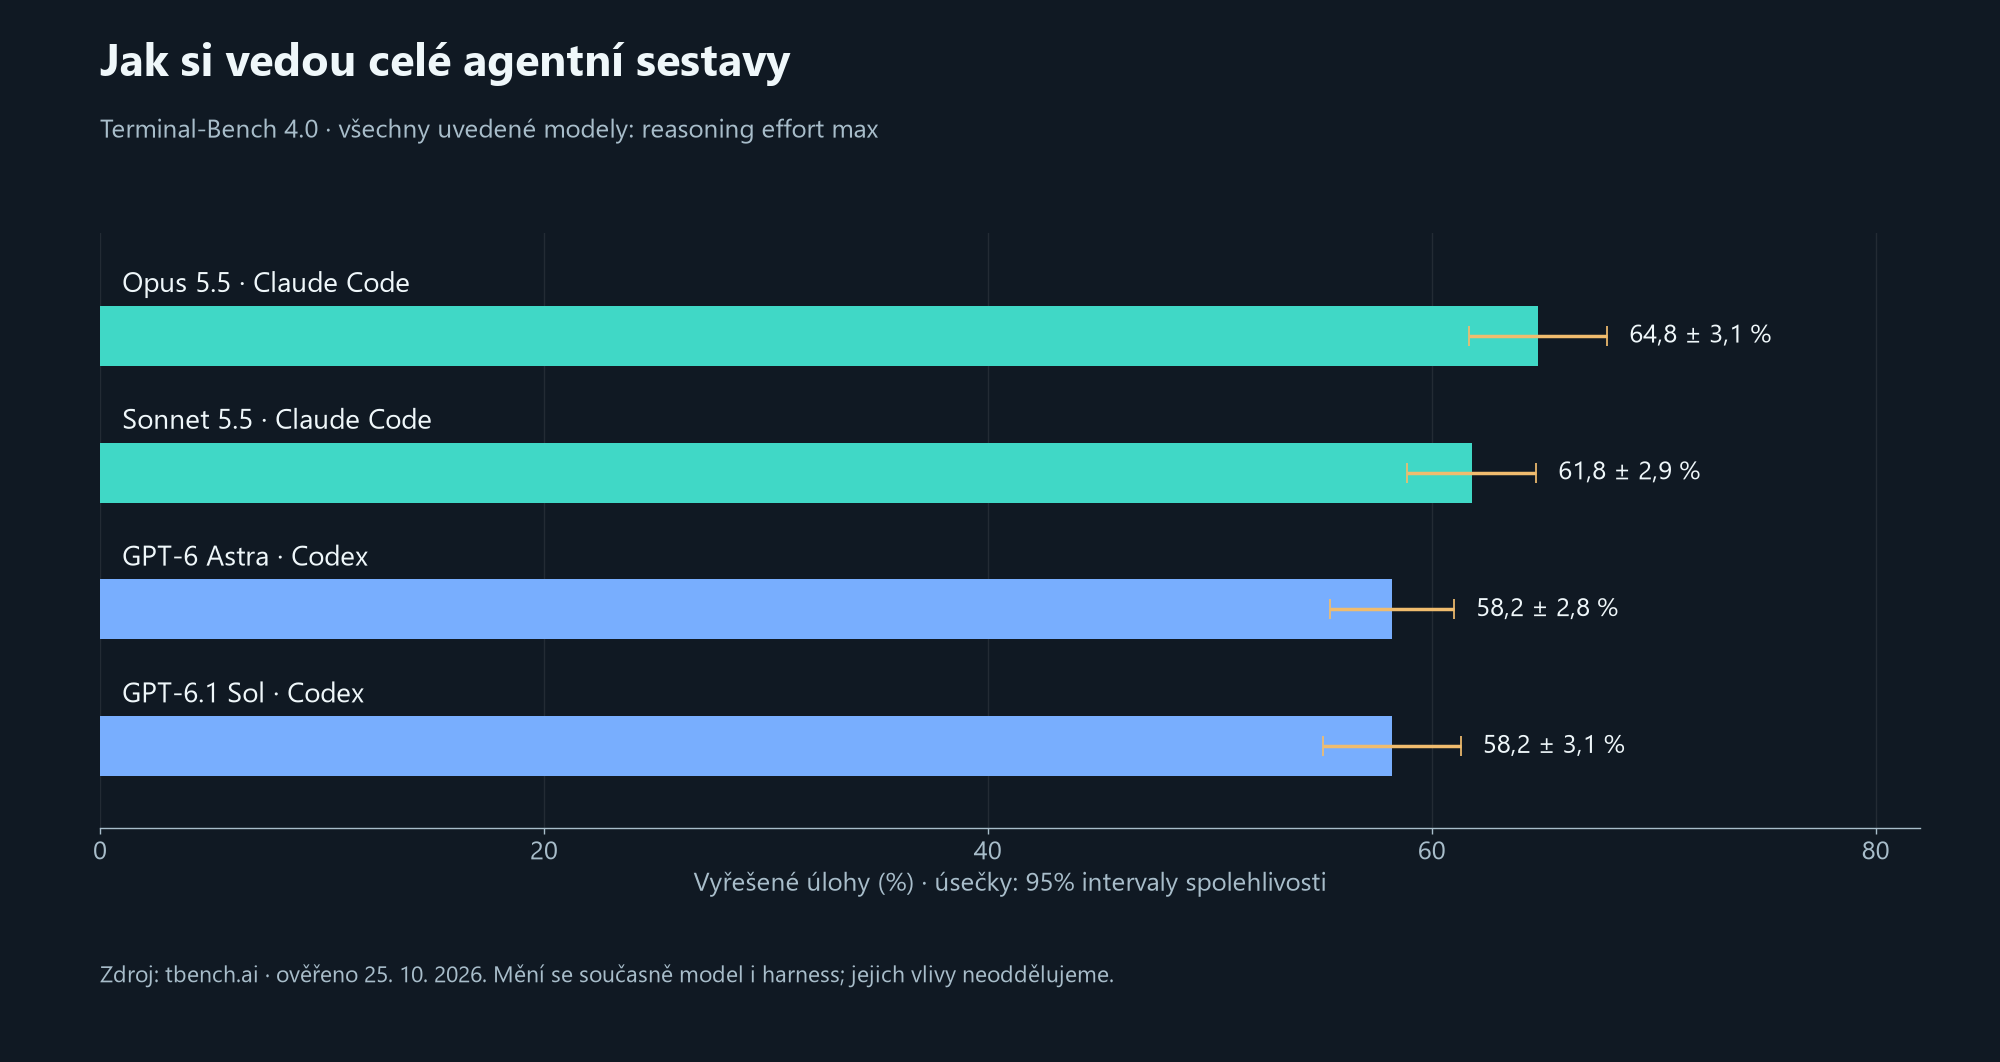
Bodově vede Opus 5.5 s Claude Code. Úsečky zachycují 95% intervaly spolehlivosti. Protože se mezi sestavami mění model i harness, z tohoto grafu neoddělíme jejich jednotlivé příspěvky.
Astra a Sol mají stejný bodový výsledek, ale žebříček uvádí za hodnocený běh přibližně 3,3 tisíce versus 0,6 tisíce USD. Jsou to celkové náklady evaluace, nikoli cena jedné úlohy nebo měsíčního předplatného. Oficiální výsledky
Pozor také na verzi: Terminal-Bench 4.0 měnil prostředky prostředí a opravoval či odstraňoval úlohy. Autoři požadují nové běhy. Číslo 66,5 % z dřívějšího pokusu na verzi 2.0 proto nelze přímo porovnat s dnešními 64,8 % na verzi 4.0. Změny Terminal-Bench 4.0
Kancelářský výstup prověří jiné schopnosti
AA-Briefcase v1.1 má 91 úloh ve čtyřech pracovních projektech. Kombinuje splnění hodnoticích kritérií, analytickou kvalitu a prezentaci do společného Elo. Vybrané výsledky ukazují i význam nastavení uvažování:
| Konfigurace | AA-Briefcase Elo |
|---|---|
| Claude Sonnet 5.5 · Max · Default Fallback | 1816 |
| Claude Opus 5.5 · Max · Default Fallback | 1801 |
| Claude Opus 5.5 · Medium · Default Fallback | 1622 |
| Claude Sonnet 5.5 · Medium · Default Fallback | 1438 |
Při Max je bodově výše Sonnet, při Medium Opus. První dva výsledky jsou blízko: jejich uvedené 95% intervaly jsou 1805–1828 a 1790–1813. Pořadí bodových odhadů samo o sobě nedokazuje spolehlivý rozdíl. Zachovávám také označení Default Fallback, které patří k testované konfiguraci. Úlohy se nyní spouštějí nezávisle, bez přenosu vlastních předchozích odevzdaných prací. Není to tedy úplný test dlouhodobé paměti. AA-Briefcase
Artificial Analysis zde používá společný harness Stirrup. Takové porovnání pomáhá vybírat model do podobného pracovního prostředí. Nepředstavuje přímý souboj aplikací Claude Code a Codex. Metodika AA-Briefcase
Jak bych vybíral sestavu pro skutečnou práci
V Hyperprostoru porovnáváme modely podle více kritérií: zajímá nás kvalita, cena, rychlost i konkrétní druh úlohy. U agentů k tomu přibývá otázka, jaké podmínky pro práci model dostal.
Pro vlastní porovnání bych vybral několik desítek reprezentativních zadání: opravu skutečné chyby, analýzu podkladů, vytvoření prezentace i pokračování v rozdělaném úkolu. Předem bych určil, podle čeho výstup přijmu. Pak bych zaznamenával model, verzi harnessu, nástroje, skilly, paměť, čas a rozpočet.
Chci-li změřit vliv harnessu, držím model a podmínky co nejvíce stejné. Chci-li vybrat nejlepší dostupnou sestavu, mohu každé dát vhodné nastavení, ale musím to přiznat. To jsou dvě různé otázky a oba pokusy mají smysl.
Část úloh bych nechal stranou a použil až po dokončení ladění. Důležité běhy bych zopakoval. U dlouhodobého asistenta bych přidal další sezení: najde správnou poznámku, pozná zastaralou informaci a neopakuje chybu z minulého týdne? Zvlášť bych počítal selhání infrastruktury a počet lidských zásahů.
Vedle úspěšnosti bych sledoval čas a cenu přijatého výsledku, včetně oprav a lidské kontroly. Levný běh, který skoro nikdy nic nedokončí, může být ve výsledku drahý.
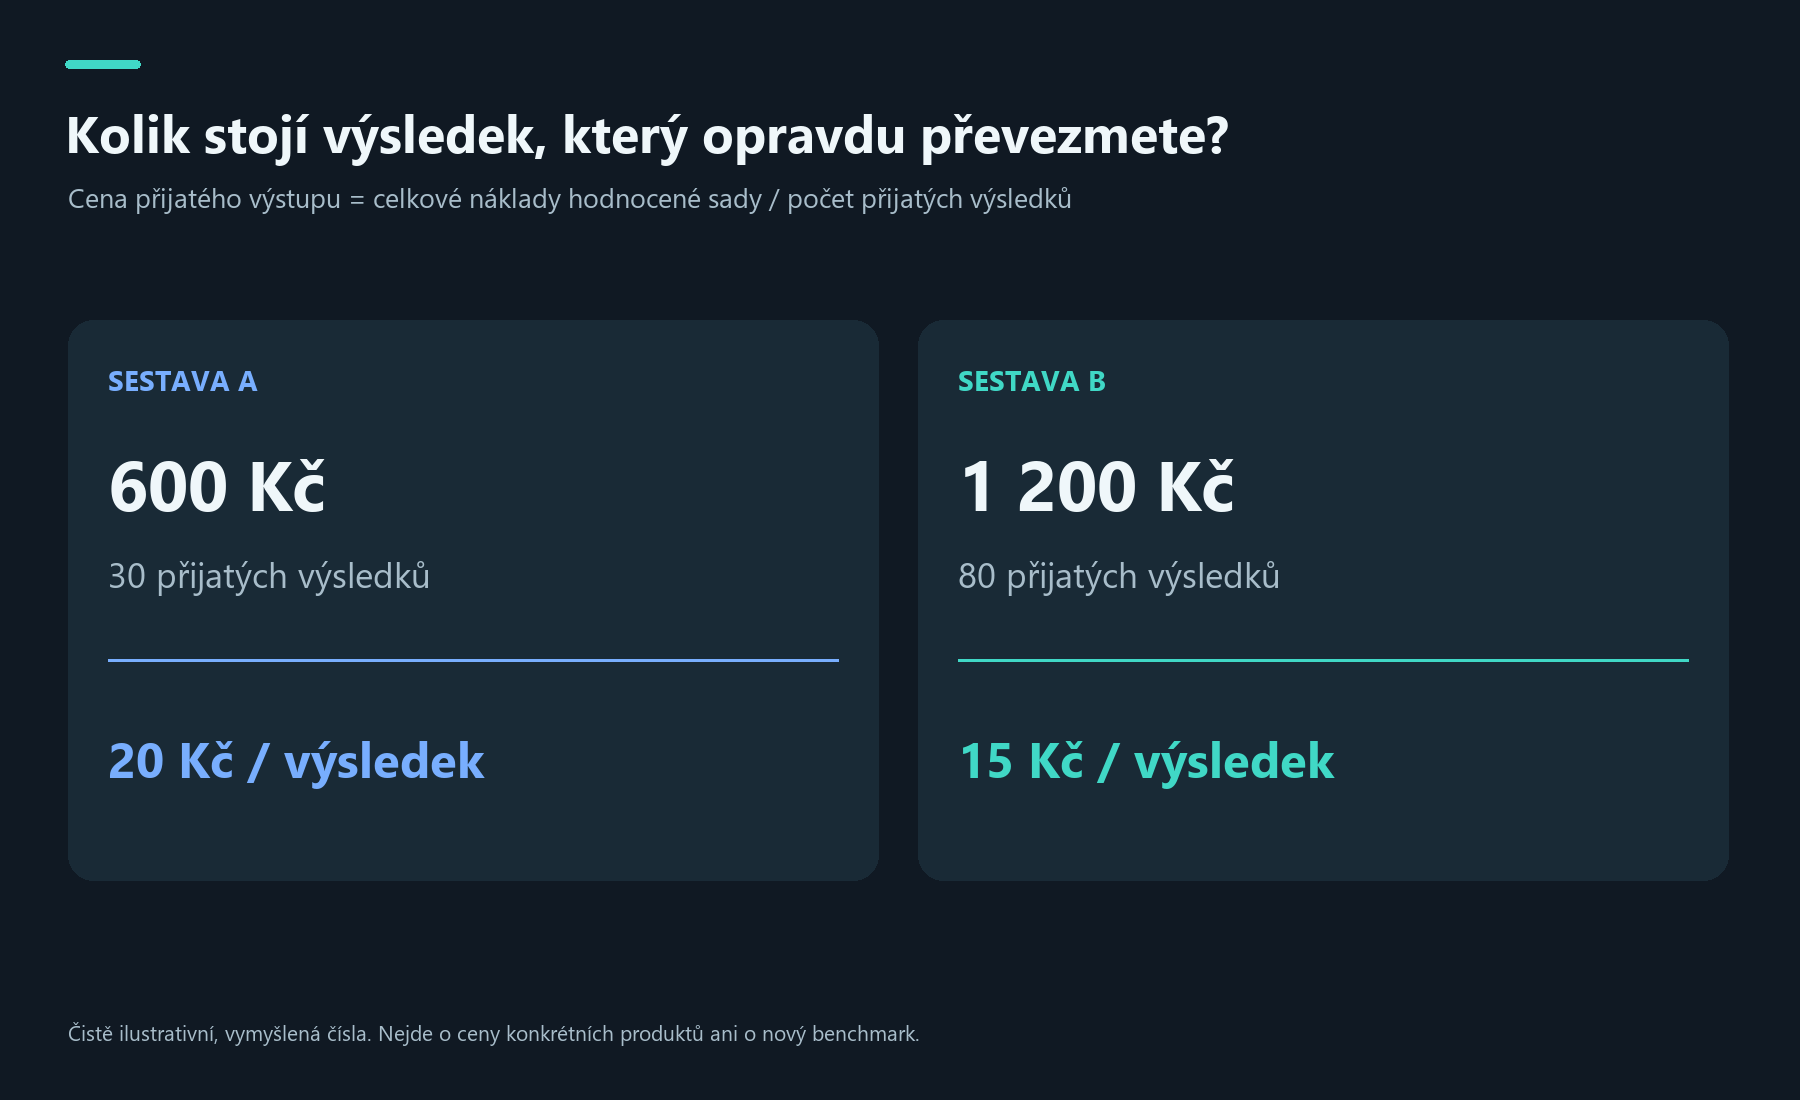
Čistě ilustrační výpočet s vymyšlenými čísly. Nejde o ceník produktů ani o další naměřený benchmark.
Když se agent zasekne, můžeme koupit silnější model. Někdy to pomůže. Jindy mu ale chybí správný soubor, nedostal výsledek předchozí akce nebo netuší, že kolega už před chvílí našel řešení.
Na našem ostrově měla taková zpráva podobu české rady v chatu. Ve firmě to může být test, správně uložené rozhodnutí nebo dohledatelný zdroj v tabulce. Harness zajišťuje, aby se tahle informace dostala do dalšího rozhodnutí. A právě tam často vzniká rozdíl mezi agentem, který působivě mluví, a agentem, jehož práci opravdu převezmeme.
Odkazy na původní metodiky jsou přímo u tvrzení a tabulek. Obrázky tvoří jedna AI ilustrace, sedm vlastních vysvětlujících schémat či grafů a jeden původní snímek experimentu. Podkladová čísla, původ obrázků a odkazy jsou dostupné také v přehledu zdrojů obrázků. Žebříčky jsou časový snímek, nikoli trvalé pořadí produktů.