Hotovo: skoro 5 000 GPU hodin na LUMI a odpověď, kterou jsem nečekal
Tři měsíce, přes dvacet experimentů, 305 tisíc ohodnocených odpovědí a 4 703 GPU hodin z 5 000. Kdy vyhraje porota AI modelů a kdy jeden dobrý model? Co se povedlo, co ne, kdo o nás psal a co si z LUMI odnášíme.

Náš projekt Fusion Playground na finském superpočítači LUMI se blíží ke konci: z přidělených 5 000 GPU hodin jsme využili 94 % a zbytek si necháváme jako rezervu. Za tři měsíce vzniklo přes dvacet experimentů s hypotézami zapsanými předem a 305 tisíc ohodnocených odpovědí jazykových modelů. Celou dobu nás přitom vedla jedna otázka, se kterou jsem na LUMI v červenci přišel:
Kdy je porota několika menších AI modelů lepší než jeden velký model — a za kolik?
Odpověď je jiná, než jsem čekal. A myslím, že je zajímavější.
Krátce pro spěchající
- Mezi otevřenými modely na LUMI vyhrál na směsi patnácti druhů úloh jeden dobrý model, Gemma-4-31B s přemýšlením: 91,3 % správně za zhruba dvě tisíciny GPU hodiny na úlohu. Porota, kaskády ani chytrý router ho v průměru nepřekonaly.
- Fúze modelů se vyplatí, ale jen v konkrétních situacích: když se dá odpověď ověřit (kód s testy), u těžké matematiky a u odborných otázek. Tam přidá jednotky bodů, obvykle za dvoj- až trojnásobnou cenu.
- Největší rezerva není v generování odpovědí, ale ve výběru té správné. Mezi osmi odpověďmi jednoho modelu byla správná v 95,5 % případů. Hlasování ale vybralo správnou jen v 86 %.
- Novější generace poráží velikost. Stejně velký Qwen3.8 je proti Qwen3.6 o 13–18 bodů lepší a dvakrát levnější. Bilionový MiMo-Pro naopak prohrál s modely třicetkrát menšími.
- Mikolovův ThinkingCap jsme za zhruba 30 GPU hodin překonali v matematice (+4 body, o 42 % kratší přemýšlení), i když mimo matematiku trochu ztratil.
- Placené modely jsou blíž, než se říká: nejlepší (Gemini 3.1 Pro) vede o 9 bodů, Claude Sonnet 5 jen o 2.
- Cestou jsme udělali i pár chyb. Popisuju je níže, protože se z nich dá naučit nejvíc.
Kdo s námi byl a kdo o nás psal
Tohle nebyl projekt jednoho člověka u jednoho počítače, i když většinu nocí to tak vypadalo.
Český tým LUMI AI Factory v IT4Innovations, národním superpočítačovém centru při VŠB-TUO, nám otevřel dveře k LUMI a celé tři měsíce pomáhal. Jako první nás oslovil Jakub Siwek.
O projektu se přitom mluvilo víc, než jsem čekal:
- LUMI AI Factory o nás v červenci vydala vlastní článek Czechia's Alpha Industries validates LUMI's power and sustainability in their initial test (13. 7. 2026). Odtud pochází i titulek mého článku Tak už jsme slavní i ve Finsku.
-
- září jsem měl keynote na festivalu CERNA.AI v ostravském Gongu, který LUMI AI Factory spolupořádala. Přišlo přes 2 000 lidí. O přednášce i o tom, proč AI ráda píše „ověřeno“, jsem psal v článku 20 + 5 = 29. Ověřeno.
- LUMI AI Factory o festivalu napsala CERNA.AI Festival: LUMI AI Factory co-organised Czechia's biggest AI event of the year (28. 9. 2026) a zmínila v něm i naši spolupráci.
- Filip Oborník si mě po přednášce o LUMI pozval do svého podcastu, natáčet budeme v říjnu.
- Projekt se odrazil i v navazující práci na českém kvantovém počítači VLQ.
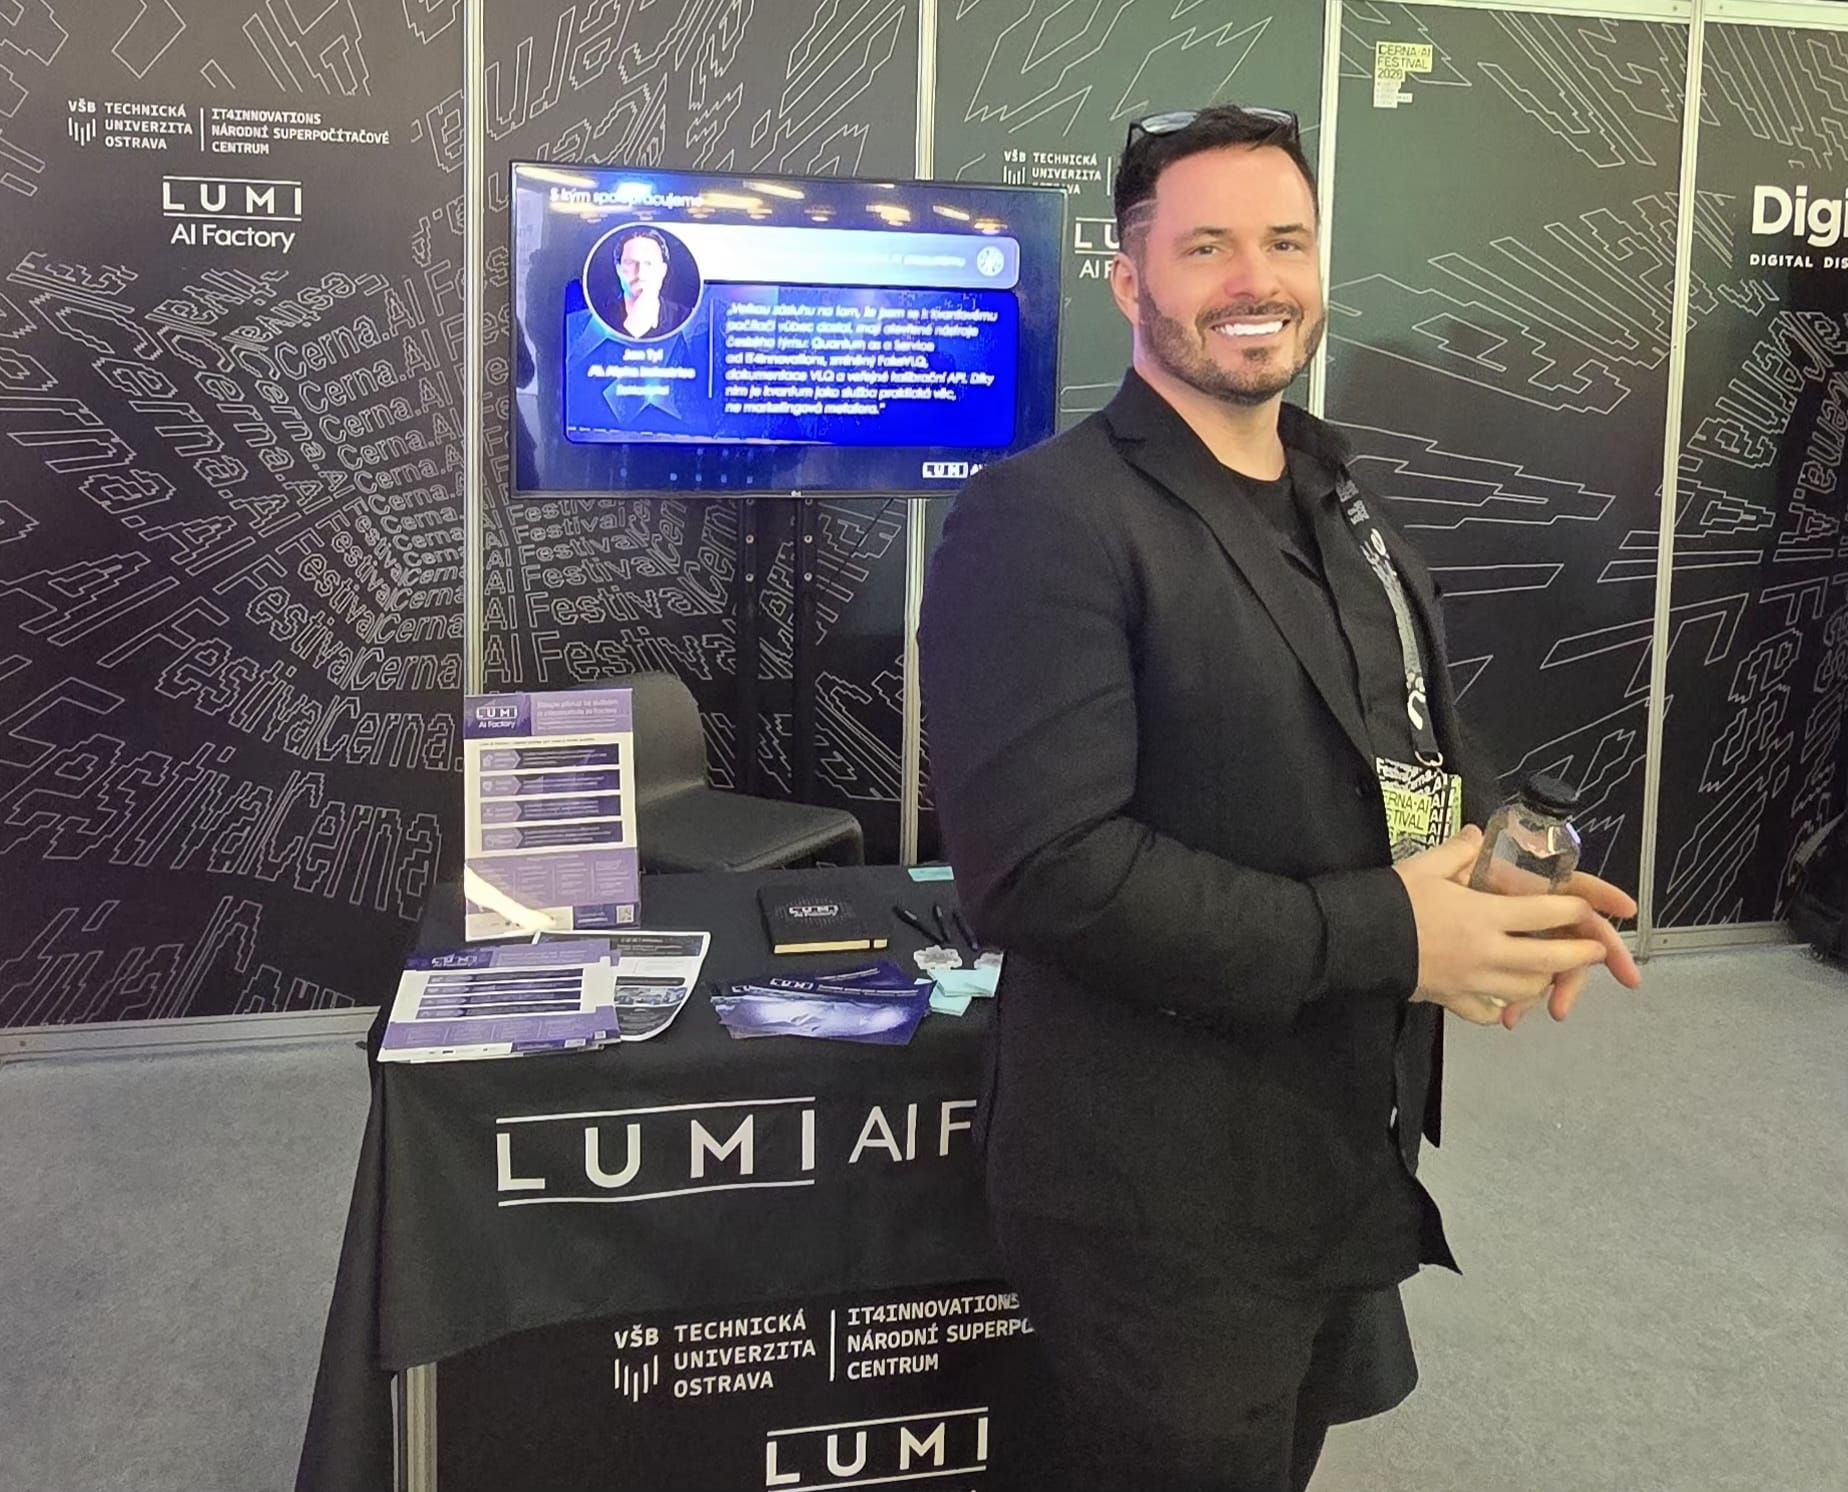
Přednáška na CERNA.AI v Ostravě. Na plátně experimenty, které tehdy na LUMI ještě běžely.
Tři měsíce v kostce
Většinu experimentů jsem průběžně popsal v samostatných článcích. Na časové ose je vidět, jak šly za sebou a co se mezitím dělo ve světě AI.
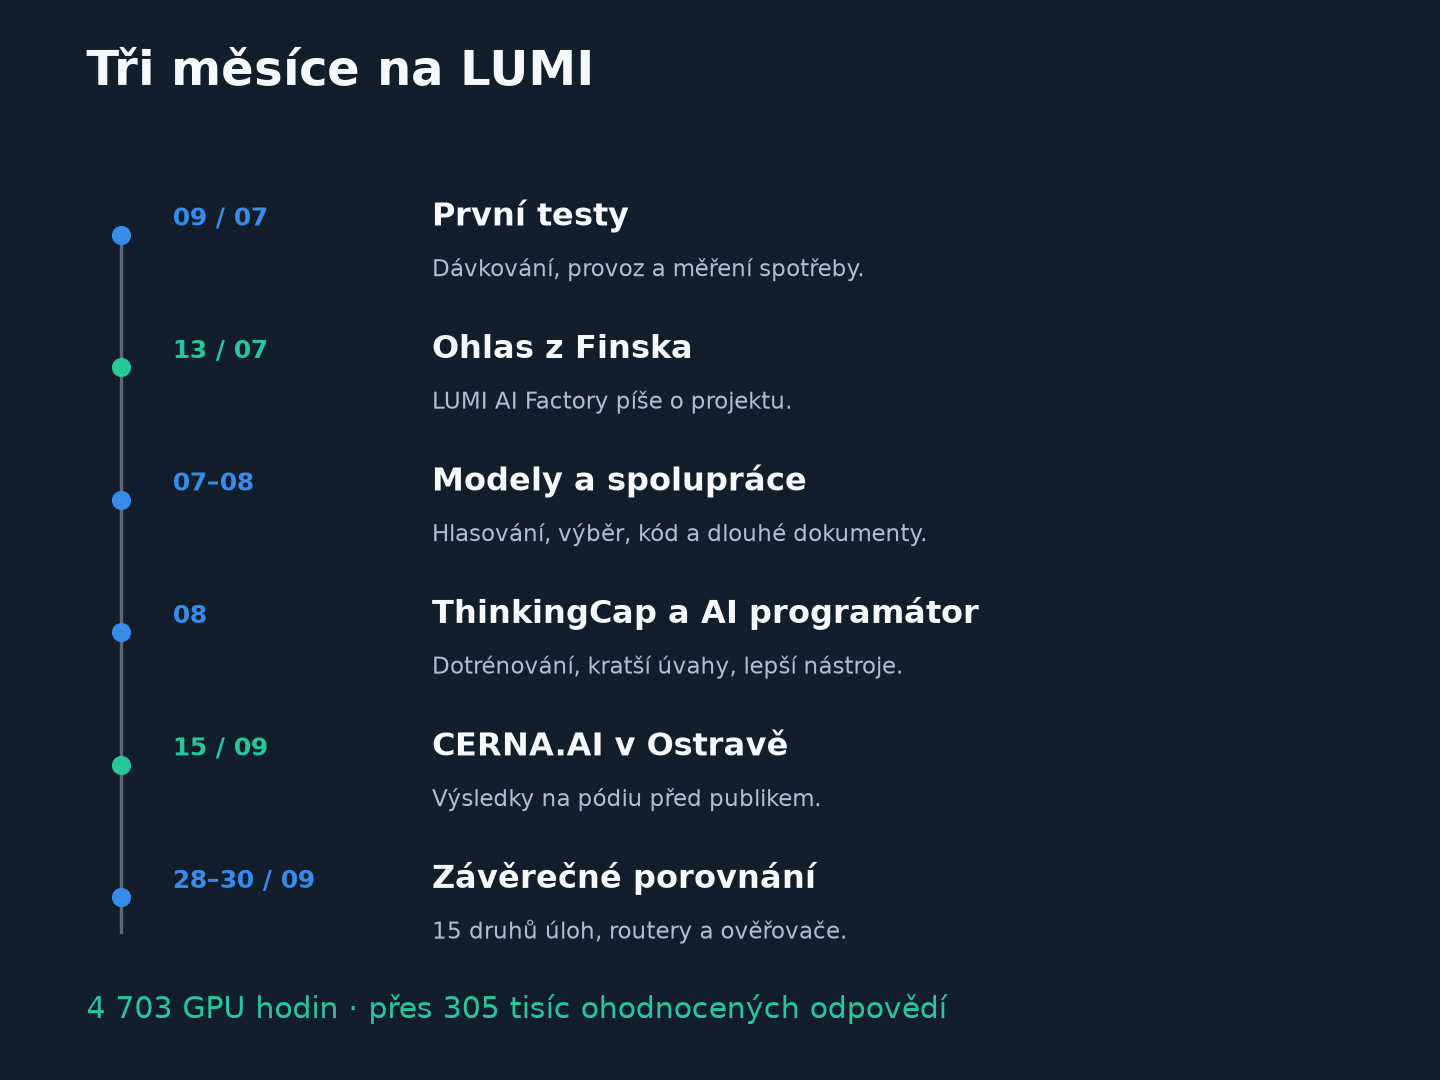
Modře naše experimenty, zeleně ohlas, oranžově nové modely a nástroje, které během projektu vyšly a které jsme hned zkoušeli.
Podrobnosti najdete v odkazech:
| Kdy | Co jsme zkoušeli | Co z toho vyšlo | Podrobně |
|---|---|---|---|
| 9. 7. | Fáze 0: první testy, jak superpočítač vůbec využít | Jeden dotaz LUMI nevyužije, tisíce najednou ano (dávkování 51× rychlejší) | Když superpočítač počítá AI a zároveň topí městu |
| 13.–14. 7. | První fúze modelů, 753miliardový GLM-5.2 ve 4 bitech | Fúze remizovala s nejlepším modelem; 4bitová komprese rozbila přemýšlení | Tak už jsme slavní i ve Finsku |
| červenec | Programování: více vzorků a rozlišovací testy | Testy vybírají správné řešení mnohem lépe než AI soudci | Jak se AI naučila programovat |
| červenec | Matematické uvažování, poroty a hlasování | Kontext pro naše pokusy s porotami | Pět let AI matematiky |
| červenec–srpen | Poroty modelů na vědeckých otázkách, vyhledávání v dokumentech, shrnutí | „Zeď selektoru“: správná odpověď v porotě je, soudci ji nenajdou | 20 + 5 = 29. Ověřeno. |
| srpen | Obří modely: Kimi K3 s 2,78 bilionu parametrů na jediném uzlu | Běží; ve 2 bitech si drží asi 90 % výkonu plné verze | — |
| srpen | Dotrénování ThinkingCapu Tomáše Mikolova | Matematika +4 body a o 42 % kratší přemýšlení (viz níže) | — |
| srpen | AI programátor na SWE-bench | Úspěšnost 42 → 61 %, ale díky lepším nástrojům, ne díky tréninku | — |
| srpen | Odbočka ke kvantům: český kvantový počítač VLQ | Bellův stav 94,2 %; simulátor zdarma | Doba kvantová, VLQ Lab |
| 28.–30. 9. | Finále: velká matice modelů a úloh, router, ověřovače | O tom je zbytek tohoto článku | — |
Po srpnu jsme měli spotřebovaných jen 1 790 GPU hodin. Zbytek jsme spálili za jeden den a jednu noc.
Za tři měsíce se posunul i svět AI
Na jednom projektu se ukázalo, jak rychle se dnes AI hýbe. Když jsme v červenci začínali, byly špičkou otevřených modelů Qwen3.6, Gemma 4 a obří GLM-5.2. Než jsme skončili, vyšla celá další vlna:
- Qwen3.8-27B (14. 8.): stejná architektura a velikost jako Qwen3.6-27B, jen novější trénink.
- MiMo-V2.6 Pro a Flash (21. 9.): bilionový a menší model od Xiaomi.
- Kimi K3 s 2,78 bilionu parametrů, který jsme v srpnu rozběhli na jediném uzlu LUMI.
- DeepSeek-V4-Flash (31. 7.) a další.
Jak velký je jeden takový skok, ukazuje dvojice Qwen3.6 a Qwen3.8. Mají stejnou velikost i stavbu, liší se jen tréninkem, a přesto se nový model zlepšil téměř všude:
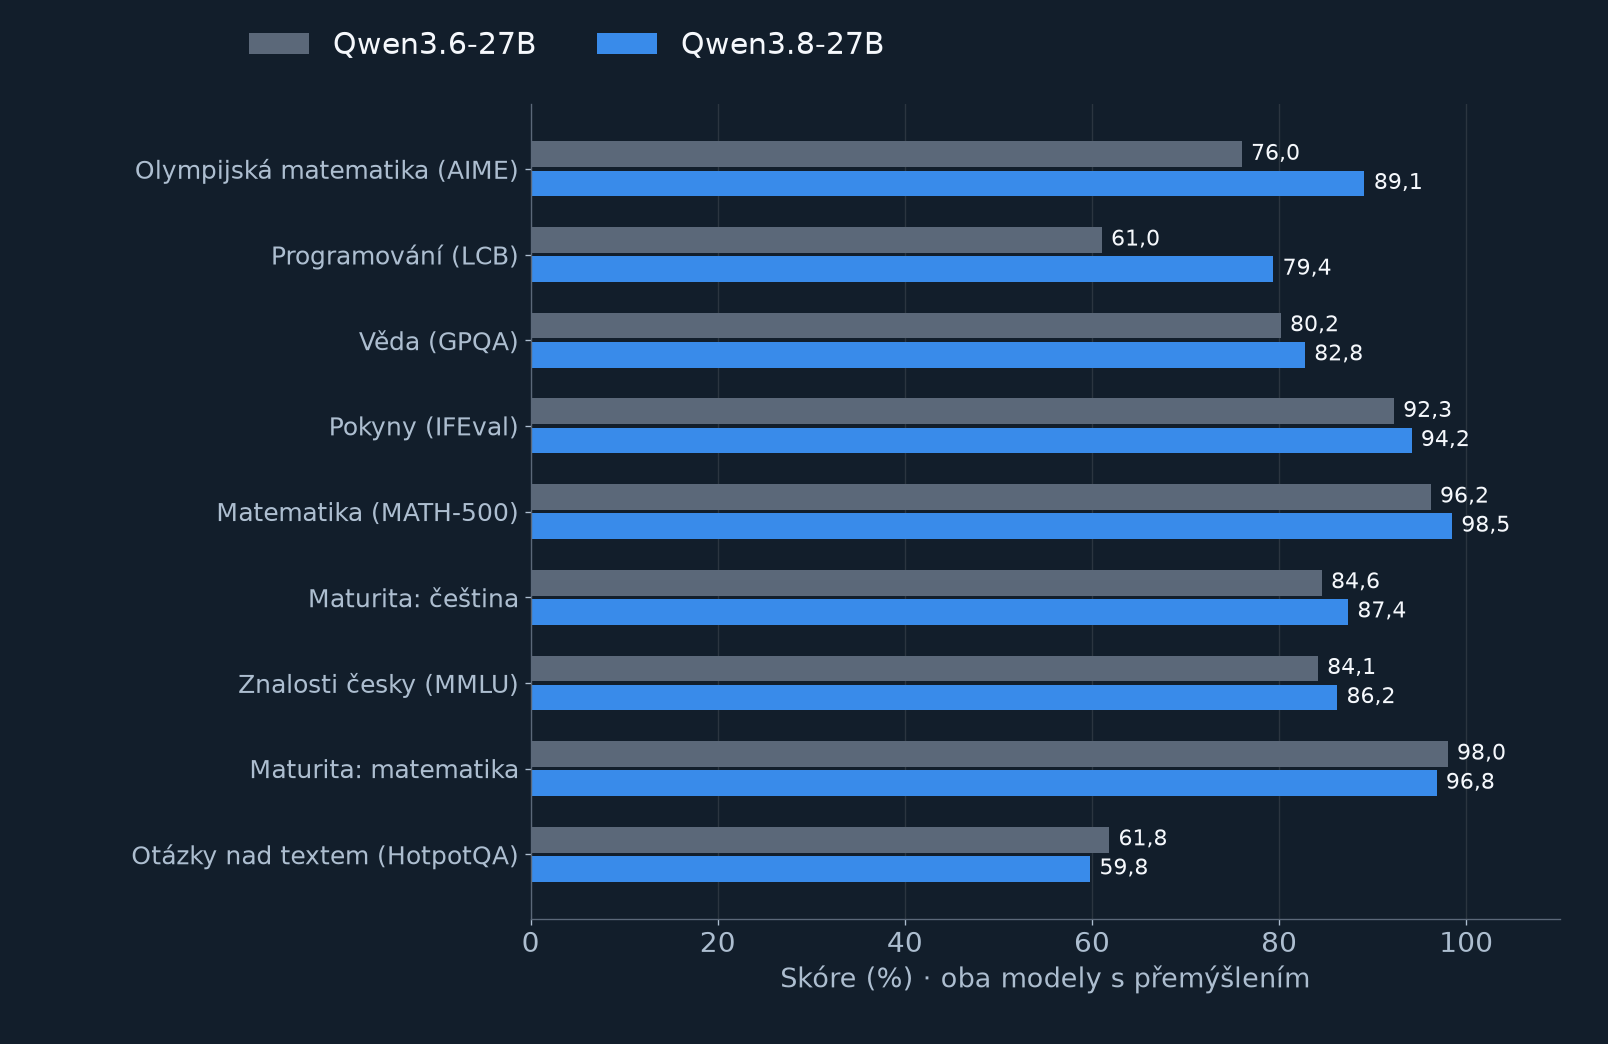
Oba modely s přemýšlením, stejné úlohy, průměr ze 4–8 pokusů. Na programování +18 bodů, na olympijské matematice +13.
A to není všechno: nový model přemýšlí zhruba o polovinu kratší. Na olympijské matematice ho jedna úloha stojí 18 tisícin GPU hodiny místo 36, u programování 16 místo 33. Je tedy lepší a zároveň dvakrát levnější. Na několika úlohách (vyhledávání v textu, maturitní matematika) si naopak o bod až dva pohoršil. I to je dobrá připomínka, proč modely měřit na vlastních úlohách.
Nové modely ale často nejdou hned spustit. Nástroje za nimi pokulhávají. MiMo-V2.6 se v tehdejší verzi vLLM na akcelerátorech AMD rozběhnout nedal. Kimi K3 jsme museli pouštět ve vlastním sestavení llama.cpp z vývojové větve. Kontejnery LUMI AI Factory se mezitím aktualizovaly z vLLM 0.20 na 0.22. Pro firmu to znamená jediné: pořadí modelů je potřeba přeměřovat průběžně. Co platilo v červenci, v září už nemusí.
Posunuly se i nástroje kolem modelů. V posledním týdnu projektu jsme zapojili JEV od TypeSafe. Je to malý rychlý model, který neodpovídá textem, ale na otázky vrací čísla a pravděpodobnosti, zhruba za třetinu sekundy a za zlomek centu. V Hyperprostoru jím Atlas měří vlastnosti zadání. Na LUMI jsme ho poprvé postavili proti tvrdým datům: jak dobře předpovídá, kdy stačí levný model, a jak dobře umí zkontrolovat hotovou odpověď. Výsledky jsou níže a byly jedním z nejpříjemnějších překvapení celého projektu.
Mikolovův ThinkingCap jsme v matematice překonali za pár hodin
ThinkingCap-27B od BottleCap AI, firmy Tomáše Mikolova, je model postavený na tom, že přemýšlí stručně. Proti základnímu Qwenu, ze kterého vznikl, podle autorů spotřebuje zhruba o polovinu méně „přemýšlecích“ tokenů. Chtěl jsem zjistit, jestli se dá ještě zlepšit, a to levně.
Vzal jsem 2 000 veřejných matematických úloh a model na LUMI dotrénoval tak, aby se učil z nejkratších správných řešení. Jeden trénink stál zhruba 30 GPU hodin, tedy pár hodin na superpočítači.
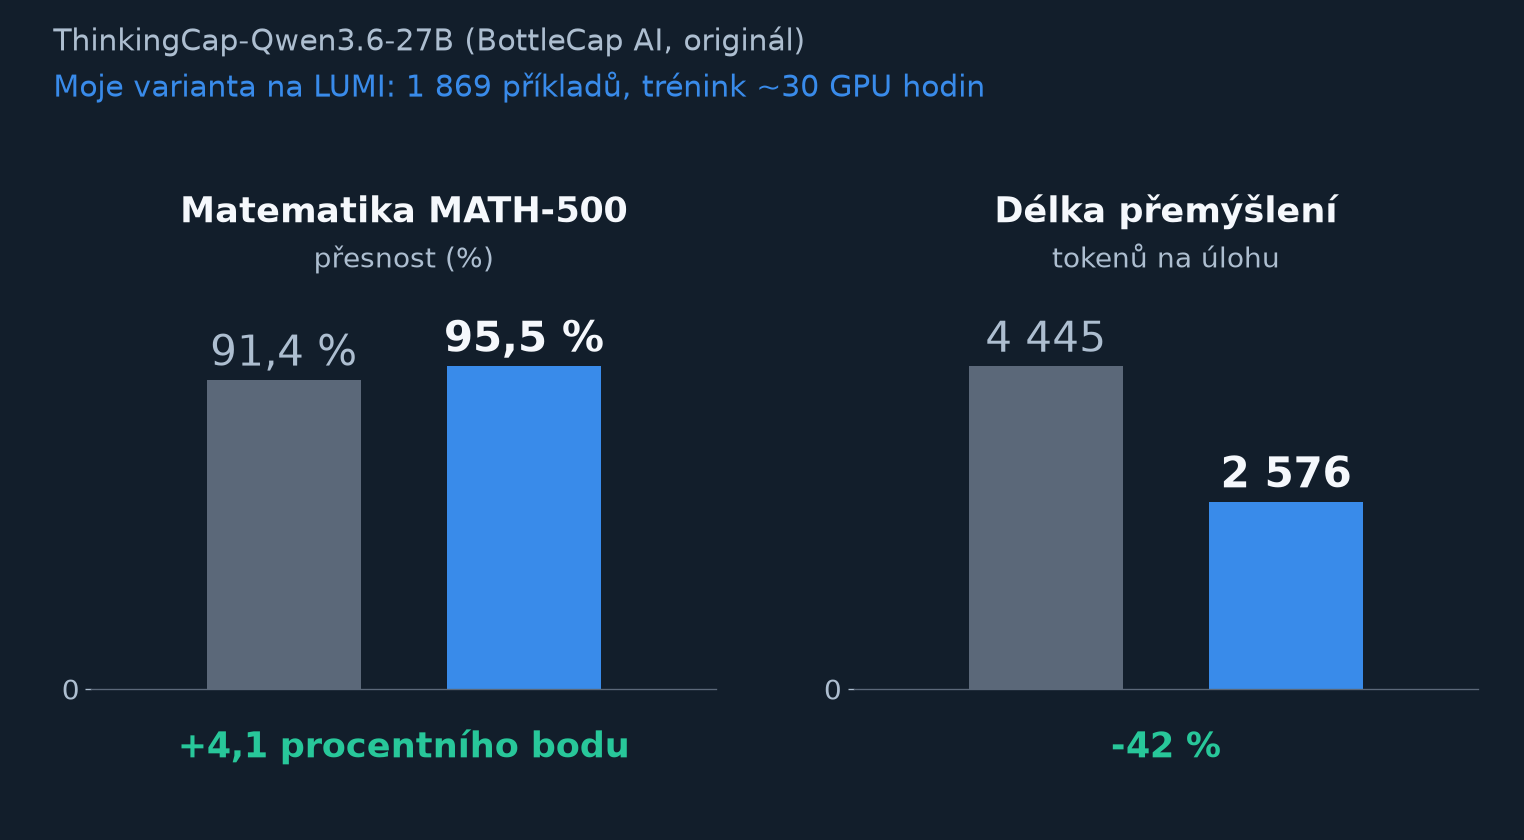
Originál ThinkingCap proti naší verzi na matematice MATH-500 (průměr z 1 500 pokusů).
Výsledek: v matematice je náš model o 4 body přesnější a přemýšlí o 42 % kratší. Model, jehož hlavní předností je stručnost, jde tedy za cenu jedné noci na evropském superpočítači udělat ještě stručnějším a zároveň přesnějším.*
* Pro úplnost: trénovali jsme jen na matematice a mimo ni náš model trochu ztratil (olympijské úlohy −3,3 bodu, vědecké otázky −5,6 bodu). Nejvyváženější z pěti vyzkoušených receptů ztrácí na vědě jen 2,3 bodu. Udržet model dobrý ve všech oborech najednou je těžší část úlohy a v té je originál od BottleCap zatím lepší.Jak si stojí placené modely
Na začátku projektu jsem si jako měřítko pár desítek dolarů „půjčil“ i od placených modelů přes API. Chtěl jsem vědět, jak daleko jsou otevřené modely běžící na LUMI od špičky a jestli komprese modelů na menší počet bitů nepoškozuje víc, než se zdá.
| Srovnání | Placený model přes API | Otevřený model na LUMI |
|---|---|---|
| Vědecké otázky GPQA (138 otázek) | Gemini 3.1 Pro 93,5 % · Claude Sonnet 5 86,2 % · GLM-5.2 82,6 % · DeepSeek V4 Pro 77,5 % | Gemma-4-31B 84,1 % · ThinkingCap-27B 82,6 % |
| GLM-5.2 (753 miliard parametrů), otevřená úloha | plná verze přes API 60 z 60 | stejný model zmenšený na 4 bity 35 z 60 |
| Kimi K3 (2,78 bilionu), programování | plná verze přes API 31 ze 40 | stejný model ve 2 bitech na LUMI 28 ze 40 (90 %) |
Z toho plynou tři věci:
- Nejlepší placený model (Gemini 3.1 Pro) je na nejtěžších vědeckých otázkách pořád o 9 bodů před nejlepším otevřeným. Claude Sonnet 5 ale jen o 2 body a GLM-5.2 s DeepSeekem jsou dokonce za Gemmou, kterou pustíte na jednom serveru.
- Komprese je loterie. Z GLM-5.2 udělala 4bitová verze úplně jiný, výrazně horší model. Kimi K3 si naopak i ve 2 bitech udržel 90 % výkonu. Rozhoduje kvalita komprese, ne samotný počet bitů, a každý model je potřeba změřit.
- Placená měřítka byla levná: všechna srovnání přes API stála dohromady asi 41 dolarů.
Co děláme v Hyperprostoru a proč jsme to zkoušeli na LUMI
Hyperprostor je naše platforma, kde spolu AI modely nejen mluví s lidmi, ale i spolupracují. Jsou v ní dva klíčové mechanismy:
- HyperFusion, porota modelů. Několik různých modelů dostane stejné zadání a každý připraví vlastní odpověď. Soudce je porovná a syntéza z nich poskládá jednu lepší: vezme dobrý nápad od jednoho, doplní ho postřehem druhého a chybu třetího zahodí.
- Atlas, dispečer. Než se začne odpovídat, JEV změří jedenáct vlastností zadání. Jde třeba o to, jestli má úloha jednoznačnou odpověď, jestli je sekvenční, riziková nebo jestli vyžaduje úplný výčet. Podle toho Atlas zvolí postup: jeden silný model, hlubší řešení, porotu se syntézou, nebo sjednocení pro úlohy, kde nesmí nic chybět.
V produkci běží HyperFusion a Atlas nad hostovanými modely. Otázka, se kterou jsem šel na LUMI, byla, jestli stejná logika platí i pro otevřené modely a jestli se dá změřit, kdy se porota opravdu vyplatí. Na superpočítači si to můžeme dovolit: každý postup vyzkoušet na tisících úloh, mnohokrát, a s přesnou cenou za každou odpověď. To v běžném provozu nejde.
Finále: 140 úloh naráz a hlídač rozpočtu
Všechny předchozí pokusy měly jednu slabinu. Většinou běžely jednou, na šedesáti otázkách. Rozdíl pěti bodů pak znamená tři otázky, a to může být náhoda.
Na závěr jsem proto chtěl jednu velkou a poctivou tabulku. Jedenáct konfigurací modelů, od malé Gemmy přes Qwen3.8 a gpt-oss až po MiMo-V2.6-Pro s bilionem parametrů. Patnáct druhů úloh: vědecké otázky, olympijská matematika, programování, dodržování pokynů, vyhledávání v textu, česká maturita, čtení s porozuměním česky, logické hádanky a další. Každou úlohu každý model řešil čtyřikrát až osmkrát, abychom viděli i to, jak moc výsledky kolísají.
Z uložených odpovědí se pak dají bez dalšího počítání skládat poroty, kaskády a hlasování. Stačí je jednou vygenerovat.
LUMI na to v jednu chvíli nasadilo 140 výpočetních úloh najednou. Celé finále tak proběhlo za jeden den a noc, a aby nepřekročilo grant, hlídal ho skript, který by při 4 700 GPU hodinách všechno sám zastavil.
Hlavní výsledek: mezi otevřenými modely vyhrál jeden stručný model
Nejdřív to nejdůležitější. Pro každou úlohu jsme mohli zvolit jiný postup: levný model, silný model, kaskádu („nejdřív levný, a když si není jistý, silný“), porotu více modelů, nebo nechat rozhodnout router. Router je chytrý dispečer, který se podívá na zadání a rozhodne, komu ho pošle.
Aby výsledky nebyly přikrášlené, hodnotil jsem poctivě. Nejlepší postup se vybíral na jedné polovině pokusů a měřil na druhé. Router jsme navíc zkoušeli i na úplně nové sadě 1 455 úloh šesti druhů, které nikdy předtím neviděl. Tu jsme otevřeli až poté, co byl router „zamčený“.
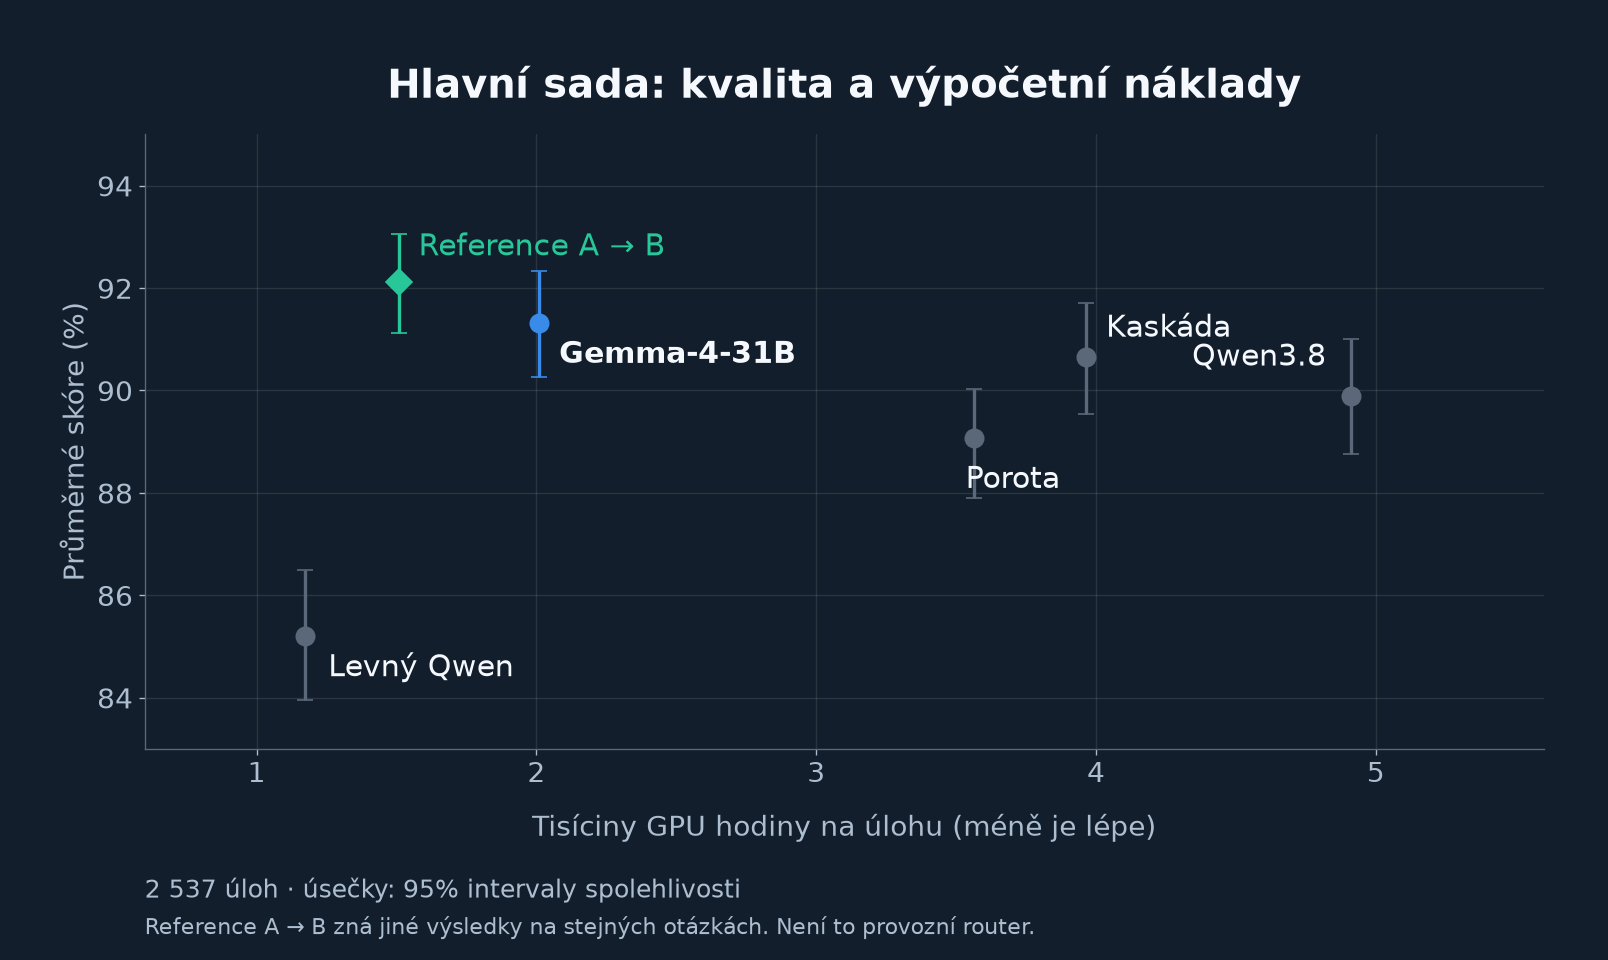
Každý bod je jeden způsob rozhodování. Nahoře vlevo je lépe (vyšší kvalita, nižší cena). Modrý bod 3 je „vždy Gemma-4-31B“. Zelené čáry jsou naučené routery. Kolečka nahoře jsou teoretický strop.
| Postup | Známé úlohy | Nové úlohy | Cena na úlohu* |
|---|---|---|---|
| vždy levný model (Qwen3.6 bez přemýšlení) | 85,2 % | 88,7 % | 0,7–1,2 |
| vždy Qwen3.8 s přemýšlením | 89,9 % | 89,9 % | 3,4–4,9 |
| vždy Gemma-4-31B s přemýšlením | 91,3 % | 91,4 % | 1,6–2,0 |
| vždy porota tří modelů | 89,1 % | 88,5 % | 1,3–3,6 |
| vždy kaskáda „levný, a když váhá, silný“ | 90,7 % | 90,1 % | 2,0–4,0 |
| naučený router | 90,2–91,3 % | 90,3–91,4 % | 1,6–3,4 |
| teoretický strop (víme předem, co vyjde) | 92,1 % | 92,8 % | 1,0–1,5 |
*Tisíciny GPU hodiny na jednu úlohu. Jedna GPU hodina na LUMI je hodina práce jednoho akcelerátoru AMD MI250X.
Proč to tak dopadlo? Gemma-4-31B přemýšlí stručně. Je tedy silná a zároveň levná. „Levný“ model byl na našem hardwaru levnější jen 1,7krát, ale o šest bodů horší. Přepínat mezi nimi se nevyplatilo.
Router je navíc v nevýhodě: vidí jen zadání. Nepozná, kterou konkrétní otázku levný model zvládne a kterou ne. U většiny otázek je to z textu prostě nepoznat.
Kdy se porota modelů vyplatí
Neznamená to, že fúze modelů nefunguje. Funguje, ale jen tam, kde k tomu jsou důvody. Když jsem se podíval na jednotlivé druhy úloh, obrázek je tenhle:
| Situace | Co funguje | Výsledek |
|---|---|---|
| Programování s testy | levný model zkusí úlohu, a když jeho řešení neprojde testy, teprve pak silný | stejná kvalita za poloviční cenu (85,2 % za 3,0 proti 84,8 % za 5,6) |
| Programování, když jde o kvalitu | silný model opakuje, dokud řešení neprojde testy | +1,4 až +1,9 bodu za o 17–40 % vyšší cenu |
| Olympijská matematika | hlasování více pokusů nebo porota menších modelů | +3,4 bodu za 2,2× cenu; levná porota tří modelů (90,4 %) je lepší i levnější než drahé přemýšlející modely (~89 %) |
| Odborné otázky z vědy | kaskáda nebo porota různých modelů | +1,3 až +2,0 bodu za 2–6× cenu |
| Vyhledání a výpočet z textu | stačí levný model bez přemýšlení | stejná nebo lepší kvalita, 3–7× levněji |
| Dodržování pokynů, maturita, logika, snadná matematika | fúze nepřidá | ≤ 1 bod za 2–5× cenu |
Dvě věci mě tu překvapily.
Hlasování pomáhá jen modelu, který se plete náhodně. Menší Gemma bez přemýšlení na olympijské matematice skočí z 82 % na 90 %, když odpoví třikrát a vybere se nejčastější výsledek. Při 32 hlasech dosáhne 93 %. Gemma-4-31B z opakování nezíská skoro nic. Když se splete, splete se pokaždé stejně.
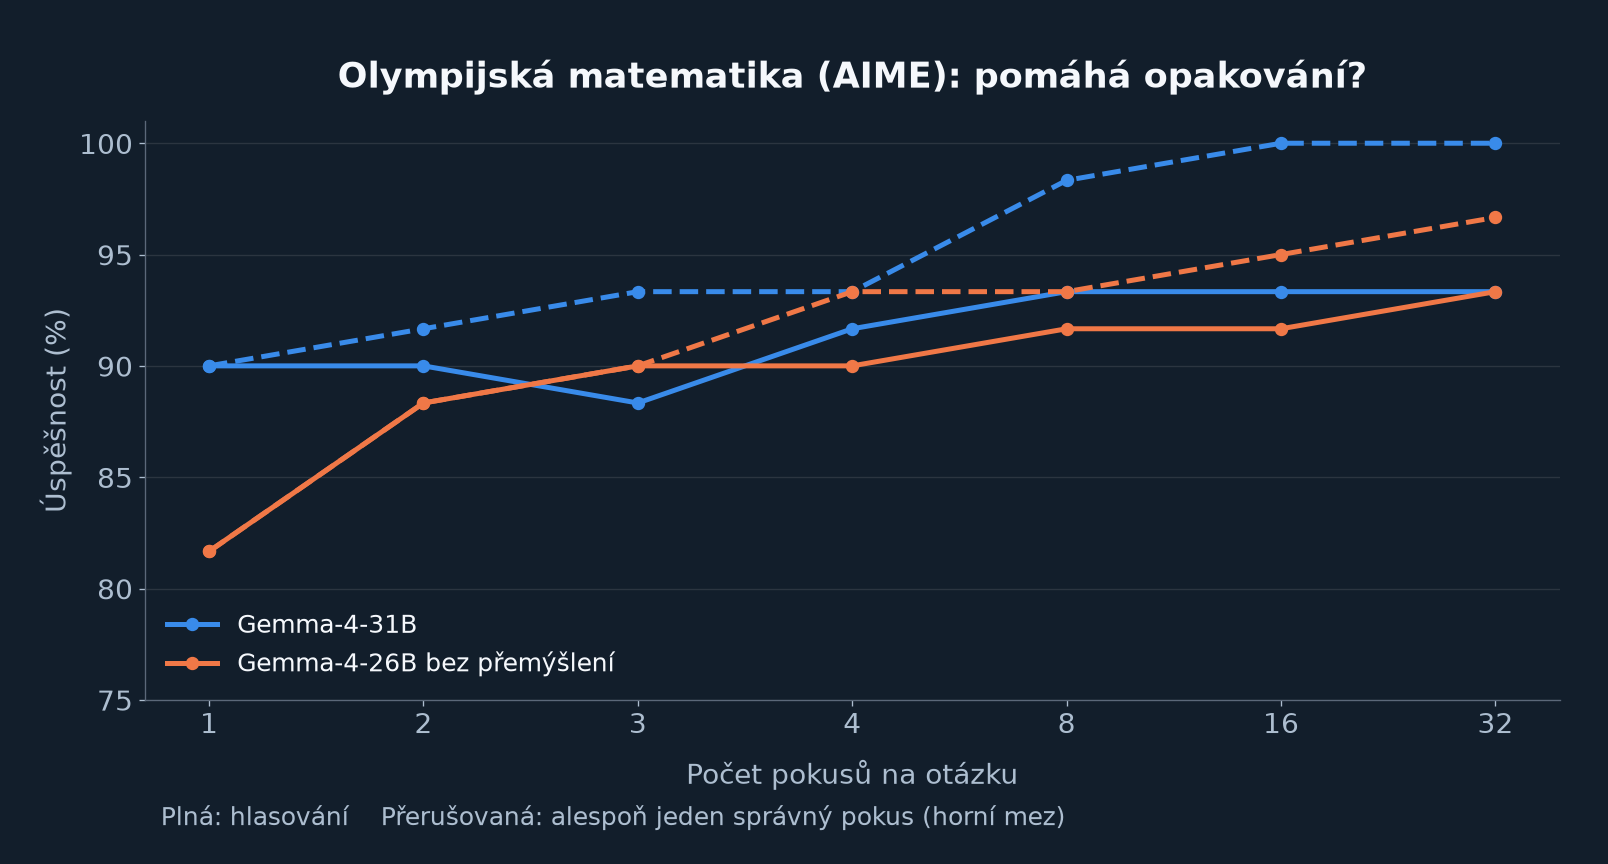
Olympijská matematika (AIME). Plná čára je hlasování z k pokusů, čárkovaná „strop“: alespoň jeden z k pokusů je správně.
U znalostí pomáhá různorodost, u matematiky opakování. Tři různé modely odpoví na vědecké otázky o 1,3 bodu lépe než tři pokusy téhož modelu: každý ví něco jiného. U matematiky naopak stačí opakovat ten správný „nestálý“ model, protože početní chyby se při opakování vyruší.
Zeď selektoru: správná odpověď tam je, jen ji nenajdeme
Tohle je podle mě nejdůležitější obrázek celého projektu.
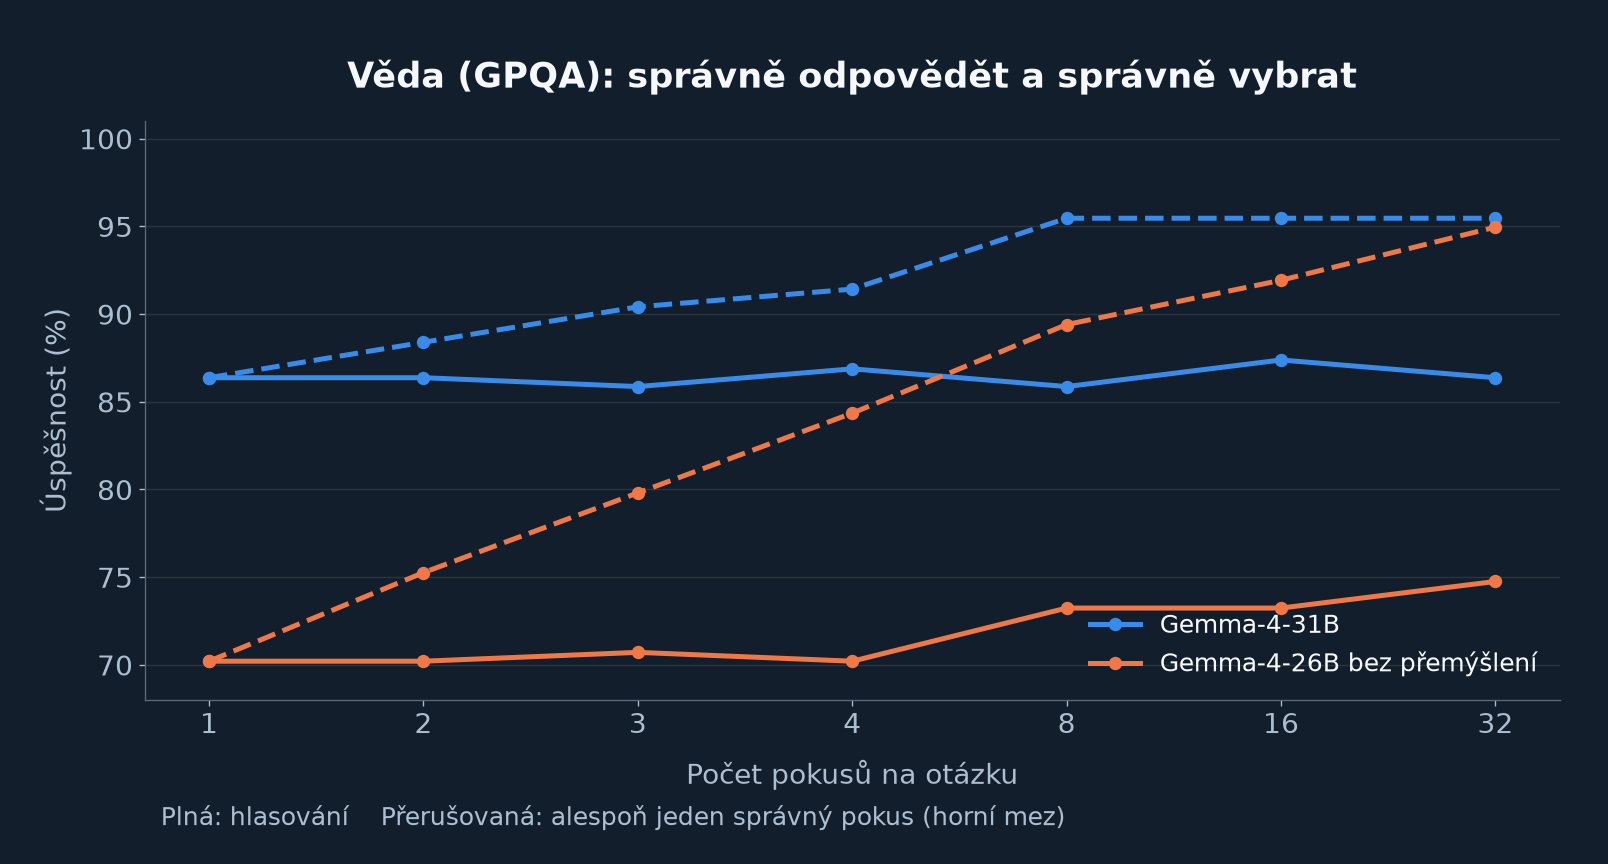
Vědecké otázky GPQA. Mezi osmi odpověďmi Gemmy-4-31B je správná v 95,5 % otázek (modrá čárkovaná). Hlasování ale vybere správnou jen v 86 % (modrá plná).
Když Gemmu necháte odpovědět osmkrát, správná odpověď je mezi nimi u 95,5 % otázek. Hlasování ale vybere správnou jen u 86 %. Kdybychom uměli spolehlivě vybrat, přidali bychom skoro deset bodů. Bez jediného nového modelu.
Tomu jsem v létě začal říkat zeď selektoru a finále ji potvrdilo ve velkém. Nabízí se nechat vybírat jiného AI soudce, ale to jsme změřili taky. AI soudci se oproti objektivní kontrole mýlili ve 20–25 % případů a u téže odpovědi při opakování měnili názor v 9–25 % případů. Tudy cesta nevede.
Cesta vede přes ověřovače: testy u kódu, výpočet u matematiky, pravidla u formátu. Tam, kde je máme, fúze funguje nejlépe.
Dá se naučit „dispečer“, který to pozná?
Tady musím zmínit Hyperprostor a jeho router Atlas. Atlas si o každém zadání nechá změřit jedenáct vlastností, například jak je úloha náročná, jestli má jednoznačnou odpověď nebo jestli je riziková. Měří je rychlý specializovaný model JEV a podle nich Atlas volí postup.
Na LUMI jsem Atlas poprvé změřil proti skutečným výsledkům. Když posílal „jednoduché“ úlohy levnému modelu, byl o 2–4 body horší než Gemma. Když je posílal silnému modelu, jak to dělá v produkci, dopadl prakticky stejně jako Gemma: 91,3 %.
Pak jsem zkoušel, jestli se JEV nedá „naladit“ lépe. Dal jsem mu jedenáct nových otázek přímo na rozhodnutí slabý nebo silný model:
- jaká úroveň znalostí je potřeba,
- kolik kroků úvahy řešení vyžaduje,
- jestli jde o úzce odbornou věc,
- jestli je potřeba přesný výpočet,
- jestli jsou mezi možnostmi chytáky,
- a také míru jistoty u každé odpovědi.
Pro srovnání jsem vyzkoušel i opačný přístup. Nechat slabý model odpovědět a pak jen ověřit hotovou odpověď.
| Podle čeho se rozhoduje | Jak dobře pozná, kdy stačí slabý model (AUC**) | Kvalita za polovinu ceny Gemmy |
|---|---|---|
| původní otázky JEV pro Atlas | 0,77 | 88,8 % |
| nové otázky JEV na obtížnost | 0,79 | 89,3 % |
| jen vlastnosti textu, bez JEV | 0,61 | 88,3 % |
| ověření odpovědi modelem Gemma-4-31B | 0,77 | 89,4 % |
| ověření odpovědi modelem Qwen3.6 | 0,82 | 88,8 % |
| ověření odpovědi pomocí JEV | 0,84 | 89,8 % |
**AUC 0,5 je hod mincí, 1,0 dokonalý odhad.
Nové otázky pomohly jen trochu. Z textu zadání se prostě nedá dobře poznat, jestli ho slabý model zvládne. Mnohem lepší je podívat se na hotovou odpověď. JEV je v roli „kontrolora“ lepší než velké modely a stojí zhruba 0,00005 dolaru na úlohu. Velká Gemma byla v roli kontrolora přehnaně sebejistá: v 90 % případů odpověděla „ano, správně“, skoro vždy se stoprocentní jistotou.
Ani nejlepší kontrolor ale Gemmu v kvalitě nepřekonal. Dokáže ušetřit asi 30 % ceny za půl bodu kvality, nebo polovinu ceny za bod a půl. Zbylé chyby jsou případy, kdy je slabý model sebejistě špatně, a to žádný levný signál nepozná.
K „ideálnímu dispečerovi“ by byl potřeba kontrolor výrazně lepší (AUC kolem 0,95). A tady je dobrá zpráva: máme 305 tisíc ohodnocených odpovědí, na kterých by se dal natrénovat.
Bilion parametrů nestačí
Chtěl jsem vyzkoušet i největší otevřený model, který šlo na LUMI rozběhnout: MiMo-V2.6-Pro s bilionem parametrů. Aby se vešel na jeden uzel, musel být zmenšený na 3,5 bitu na parametr.
| MiMo-V2.6-Pro (1T) | Gemma-4-31B | |
|---|---|---|
| vědecké otázky GPQA | 78,3 % | 85,9 % |
| česká maturita | 92,2 % | 91,0 % |
| cena na úlohu (GPQA) | ~0,52 GPU hodiny | ~0,005 GPU hodiny |
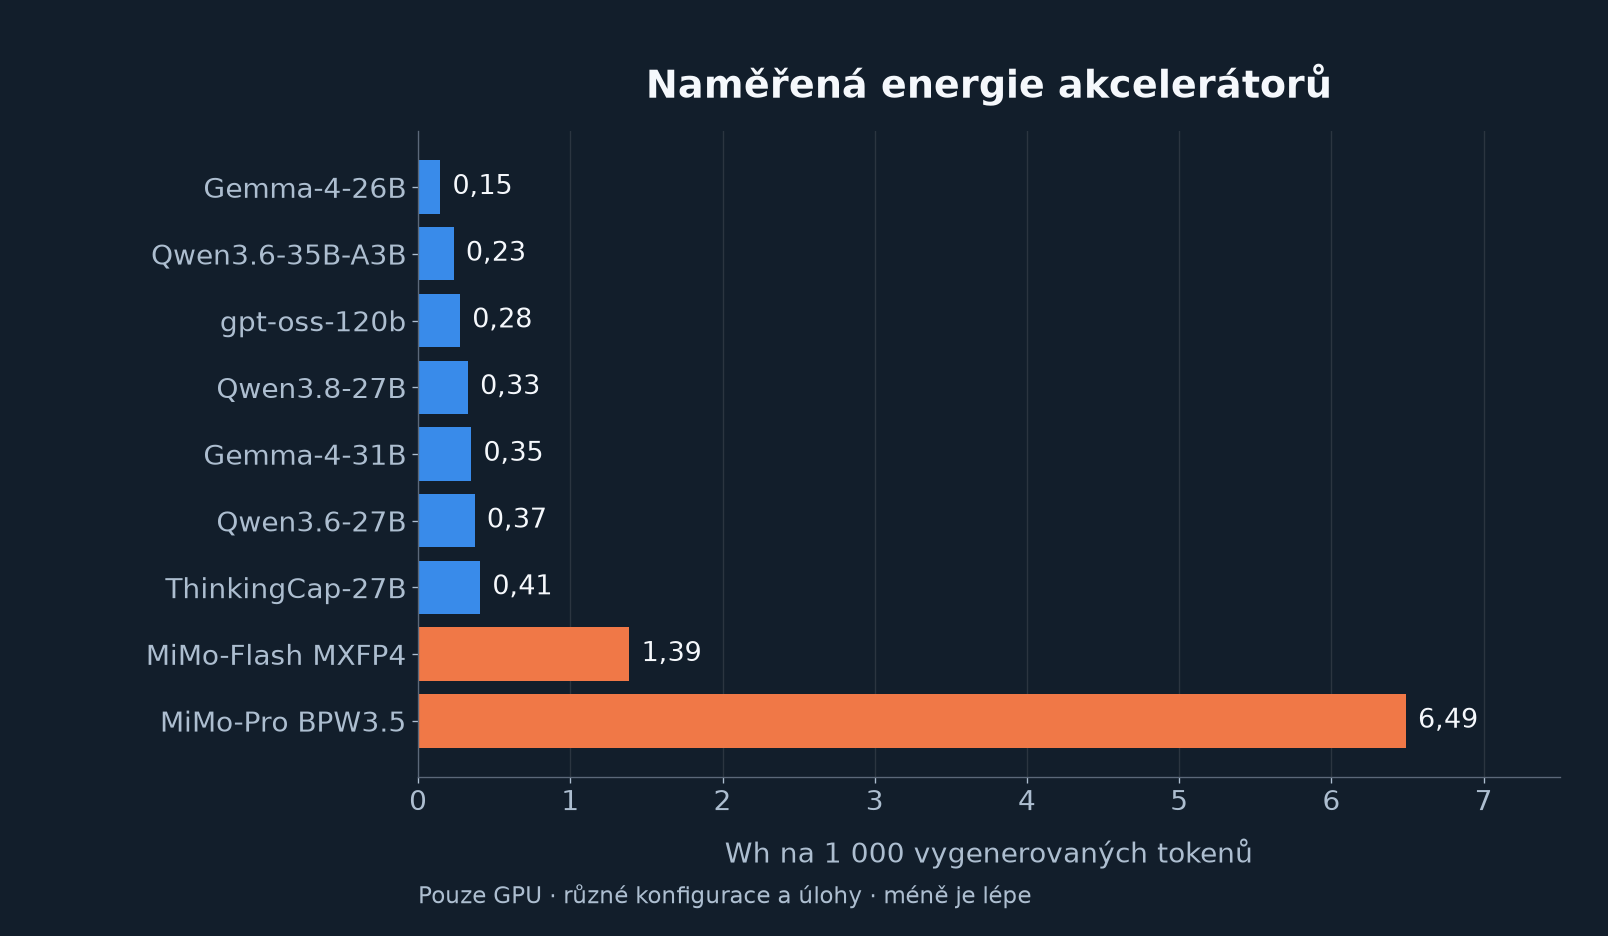
| energie na 1 000 tokenů | 6,5 Wh | 0,35 Wh |
Byl nejlepší v češtině, ale jinde prohrál s modelem třicetkrát menším a stál zhruba stokrát víc. U těžkých otázek přemýšlel tak dlouho, že pětinu odpovědí uřízl limit. Nebyly to smyčky, ale opravdu dlouhé úvahy, třeba ruční výpočty 3D souřadnic atomů. Na 64 otázkách, které stihla i přesnější 4bitová verze, měla o 4,7 bodu víc a nic neuřízla. To naznačuje, že větší komprese úvahy prodlužuje. Novější generace a stručné přemýšlení tu porazily velikost.
Recept pro provoz na superpočítači
Pár praktických zjištění pro každého, kdo bude na LUMI nebo podobných strojích provozovat AI:
Místo jednoho modelu přes celý uzel pusťte čtyři menší kopie. Stejný model rozložený přes všech osm akcelerátorů byl třikrát pomalejší než čtyři nezávislé kopie po dvou akcelerátorech.
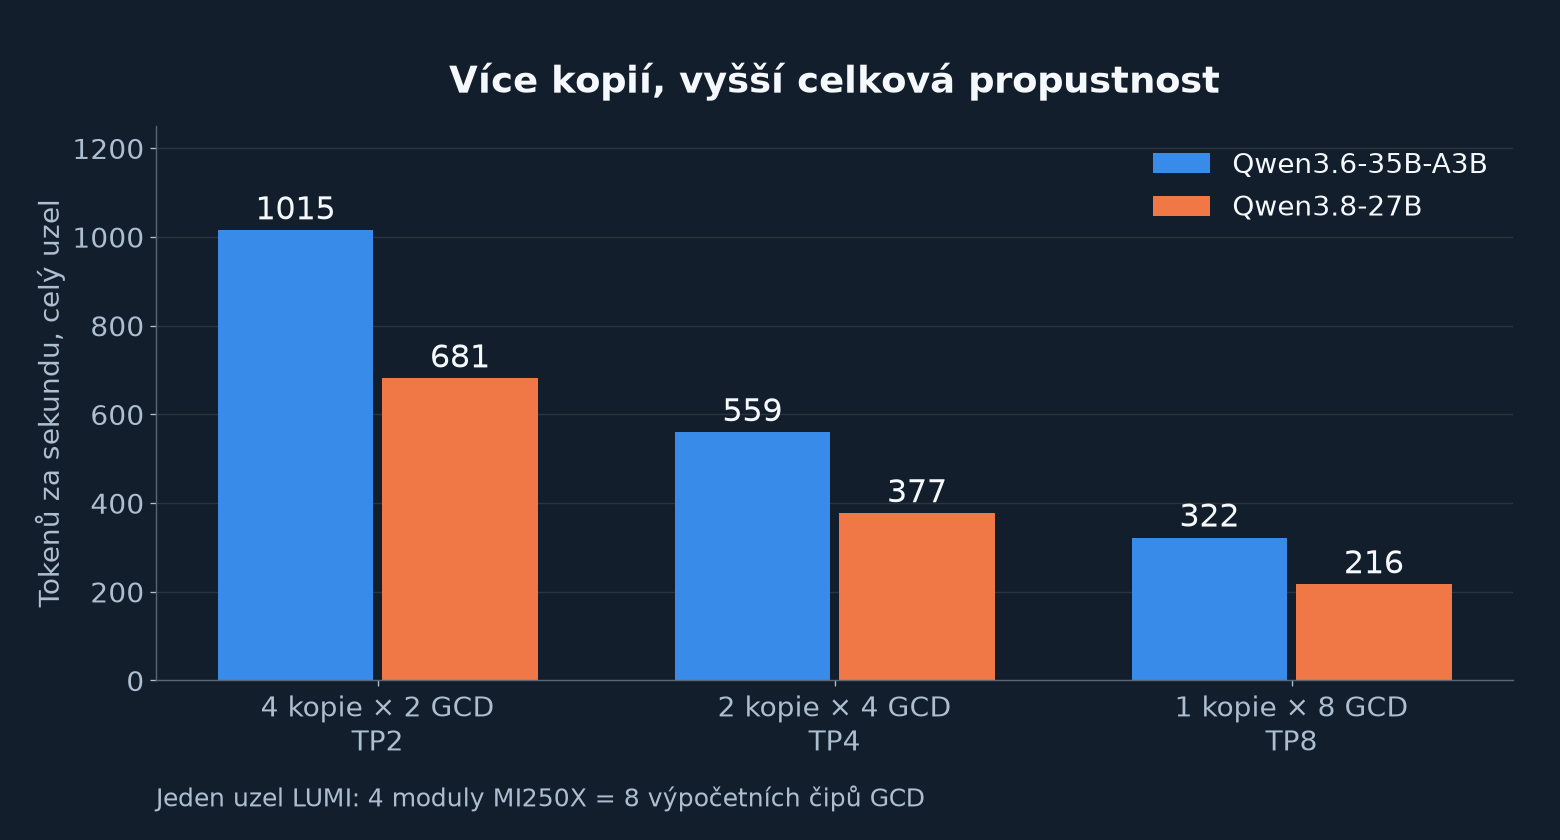
Čtyři kopie po dvou akcelerátorech (TP2) daly 1 015 tokenů za sekundu, jedna kopie přes osm (TP8) jen 322.
Energii měřte sami. LUMI spotřebu našich úloh nevykazovalo, tak jsme každých 30 sekund četli příkon akcelerátorů. Finální experiment spotřeboval 562 kWh jen za GPU. Rozdíly mezi modely byly až čtyřicetinásobné.
Co se nepovedlo
Tuhle část píšu nerad, ale je nejpoučnější.
- Dvakrát jsem modelům uřízl přemýšlení. Limit délky odpovědi jsem nastavil podle průměrné úlohy, ne podle nejtěžší. Modely s přemýšlením pak na nejtěžších otázkách nestihly doběhnout a vypadaly hůř, než jsou. Přepočet uříznutých odpovědí s delším limitem stál 777 GPU hodin, šestinu rozpočtu.
- Věřil jsem průběžným číslům. V noci vypadal Qwen3.8 na vědeckých otázkách na 90,6 %. Po doběhnutí měl 82,8 %. Jako první doběhnou snadné úlohy, takže průběžný stav vypadá lépe, než je.
- Porovnával jsem nesrovnatelné. V první verzi analýzy byly poroty a kaskády spočítané z jediného pokusu, jednotlivé modely z průměru osmi. Poroty vycházely o několik bodů lépe, než jsou. Chybu jsem našel sám a opravil, čísla v tomto článku jsou už ta opravená.
- Trénink a AI programátor spotřebovaly zhruba 1 400 GPU hodin a většinu přidělených procesorových hodin. U programátorského agenta trénink nepřidal nic, zlepšení přinesly lepší nástroje. U ThinkingCapu jsme v matematice získali, ale jinde ztratili.
- Ruční pravidla Atlasu byla v přímém souboji s naučeným pravidlem o 1–3,5 bodu horší. Dobrá zpráva pro produkt: víme, co vyměnit.
- Největší model se ve vLLM na našich akcelerátorech nedal spustit vůbec. Museli jsme ho rozběhnout jinak a jeho přesnější verze byla tak pomalá, že jsme ji po šesti hodinách zrušili.
Všechny chyby mám zapsané v provozním deníku. Každá teď má svůj bod v kontrolním seznamu před dalším experimentem.
Kolik to stálo
| GPU hodiny | 4 703 z 5 000 (94 %), oficiální účtování sedí s naším odhadem na hodinu přesně |
| z toho finále (Exp21 + Exp22) | ~2 900 GPU hodin za jeden den a noc |
| energie finále | 562 kWh (jen akcelerátory) |
| ohodnocené odpovědi | 305 051 + 5 314 řešení programovacích úloh |
| placená API | asi 42 dolarů: srovnání s placenými modely ~41 $, JEV pro router a ověřování ~0,85 $ |
Co dál
Pro Hyperprostor si z LUMI odnáším hlavně podněty, které teď ověříme i na velkých modelech:
- U menších otevřených modelů se často vyplatí jeden dobrý, stručně přemýšlející model. Porota a syntéza u nich přidávají hlavně tam, kde jde odpověď ověřit, u těžké matematiky a u odborných otázek. U velkých modelů, se kterými Hyperprostor pracuje, jsou poměry sil i cen jiné a porota se syntézou tam mají své místo. Kde přesně se vyplatí nejvíc, budeme měřit stejně poctivě jako na LUMI.
- Zkusit rozhodovat i podle kontroly hotové odpovědi, ne jen podle odhadu ze zadání. JEV jako kontrolor fungoval lépe než JEV jako věštec.
- Ruční prahy v routeru doplnit pravidlem naučeným z dat.
A pro další projekt na evropských superpočítačích mám jasné téma. Naučit kontrolora odpovědí na našich 305 tisících ohodnocených odpovědích, aby prorazil zeď selektoru. Pokud se to povede, porota modelů konečně využije to, co v ní je.
Data, skripty a zmrazené sady úloh chci zveřejnit, aby si výsledky mohl ověřit kdokoli.
Poděkování
Děkuji EuroHPC JU a LUMI AI Factory za přidělení výpočetního času a za celý program AI Factories, který otevírá superpočítače i malým firmám. Děkuji IT4Innovations a českému týmu LUMI AI Factory za podporu. Děkuji také CSC – IT Center for Science a konsorciu LUMI za provoz stroje, na kterém to všechno běželo. A díky organizátorům CERNA.AI za pozvání.
Osobně děkuji Jakubu Siwkovi, že nás tehdy jako první oslovil, a Filipu Oborníkovi, který si mě po přednášce o LUMI pozval do svého podcastu. Natáčet budeme příští měsíc.
Zleva Jan Tyl, Jakub Siwek a Filip Oborník na festivalu CERNA.AI v Ostravě.
We acknowledge EuroHPC JU for awarding the project ID EHPC-AIF-2026PG01-843 access to LUMI at CSC, Finland.
Chcete LUMI pro vlastní projekt?
Ozvěte se českému týmu LUMI AI Factory v IT4Innovations na ai-factory@it4i.cz. Program je otevřený i firmám a začít se dá menším projektem, jako jsme začínali my.
A pokud si chcete porotu modelů vyzkoušet sami, vstupte do Hyperprostoru →
Odkazy
- LUMI AI Factory: Czechia's Alpha Industries validates LUMI's power and sustainability in their initial test (13. 7. 2026)
- LUMI AI Factory: CERNA.AI Festival: LUMI AI Factory co-organised Czechia's biggest AI event of the year (28. 9. 2026)
- Když superpočítač počítá AI a zároveň topí městu (9. 7. 2026)
- Tak už jsme slavní i ve Finsku: dva dny a jedna noc na LUMI (14. 7. 2026)
- Jak se AI naučila programovat: od HumanEval ke zlaté medaili z ICPC (16. 7. 2026)
- Od počítání slovních úloh k porotám důkazů: pět let AI matematiky (16. 7. 2026)
- Alpha Industries vstupuje do doby kvantové (26. 8. 2026)
- Postavil jsem simulátor českého kvantového počítače (31. 8. 2026)
- 20 + 5 = 29. Ověřeno. Z Černé AI přes LUMI až ke kvantovému vlkovi (16. 9. 2026)